
PandaScript 与 Puppeteer 和 Playwright 的比较
PandaScript 就是你为 Puppeteer 或 Playwright 写的那种脚本,区别在于它直接在 Lightpanda 二进制内部运行,而不是向另一个进程中的浏览器发送指令。无需任何配置:lightpanda run script.js 读取文件后自己完成浏览。同样的脚本如果用 Puppeteer 或 Playwright,则需要 Node.js、npm install、下载 Chrome,还要有一个正在运行的浏览器供其连接。
PandaScript 非常省内存:在新闻监控任务示例中,内存占用只有 Playwright 的 1/4。速度也很快:一个登录流程比 Puppeteer 加 Chrome 快 14 倍,还把浏览器启动时间算在内。并行运行时,一批 Hacker News 请求快 3 倍,CPU 占用约低 30 倍,内存约低 40 倍——因为 Chrome 会把整台机器吃满,而 Lightpanda 几乎不占资源。
Lightpanda 的 agent 还能根据一段自然语言提示直接帮你写脚本。回放已保存的脚本是确定性的,且不需要 API key。
脚本示例
PandaScript 是一个语法简单的 JavaScript 文件。在这个例子中,我们打开 Hacker News 首页,取前五条新闻,访问每条新闻的评论页,返回前三条评论。共加载六个页面,输出一个 JSON 结果。对应的 PandaScript 如下:
const page = new Page();
await page.goto("https://news.ycombinator.com");
const { stories } = page.extract({
  stories: [{
    selector: "tr.athing",
    limit: 5,
    fields: {
      id: { selector: "", attr: "id" },
      title: ".titleline > a",
      url: { selector: ".titleline > a", attr: "href" }
    }
  }]
});

for (const story of stories) {
  await page.goto(`https://news.ycombinator.com/item?id=${story.id}`);
  story.comments = page.extract({
    comments: [{
      selector: "tr.comtr",
      limit: 3,
      fields: { user: ".hnuser", text: ".commtext" }
    }]
  }).comments;
}
return stories;两个值得注意的细节:第一,page.goto 需要 await,因为它要等待网络;而 page.extract 不需要,因为它读取的 DOM 就在当前进程里。第二,脚本的返回值就是最终以 JSON 形式输出到 stdout 的内容。
PandaScript 比 Puppeteer 或 Playwright 更简单,后两者在执行任何操作前都必须先启动浏览器,结束后再销毁:
import puppeteer from 'puppeteer';
const browser = await puppeteer.launch();
const context = await browser.createBrowserContext();
const page = await context.newPage();
// 与上文相同的导航、选择和循环操作
await page.close();
await context.close();
await browser.close();
中间的工作内容是一样的。区别在于两端:启动浏览器并打开页面需要四行代码,关闭则需要三行。而 PandaScript 从第一行代码开始就在工作,因为运行脚本的进程本身就是浏览器。
另一个区别在于数据的输出方式。Puppeteer 和 Playwright 提供 $$eval:你需要把一个函数发送到页面中并收集其返回值。而 PandaScript 的 extract 接受声明式 Schema,输入选择器,输出 JSON。
相比代码,Schema 在重放(replay)时更稳定。选择器要么匹配,要么不匹配,不匹配时错误信息会直接指出是哪个选择器出了问题。使用 $$eval 时,你得到的只是一个序列化到不可见页面中的函数内部的堆栈帧。
在运行任何脚本之前,机器需要以下条件:
| Puppeteer / Playwright | PandaScript | |
|---|---|---|
| 运行时 | Node.js | 无 |
| 依赖项 | npm install,node_modules/ | 无 |
| 浏览器 | 下载 Chromium(约 170 MB)或运行中的 Chrome | 无 |
| 连接 | 启动浏览器,通过 CDP 连接 | 无 |
| 总计 | 两个进程和一个协议 | 一个进程 |
安装 Lightpanda 只需一条命令:curl -fsSL https://pkg.lightpanda.io/install.sh | bash。之后,执行 lightpanda run script.js 即可。
使用 Lightpanda agent 生成 PandaScript
你可以手动编写脚本,考虑到这个规模,这么做是合理的。也可以用大白话描述任务,然后让 lightpanda agent 来完成。Agent 会打开一个 REPL,每条指令都在实时页面上执行,你在它变成脚本之前就能看到返回的结果。下面这个 Hacker News 示例的编写成本仅为 0.12 美元(使用 Gemini 3.8 Flash API),这是一次性的。之后的每次重放都是免费的。
$ lightpanda agent
❯ 打开 news.ycombinator.com 并获取前 5 个新闻及其 ID
// 这里打印新闻
[agent: 运行 4.7s · 2 次工具调用]

❯ 对于其中每一项,打开评论页并获取前 3 条评论
// 这里打印带评论的新闻
[agent: 运行 49.5s · 10 次工具调用]

❯ /save hn.js
[agent: 运行 3.4s · 0 次工具调用]
已将合成脚本保存至 hn.js

❯ /usage
usage: input=148195 (fresh=140225 · cache read=7970 · cache write=0), output=3112
cache: 5% 的输入来自缓存
上面的 PandaScript 仅包含成功获取目标数据的调用。Agent 的所有失败尝试均被排除。
凭据
如果任务需要登录,请将秘密信息放入环境变量中,并按名称引用。以下是本稍后文中测得的登录脚本全文:
const page = new Page();
await page.goto("$LP_BASE_URL/login");

page.fill("input[name=acct]", "$LP_HN_USERNAME");
page.fill("input[name=pw]", "$LP_HN_PASSWORD");
page.press("input[name=pw]", "Enter");

page.waitForState({ state: "load" });
page.waitForSelector("#logout");

await page.goto("$LP_BASE_URL/user?id=$LP_HN_USERNAME");
const { karma } = page.extract({
  karma: "#hnmain table table tr:nth-child(3) td:nth-child(2)"
});

return { karma: parseInt(karma, 10) };
使用环境变量中的值运行它:
LP_HN_USERNAME=panda LP_HN_PASSWORD=… lightpanda run login.js
Lightpanda 在调用执行的那一刻,会根据自己的环境解析所有 $LP_* 占位符。脚本里只保存变量名而不保存值,因此可以放心提交到代码仓库。只有带 LP_ 前缀的变量会被解析,脚本无法访问环境中的其他变量。
PandaScript 的内存占用只有 Puppeteer 和 Playwright 的四分之一
我们在四种配置下运行了同样的四个任务:PandaScript、Puppeteer、Playwright 和 browser-use CLI。Puppeteer 和 Playwright 是目前使用最广泛的两个网页自动化库;browser-use CLI 则是较新的自动化工具,面向编码 agent 而非供人直接编写脚本的库(这一点与 PandaScript 类似)。
测试中,每种工具分别驱动 Chrome 或 Lightpanda 引擎(即 PandaScript 所用的引擎)。让每个驱动工具搭配两种引擎,就能把引擎本身和驱动方式的影响分开,剩下的差异就是驱动开销。
四个任务分别是:Hacker News、一个依赖大量 hydration 的电商页面(eu.gymshark.com)、一个广告密集的新闻页面(apnews.com),以及一个本地运行的登录流程(用于排除网络因素)。
| 配置 | HN 抓取 | 电商(storefront) | 新闻监控 | 登录(本地) |
|---|---|---|---|---|
| PandaScript | 39 MB | 218 MB | 227 MB | 16 MB |
| Puppeteer → Lightpanda | 128 MB | 355 MB | 438 MB | 102 MB |
| Playwright → Lightpanda | 139 MB | 368 MB | 456 MB | 109 MB |
| Puppeteer → Chrome | 614 MB | 1,038 MB | 1,024 MB | 436 MB |
| Playwright → Chrome | 680 MB | 1,186 MB | 986 MB | 516 MB |
| browser-use CLI → Lightpanda | 98 MB | 341 MB | 365 MB | 90 MB |
| browser-use CLI → Chrome | 433 MB | 807 MB | 845 MB | 395 MB |
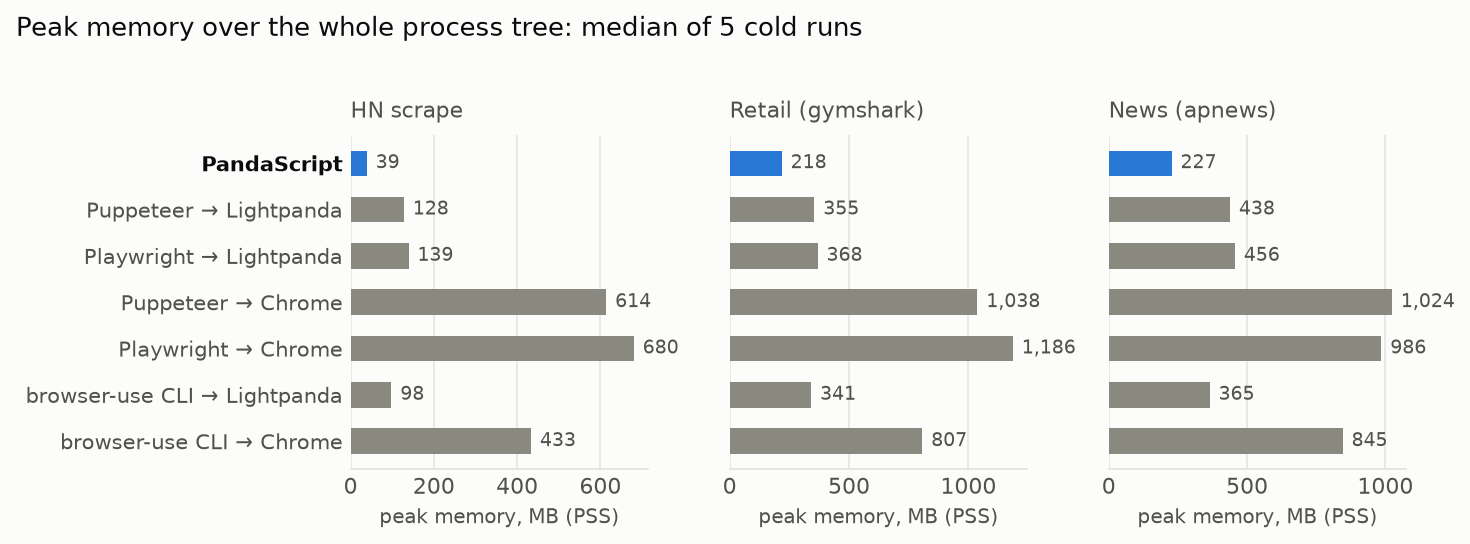
PandaScript 之所以更轻量,是因为它仅靠一个进程直接在 Lightpanda 浏览器上原生执行任务。相比之下,Puppeteer、Playwright 和 browser-use CLI 通过 CDP(Chrome DevTools Protocol)在独立的进程(Node.js 或 Python)中控制浏览器。这种方式不仅要求浏览器保持运行,还需要通过 WebSocket 连接进行消息的序列化和反序列化。
内存差距的一部分也源于浏览器引擎本身。Chrome 比较沉重,在前述店面示例中消耗了 1 GB 内存。正如上文数据所示,Lightpanda 引擎则轻量得多。
PandaScript 比 Puppeteer 和 Playwright 更快
当每次只运行一个请求时,任何引擎的大部分时间都花在等待网络响应上。例如,Hacker News 的响应时间只有几百毫秒。然而,爬虫或监控任务通常会并行运行数百个请求。在这种情况下,关键指标是单个请求消耗的机器资源量。
与 Puppeteer 搭配 Chrome 相比,PandaScript 的效率要高得多,并行任务的处理速度快了 3 倍。同时,Lightpanda 引擎的性能也优于 Chrome,且随着负载规模扩大,其资源消耗仅略微增加。
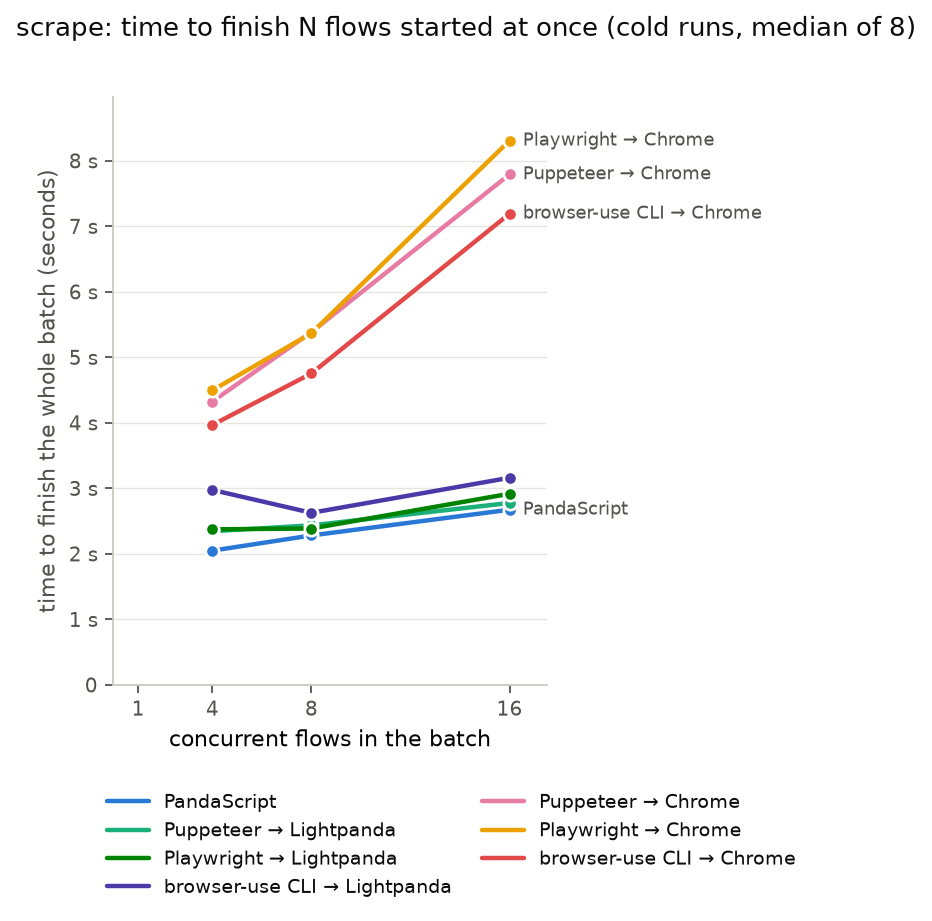
PandaScript 实际上快到了需要“降速”的程度。在本次基准测试中,我们同时启动 16 个进程,并在同一毫秒内发送它们的首个请求,结果 Hacker News 的突发限制器将其视为攻击。因此,我们的基准测试让 PandaScript 的进程每 30 ms 启动一次(任何工作进程池其实也应该这么做)。
| 驱动 | 4 个流 | 8 个流 | 16 个流 | 16 个流时的 CPU 时间 | 16 个流时的峰值内存 |
|---|---|---|---|---|---|
| PandaScript | 2.05 s | 2.28 s | 2.67 s | 2.1 s | 162 MB |
| Puppeteer → Lightpanda | 2.34 s | 2.43 s | 2.78 s | 12.0 s | 870 MB |
| Playwright → Lightpanda | 2.37 s | 2.39 s | 2.92 s | 14.4 s | 982 MB |
| browser-use CLI → Lightpanda | 2.97 s | 2.63 s | 3.16 s | 9.7 s | 966 MB |
| browser-use CLI → Chrome | 3.97 s | 4.75 s | 7.19 s | 43.4 s | 5.4 GB |
| Puppeteer → Chrome | 4.32 s | 5.38 s | 7.79 s | 57.0 s | 7.2 GB |
| Playwright → Chrome | 4.50 s | 5.37 s | 8.31 s | 65.0 s | 8.0 GB |
测试框架、脚本以及每次运行的原始数据都可以在基准测试仓库中找到。