大语言模型如何在大海捞针
你的智能体返回了奇怪的结果。是提示词的问题、某个工具调用超时,还是代码无法解析的响应?如果没有追踪记录,你只能盲目猜测。
在这期实操工作坊中,Sentry 的 Serge 将使用 Sentry Agent Tracing 为三个智能体添加埋点:一个电商平台的聊天机器人、一个自定义 Slack 智能体,以及一个审查 PR 的 GitHub Action。你将学会如何捕获异常的工具调用和意外输出,同时追踪所有智能体的 Token 消耗和性能表现。
想象这样一个场景:一名员工因航班取消被困在机场。在预订酒店前,他向公司 AI 助手提了一个简单问题:“航班取消的话,酒店费用可以报销吗?”
公司有成千上万份文档,涵盖差旅、报销、保险、员工福利和地区政策。其中某段文字提到,非自愿旅行中断导致的住宿费用符合条件可予以报销。
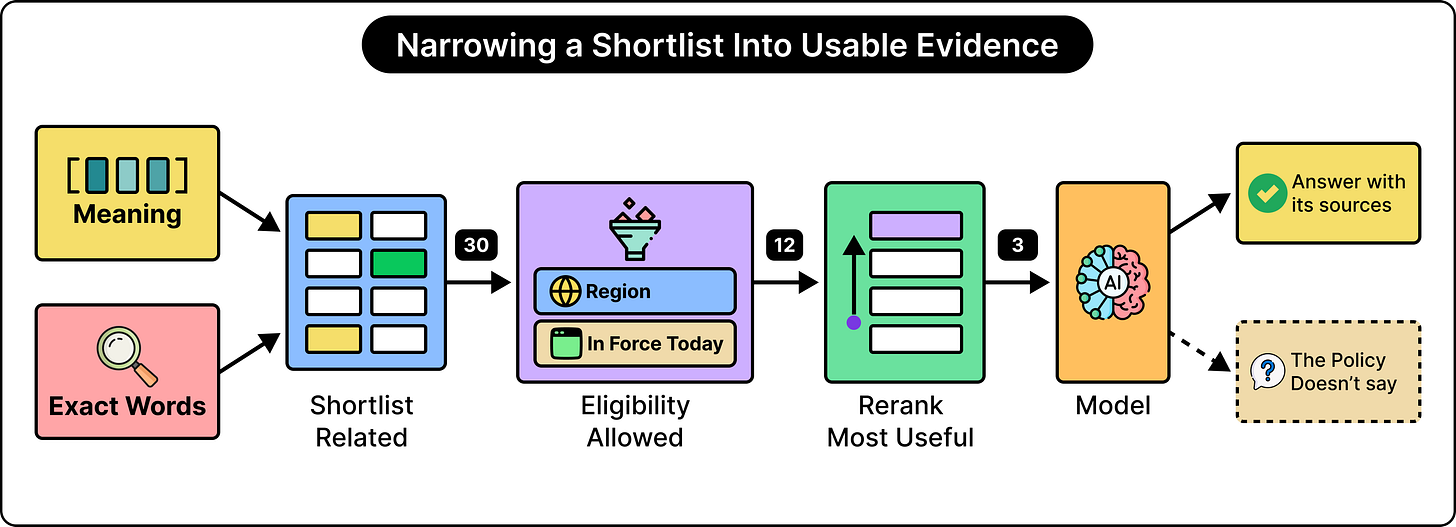
对于 LLM 聊天机器人而言,找到这条信息远比表面看起来困难。问题中说的是“取消的航班”,而政策里用的术语是“非自愿旅行中断”。其他文档也讨论酒店,但适用于不同的国家。可能还存在一份旧政策,其中包含早已变更的报销限额。
在这种情况下,LLM 必须找到语义上匹配问题、属于正确政策且当前仍然有效的信息。只有这样,它才能给出解决用户问题的有用回答。
这就是许多 LLM 应用背后的检索问题。本文将探讨 LLM 如何“大海捞针”。内容如下:
LLM 回答问题需要证据
文档如何转化为可搜索的段落
LLM 如何理解不同词汇背后的语义
“足够接近”的标准是什么
为什么搜索每个段落成本过高
如何通过关联找到正确的“邻近区域”
搜索多少才够
答案变化时会怎样
LLM 需要依据才能回答问题
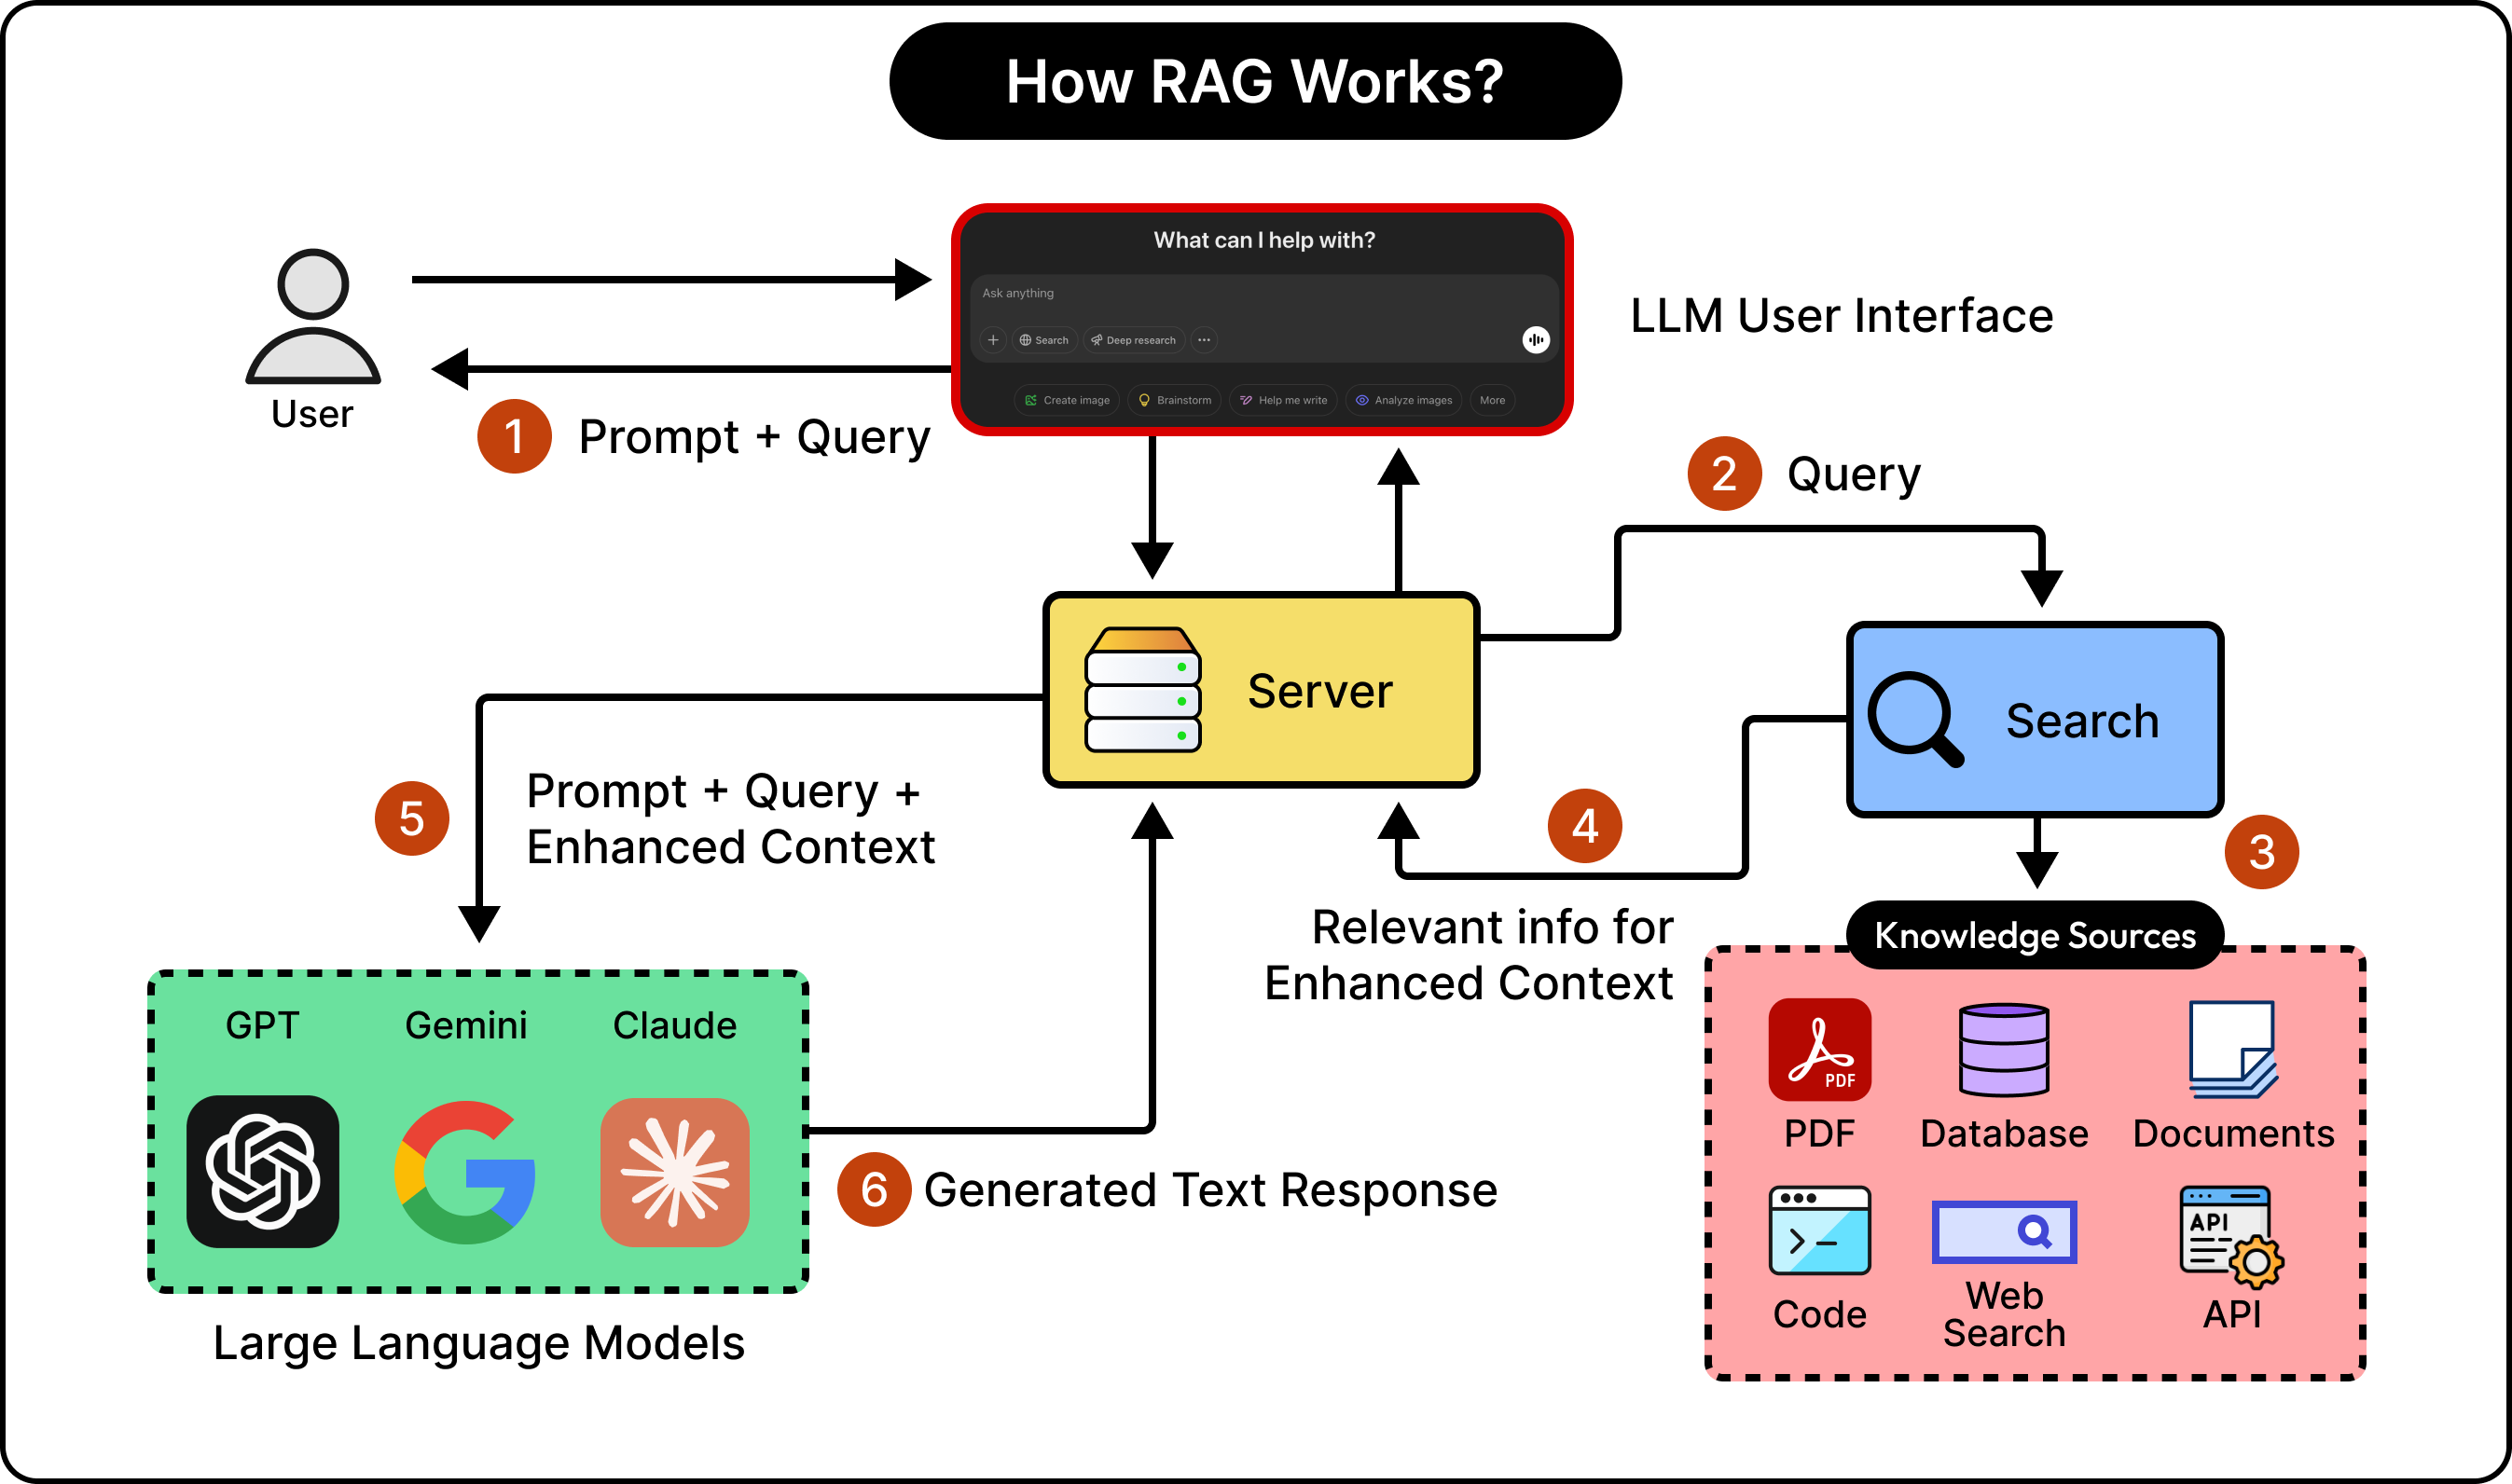
语言模型不会自动知道公司内部文档里写了什么。应用必须提供这些信息——要么直接把文档放进输入,要么在问题到来时检索相关段落。
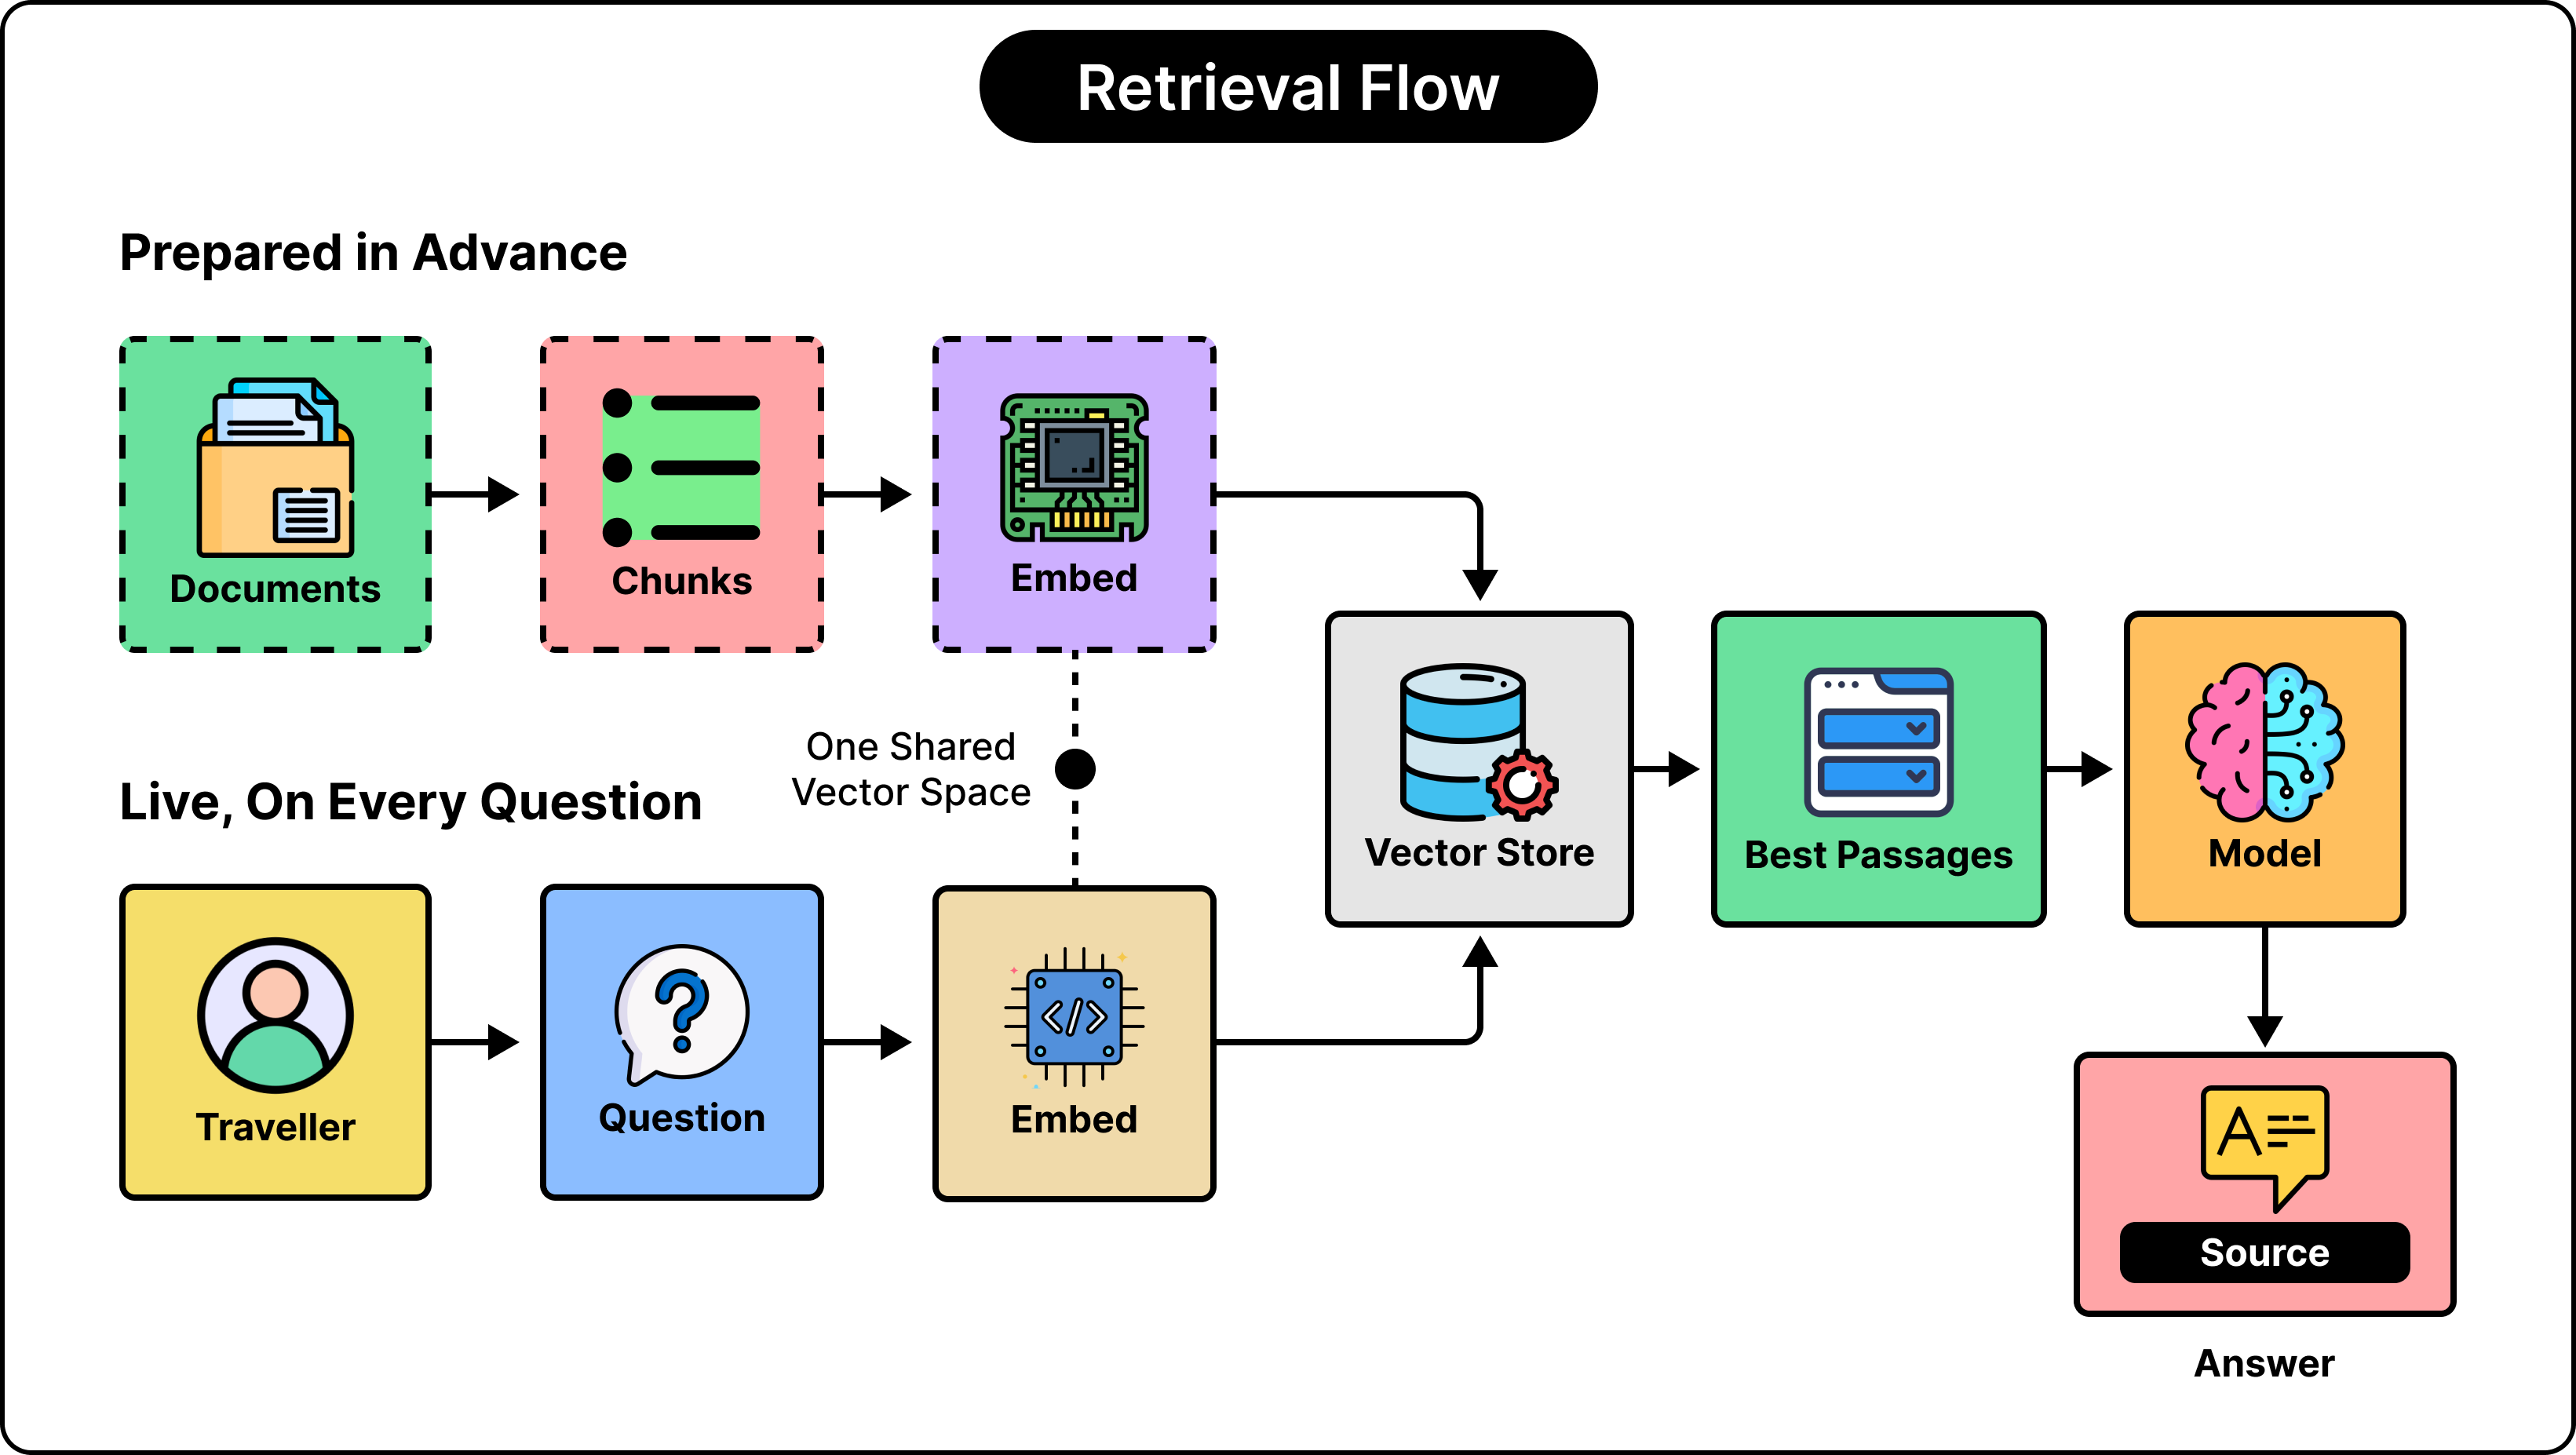
面对海量文档,检索提供了一种筛选出适量信息的方式。embedding 模型把问题转换成数值表示,搜索系统再利用这个表示找到有价值的段落,最后由应用把原始文本交给 LLM。
模型随后就能基于这些段落解释政策,并准确引用信息来源。这种模式叫做 retrieval-augmented generation(RAG)。vector database 负责其中的检索环节,存储并搜索内容的数值表示。
这种分工非常实用。如果应用检索到的是过时的政策,再强的语言模型也会给出过时的答案。如果检索到的是通用的酒店预订规则,却漏掉了取消条款的例外情况,答案听起来可能相当合理,实则忽略了关键条件。
因此,答案是否可靠取决于生成之前发生了什么。这就要求我们把文档集合按合适的粒度做成可检索的。
文档如何转化为可检索段落
旅行手册通常涵盖航班、住宿、餐饮、审批和保险等内容。然而,若将整本手册视为单个可检索对象,生成的表征往往过于宽泛,从而模糊具体规则。
因此,应用层会将文档切分为更小的单元,称为 chunks(语块)。一个 chunk 可能专门描述酒店报销政策,另一个则解释审批要求。这样,搜索便能定位到特定段落,而不仅仅是找到包含该段落的手册。
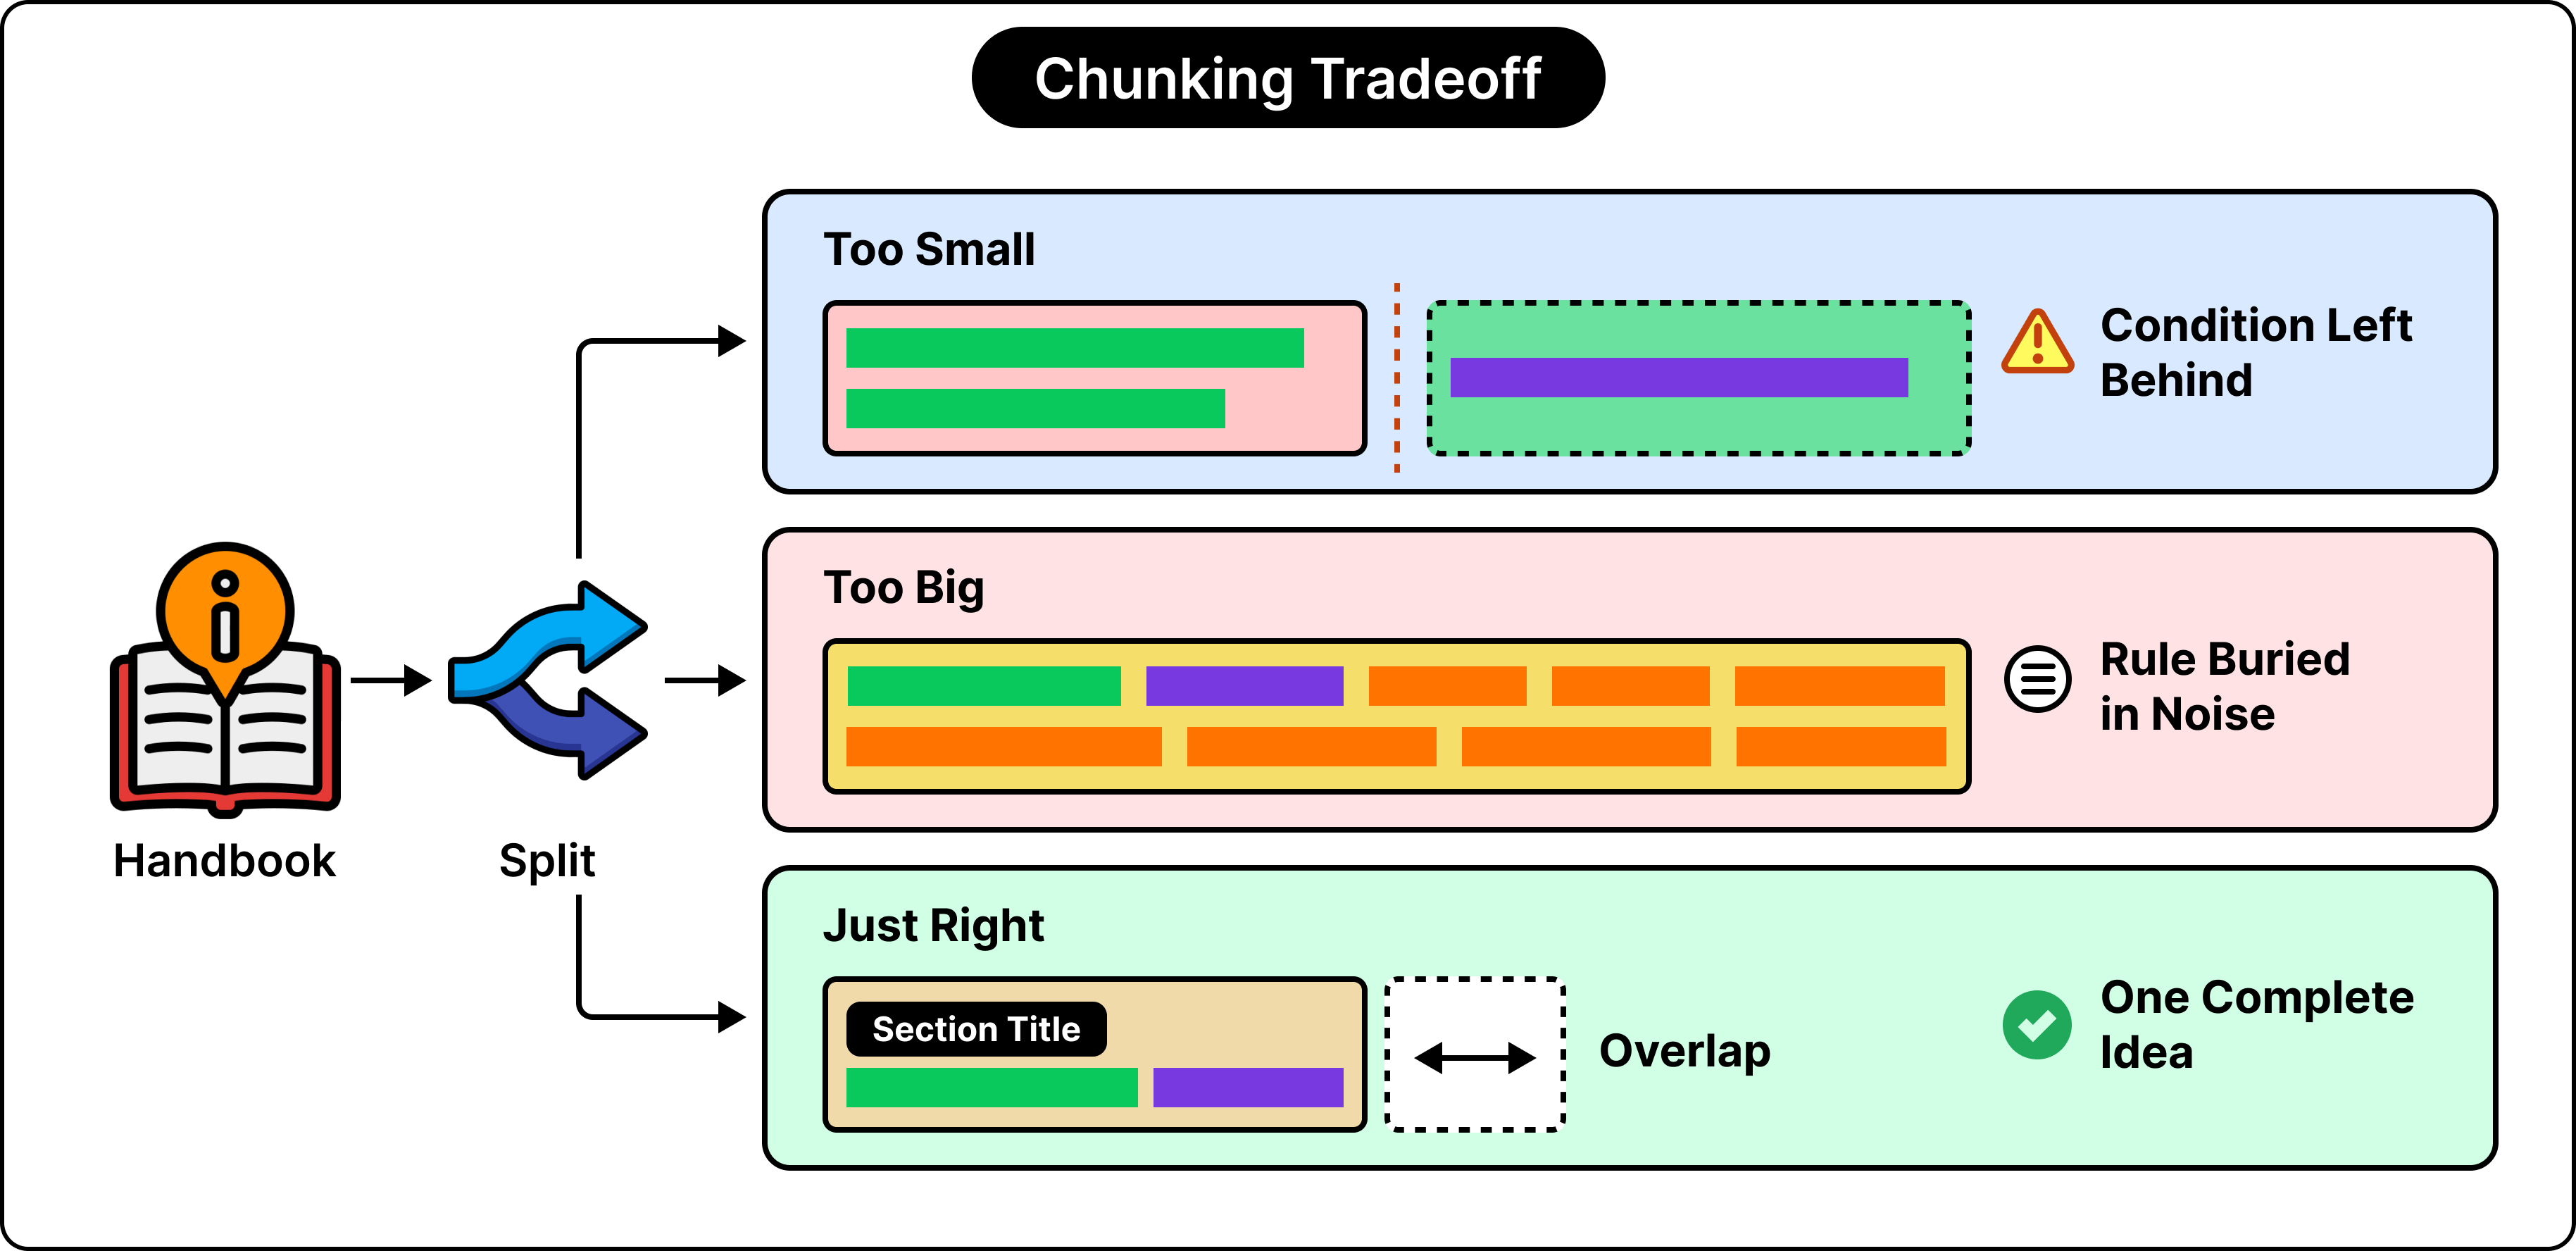
切分(Chunking)需要在精度与上下文之间取得平衡。小块可能紧密聚焦问题,却遗漏例外情况;大块虽能保留例外,但也可能混入多项无关政策。例如,若某段落称“取消后产生的住宿费用可报销”,下一句补充“仅在航空公司未提供住宿时适用”,将这两句话拆分开来,可能导致助手即便拥有相关文本也给出错误答案。
因此,理想的 chunk 应在可行范围内保留完整语义。章节标题以及相邻 chunk 之间的适度重叠有助于维持上下文连贯。目标是创建即使被单独检索也能独立理解的段落。
针对上述员工提问的场景,最佳的可检索单元应包含报销规则、相关条件,以及足以确定其所属政策的识别性上下文。
LLM 如何捕捉不同词汇背后的语义
Embeddings(嵌入向量)使得即使表述不同,也能搜索到语义相关的内容。
嵌入模型将一段文本转化为向量:一长串数字,通常包含成百上千个小数位。你可以把它看作一张“文本地图”。含义相近的文本片段会落在彼此邻近的位置。例如,关于航班取消后酒店费用的咨询,在地图上应该离“旅行受阻政策”更近,而不是“重置密码指南”。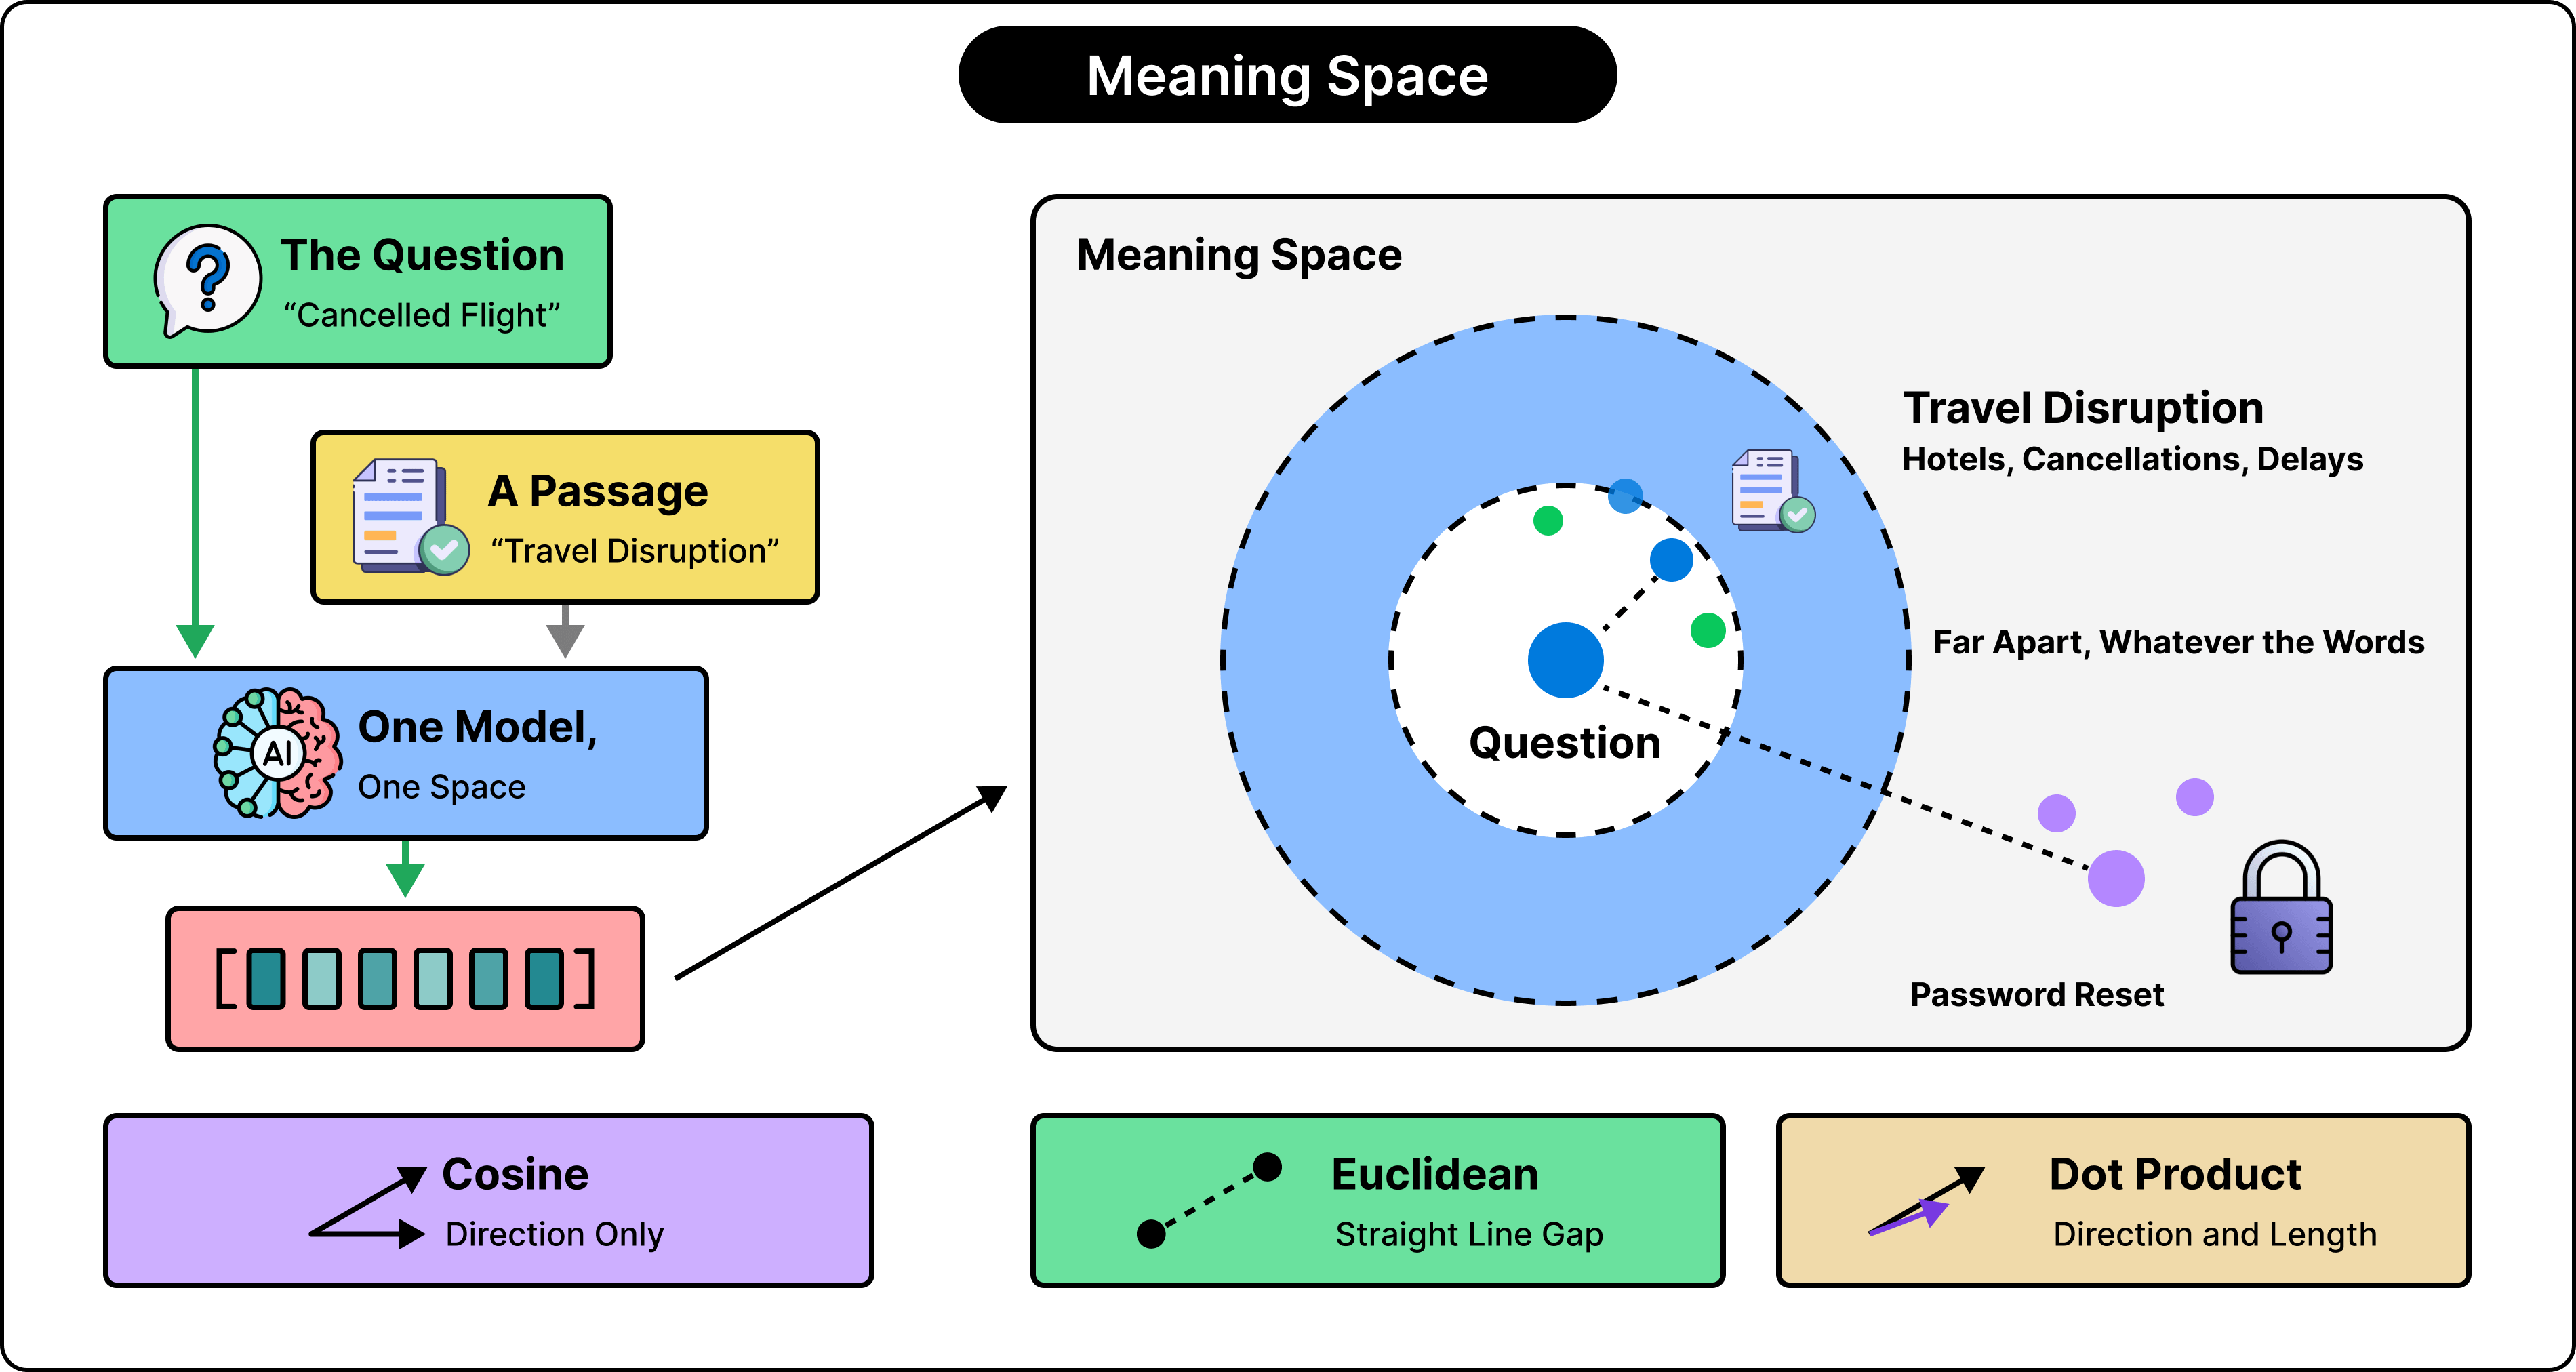
多近才算近?
搜索系统需要对“邻近”做出精确界定。这通过距离或相似度度量实现,该度量对比两个向量并给出一个评分。常见的度量方式包括:余弦相似度:比较两个向量的方向,忽略其长度。
欧几里得距离:测量两个向量端点之间的直线距离,因此向量长度会影响结果。
点积同时反映方向一致性和向量长度。
归一化会把向量缩放为长度 1。当查询向量和文档向量都归一化后,点积就等于余弦相似度,此时欧氏距离虽然分数不同,但排名结果一致。如果嵌入模型本身就按未归一化向量设计,点积同样适用。
选择度量方式应依据嵌入模型的设计意图。仅仅因为某种度量流行就选用它,可能会以意想不到的方式改变排序结果。
相似度分数也需要谨慎解读。0.85 的分数并不意味着该段落有 85% 的概率能正确回答问题,它只是描述了表示之间的一种数学关系。
这段内容可能主题相关,但讲的是错误地区的政策,也可能已经过时,或遗漏了某个例外情况。相似度只能提供相关性证据,在成为答案之前还需要额外的校验。
为什么逐一检索所有段落代价太高
逐一遍历所有向量做检索很简单直接,但计算量会随集合规模增长。
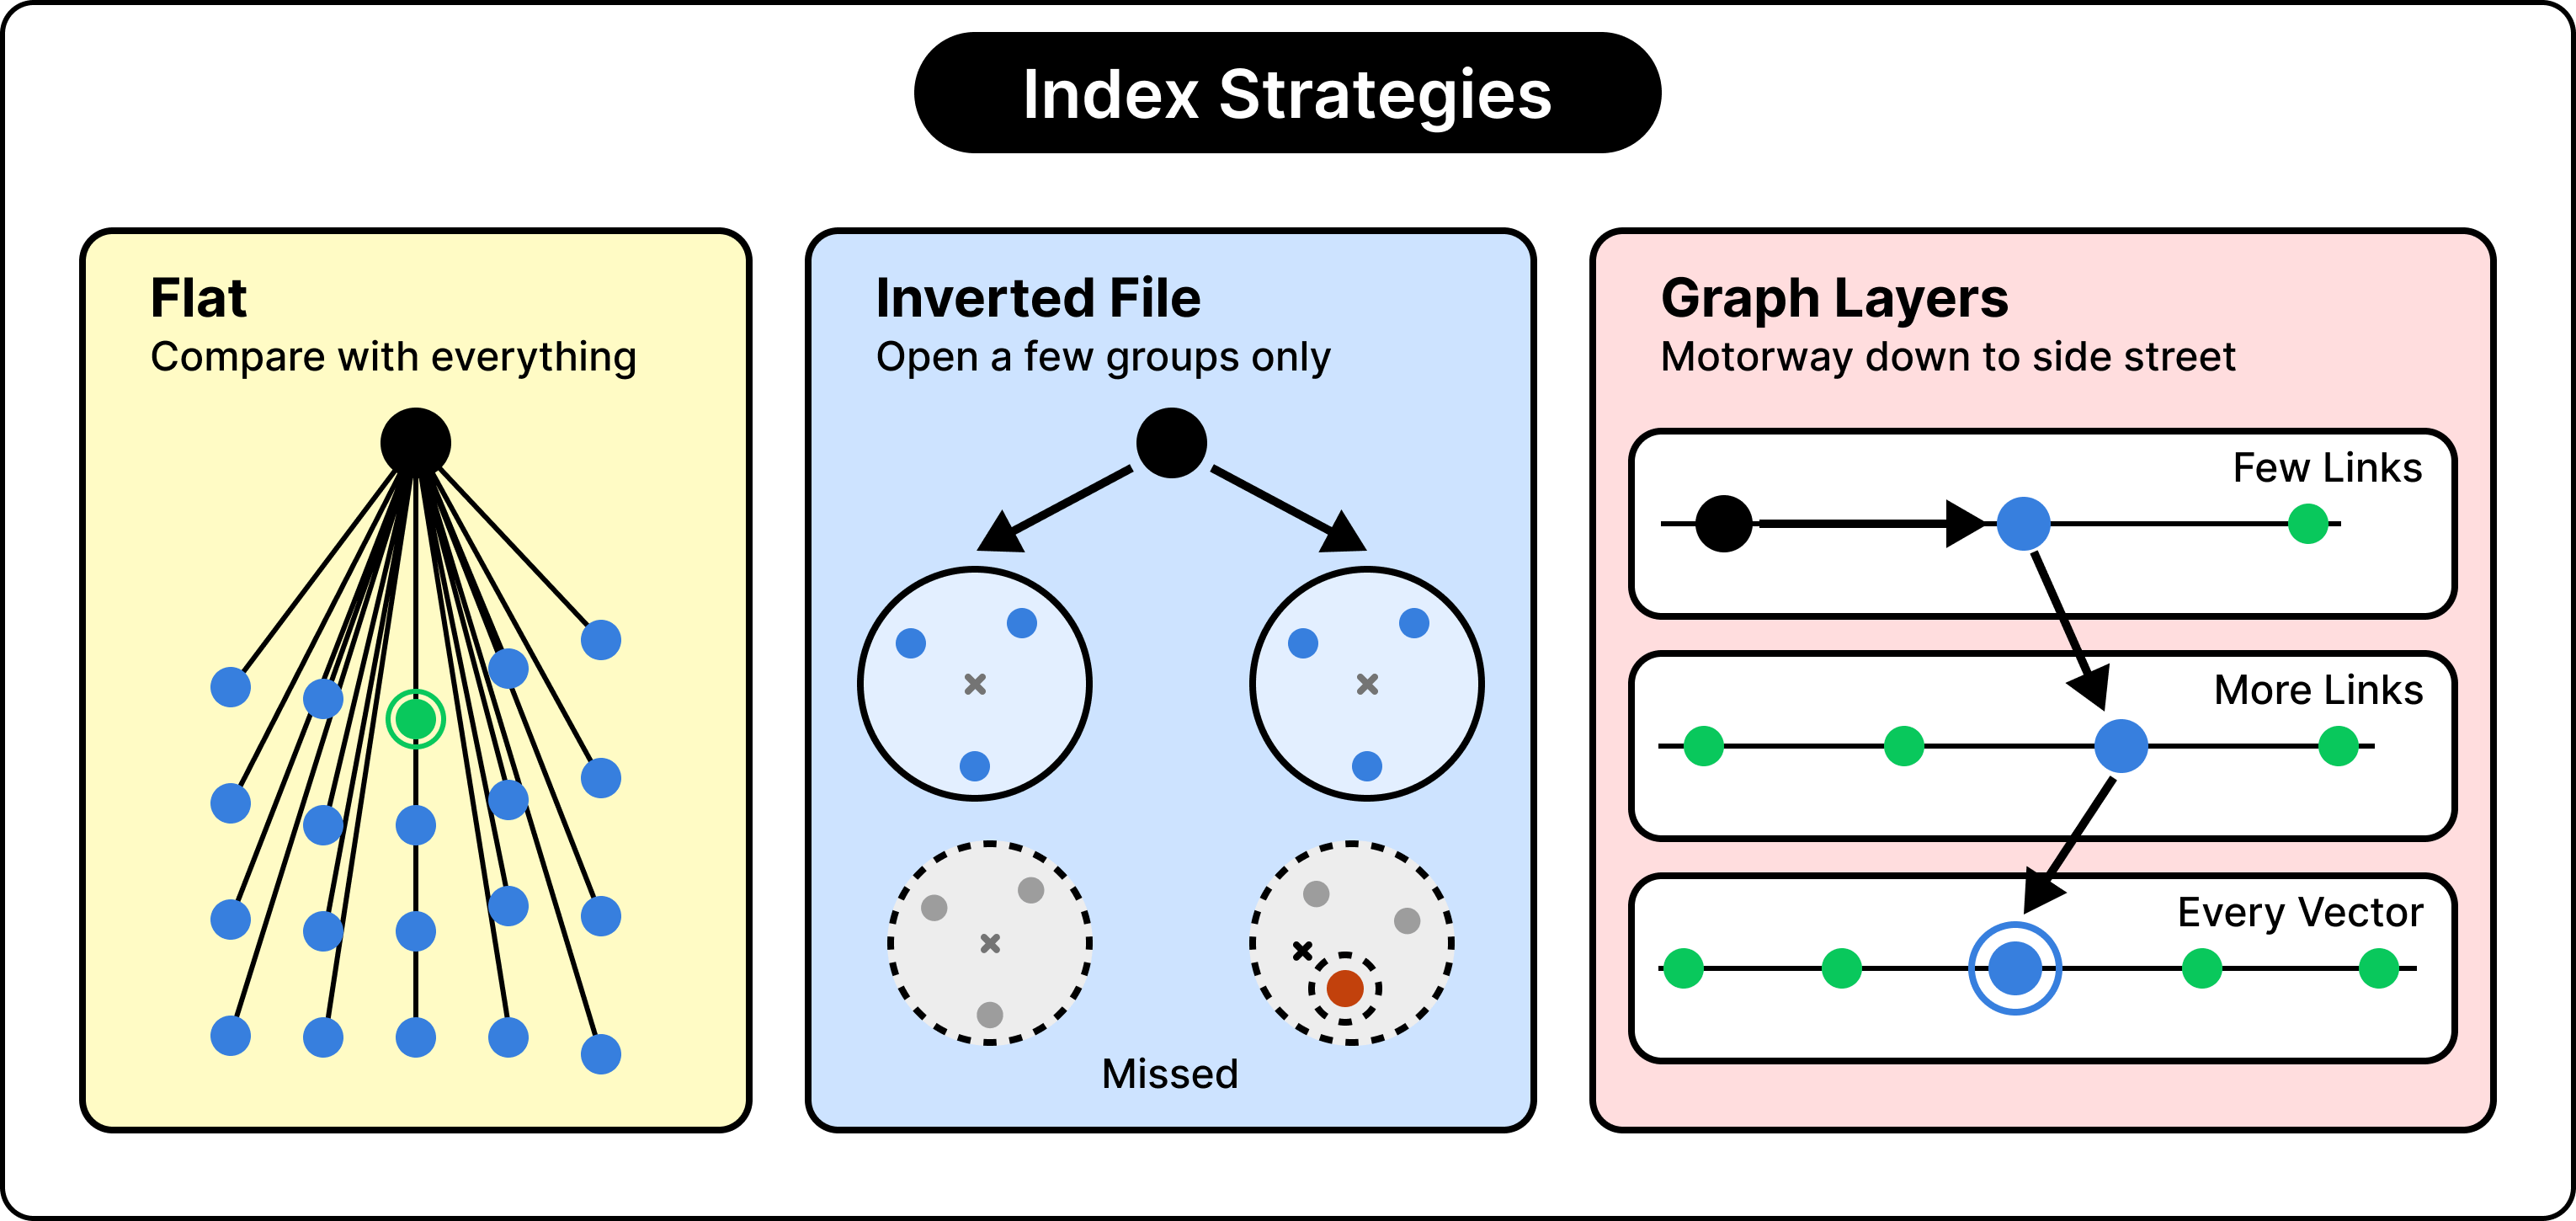
扁平索引会把查询与所有候选向量逐一比较,返回得分最高的那些。在维度固定的情况下,比较开销大致与向量数量成正比,这就是 O(n) 的含义:集合翻倍,向量比较次数也翻倍。向量越长,每次比较的计算量也越大。
在选定的度量方式下,扁平检索得到的是精确的最近邻。但“精确”只是指数值搜索结果的精确性,并不保证这些最近邻就包含正确答案。
另一方面,倒排文件索引通过将向量分组来减少计算量。构建索引时,聚类会识别出有代表性的中心点,并