Mozilla报告:中国开源权重AI模型仅落后美国前沿模型4个月,成本大幅降低
Mozilla 于 9 月 15 日发布了 State of Open Source AI 报告 1.1 版,数据截至 9 月 1 日。报告显示,许多中国最优秀的开源权重 AI 模型正在缩小与美国前沿模型的差距:最佳开源模型在 Artificial Analysis Intelligence Index 上仅落后封闭模型 3 分,而价格只有后者的 60%;与 Claude Fable 5 相差 2 分,价格为其 30%。Mozilla 对 METR 任务时长数据的拟合显示,开源与闭源模型之间的差距约为 4.4 个月,与 Epoch AI 估计的 4 个月基本一致。
深入了解 TH Premium:AI 与数据中心
- 数据中心散热现状
- 定制 AI ASIC 现状
- 美国 AI 芯片规则频繁变动,代价却由全世界承担
- GTC 2026:Ian Buck 媒体问答实录——超大规模与 HPC 副总裁谈搁置 CPX 及年内推出 LPU decode
- 数据中心 CPU 需求激增,AI 智能体是幕后推手
Mozilla 是 Firefox 浏览器的非营利组织,其报告属于定期发布的评估内容,首次发表于 7 月 14 日 的 Mozilla 博客上。报告基于 Mozilla/SlashData 对约 1,400 名开发者的调查、OpenRouter 流量数据以及第三方基准指数。Mozilla 一直倡导开源模型,《时代》杂志 在 7 月 14 日报道,Mozilla 首席技术官 Raffi Krikorian 表示,该报告在一定程度上带有倡导性质。在此语境下,“开放权重”指可下载的模型权重,而非训练数据或代码。报告统计了 16 个重要的开源发布,但没有一个符合开放源代码基金会定义中关于“数据配方”的要求。
“四个月”这一差距基于 METR 的评估,该研究非营利组织按模型完成任务所需的人类工作时间的一半来衡量任务时长。根据 Mozilla 的拟合估算,闭源模型能处理人类专家需 8 到 12 小时的任务,而开源模型大约落后四个月达到同等能力;Mozilla 测算显示,开源能力每 3.9 个月翻倍,闭源则为 5.5 个月。Mozilla 还绘制了 vals.ai 的 Terminal-Bench 2.1 结果图表,该基准测试通过同一 harness(即向模型提供工具的软件层)对所有模型进行统一测试。在该榜单上,Z.ai 的 GLM-5.2 得分与 Claude Opus 4.7 仅差 1 分,落后 Opus 4.8 约 4 分,且单次测试成本不到后者的五分之一。在将开发者流量路由至数百个模型的 OpenRouter 市场中,Mozilla 统计发现,8 月按 token 使用量计算的前十大模型中有 8 个是开放权重模型,其中 7 个为中国团队开发。尽管如此,根据Linux 基金会 的报告,2025 年 5 月至 9 月期间,闭源提供商仍占据了 OpenRouter 模型层收入的 96%。Krikorian 在给 Ars Technica 的邮件中表示:“我们认为付费使用闭源模型是基于工作负载而非基于组织的决定。”
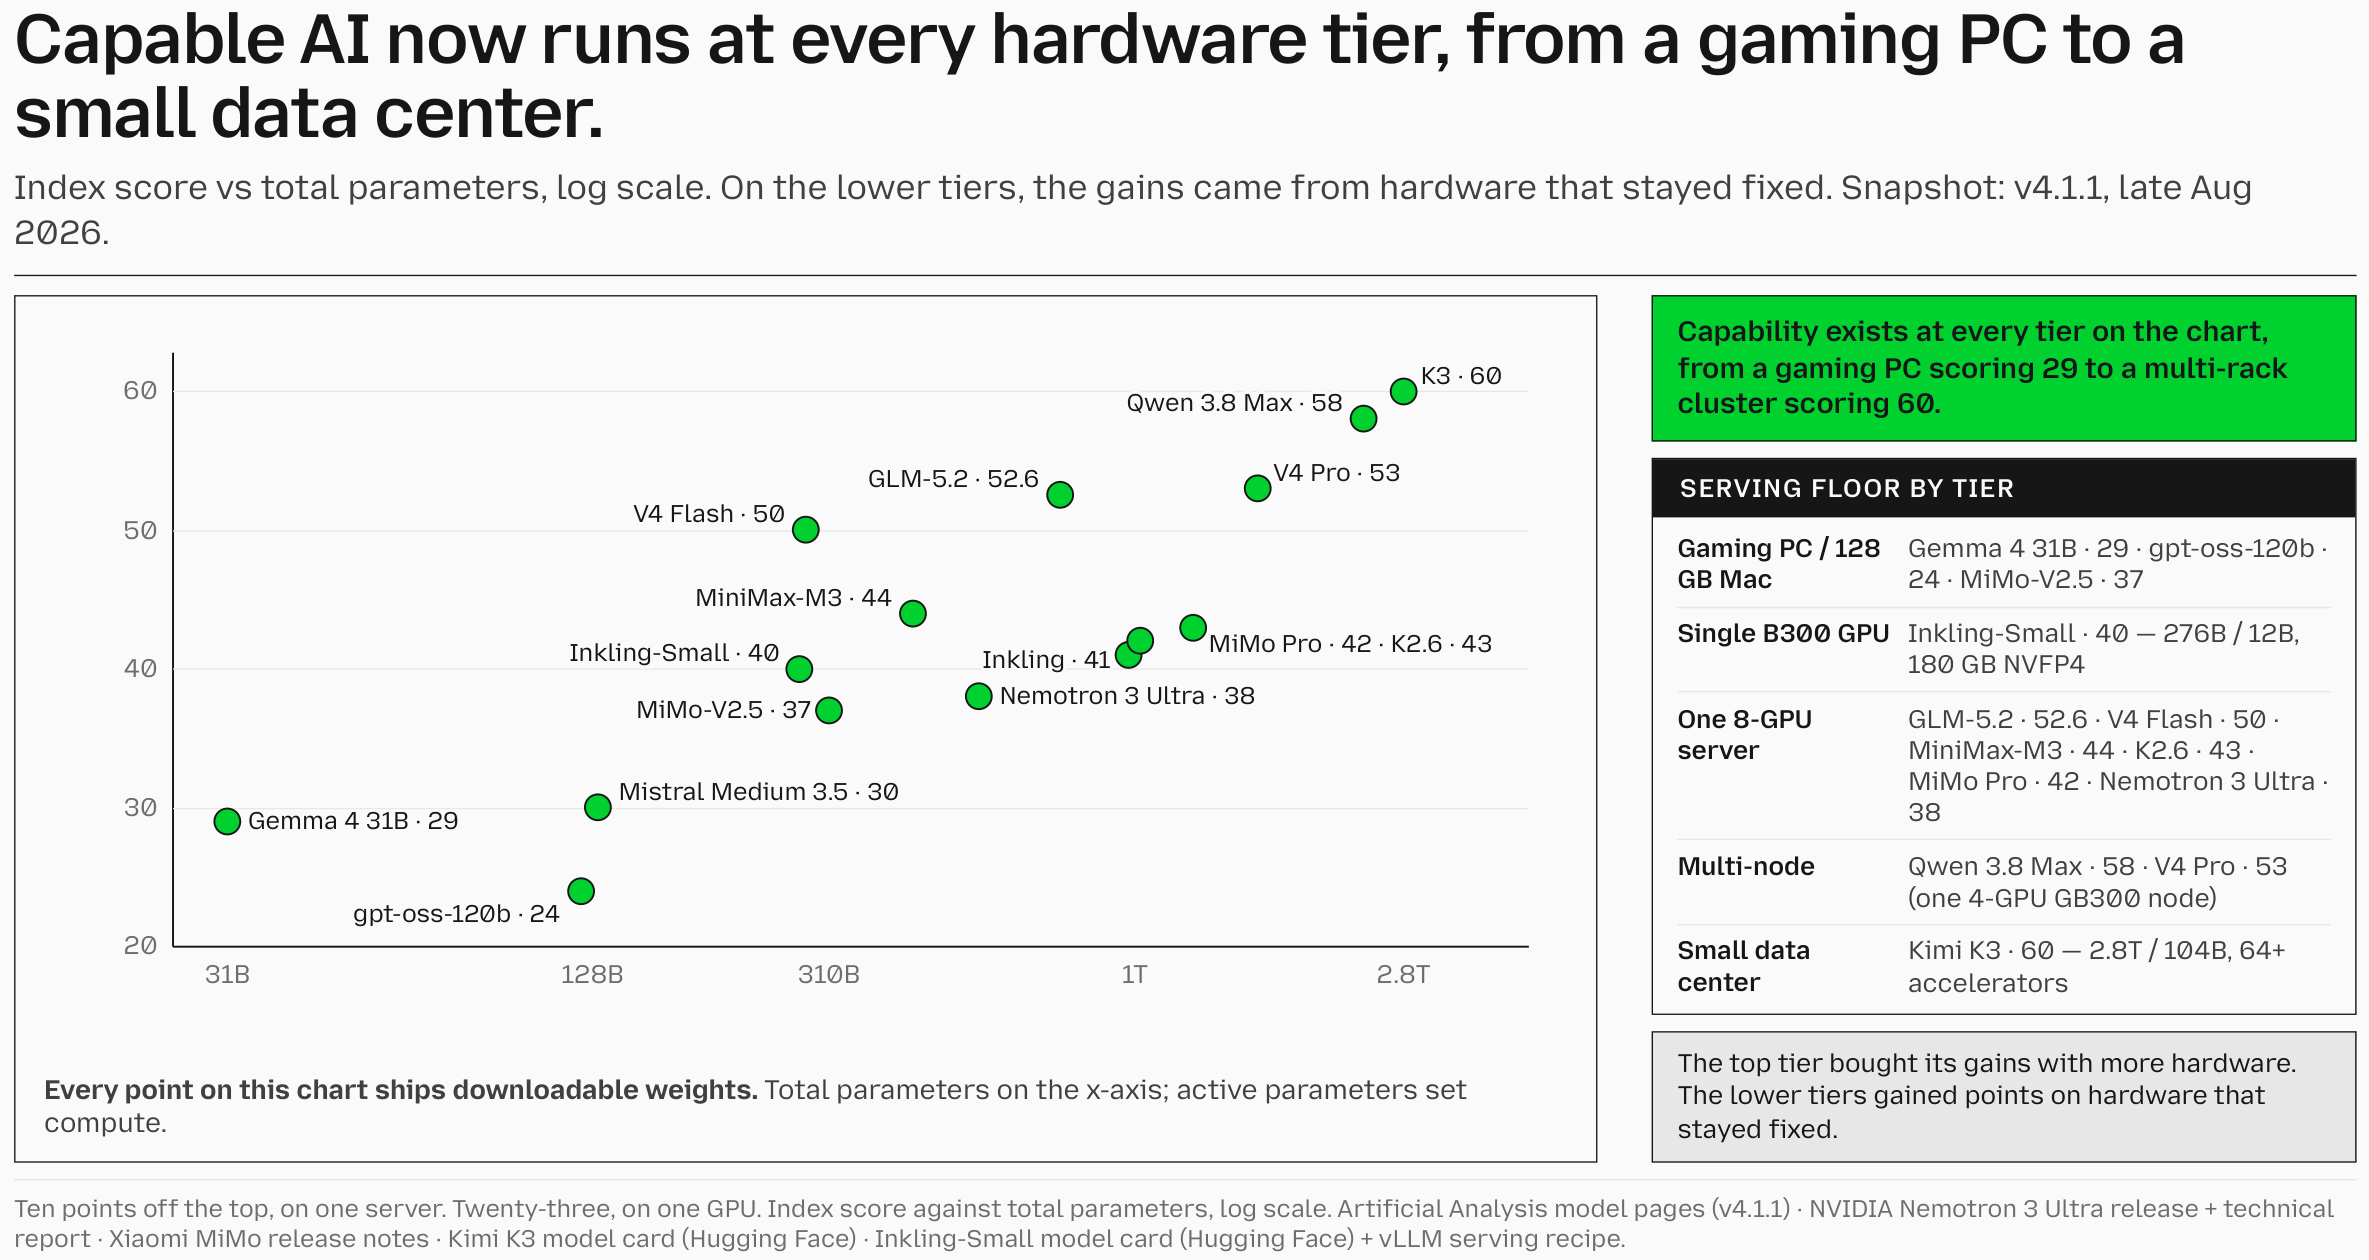
需要注意的是,报告中提到的四个月差距和 30% 的 Token 价格优势,是在托管端点基于 API 列表价进行对比得出的。根据该报告自身的硬件图表数据,能适配单台服务器的最佳开源模型得分仅为 52.6 分,而能适配单张 GPU 的最佳模型得分为 40 分。与头部模型的差距分别为 10 分和 23 分,这一分差远大于报告所宣称的四个月进度差。Kimi K3 的原生 MXFP4 检查点(checkpoint)大小约为 1.56TB,分布在 96 个分片中。Mozilla 的服务配置建议至少使用 64 个或更多加速器,而 vLLM 官方建议生产环境至少需配备八块 GB300 GPU 并跨多节点部署。报告指出,尽管该模型权重开放,但大多数人实际上无法运行它;Tom’s Hardware 在七月份也曾报道,该模型的大约 1.5TB 显存需求是巨大门槛。一个例外是 Thinking Machines 的 Inkling-Small 模型,它采用 Apache 2.0 许可证,其 NVFP4 版本仅需 180GB 显存下限,即可在一块 B300 上运行。
该报告的数据截止日期为 9 月 1 日。此后,Artificial Analysis 已将其评估指数更新至 v4.3 版本,并更换了评估数据集。在最新排行榜上,Claude Fable 5.1 在最高算力配置下得分 53 分,Kimi K3 得 44 分,这与 Mozilla 图表中使用的 v4.1.1 版本数据不可直接对比。vals.ai 于 9 月 11 日更新的 Terminal-Bench 2.1 排行榜显示,GPT-6 Astra 以 87.27% 的成绩位居第一,Fable 5.1 紧随其后,成绩为 85.02%。Mozilla 图表的注脚写道:“每次发布周期都会重置差距。”此外,K3 还涉及一项指控,详见 9 月 8 日发布的 NSA/CISA/FBI 联合公告(编号 AA26-251A)。Mozilla 在报告中将此描述为“已有声称,但未证实”,具体内容是 Moonshot 通过蒸馏(distillation,即利用一个模型的输出训练另一个模型)的方式,提取 Claude Fable 5 的数据来训练 K3。在 7 月 17 日,Artificial Analysis 曾显示 K3 得分为 57,而 Fable 5 为 60;而在 9 月 1 日,Mozilla 的数据显示 K3 落后 2 分。