以大语言模型作为评判者:如何判断你的 LLM 是否健康
为何应在将 AI Agent 上线前进行评估——具体方法解析(赞助内容)
如果在没有离线验证的情况下就部署 AI Agent,等于把测试工作直接甩给了用户。本文提供一个实用框架,帮助你在产品正式商用前,对生产级 AI Agent 完成全面评估。
通过这份指南,你可以了解如何:
构建覆盖核心场景、边缘情况及对抗性输入的标注测试数据集
设计确定性测试和 LLM-as-a-Judge 评估器,以映射真实的业务影响
在实验阶段端到端追踪多 Agent 工作流,在用户发现问题之前捕获故障
保持离线测试环境与生产环境的一致性,从而防止模型漂移
LLM 本质上也是软件系统,与我们日常接触的其他软件无异。但测试 LLM 的方法与普通软件截然不同。
例如,软件中常见的函数接收两个数字作为输入,总会返回相同的总和。而若对 LLM 提出同样的问题两次,它大概率会生成措辞不同的两个答案。这两个答案可能都符合预期,但这让评估变得棘手。评估 LLM 时,我们需要衡量应用在各种情境下是否始终表现正常。
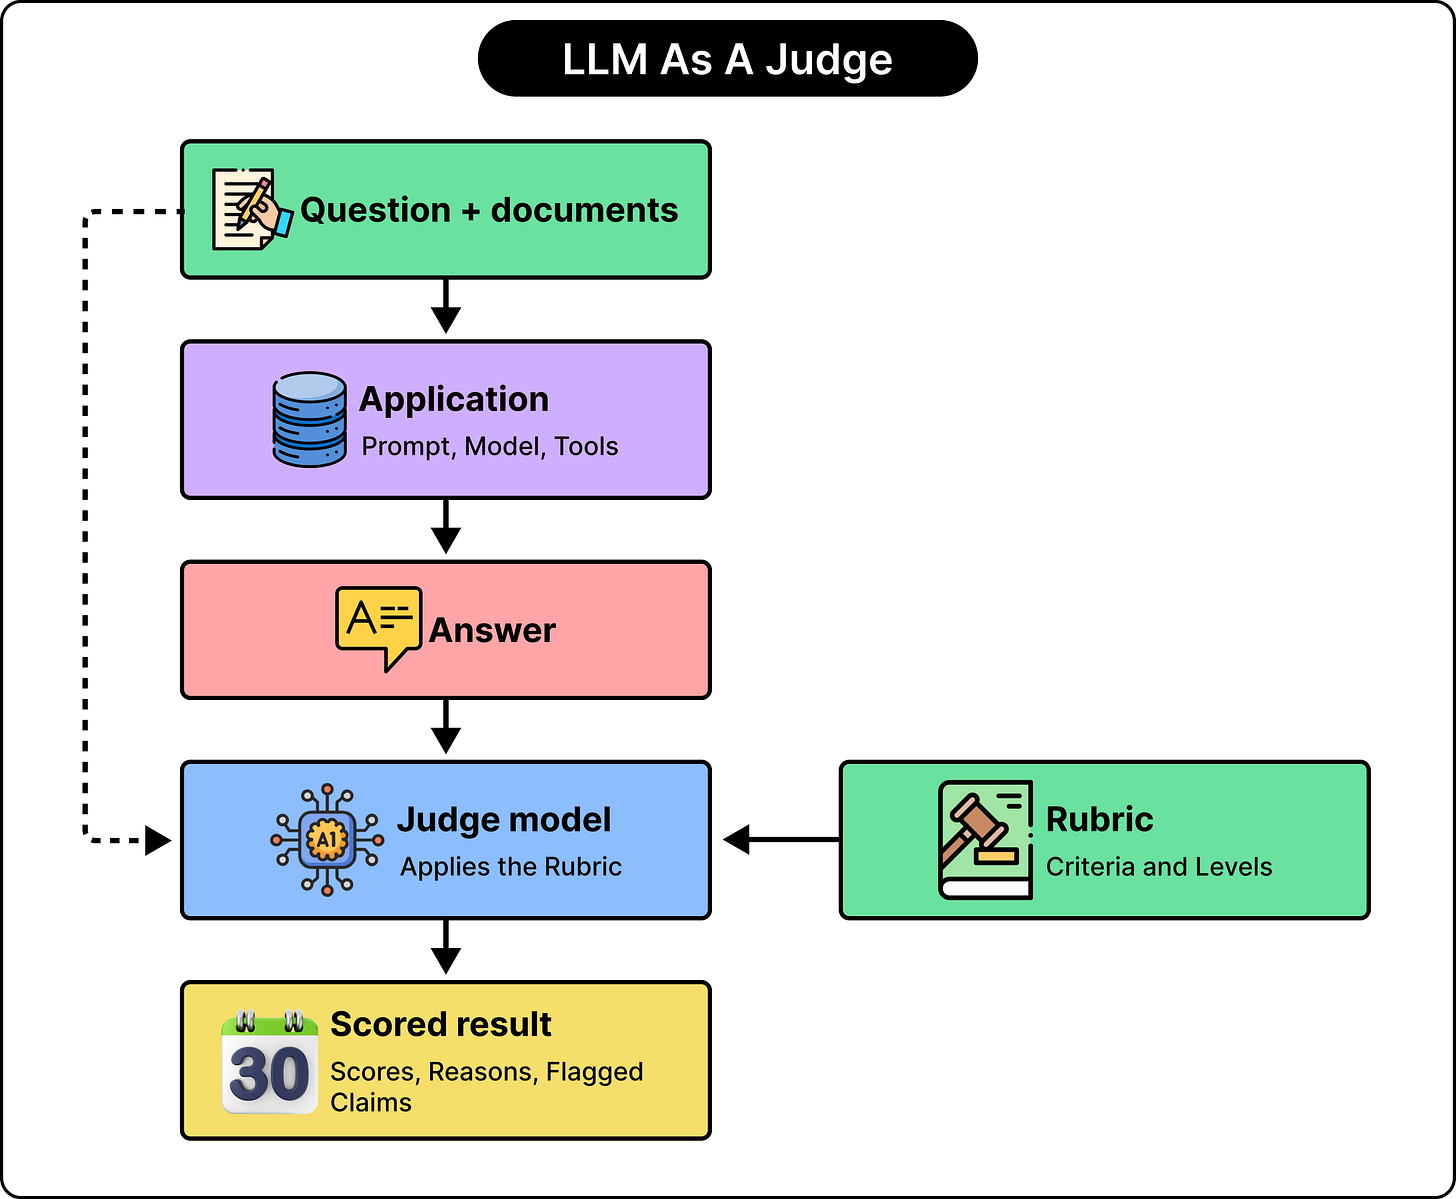
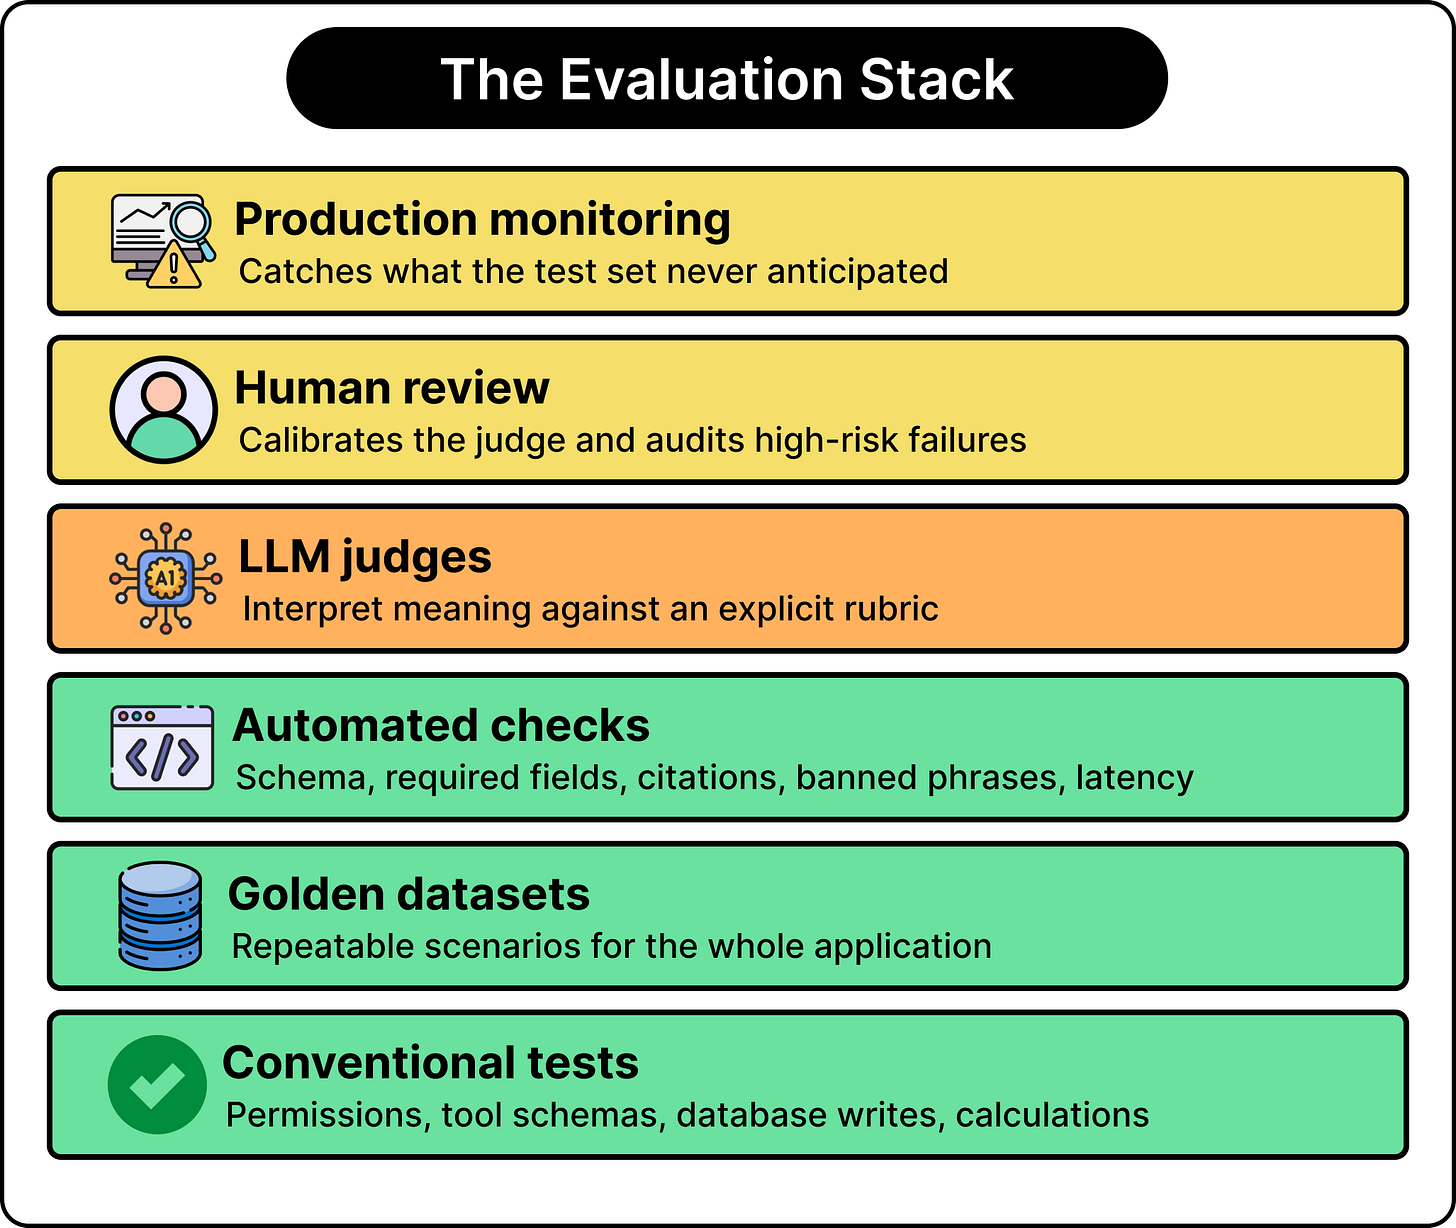
“LLM-as-a-Judge”是评估流程中的一环,其核心是用一个语言模型去评判另一个语言模型的输出。但仅有“裁判”模型是不够的。一个健康的 LLM 评估体系需要整合多种要素,包括传统软件测试、精心挑选的示例、自动化检查、基于模型的评判、人工审核以及生产环境监控。
下文将深入剖析 LLM 评估的具体流程,主要涵盖以下内容:
如何界定 LLM 应用的“健康”状态?
为何常规测试不足以评估 LLM?
LLM 评估的基本流程
Golden 数据集:用于可重复地测试 LLM 行为
自动化指标:快速但有限的检查手段
LLM-as-a-judge 是什么意思?
评审模型评估答案的不同方式
人工评估与校准
评估技术栈
什么样的 LLM 应用才算“健康”?
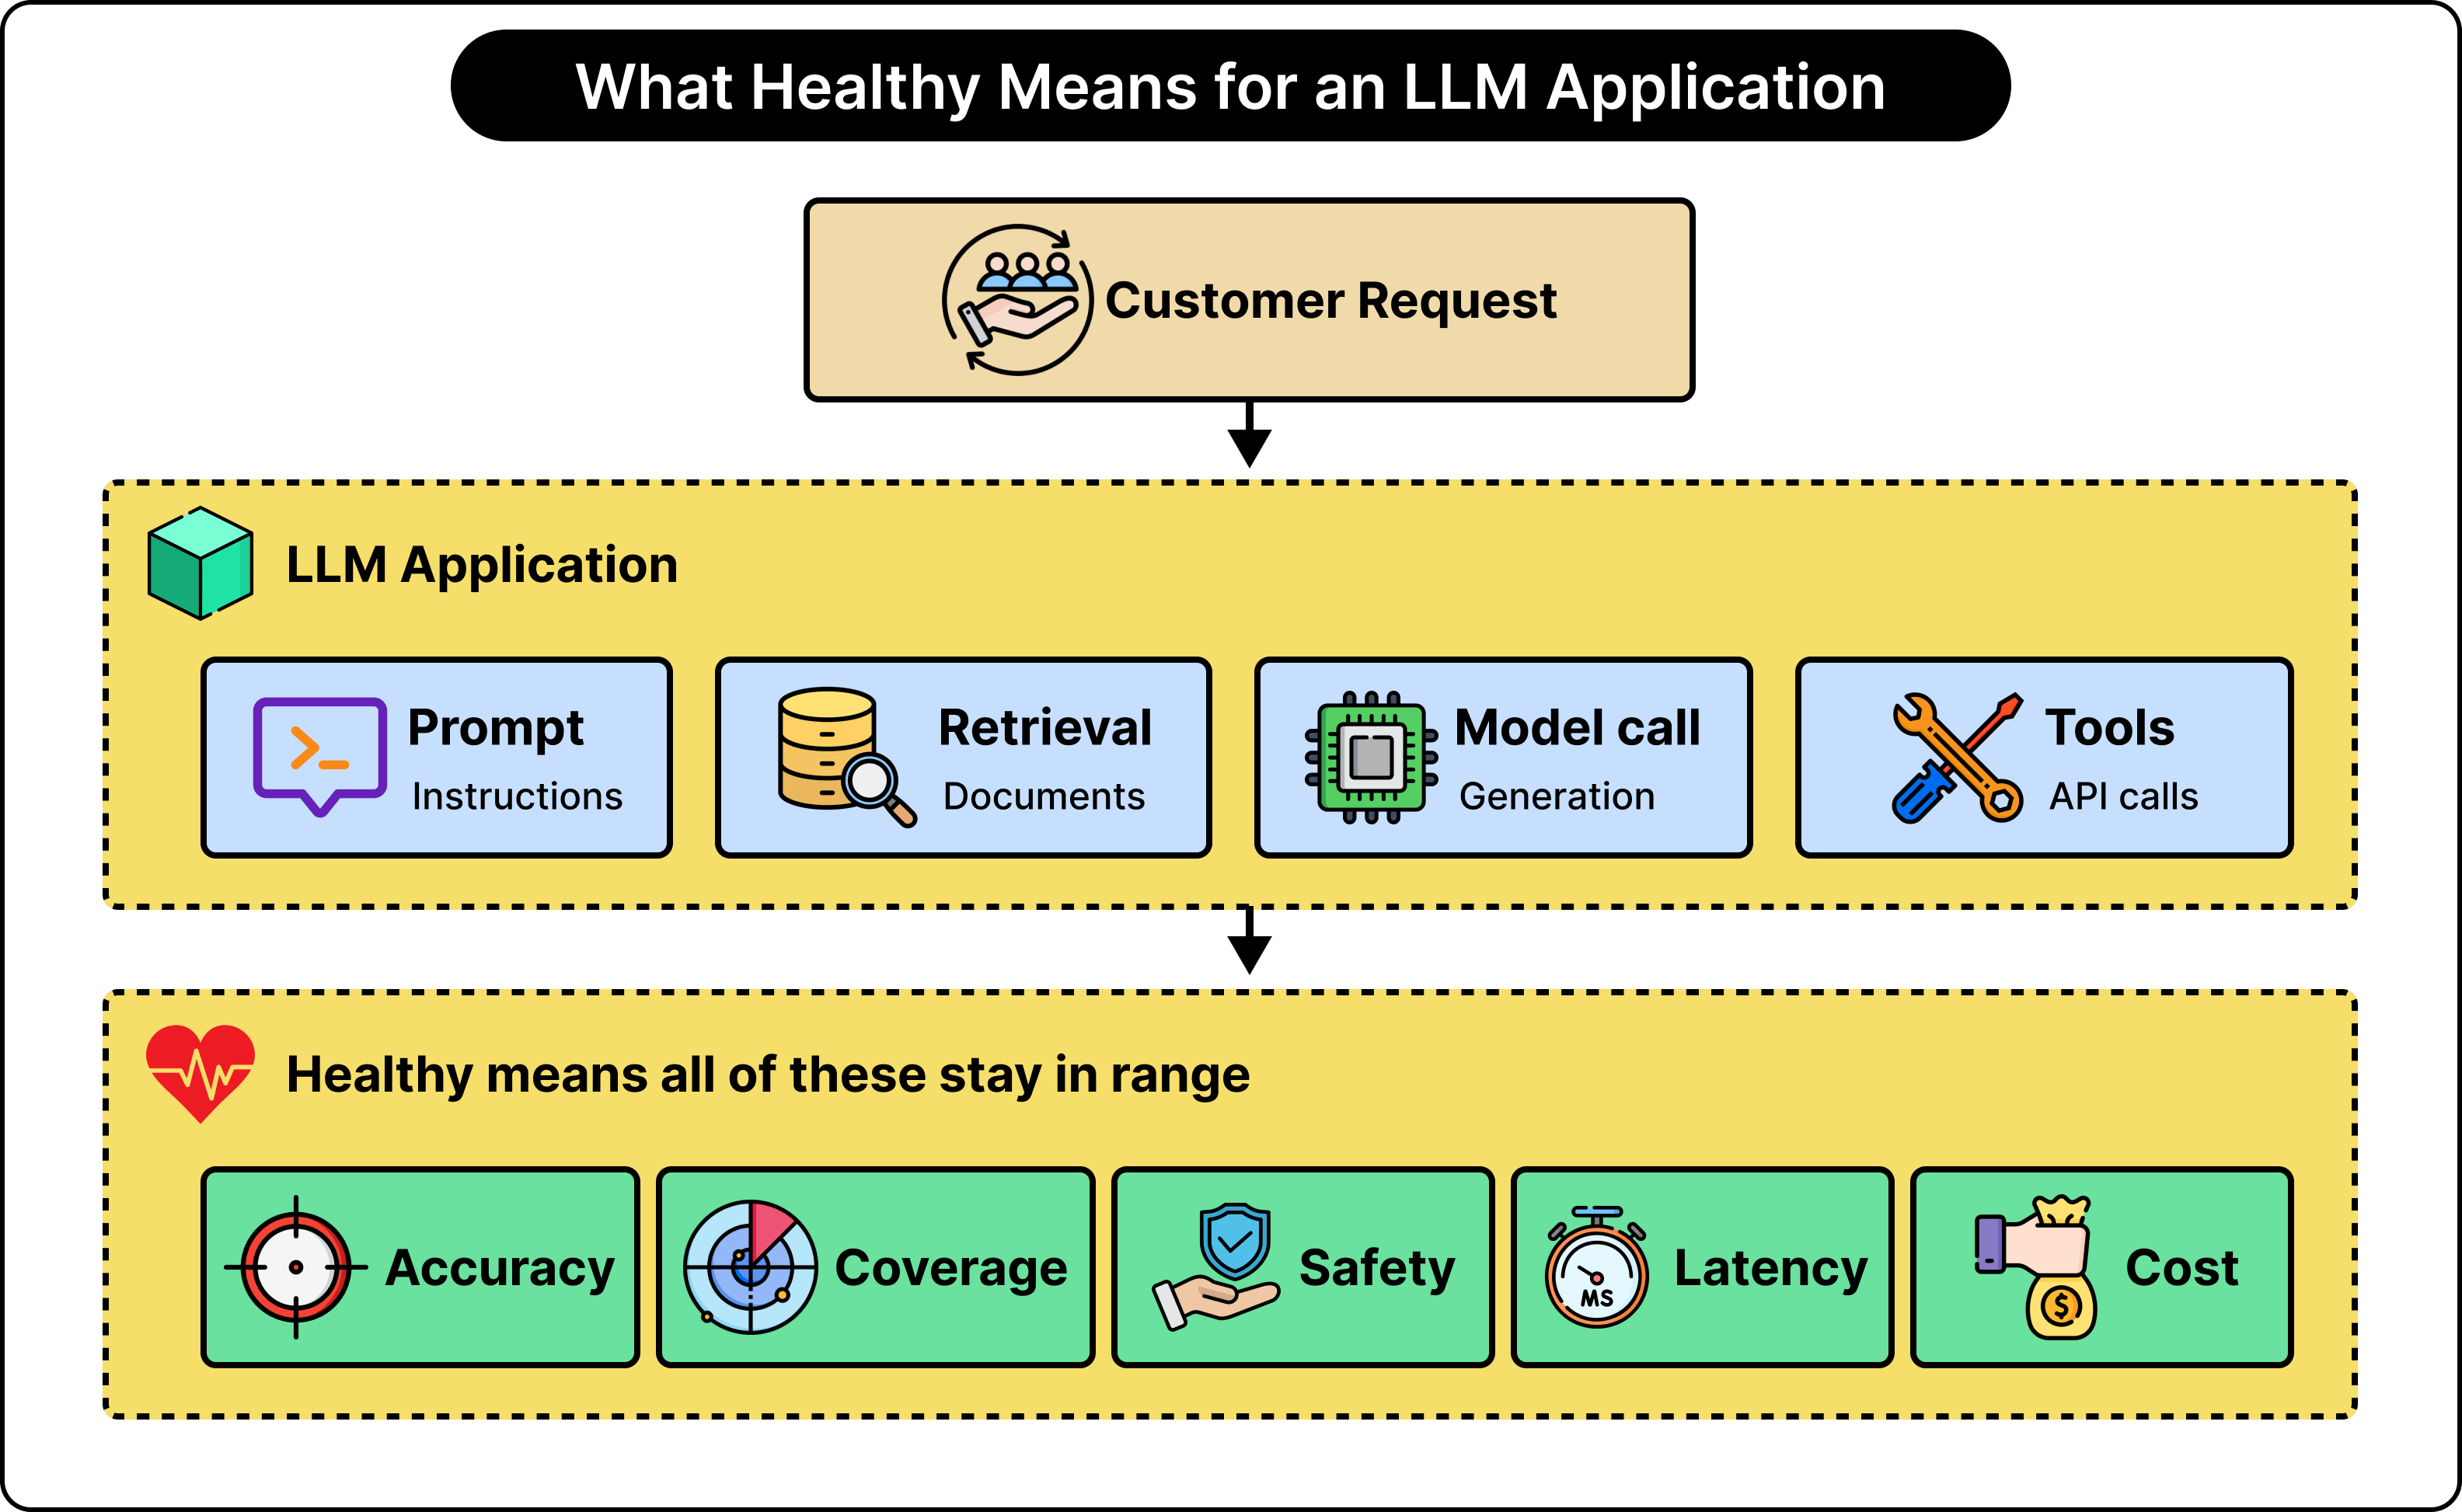
我们什么时候可以说一个 LLM 是健康的?
答案其实很简单:只要 LLM 能稳定地生成有用的结果,同时在准确性、安全性、速度、可靠性和成本上都保持在可接受的范围内,就可以认为它是健康的。以一个客服助手为例,我们不能仅凭“它有没有返回正确的输出?”这样一个问题就下结论。
我们需要考虑多个不同的问题:
它是否理解了客户的提问?
答案是否与公司文档的事实一致?
它是否完整回答了问题?
是否符合要求的语气和格式?
有没有编造不存在的政策?
是否拒绝了不应回答的请求?
响应时间是否在可接受范围内?
处理该请求的成本是否可接受?
可以看到,这些问题分别对应不同的质量维度,而每个维度都很重要。一个助手可能友好又切题,但答案在事实上有错;也可能很准确,却啰嗦到用户根本找不到答案;还可能回答得很好,但每次请求都要等 30 秒。因此,评估一个 LLM 时,我们必须衡量系统的多个方面。
我们也必须区分 LLM 本身的健康状况和应用层的健康状况。不能简单地把模型视为所有问题的根源。问题往往源于多种因素,例如 prompt 写错、文档缺失、检索逻辑不佳、工具调用错误、数据陈旧,或者是周边代码发生了变更。
为什么常规测试对 LLM 不够用?
传统软件测试通常依赖于确定性行为。当函数接收到已知输入时,测试期望得到特定输出。例如:
输入:add(2, 3)
期望输出:5
这种测试之所以有效,是因为存在一个唯一的正确答案。然而,LLM 的任务截然不同。以“解释为什么密码重置链接会过期”这个问题为例:
一种回答可能先讨论安全性,另一种回答可能先解释有效期。即使底层答案都是正确的,句子的表述方式也可能完全不同。
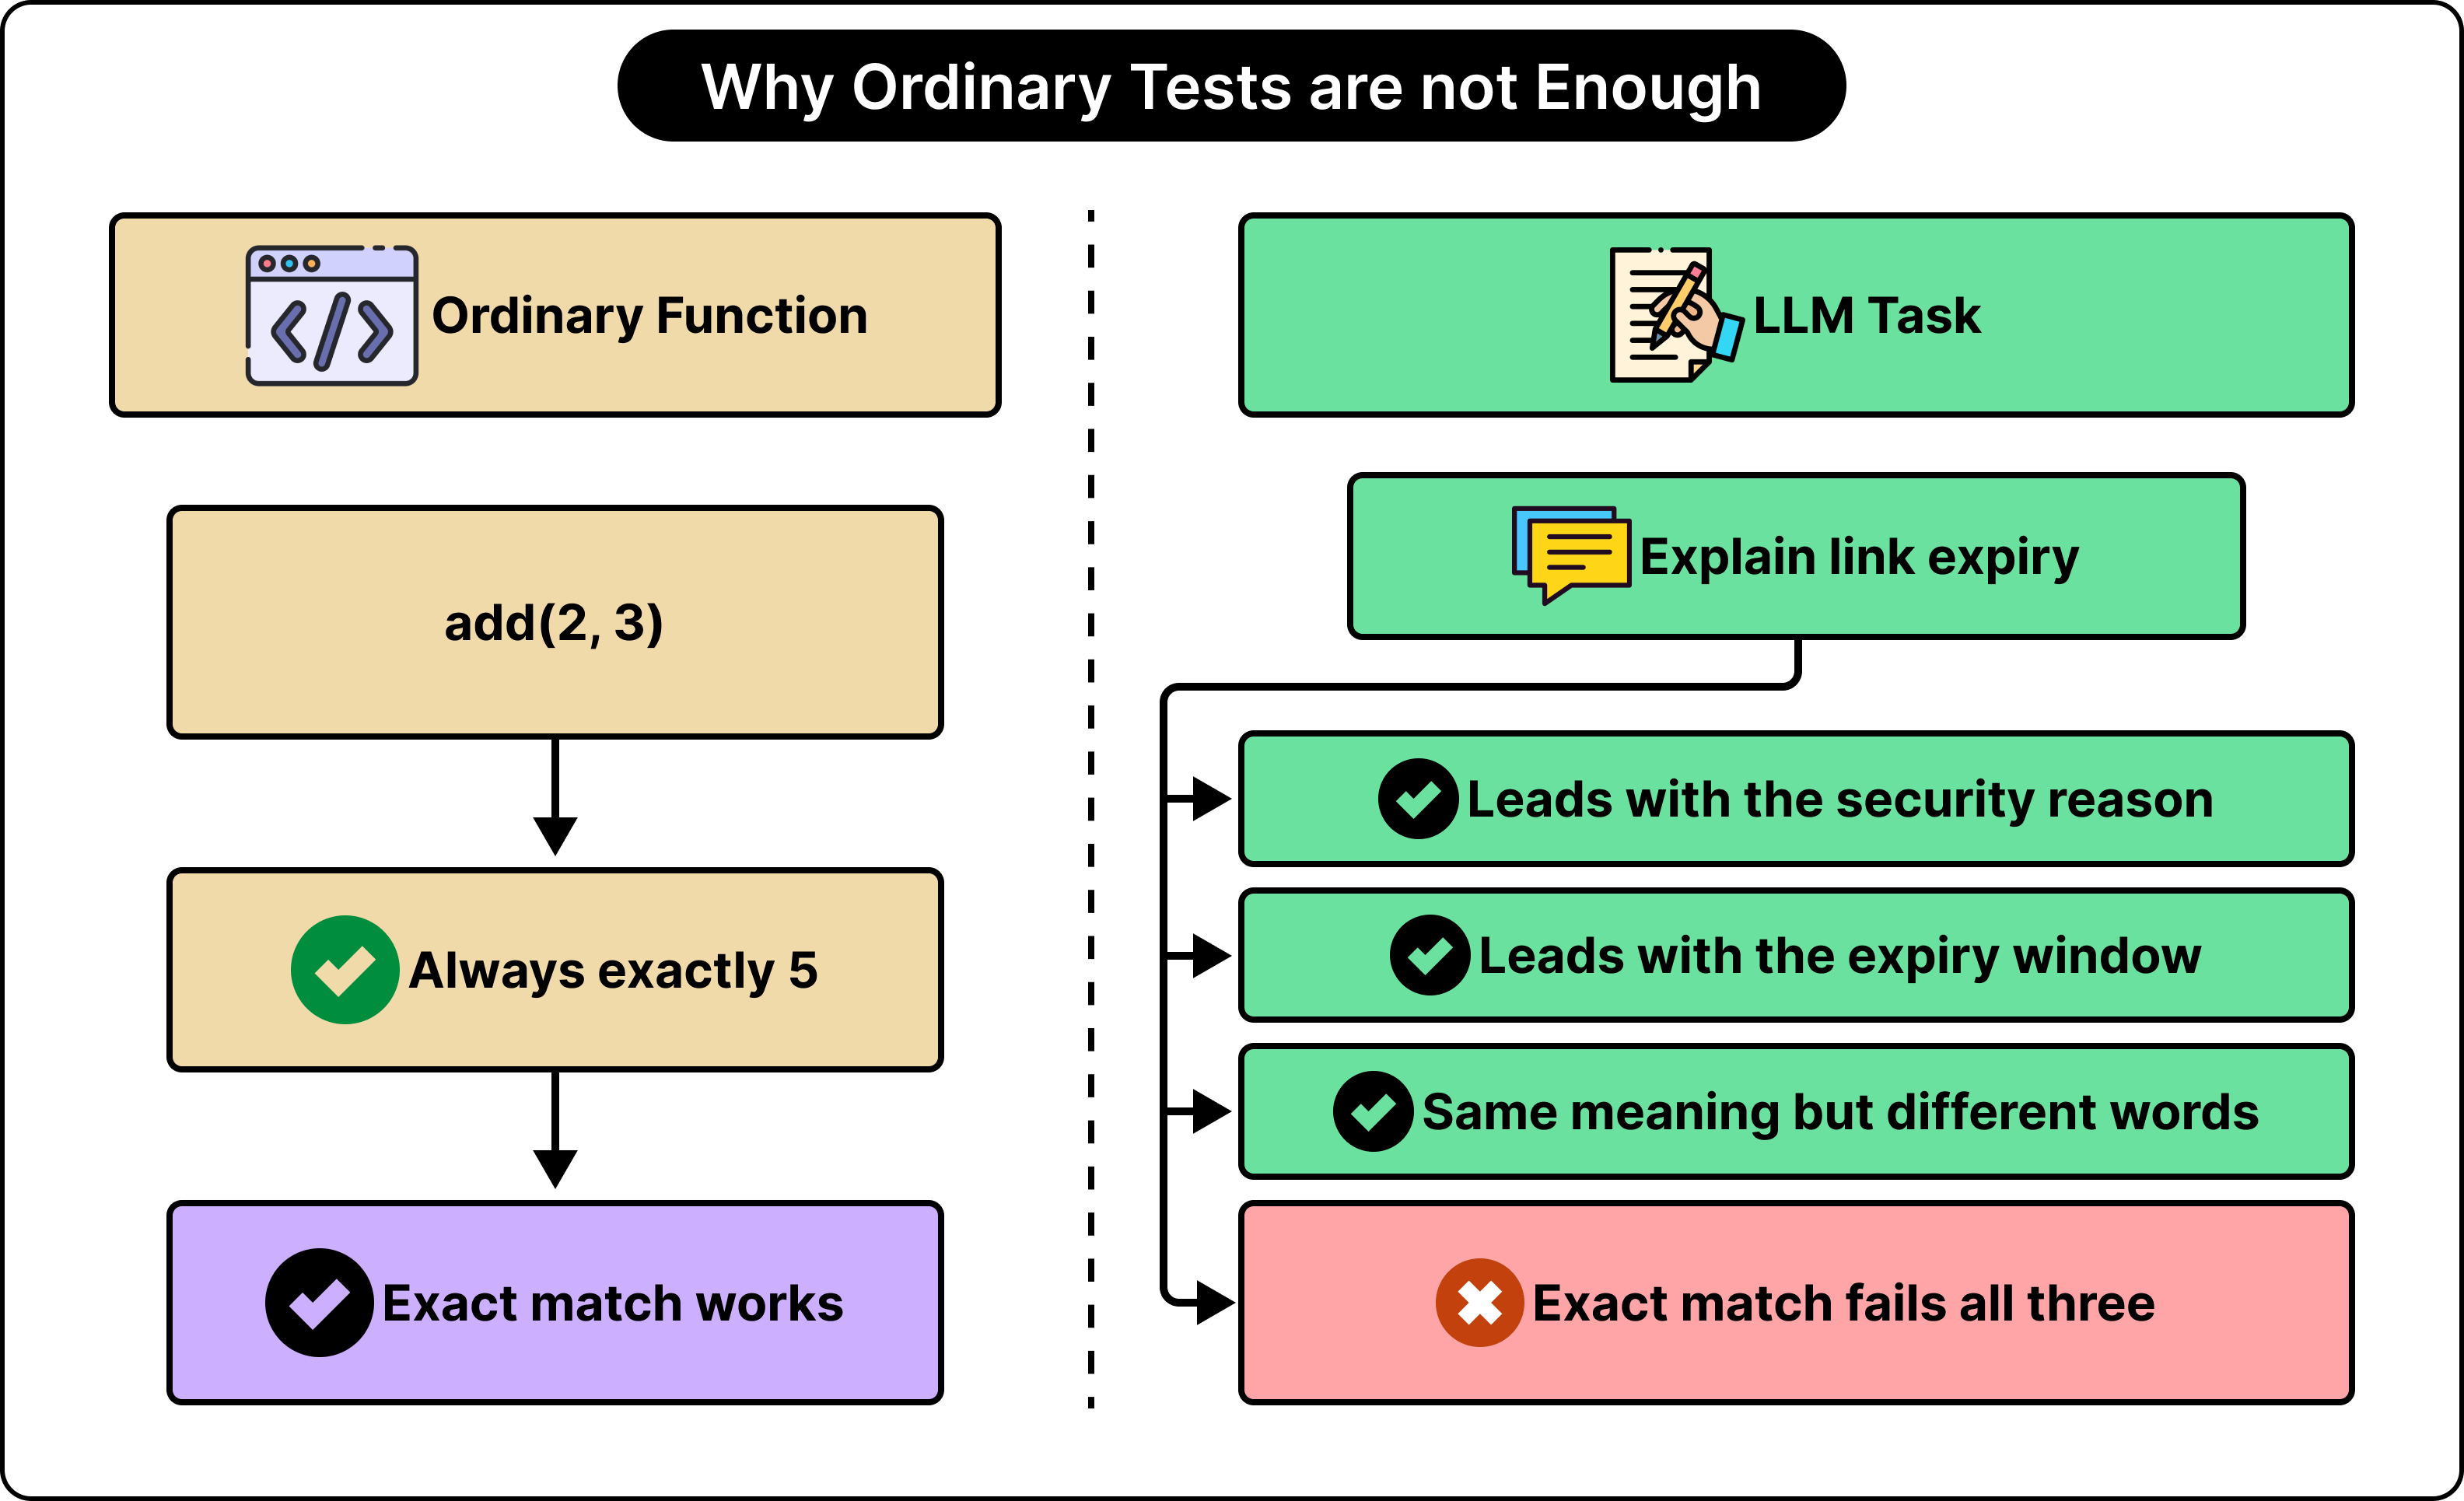
三个特性让 LLM 评估变得棘手。
首先,LLM 的输出并非确定性的。这是因为 LLM 采用概率方法生成答案。即使用相同的 prompt 和模型,答案也可能不同。提高模型的温度只会增加变数,但即便将温度设置得很低,也并非能让所有模型与基础设施的组合实现完美复现。
即使是精确的字符串比较,也可能将许多有效答案标记为失败。例如,“支付被拒,因为卡片已过期”和“卡片有效期导致支付失败”这两句话传达的信息是相同的。
其次,质量是多维度的,且带有一定的主观性。我们无法为答案的细节程度、语气或组织形式设定一个普适的标准。对开发者有用的回答,可能让普通用户感到困惑;短回复或许适合客服聊天场景,但更长、更详尽的回答可能更适合文档说明。
这并不意味着质量无法衡量,只是要求我们先明确定义所需的质量维度。例如,“给出好答案”这种目标过于模糊,无法用于测试。更好的做法是设定具体标准,如“直接回答问题,仅依据所提供的政策执行,并解释所有必要步骤”。
第三,正确性还取决于上下文。以“这笔订单能否退款?”为例,答案取决于订单日期、产品类型、账户状态、所在地区及当前退款政策等多个数据点。对某位客户正确的回答,对另一位客户可能就是错误的。
因此,要正确评估模型表现,必须纳入模型可获取的上下文信息,确保能够验证回答在该上下文中的准确性。
当然,对于 LLM 应用中确定性的部分,传统测试依然不可或缺。例如,JSON 解析、权限校验、计算逻辑、数据库操作、API 契约及工具执行等,仍应依赖常规的单元测试和集成测试。
基础评估循环
一个实用的 LLM 评估系统围绕一个循环流程构建,具体步骤如下:
收集具有代表性的测试用例。
在这些用例上运行应用。
通过多种评估方法检查结果输出。
将结果与当前生产环境版本进行对比。
拦截或深入排查造成关键功能回退的变更。
监控真实生产流量,发现测试集未覆盖的问题。
将新发现的失败案例补充到测试集中。
参见下图:
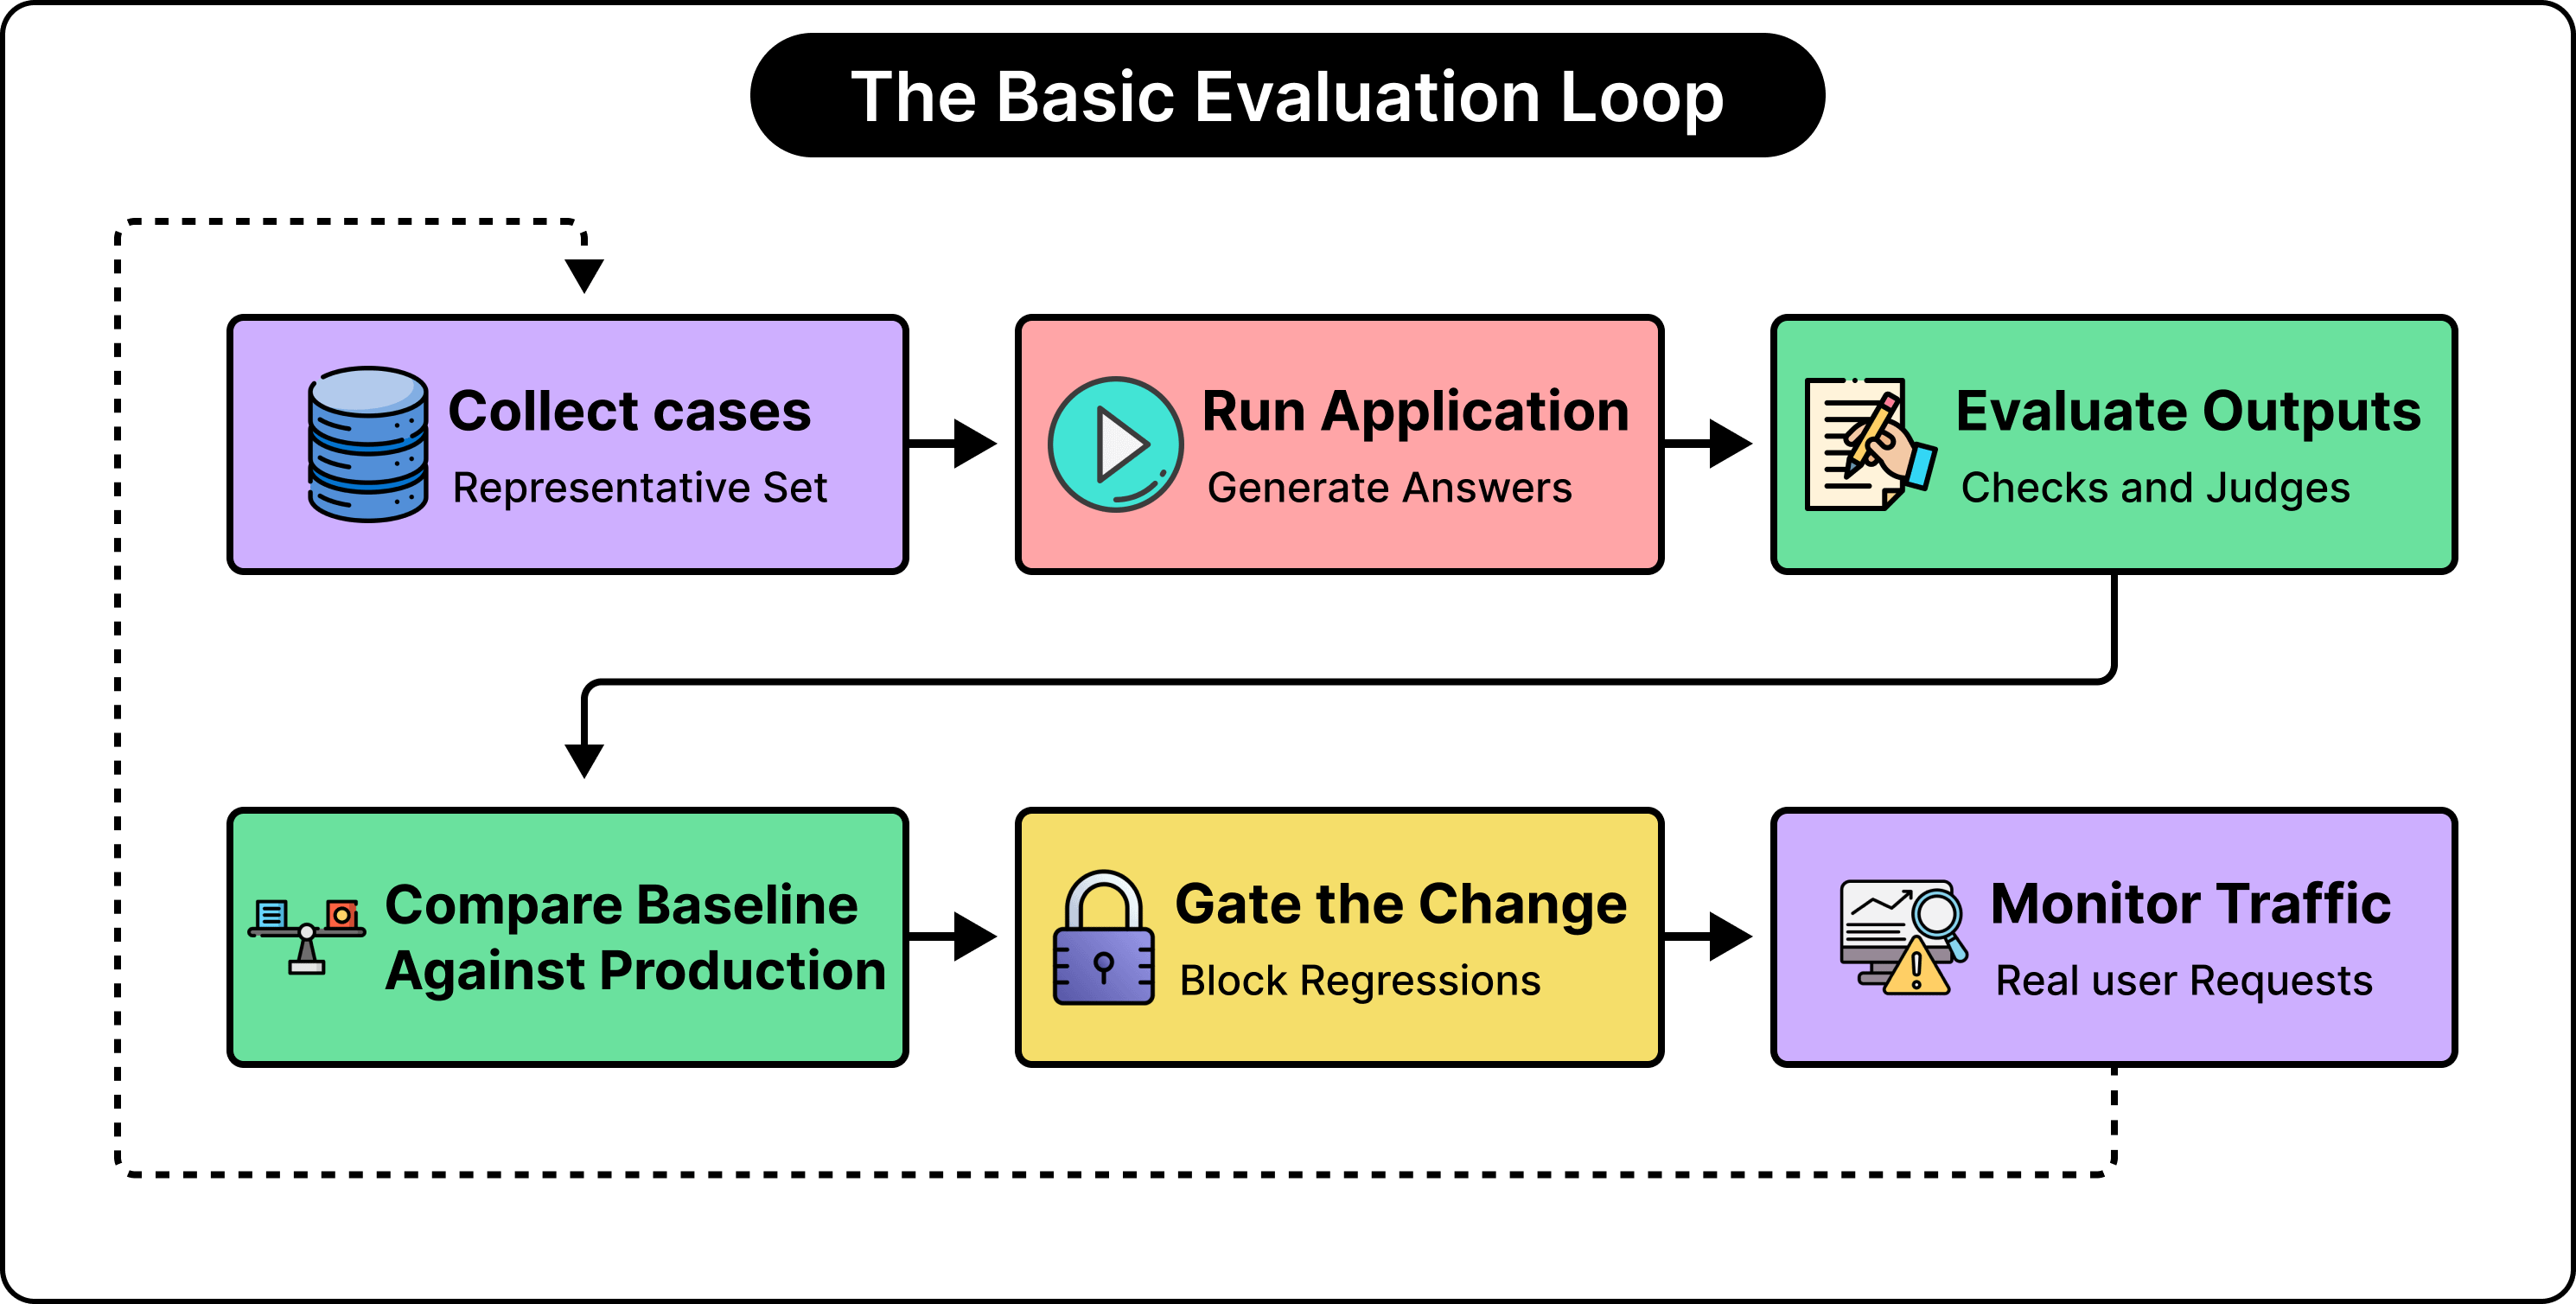
最后一步非常关键:我们需要持续扩充这份有用的评测数据集,加入更多样例。真实用户会不断暴露出意想不到的问题、模棱两可的指令、各种文档格式,以及系统可能出错的新方式,数据集也应随之增长。
用 Golden Dataset 实现可重复的 LLM 行为测试
Golden dataset 是经过精心整理的一组可能的输入,以及关于“针对这类输入,好的回答应该包含什么”的信息。它的作用类似于单元测试套件,但与单元测试不同,我们并不总是用完全相等来校验答案。
举个例子,退款助手的测试用例可能包含以下细节:
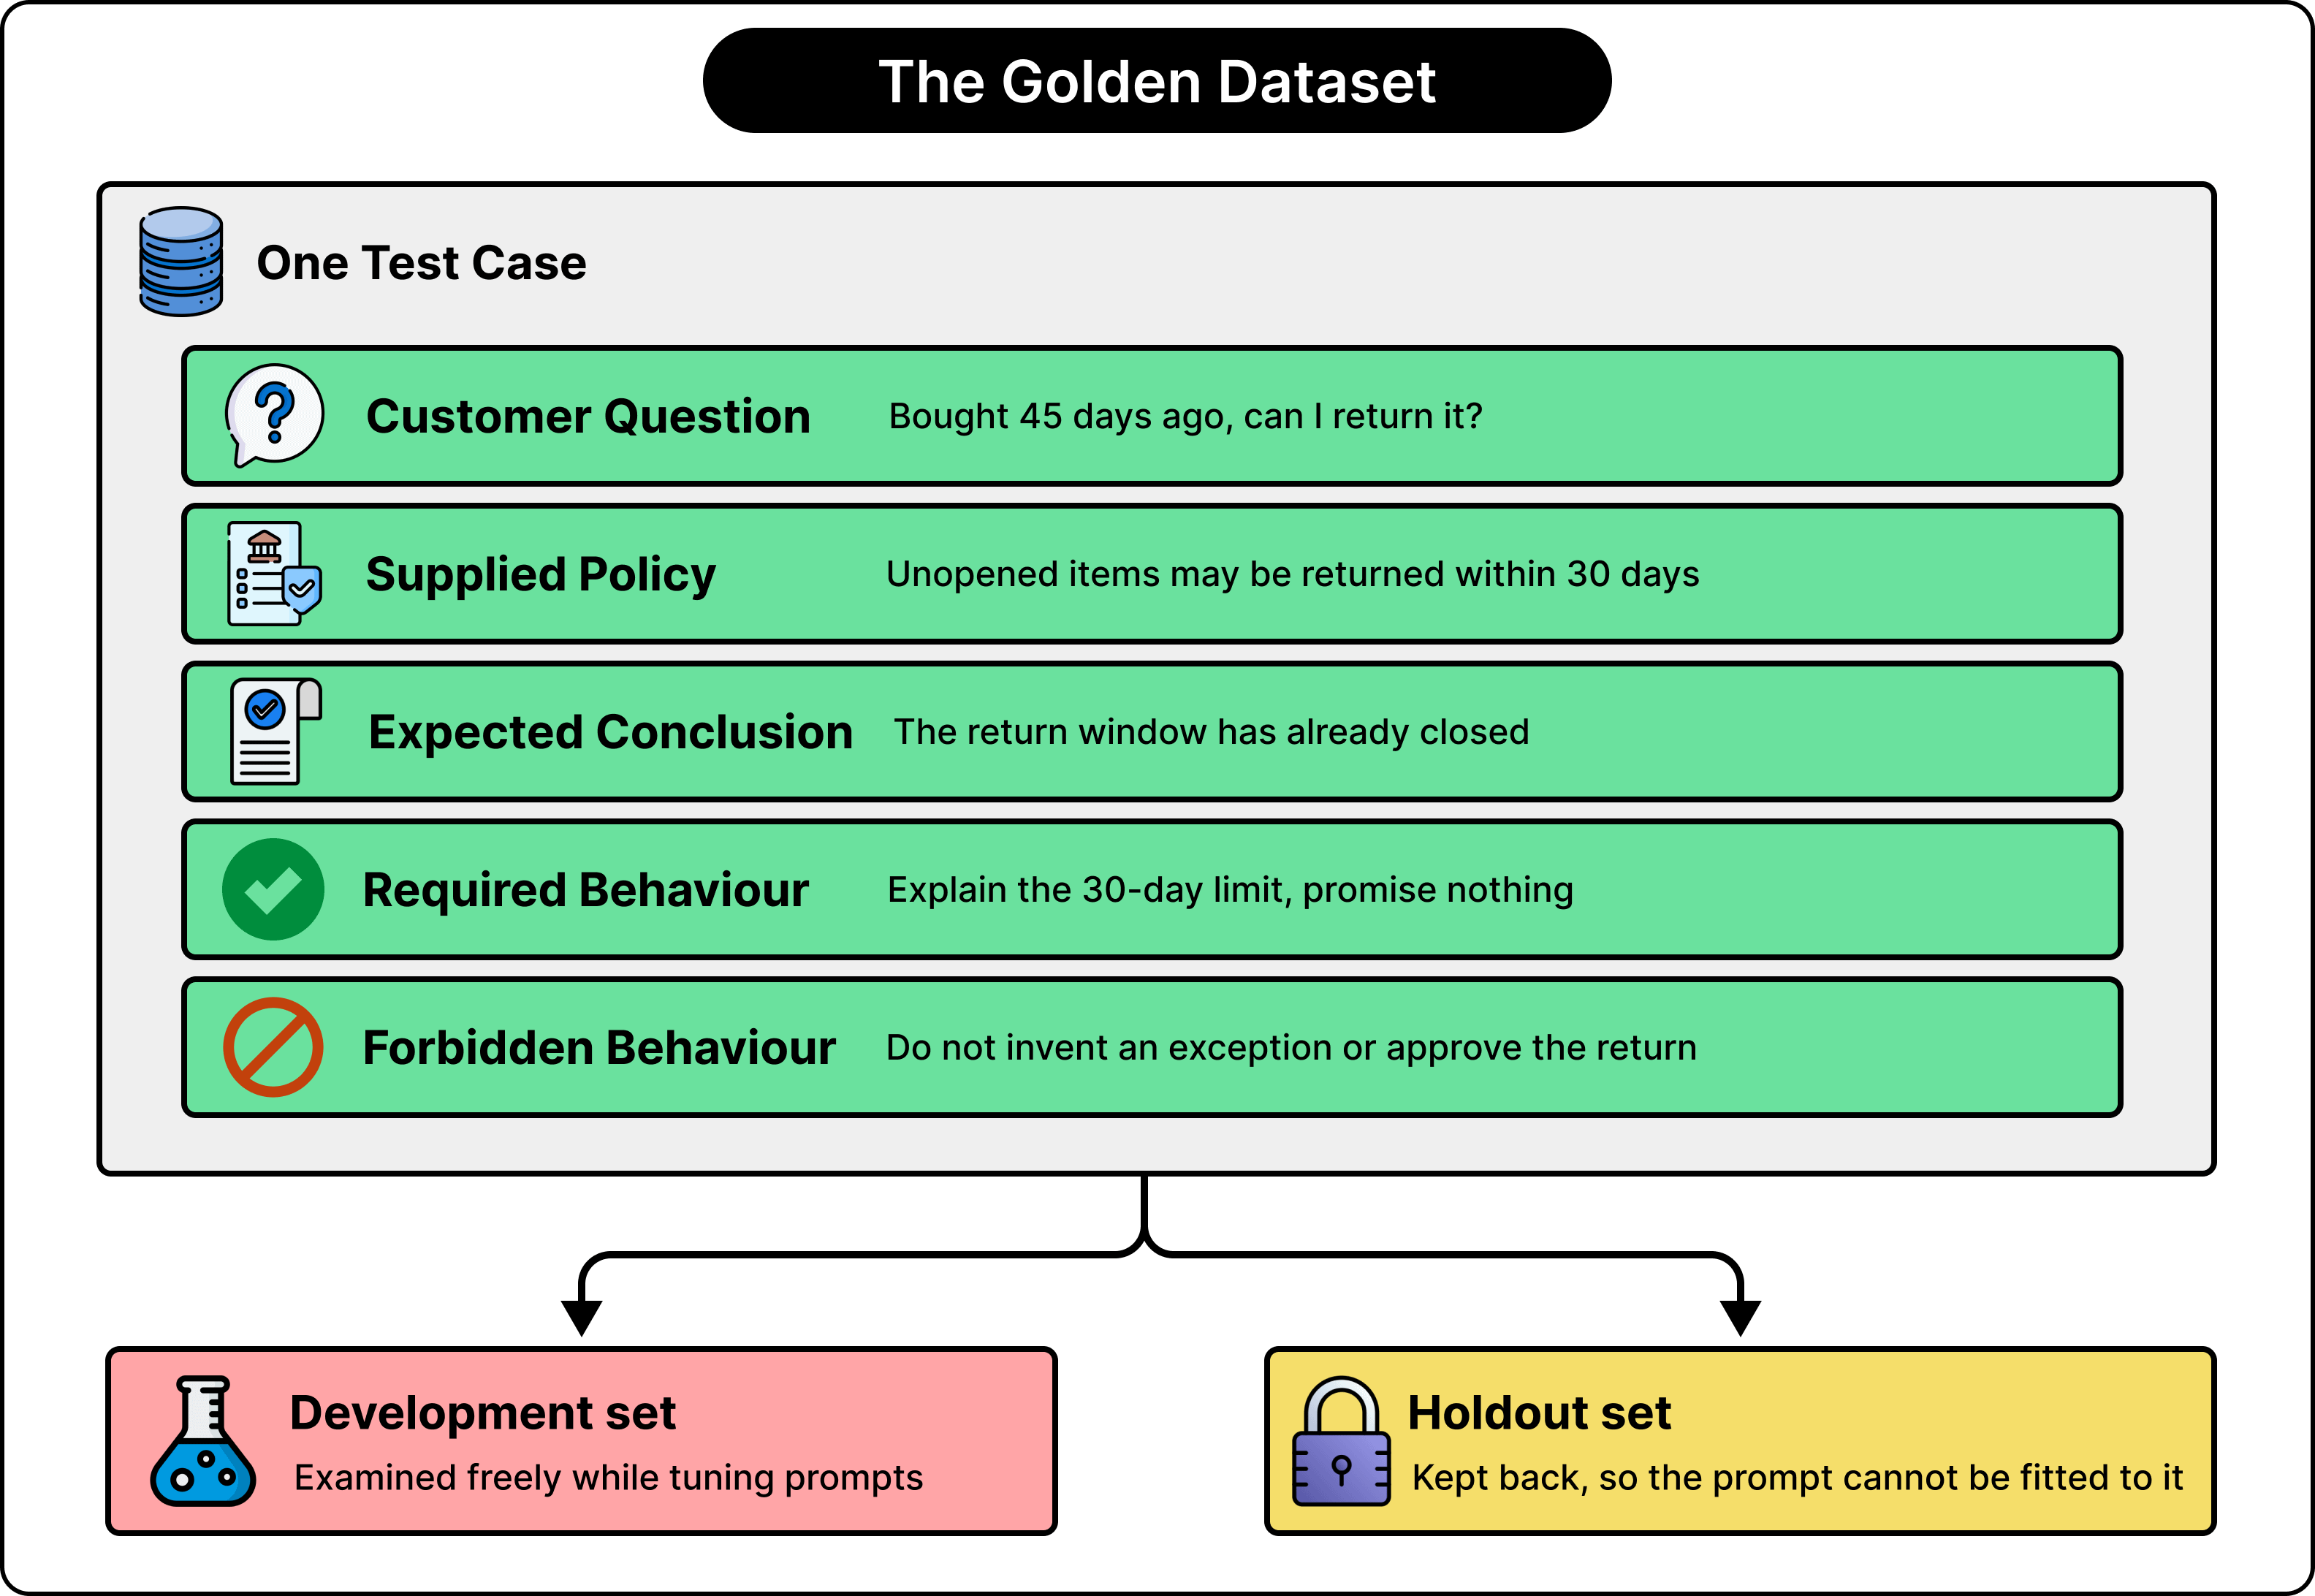
这种方式比提供一份写得完美的参考答案有用得多。因为同一个答案可以有很多种合理的表达方式,关键在于 LLM 能否在遵守既定约束的前提下做出正确的决策。
构建一个高质量的 golden dataset,不能只收录简单和常规的请求,理想情况下还应包括:
代表大多数真实流量的常见请求。
答错会造成严重后果的重要场景。
需要澄清的模糊问题。
所给资料中找不到答案的问题。
检索到的文档中嵌入的恶意或无关指令。
包括极短、极长、质量差以及(在相关场景下)多语言输入。
以往生产环境中的失败案例。
边界情况,例如在允许退货的最后一天当天申请退货。
我们还需要将数据集分组。开发集可在提示词迭代