
OpenAI如何利用自研大模型设计Jalapeño芯片
点击蓝字 关注我们
SUBSCRIBE to US
OPENAI
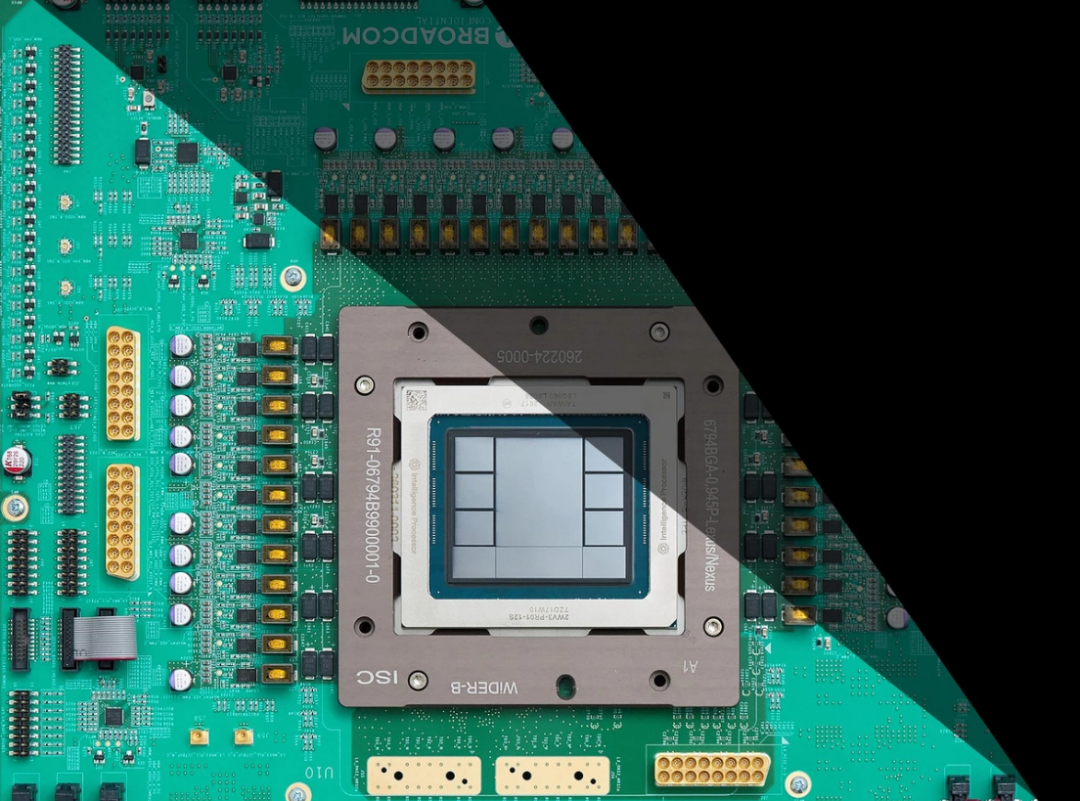
8月25日,OpenAI完整发布了首款AI加速芯片Jalapeño。Jalapeño最高可提供13.4千万亿次每秒的4位算力,搭载232GB当前最先进的存储器,内存带宽高达15.4TB/s。OpenAI给出的基准测试显示,相较于该公司目前正在使用的英伟达GB300芯片,Jalapeño的端到端延迟(从输入提示词到输出最后一个token的耗时)最高可降低至原来的1/3.6,同时功耗更低(https://inferencex.semianalysis.com/)。
Jalapeño大规模部署在OpenAI推理集群之后,上述指标能否转化为实际业务收益仍有待观察,但性能只是故事的一半。另一半在于芯片本身的设计流程 —— 正如大家所料,整个研发过程借助OpenAI自家大语言模型(LLM)实现加速。Jalapeño从最初架构构思到拿到首版硅片,用时不到20个月。从首版RTL(定义芯片逻辑的寄存器传输级代码)到流片、将最终设计交付工厂制造,仅间隔9个月。
这样的研发周期已经十分迅速,但专家认为,随着大语言模型持续迭代,并更深地嵌入芯片设计工具,该速度很快就会显得落后。不出所料,OpenAI十分看好这一机遇。OpenAI硬件副总裁Richard Ho表示:“模型赋予了我们工程师超强能力。工程师仍然主导研发工作,也是所有方案的最终裁定者。但他们做事效率大幅提升,能够探索更多设计路线。”
OpenAI依靠小型设计团队取得高效成果
Ho称,Jalapeño项目的设计团队在整个研发周期内平均规模不足百人;目前团队仍维持在约100人,正在推进第二代与第三代芯片的设计。这一人数涵盖硬件团队内从系统设计、软件到供应链的各类岗位,但不包含项目合作方博通(Broadcom)的人员。
OpenAI与博通的分工大致为:前者负责设计,后者负责落地实现。Ho表示,OpenAI团队承担端到端系统设计,涵盖推理加速器、存储层级结构以及网络互联模块;博通则负责“门电路层级之后的物理设计”。
与博通的合作,也让外界对OpenAI的研发速度产生了一些不同看法。智能体芯片设计初创企业Verkor.io联合创始人David Chin称:“他们公布的时间表可信度很高”,但他认为博通的助力是Jalapeño能够快速落地的关键。“如果换一家从零起步的公司,是不可能做到的。”Verkor.io另一位联合创始人Ravi Krishna评价,OpenAI的这个速度“成果相当亮眼”,但他补充道,如果项目在当下启动,依托能力持续增强的大语言模型,研发周期还能进一步缩短。
加州大学圣地亚哥分校杰出教授Andrew Kahng同样认为OpenAI的研发速度十分突出,称其“大概率属于当前业界顶尖水平”。Kahng回忆起2016年IEEE Design Automation Futures研讨会,该研讨会由他联合筹办(https://www.iwls.org/iwls2017/slides/keynote-andrew-kahng.pdf)。当年的主旨演讲嘉宾正是Richard Ho,彼时他还是谷歌的一名工程师。Ho当时对设计自动化有着鲜明观点,他将芯片设计所需的总耗时,定义为团队每日可完成迭代次数的函数。
OpenAI的大语言模型如何加速Jalapeño芯片设计
马里兰大学半导体项目与创新负责人Ankur Srivastava表示:“自动化技术本身在芯片设计领域已经存在数十年,这并非全新课题。”但大语言模型与以往自动化工具的差异,在于其理解自然语言和代码的能力。他称,这一特性让大模型尤其适合处理那些“仍处于问题的语言描述层面”的芯片设计任务。
OpenAI团队设计了一套利用该优势的工作流。OpenAI的前端工作流基于Accelerated Hardware Synthesis(XLS,加速硬件综合工具链)搭建,这套开源高层次综合工具链最初由谷歌开发。高层次综合属于芯片设计自动化技术,工程师可以在更熟悉的编程环境中完成芯片设计。在XLS工具中,芯片设计师能够使用DSLX(借鉴Rust语言的领域专用语言)以及C++等语言进行编码,随后XLS会将代码转换为Verilog —— 用于描述电子系统的硬件描述语言。
OpenAI技术专员Chris Leary表示:“我们当时在思考如何借助AI加快项目进度,而AI在类软件任务上表现要好得多。XLS在某种程度上近似软件,因此享受到了这一红利。”利里曾在谷歌任职期间发起XLS项目,他对这套工具的运行机制极为熟悉,这也对项目推进起到助力作用。
Kahng认同选用AI加速XLS这类高层次综合工具的思路具备合理性,因为该工具“更适合大语言模型处理”,并且能够实现快速迭代。“我认为这是一套具备普适价值的工作流,在未来会拥有长久的生命力。”
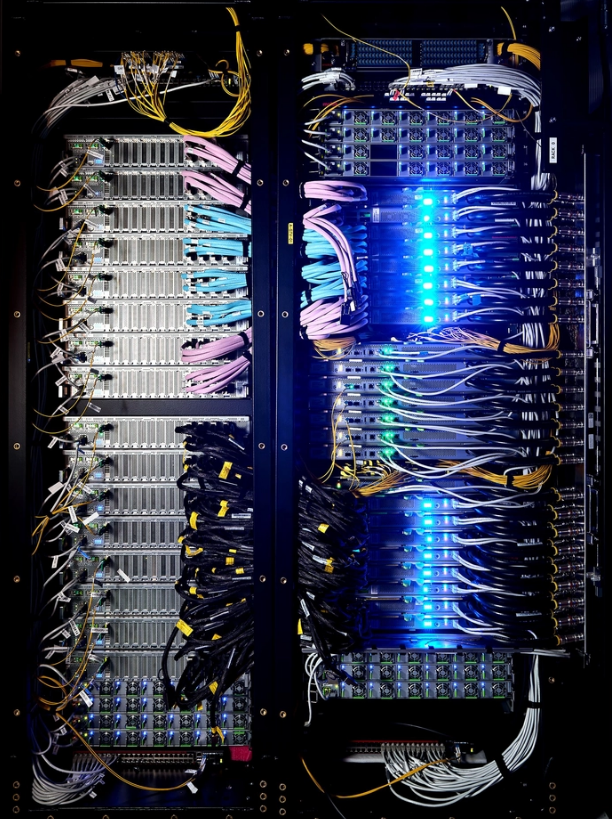
基于同样的思路,Jalapeño芯片团队将重心放在软件优化上。5月晶圆厂交付首批芯片样品后,团队利用内部AI模型开发配套软件,用以运行SemiAnalysis的InferenceX等基准测试。在DeepSeek多头隐式注意力内核基准测试中,芯片性能仅用约40小时,就从理论上限(由芯片算力与内存带宽决定)的0.31%提升至88.94%。Ho表示该结果可以复现,这能够缩短晶圆厂交付首版芯片到量产爬坡之间的周期。“我们所有的时间规划,都将建立在我们现已掌握这项能力的基础之上。”
尽管Ho与Leary在项目初期就预判了Jalapeño团队这套AI辅助工作流的大体框架,但OpenAI模型的迭代升级,仍带来了一些意料之外的惊喜。
OPENAI
Leary称,项目启动阶段使用的是OpenAI o3这类模型,该模型于2025年4月对外发布(但Jalapeño团队可提前使用)。而当项目收尾时,团队已经能够使用GPT-6 Astra的前身模型;这款模型直到2026年9月3日才对外公开。Leary介绍,新版模型可以直接编写Verilog代码,不再需要依靠XLS将常规编程语言做转换,并且已经接近能够独立操作专属设计工具。
Ho同时证实,团队使用了面向芯片设计微调的内部大语言模型,这类模型并未对外开放。他拒绝透露所用模型的详细信息,但补充道,Jalapeño团队与OpenAI研究团队展开了合作。Ho表示,虽然用于设计Jalapeño的部分特定模型没有公开,但项目目标是把本次研发获得的经验沉淀到公司商用大模型当中。“可以肯定地说,Astra以及后续模型,在芯片设计方面将会表现十分出色。”
AI在后端优化方面的作用相对有限,但这一情况或将改变
前文提到,OpenAI在Jalapeño项目中的大部分工作集中于芯片前端设计:涵盖从初始构思、编写RTL代码定义设计方案,到验证该方案物理落地后能否正常运行的一系列任务。而大部分后端设计工作,包括互连线布线、完成并验证时钟与功耗指标、向晶圆厂交付设计文件等,交由博通负责,由其推进芯片生产流程。
不过,这不代表OpenAI的工作流完全舍弃后端环节。Jalapeño团队配备了物理设计工程师,与博通的同行协作,针对芯片布局规划、布线等工作提供技术指导。在2026年IEEE Hot Chips 大会上,Ho与Leary公布了AI辅助物理设计优化带来的提升数据:相较于人工优化的基准方案,矩阵乘法单元的面积缩减10%。换言之,OpenAI称借助AI优化,可以在同样大小的硅片上集成更多电路(https://hc2026.hotchips.org/#clip=2whmy9evgf0g)。
博通采用自身内部工作流开展工作。博通团队无法使用OpenAI用于Jalapeño芯片设计的内部模型,但可以调用OpenAI对外公开的商用模型。
Verkor.io的Ravi Krishna认为,OpenAI在后端设计上采取的方案略显保守,他觉得这是由项目启动时间(2024年10月)造成的局限。他表示:“过去四五个月的模型能力已经取得长足进步。从2026年4月起,模型才真正开始更好地处理这类后端任务。”Verkor.io联合创始人Suresh Krishna也认同该观点,他说:“完全可以搭建一套智能体闭环流程,大幅加速设计流程的后端环节,不存在技术上的阻碍。”
Ho与Leary还暗示,相比于团队接下来的研发项目,设计Jalapeño所采用的这套工作流或许会显得有些传统。
Leary表示:“正如大家能够想到的,开发Jalapeño时我们追求尽可能快的推进速度。所以当时存在取舍:‘我们是花时间开展创新,还是采用过往经验验证可行的成熟方案?’”“到第二代芯片,我们获得一次重新规划的机会,可以统筹搭建所有我们想要的配套体系。”
Ho称,第二代芯片的工作流“在诸多环节都会引入AI技术”。他提到,在验证和物理设计环节,AI拥有更大的发挥空间。Leary补充,团队现已具备波形自动处理与查看工具。该工具可自动分析,定位与故障相关的芯片时钟信号,能够在硬件设计阶段提升调试效率。尽管预期会有这些改进,Ho与Leary明确表示,芯片设计无法实现完全自动化。Ho解释道:“我们并不是说任何人仅凭OpenAI代码平台Codex,就能直接打造顶尖前沿的AI/ML加速芯片。我们想表达的是,我们探索出了充分发挥Codex能力的特定方法,依靠小规模团队、短研发周期,产出高质量成果。”
微信号|IEEE电气电子工程师学会
新浪微博|IEEE中国
Bilibili | IEEE中国
· IEEE电气电子工程师学会 ·
往
期
推
荐