
在 FPGA 上重现 Voodoo Graphics 与 90 年代末游戏 PC
过去一个月,我一直在为 z486_MiSTer 添加功能、优化性能,主要是在跑 90 年代上半期的游戏。往前多想几年,我注意到另一个想探索的变化:3D 显卡的诞生。
给我留下最深刻印象的第一块卡就是 Voodoo,游戏是《极品飞车 II SE》。平滑的纹理、雾效,加上整体飞快的速度,让人感觉 PC 游戏进入了一个新时代。既然 z486 CPU 已经有了,我能不能在 FPGA 上重现那种体验?
这次绕道折腾的成果就是 zSST——一个用 SystemVerilog 实现的 3dfx Voodoo Graphics(即 SST-1)。配上我的 z486 CPU 和周边 PC 硬件,就构成了 z486 XL:一台在 Xilinx KV260 开发板的可编程逻辑里运行、带 Voodoo 图形的 DOS PC。《古墓丽影》如今可以用它原生的 3dfx 渲染器运行了。
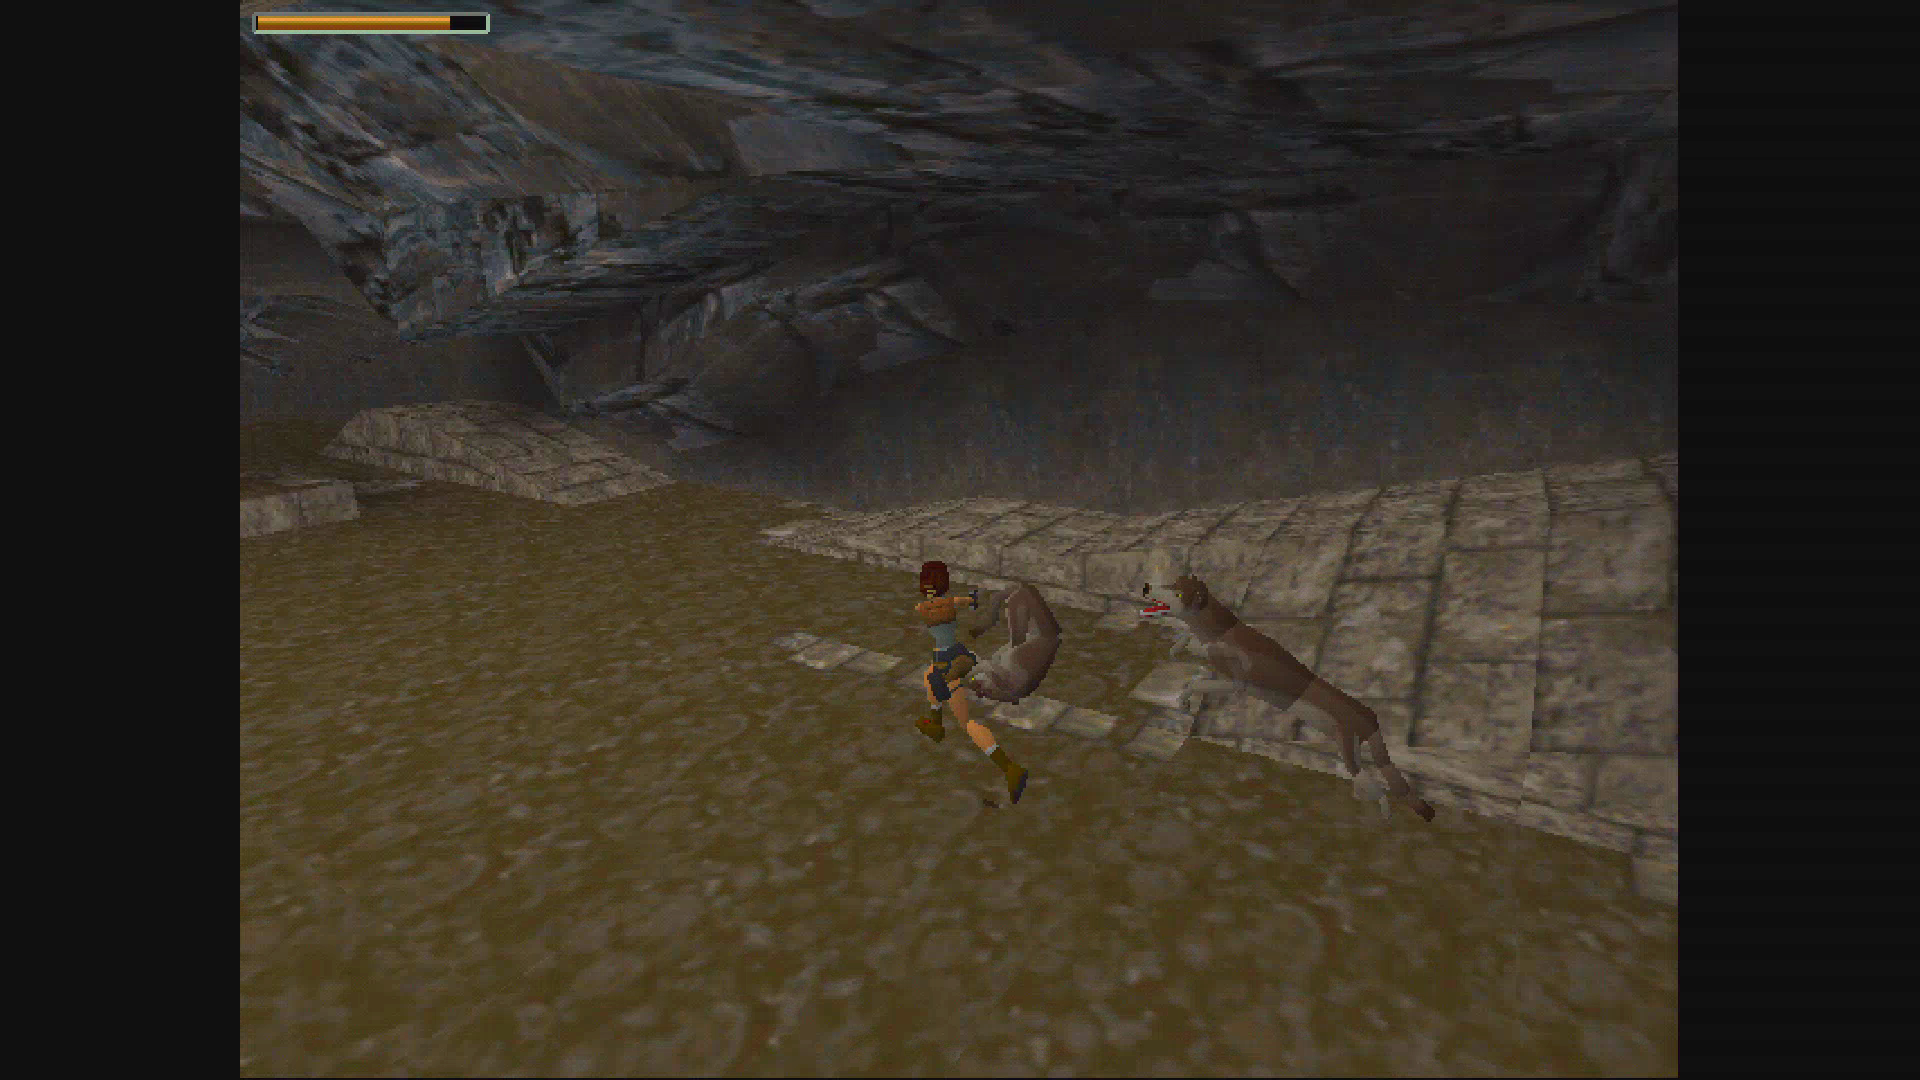
zSST 实现了 Voodoo 的大部分核心功能:三角形预处理、纹理过滤和 mipmap、深度测试与 alpha 测试、雾效、混合、抖动、帧缓冲访问以及缓冲区交换,定点和浮点两种 setup 接口都支持。硬件游戏测试目前仍集中在《古墓丽影》上,更广泛的兼容性和后续几代 Voodoo 就留待日后再做了。
CPU 和渲染器在 KV260 上以 100 MHz 运行。这块板子的逻辑资源、DSP 单元、片上存储和 DDR 带宽都足以容纳整个设计,而 DE10-Nano 则装不下这个图形模块。KV260 使用板载 DDR,无需外接 SDRAM 模块。
从编程模型入手
幸运的是,相关资料很丰富。3dfx 在 1999 年就开源了 Glide 代码,早于 NVIDIA 在 2000 年 12 月收购其核心图形资产。现存的 Glide 源码 和 SST-1 规格书 详细介绍了软件如何准备三角形、配置像素管线以及管理纹理和帧缓冲。
这份规格书是行为目标,而非电路原理图。它说明了软件写入寄存器后应发生的变化,但保留了许多实现细节上的自由度。86Box 为复杂的渲染行为提供了有用的参考。早前的 MAME Voodoo 工作 也是这项保护历程中的一部分。SpinalVoodoo 则提供了特别有用的 Glide 追踪数据和参考截图,用于测试验证。
从三角形到 3D,每时钟周期处理一个像素
Voodoo Graphics 将三角形转换为像素,大部分 3D 运算工作交给宿主 CPU。其命令接口出奇地紧凑:五个主要命令寄存器驱动加速卡。
| 寄存器 | 动作 |
|---|---|
triangleCMD |
开始渲染一个已准备好的三角形。 |
ftriangleCMD |
通过浮点设置接口开始三角形渲染。 |
nopCMD |
刷新管线;可选重置统计计数器。 |
fastfillCMD |
清除经过裁剪的矩形色值和/或深度数据。 |
swapbufferCMD |
切换显示缓冲区,立即切换或同步垂直回扫。 |
两个三角形命令启动相同的渲染管线。其他寄存器保存坐标、渐变和渲染状态,内存映射区域则用于上传纹理和直接访问帧缓冲。主要的绘制图元就是一个准备好的三角形。
对于游戏开发者,Glide 提供了更友好的接口:
void grDrawTriangle(const GrVertex *a, const GrVertex *b, const GrVertex *c);
在发起调用之前,宿主 CPU 会先对 3D 几何体进行变换,计算顶点光照,执行裁剪,并将其投影到屏幕上。随后,Glide 将屏幕空间中的三角形及其参数梯度准备好——这些梯度用于在三角形表面插值属性——并写入三角形命令以启动渲染。与 GeForce 256 等后续 GPU 不同,SST-1 没有硬件级的变换与光照引擎。
尽管如此,加速器仍有大量工作要做。光栅化器负责判断哪些像素中心位于三角形内部,并插值它们的颜色、深度和纹理坐标。纹理单元则负责获取和过滤纹素(texel);帧缓冲单元负责混合颜色,应用可见性测试和雾效,与现有图像进行混合,最后写入结果。
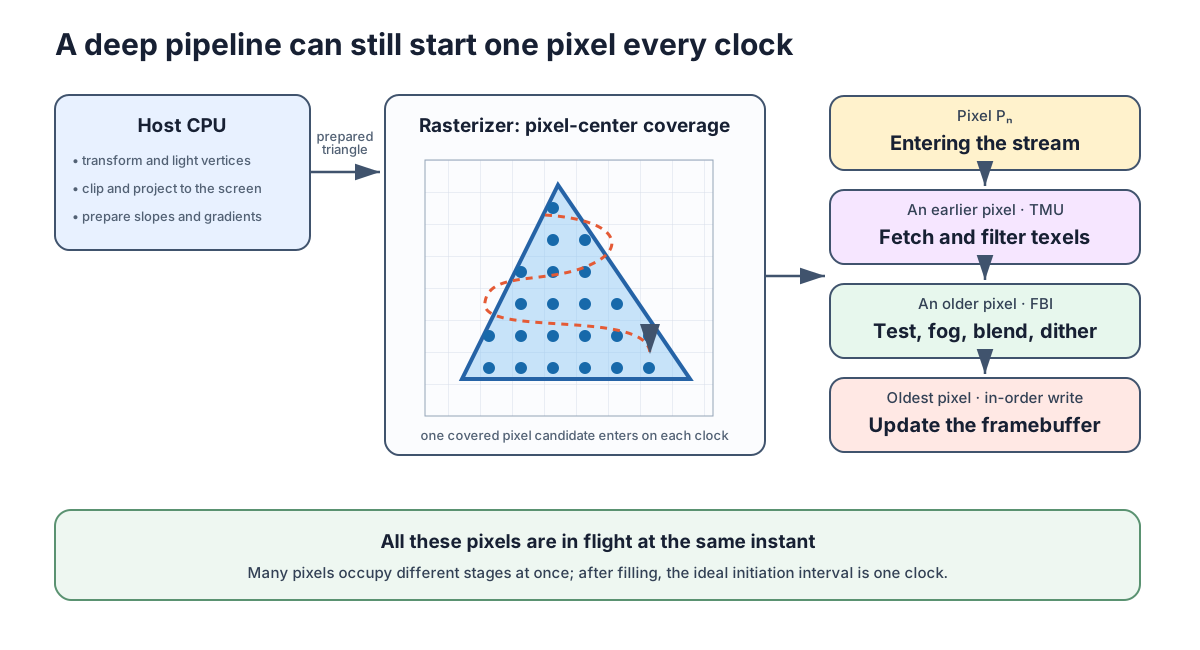
原始显卡将上述工作分配给两块专用 ASIC:FBI(帧缓冲接口)和 TREX(纹理映射单元,通常简称 TMU)。在 50 MHz 的图形时钟频率下,其标称峰值性能为每时钟周期输出 1 个经纹理采样和深度测试的像素:即每秒 5000 万像素。
“每时钟周期一个像素”并不意味着单个像素在一个时钟周期内就能处理完毕。它指的是流水线的不同阶段可以同时处理不同的像素:当一个像素正在做纹理映射时,较早的像素可能正在混合,而另一个像素可能正在写回。一旦流水线填满,在内存带宽跟得上的情况下,理想状态下它每个时钟周期都能接收并完成一个像素。
这正是固定功能流水线的魅力所在。软件渲染器需要为每个像素执行大量指令;而专用硬件可以让这些工作在一串连续的像素流中重叠执行。Voodoo 让纹理丰富的 3D 游戏以流畅的 30 FPS 或更高帧率运行——这也是它如此受欢迎的重要原因。
构建像素流水线
与 x86 CPU 相比,算术通路非常规整。让我们跟随一个像素,从插值参数开始,经过纹理映射和颜色运算,最终到达帧缓冲,首先看看这些数值是如何表示的。
浮点接口背后的定点数
浮点运算是现代 GPU 编程的核心。SST-1 正处于一个有趣的过渡期:软件可以提交浮点数值,但渲染机制基本工作在定点数上——也就是带有隐含缩放因子的整数。
| Setup 值 | 定点寄存器格式 |
|---|---|
| 屏幕 X 和 Y | 12.4 |
| 红、绿、蓝、alpha | 12.12 |
| 深度 Z | 20.12 |
| 纹理 S/W 和 T/W | 14.18 |
| W 的倒数 | 2.30 |
这里 12.4 表示二进制小数点前有十二位(含符号位),后面有四位小数位。因此屏幕坐标 10.5 会被存成整数 168:编码时乘以 16,解码时除以 16。这些小数位让光栅化器能够处理位于像素中心之间的顶点。
fvertex、fstart 以及浮点梯度寄存器接受 IEEE 单精度值。SST-1 会把它们转换成内部定点表示,zSST 也遵循这一约定。三角形准备好之后,沿扫描线推进主要是给每个插值参数加上一个预计算的增量。大量逐像素的计算 thus 变成了简单的整数加法。
一个像素对应四个纹素
为了实现透视校正纹理映射,TMU 会插值 S/W、T/W 和 1/W,然后把前两者除以第三个来恢复纹理坐标。这样即使表面逐渐远去,地面或墙壁的纹理也能保持正确的透视效果。TMU 还会选择一个mip 级别:当像素覆盖纹理表面较大区域时,使用纹理的缩小版本。这能减少远处的走样和闪烁。
接着双线性滤波会把采样位置周围四个相邻纹素(即纹理上的像素)组合起来:先横向混合上面一对,再混合下面一对,最后在这两个结果之间做纵向混合。小数位置决定混合权重,从而在纹素颜色之间产生平滑过渡,而不是从一个颜色突兀地跳到另一个。
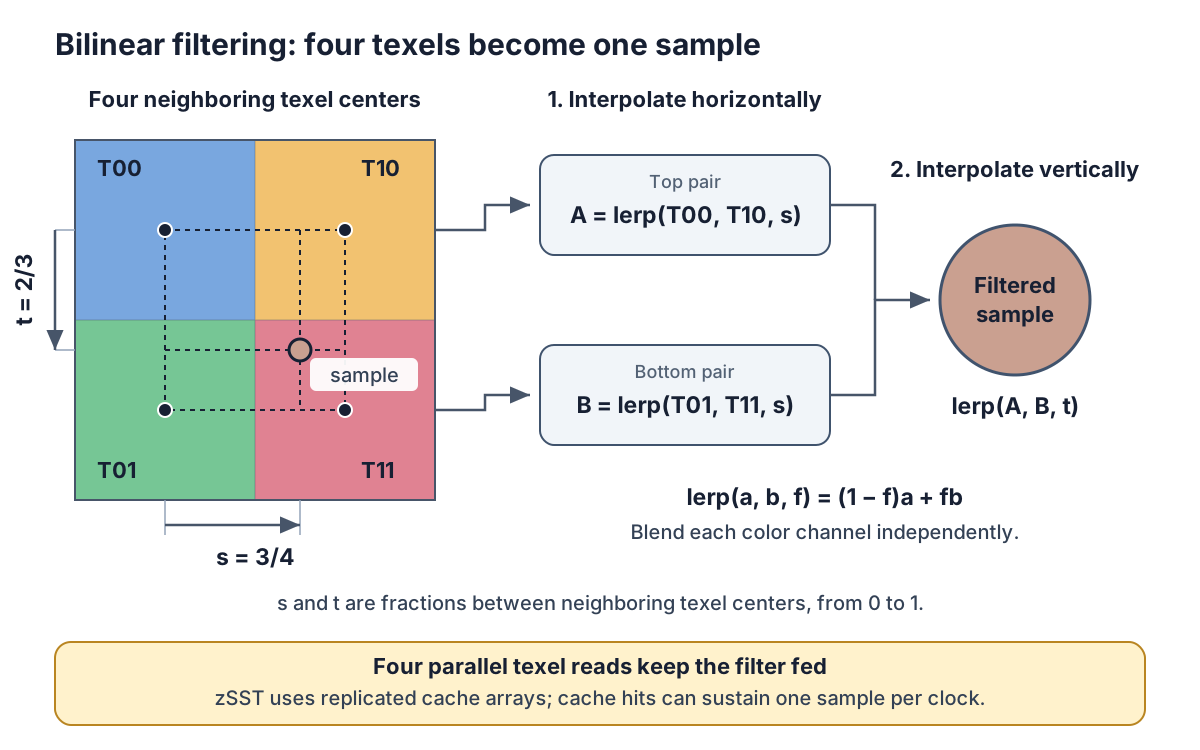
zSST 的前端采用四级流水线,负责透视和细节层次(Level-of-Detail)计算。地址生成和缓存查找提供纹理素,两个寄存解码级则将其存储格式转换为颜色,用于滤波和纹理组合。基于调色板(Palette)和 NCC 编码的纹理需要不同的解码规则,但最终都汇入同一像素流。
颜色、测试、雾效与混合
当纹理和帧缓冲数据就绪后,zSST 的 FBI 像素路径使用六个寄存级:
| 阶段 | 主要工作 |
|---|---|
| F0 | 选择源数据,检查色度键(Chroma Key),准备 Z/W 深度值 |
| F1 | 应用颜色和 Alpha 混合函数 |
| F2a | 执行 Alpha/深度测试,查找雾效系数 |
| F2b | 应用雾效 |
| F3 | 重建目标颜色并执行 Alpha 混合 |
| F4 | 转换至帧缓冲精度,抖动并应用写入掩码 |
这些阶段边界的划分旨在满足 FPGA 的时钟目标。SST-1 规格书描述了相关操作,但未透露原始 ASIC 的确切流水线寄存器配置。例如,将雾效查找与雾效应用分离,既避免了单周期内存在过长算术路径,又保留了每时钟周期处理一个像素的能力。
结果写入后缓冲。随后,通过垂直同步的缓冲交换显示完成图像,避免在扫描输出过程中中途切换缓冲。原始 Voodoo 是纯 3D 加速卡,闲置时会透传普通 VGA 卡的输出。z486 XL 在 FPGA 系统内实现了对应逻辑,在 PC VGA 输出与 zSST 显示输出之间进行选择。
难点:从内存供给数据
zSST 的像素流水线实现起来相对简单,至少比 z486 的 CPU 流水线省事。但要喂饱它就难得多了。一次双线性采样需要从四个不同地址读取纹理元素(texel),而经过深度测试并混合后的像素还要读出原有的深度和颜色,再写回新值。这些访存操作如果串行进行,吞吐量会迅速崩掉。结果,我在内存系统的设计、调优和调试上花的时间,比算术流水线本身还多。
原版显卡是如何供像素的
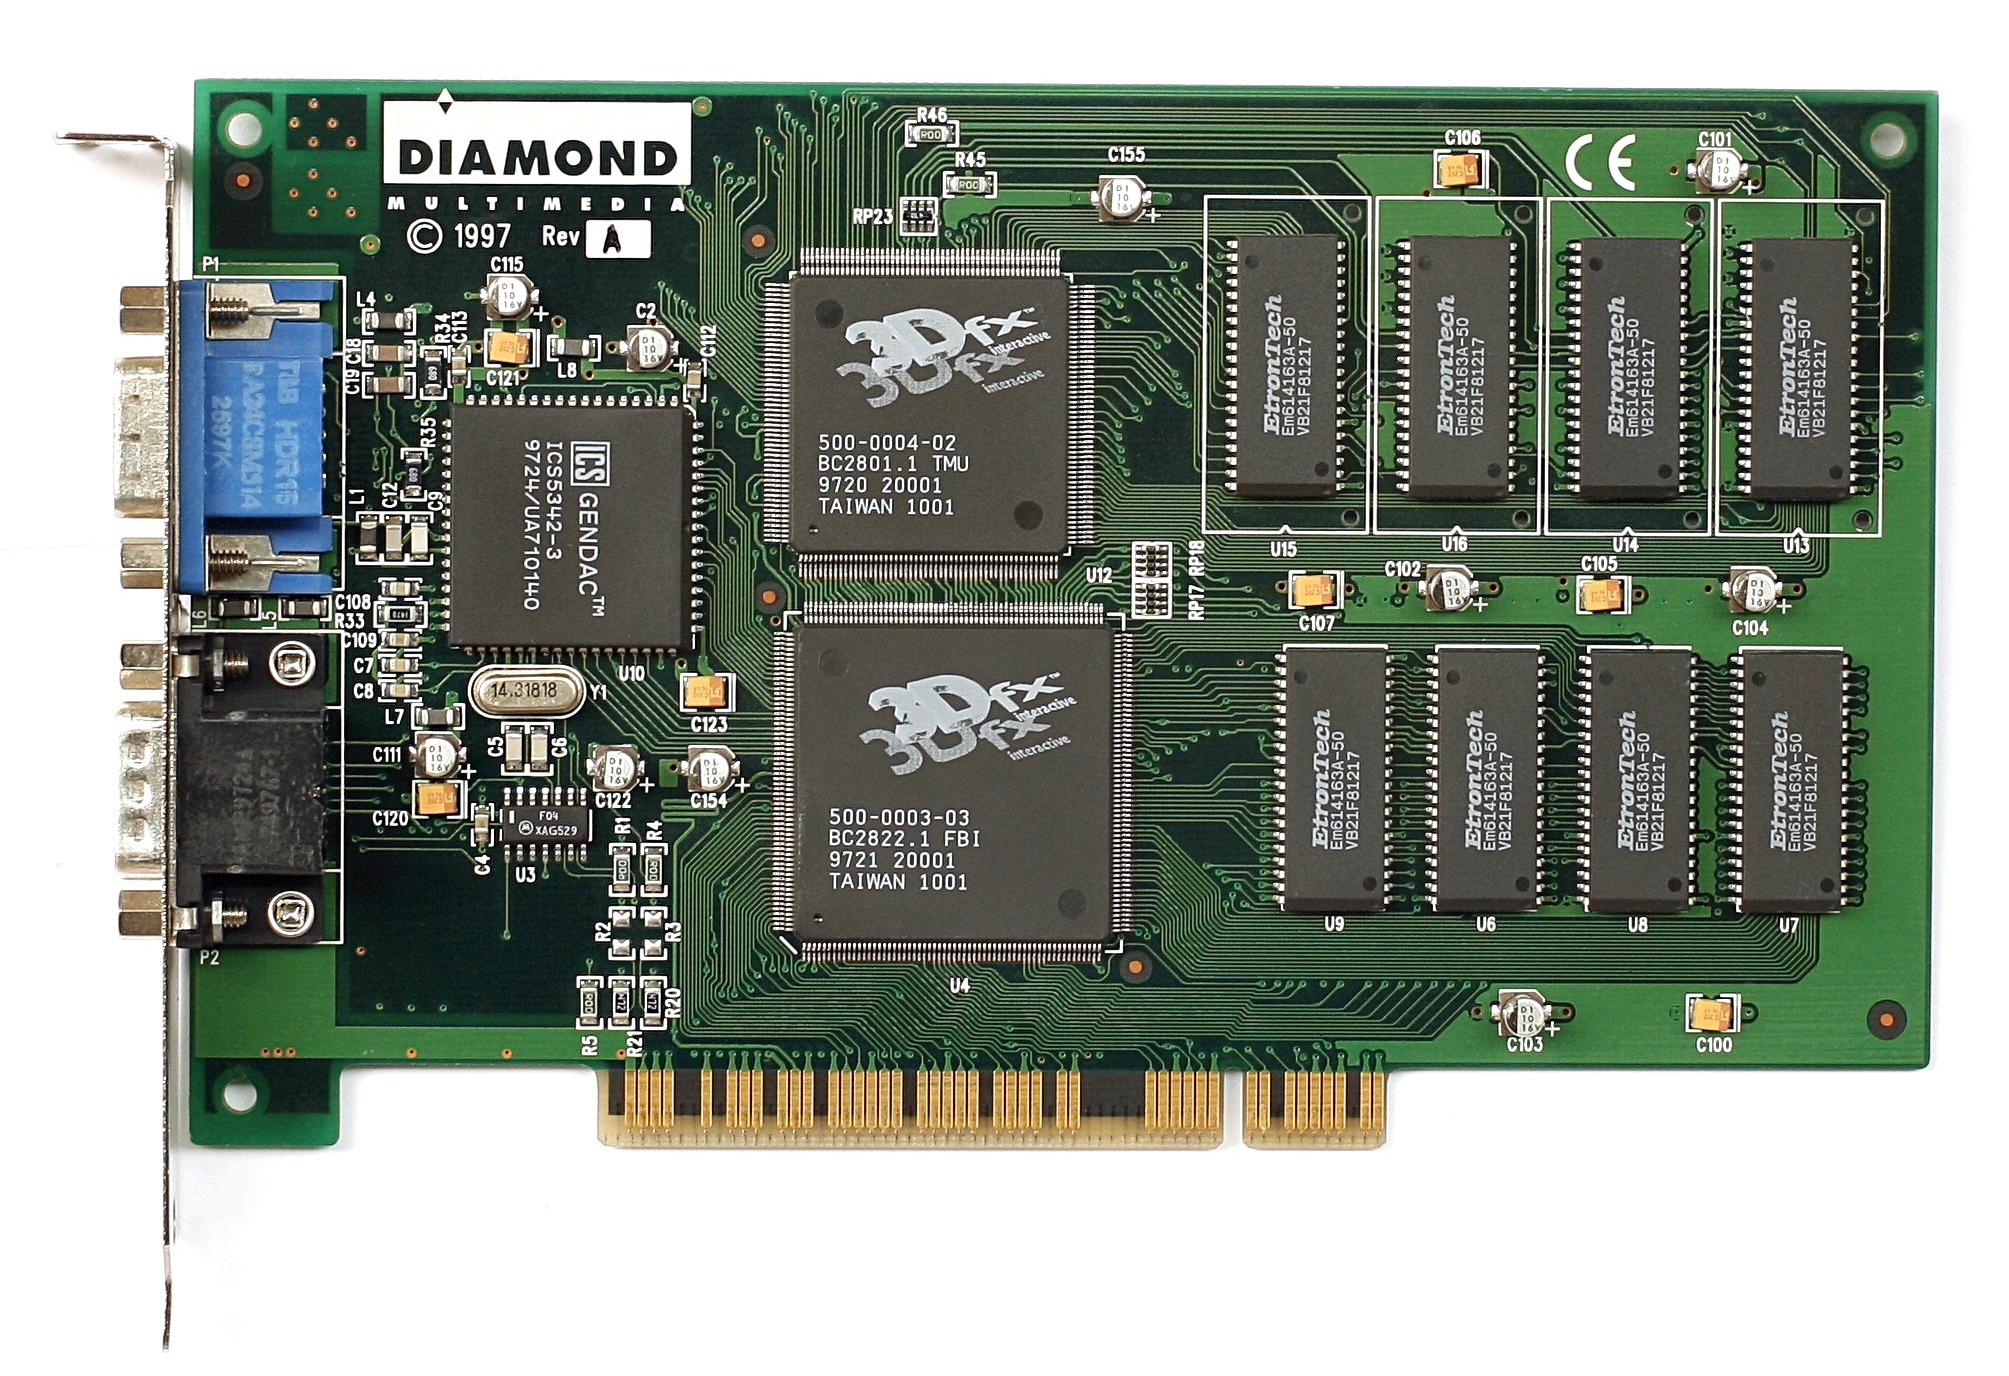
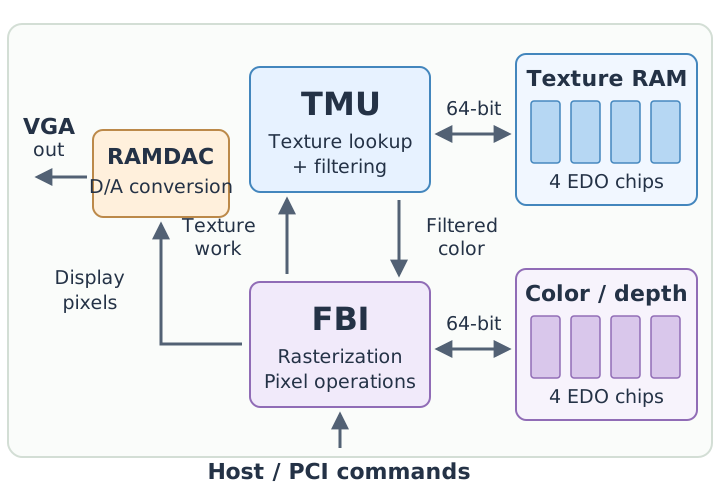
照片:Konstantin Lanzet;裁剪:Pittigrilli,Wikimedia Commons。 照片许可:GFDL 1.2 或更新版本。示意图:nand2mario。

在这块 Diamond Monster 3D 上能直接看到分工:上面那颗 3dfx 芯片是 TMU,下面那颗是 FBI,各自右侧配有四颗 EDO RAM。上面那组存放纹理,下面那组存放颜色和深度/alpha 缓冲。
FBI 和 TMU 各有一条专用的 64 位内存通路。纹理侧采用四路交错,让各个 bank 能读取独立地址,从而并行提供双线性滤波所需的四个相邻 texel。规范文档(第 13 页)承诺其吞吐量与点采样相同,且无需存储重复的 texel。
可如果两个相邻 texel 落进同一颗芯片怎么办?诀窍在于用一种重复的二维模式来分布 texel,而不是把图像切成四个大区域。按行列奇偶的组合分配 bank,原因就一目了然了:
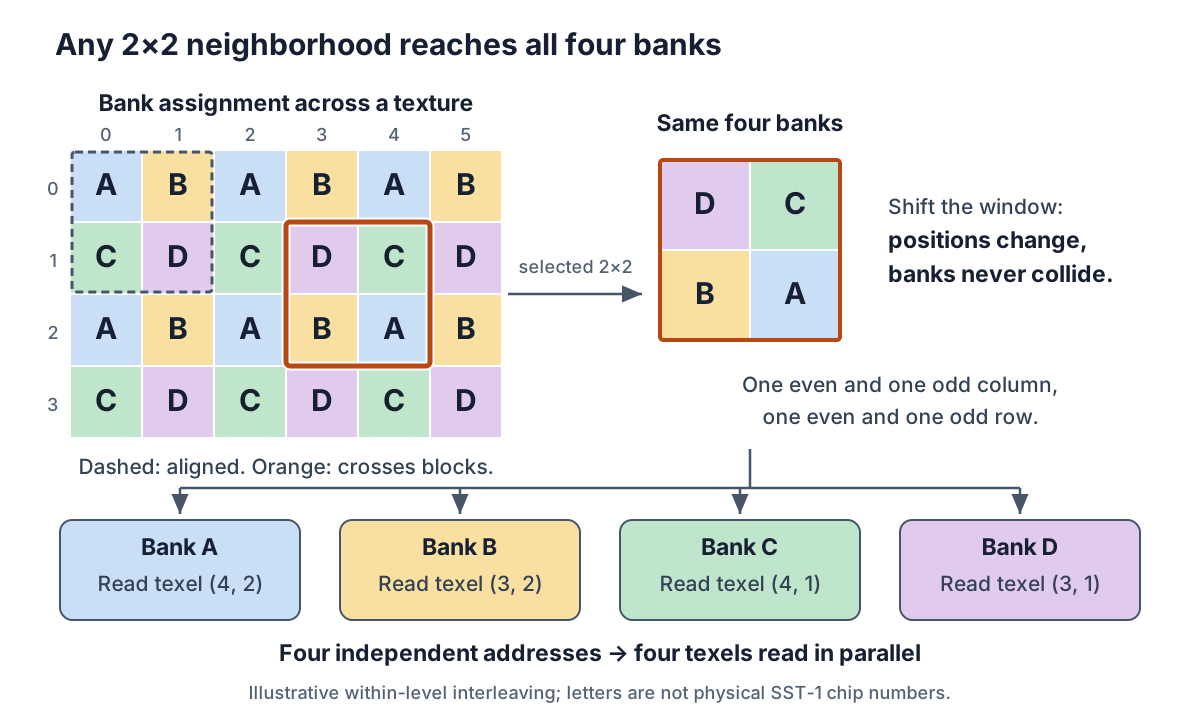
每个 2×2 窗口都包含 A、B、C 和 D——即便是在跨越水平和垂直块边界的橙色窗口中也是如此。相邻两列的奇偶性相反,相邻两行的奇偶性也相反。由于四种组合恰好各出现一次,每个银行都能无冲突地提供一个像素(texel)。
纹理边缘和较小的 mip 级别需要稍加注意。由于 SST-1 使用 2 的幂作为纹理尺寸,只要维度大于或等于 2,纹理环绕就能保持交替模式。但在钳制(clamp)边缘,或在一维宽度/高度仅为一个像素的 mip 级别中,部分采样会复用同一像素。核心洞察依然是:快速的线性双采样过滤依赖于内存排布,使得算术单元能同时接收所有输入。
FBI 对颜色和深度/透明度内存采用了类似思路。其交错路径支持每时钟周期峰值渲染一个像素,或清除操作时每周期两个像素。同时处理相邻像素能将读写开销分摊到整个扫描线上。Fabien Sanglard 的双像素解释提供了对该行为的有用重构,尽管编程指南中未记录具体的 ASIC 银行调度细节。
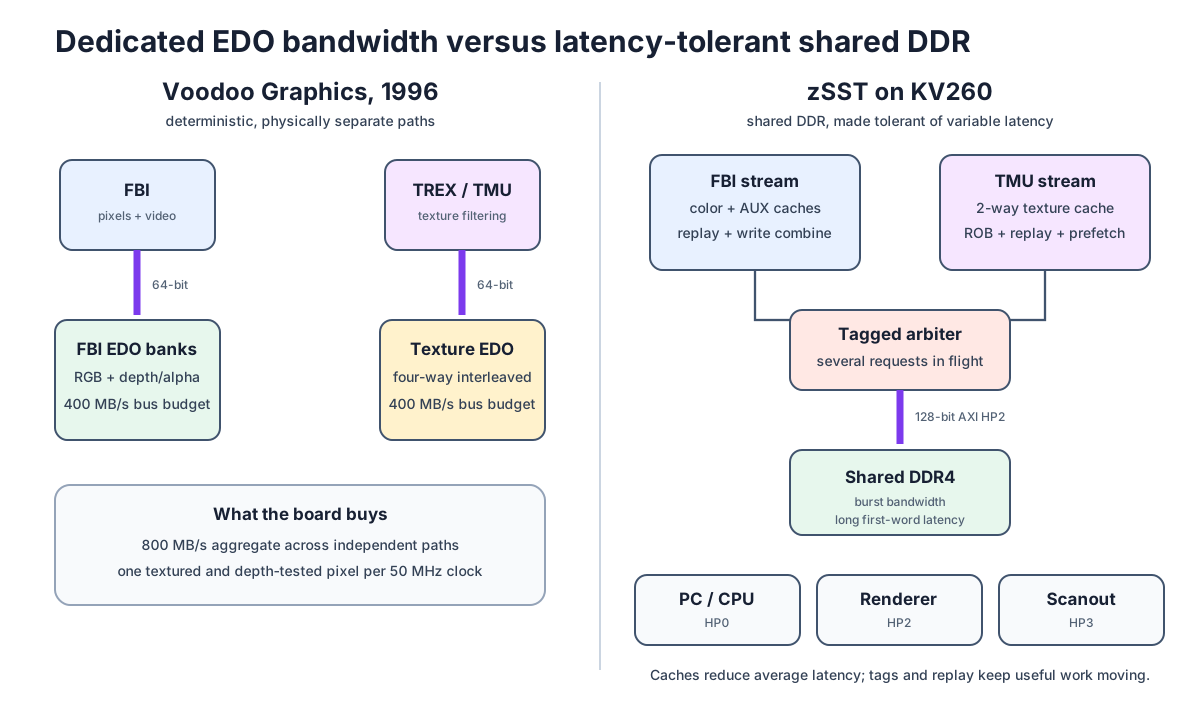
在 50 MHz 频率下,每条 64 位路径的理论带宽为 400 MB/s,总带宽为 800 MB/s,但被预留用于不同的任务。TMU 无法借用闲置的 FBI 带宽,反之亦然。这些专用总线和精心排布的银行让我想起了在SNESTang等项目中探索的 NES 和 SNES 时代设计:从内存中榨取最大性能,关键在于围绕每个数值被确切的时刻和位置进行设计。
FPGA SoC 上的差异
回顾 Voodoo 的内存布局可知它如何保持渲染流水线满载,但我无法将这套设计直接移植到 KV260 上。KV260 虽然拥有更大的内存带宽,但两个渲染单元并未配备专用的 EDO 内存。取而代之的是,FPGA 通过 Zynq 处理系统的 AXI 端口访问共享的 DDR 内存。Linux 系统、FPGA 上的 PC 以及显示扫描输出都在争夺这部分内存资源。目标依然不变——确保持续为像素流水线供数——但实现路径必须改变。
KV260 的实测数据表明,仅靠带宽并不足够。一个 128 位宽、运行在 100 MHz 端口的理论带宽为 1.6 GB/s。当只有 1 个请求处于待处理状态时,4 KiB 的读取操作可达 1,370 MiB/s,而 64 字节的读取仅为 189 MiB/s。首个数据块的到达时间通常需要约 280 ns(100 MHz 下约为 28 个时钟周期),且偶尔会出现更长的等待。
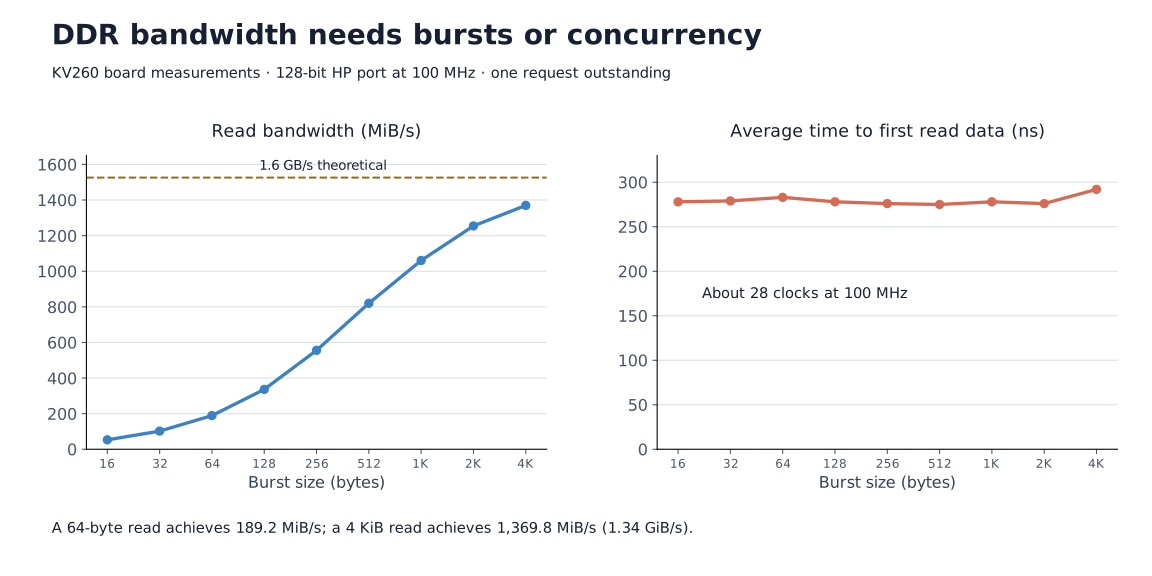
如果一个渲染器每执行一次小读操作后都要等待结果才发起下一次请求,那么它将大部分时间处于空闲状态。zSST 需要足够多的独立任务并行执行,以填补这些等待间隙。
缓存、重放与重排序缓冲
维持流水线满载需要双管齐下:既减少 DDR 访问次数,又降低等待时间。第一步是引入缓存。屏幕上相邻像素通常采样纹理的重叠区域,因此最近获取的纹素可以从片上 RAM 中复用。zSST 的纹理缓存容量为 8 KiB,行大小为 64 字节;每次取数还会拉取相邻纹素,这些纹素很可能被后续像素用到。
即便发生缓存未命中,也会消耗大量时钟周期,但独立的纹理采样无需为此等待。zSST 最多允许 8 个缓存行取数请求处于待处理状态,并利用重放队列暂时搁置数据缺失的采样任务,待数据到达后重试。与此同时,那些纹素已在缓存中的采样任务可以继续执行。预取机制则为未来的读取操作争取先手优势。
此时,后发的缓存命中可能比先前的未命中更早完成。一个 64 项的 reorder buffer(重排序缓冲区,ROB)负责收集这些结果,并按原始顺序释放它们。这个原理在 CPU 中很常见:在漫长的等待期间做有用的工作,然后把结果按顺序传递给下游。
帧缓冲一侧使用独立的 4 KiB 颜色和深度/alpha 读缓存,写合并器则把相邻的 16-bit 写入打包成 128-bit 请求。这里顺序很重要:混合或深度测试可能需要某个先前像素已修改但尚未写入 DDR 的值。转发机制会直接提供这个待写值。帧缓冲更新按顺序生效,需要等待已完成工作的状态变更则先等流水线排空。内存请求可以重叠,但后面的像素仍必须能看到前面像素的效果。
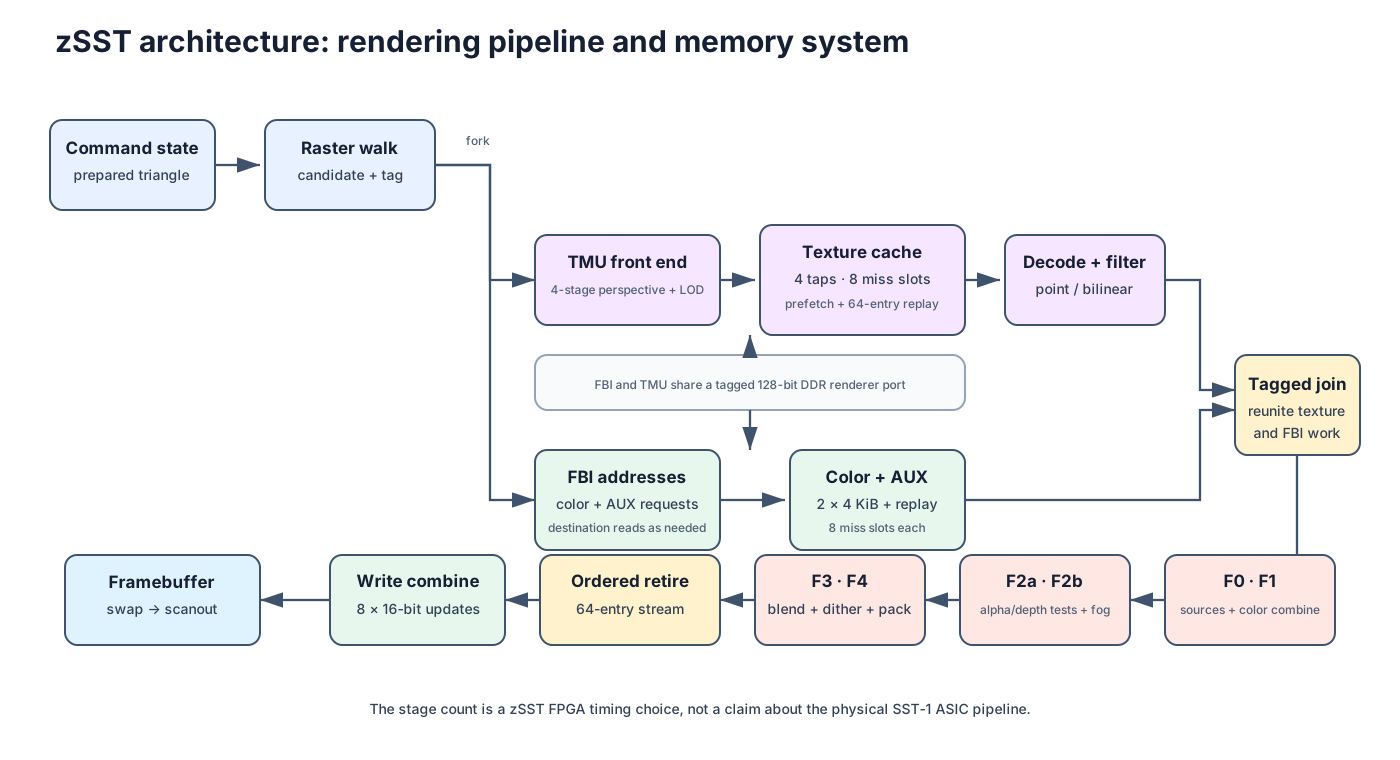
FBI 和 TMU 共享渲染器的 128-bit AXI 端口 HP2。PC 使用 HP0,显示扫描输出使用 HP3,三者的请求队列各自独立,尽管最终都共享 DDR。
评测结果
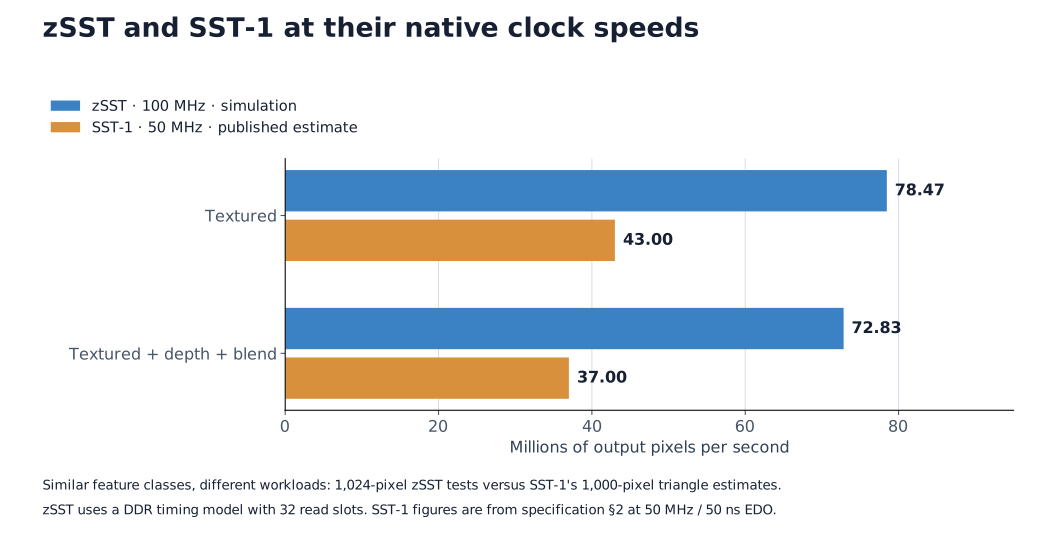
我把渲染器和完整的 PC 分开测量。仿真基准测试通过 zSST 的前端发送命令,对 TMU、FBI、共享仲裁器和 DDR 时序模型进行压测。读数据至少 26 个时钟周期后返回,带有确定性的波动以及偶尔更长的延迟;写入同样受到速率限制。完整渲染器测试允许 32 个未完成的读请求。
在 100 MHz 下,zSST 渲染带纹理的三角形达到每秒 7850 万像素(MPix/s),加上深度测试和混合后为 72.8 MPix/s。Voodoo 1 在其原生 50 MHz 下,官方公布的同等功能估计值是 43 和 37 MPix/s。这并非严格对等的对比:两者的三角形负载不同,原版估计值还包含雾效、mipmapping 和 Gouraud 着色。我手头没有 Voodoo 1,无法在两块卡上跑同样的测试。这个对比只能说明填充率的量级,并不是对原卡的实测性能提升。
高填充率并不意味着游戏帧率必然高。在开发板上,《古墓丽影》第二关在约 20 秒内完成了 237 次显存交换,折合每秒约 12 帧,该数据基于显存交换次数统计,而非引擎内部的 FPS 计数器。初步测量显示主要瓶颈在于 CPU:它仍需运行游戏、准备几何数据并提交指令。共享 DDR 的争用可能也是一个原因。整套系统仍有大量优化空间。
对于非 Voodoo 游戏,当前 100 MHz 的 z486 XL 在最高画质下运行 Doom 可达 38.5 FPS,运行 Quake 1.06 可达 8.1 FPS。这比 85 MHz 的 DE10-Nano 版本快约 20%——其中 Doom 提升约 23%,Quake 提升约 19%。512 KiB 的回写 L2 缓存(采用 UltraRAM 实现)有助于 CPU 更高效地利用 DDR。
在集成的 XCK26 设计中,zSST 占用约 29,500 个 LUT、28,100 个触发器、14 个 RAMB36 模块、8 个 RAMB18 模块以及 97 个 DSP 切片。整个 PC 加图形的组合设计在 100 MHz 下满足时序要求。
结语
最有成就感的是看到原有的 Glide 软件驱动我在 RTL 中构建的硬件。原本以为渲染算术会是难点,但实现数据的高效传输花了更多精力。Voodoo 精心设计的 EDO 交错机制,以及 zSST 的缓存和队列,都在解决同一个问题,只是约束条件截然不同:如果像素流水线没有数据可处理,再快也没用。
zSST 和 z486 XL 均为开源项目。 如果你手头已有 KV260, z486 XL SD 镜像 提供了启动自有 DOS 磁盘镜像所需的 Linux 支持和应用程序。
致谢:感谢 SpinalVoodoo 提供 Glide 追踪数据和参考截图,以及 86Box 提供的实现参考。Fabien Sanglard 撰写的《3dfx Voodoo1 的故事》 是了解原始显卡内存系统的绝佳入门读物。