
Protobuf 中的增量编码
关于 Protobuf 整数类型,一般的建议是直接用 int64,如果带宽或磁盘空间吃紧,就压缩你的 proto 数据。但当相邻的值彼此接近时,只存储它们之间的差值可以让数据小得多——即使经过压缩也是如此。这种技术叫作delta encoding(差分编码)。
核心概念
你可能知道,varint 的线上编码长度取决于所编码的值,所以小数字在线上占用的字节更少。delta encoding 的基本思路就是利用这样一个事实:变化量(delta)通常比值本身小得多。理解这个概念,知道这些就够了。
不过在深入实际应用之前,还有一个小坑要填平。int64 有个怪癖:任何负数都要占满整整 10 个字节。另有一个稍微不同的类型 sint64,它对小数值的负数的处理方式和小数值的正数一样。所以如果你的 delta 可能为负,就用 sint64;如果确定永远不为负,用 int64 就没问题。
下面是用 delta encoding 编码地理纬度,与每个采样点都存完整值的对比效果:
在这个例子里,绝对值每个占 5 字节,而 delta 除了第一个之外,每个只占一到两个字节。
先例
这项技术早已在实际项目中使用。下面是三个在 protobuf 中使用 delta encoding 的例子。
OpenStreetMap PBF 从 2010 年起就把节点存储为 DenseNodes,即多个并行打包的 sint64 数组,每个坐标值都相对于前一个节点做差分编码。
Mapbox Vector Tiles 使用 repeated uint32 加 delta encoding 来表示网格上移动的光标。有意思的是,为了在 uint32 字段里支持负数 delta,它在 protobuf 之外自行应用了 ZigZag 编码。
Prometheus 在原生直方图(native histograms)的整数桶计数中采用了 Delta 编码。注意,这里的差异值(deltas)是单个直方图内部相邻桶之间的差值,而非随时间变化的采样值之间的差值。
测试用例
本文的测试用例是一条虚构的 10,000 个样本的 GPS 轨迹,模拟一辆汽车在伦敦行驶,每 10ms 记录一次时间戳和坐标对,并带有轻微的抖动(jitter)。由于这是合成数据,请将具体数值视为对技术效果的演示,而非性能承诺。采样频率和抖动程度会直接影响数据压缩效果。
为了展示 Delta 编码技术的效率,基准测试包含了两种使用绝对值的替代方案(这是默认常见的做法):一种使用 int64,另一种使用 sint64。这两种方案都采用与 Delta 模式相同的并行打包数组(parallel packed arrays),只是将差异值替换为绝对值,因此该对比仅衡量编码方式的差异,排除其他干扰。
Delta 模式定义如下:
edition = "2024";

package bench.delta.v1;

message Track {
  // 第一个样本的绝对基准值。缺少这三个字段,
  // 消息的其余部分将无法解码。
  int64 first_timestamp_ms = 1;
  int64 first_latitude_e7 = 2;
  int64 first_longitude_e7 = 3;

  // 相对于前一个样本的偏移量,除第一个样本外每个样本一个条目。
  // 时钟只向前推进,因此时间戳差异保持为 int64。
  // 坐标可向任意方向移动,因此其差异值使用 sint64。
  repeated int64 timestamp_delta_ms = 4;
  repeated sint64 latitude_delta_e7 = 5;
  repeated sint64 longitude_delta_e7 = 6;
}
first_* 字段充当关键帧(keyframes)。如果没有初始锚点,差异值只能告诉你汽车在每个方向上移动了多远,而无法得知其当时的实际地理位置。
测试结果
以下是每个样本占用的字节数(时间戳以毫秒为单位)。两张图表使用完全相同的刻度,以便直观观察差异。
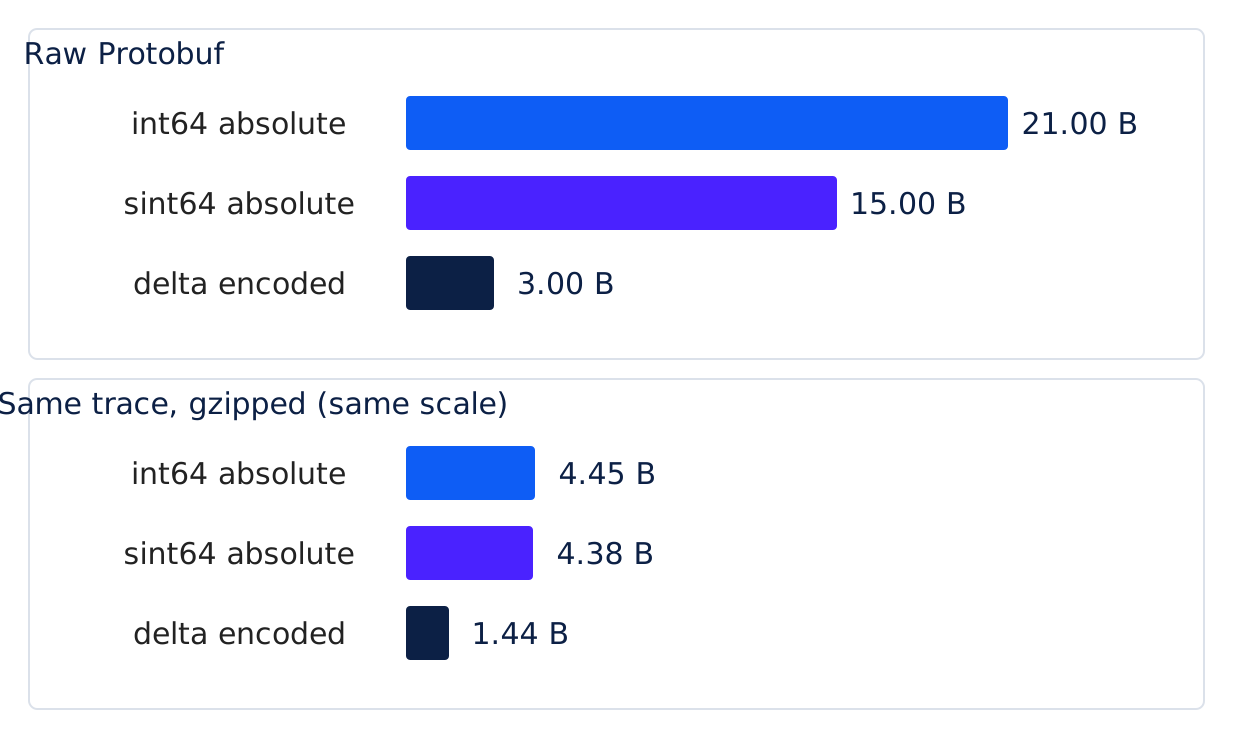
看看这张 gzip 图表!普通压缩几乎完全抹平了 int64 和 sint64 之间的差异,这也印证了 Protobuf 技巧 #10 中的建议。
再看看差值编码 schema。它彻底碾压了 int64 和 sint64,经 gzip 压缩后,每样本仅需 1.44 字节。
权衡
那么,应该到处都用这套方案吗?不用。大多数情况下并不需要。
线路格式的节省并非免费午餐:复杂度转移到了你的应用代码中。解码器需要通过从消息开头累积差值来重构每一个数值,因此要直接跳到第 5,000 个样本,就得先对之前的 4,999 个差值求和(或者增加更多的锚点字段作为关键帧)。而且,由于这些数值存储在并行数组中,编码器必须确保它们对齐:任何一个数组中缺失或多出的条目,都会静默地破坏该条目之后的所有样本。
只有当你拥有大量的、有序的、且变化不显著的整数列表时,差值编码才真正有价值。如果 gzip 已经帮你实现了大部分目标,就别费那个劲了,坚持使用简单的 schema 就好。
对于标准的请求响应式 RPC,这种额外逻辑通常得不偿失。但如果你处理的是海量追踪数据、GPS 坐标、遥测计数器或其他大规模数字序列,它能为你节省大量带宽和存储空间。在这项小规模测试中,gzip 虽然在标准整数类型之间拉平了竞争态势,但差值编码仍进一步将负载压缩了 67%。
下一篇