
大卫贝克主导,9460万美元计划要AI自己实现蛋白质学习设计
编辑丨&
AI 设计的蛋白质在相关新闻中已不算新鲜。从蛋白质结构预测到 de novo 蛋白设计,机器学习已经能够生成大量自然界不存在的蛋白质候选,在它们产生实际效用之前,生成结果只是研究流程中的一个环节。设计出来的分子最终能否工作,仍然需要通过真实实验验证。实验得到的数据又会成为下一轮模型训练的材料。
9月3日,Allen Institute、华盛顿大学和 Fred Hutchinson Cancer Center 联合启动 AI BioDesign。项目获得 9460 万美元、为期 5 年的资金支持,由诺贝尔化学奖得主 David Baker 和基因组学科学家 Jay Shendure 共同牵头。项目计划建立一套长期运行的开放科研体系,让人工智能参与生物设计,也参与后续实验方案的选择和迭代。
AI BioDesign 提出的核心流程可以概括为「Design、Build、Measure、Learn」。模型先产生设计,研究人员完成构建,再通过大规模实验获得真实测量结果,新的数据随后返回计算环节,用于训练和改进下一轮模型。这样的循环会持续运行,实验室也因此成为模型学习过程中的重要组成部分。
走向大规模并行
传统生物实验往往针对一个或少量候选分子进行测试。AI 生成能力提升之后,如果每一次模型迭代都只能验证几十个设计,实验很快就会成为整个流程的瓶颈。
AI BioDesign 把重点放在了 multiplex experiment,也就是多重并行实验上。研究团队希望在一次实验中同时测试成千上万甚至数百万种不同设计,再利用测序等技术把这些结果一次性读取出来。
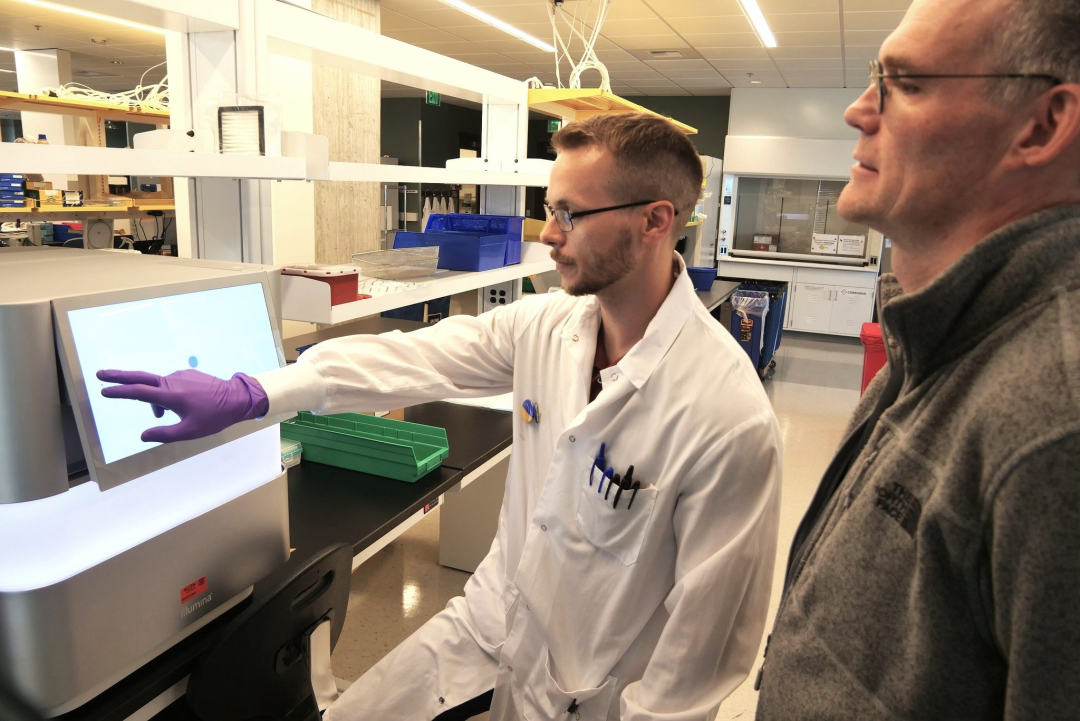
图示:杰克·博伊兰(左),以及人工智能生物设计战略与平台执行总监杰西·格雷,在该计划新实验室内的 DNA 测序仪前。图源:GeeWire。
GeekWire 在对项目实验室的实地采访中提到,该实验室的 DNA 测序设备能够同时读取数百万条人工设计的 DNA 序列。项目近期一次实验就测试了约 600 万条不同序列。这里的规模并不主要来自让机器人机械地重复做 600 万次实验,而是来自分子生物学本身的并行化能力,大量不同序列可以在同一个实验体系中同时接受测试。
相关链接:https://www.geekwire.com/2026/allen-institute-uw-and-fred-hutch-launch-95m-open-science-initiative
凭此,模型能够快速生成大量候选设计,只有实验系统也具备相近的数据吞吐能力,AI 的生成能力才真正有机会转化成持续的实验反馈。
持续产生训练数据的实验系统
AI BioDesign 的另一项重点,是把实验结果系统化地转化成模型可以继续学习的数据。
参与项目的研究人员在项目内部设置了机器学习团队,它们会和负责湿实验的研究人员共同决定下一轮实验应该测试哪些设计,并考虑哪些实验最有可能为模型提供新的信息,用实验结果不断调整后续设计策略。
假设模型已经能够生成大量候选序列,那么下一轮实验可以优先测试那些最能区分不同模型假设的设计。某些结果可能证明现有模型已经掌握了某种规律,也可能暴露出模型没有覆盖的新情况。无论结果是哪一种,它们都可以继续进入下一轮训练。
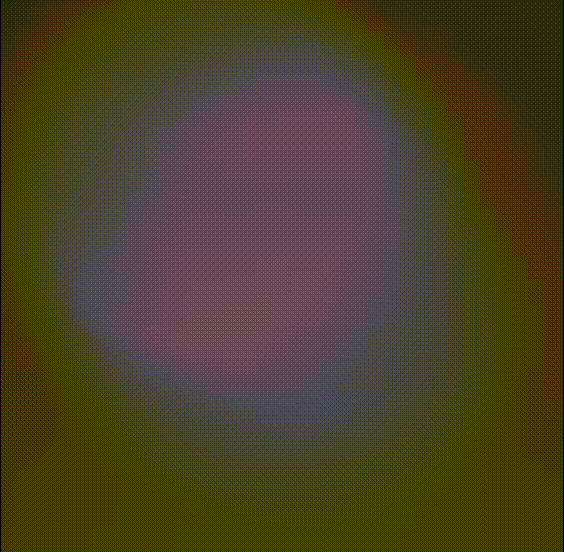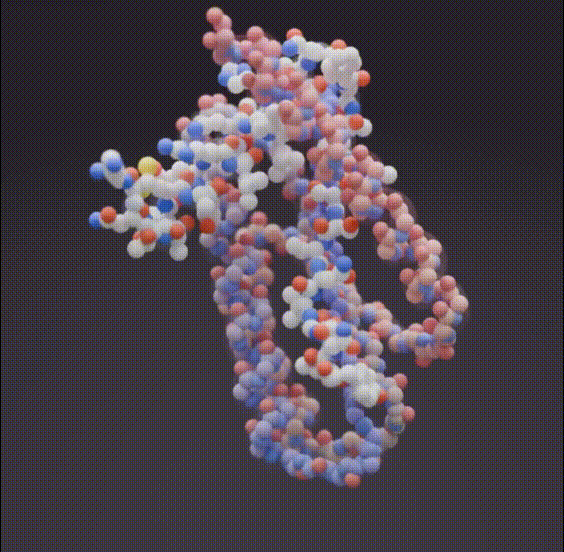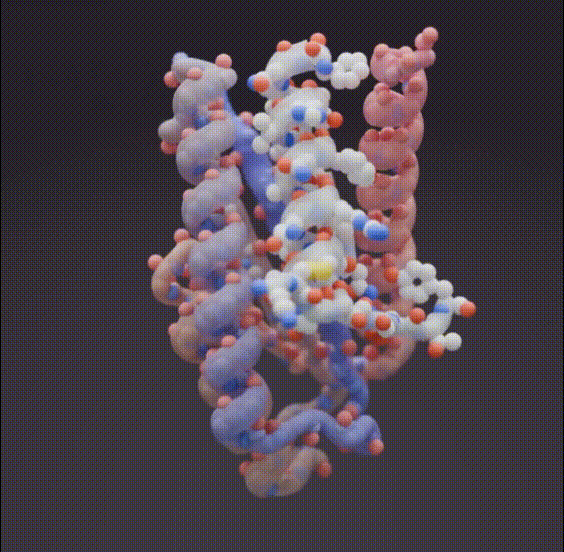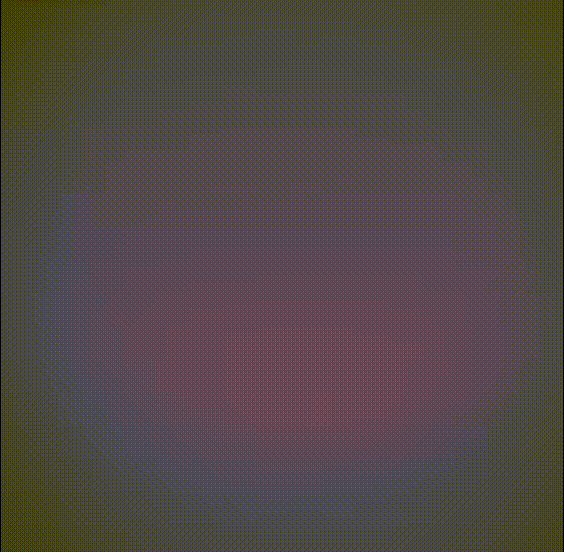
图示:蛋白质结合剂向淀粉素扩散轨迹。
Allen Institute 将这一体系称为一个可持续学习的生物设计平台。项目希望通过持续运行的实验与计算循环,逐步建立属于人工设计体系的大规模生物学数据。
相关链接:https://alleninstitute.org/news/ai-biodesign-accelerator-combines-experimental-biology-and-artificial-intelligence-to-learn-natures-design-rules
实验基础与延伸
AI BioDesign 并不是突然出现的一项孤立计划。
2025 年,Shendure 团队在《Nature》发表研究,利用 lentiMPRA 技术对超过 68 万个 DNA 序列进行了大规模功能测试。研究覆盖三种人类细胞类型,其中约 41.7% 的序列表现出活性。研究人员进一步利用这些实验数据训练序列模型,用于预测候选顺式调控元件的功能以及部分遗传变异可能产生的影响。
相关链接:https://www.nature.com/articles/s41586-024-08430-9
这类实验已经展示出实验数据与模型的相互作用关系:前者将在后者帮助下以远超传统实验的数量生成,后者又从中得益,不断训练自己。AI BioDesign 现在试图把这种思路进一步扩展,并把模型的设计能力直接纳入实验规划。
对于后续的探索,AI BioDesign 的目标是能够靶向癌细胞的蛋白质、具有特定细胞类型活性的 DNA 调控开关、蛋白质降解或稳定分子,以及能够分解塑料的酶等方向。更长期的目标还包括利用生物分子构建具有计算功能的系统。
AI BioDesign 希望借助生成模型进入更大的搜索空间,再用真实实验筛选其中真正有价值的设计。这样得到的数据又能够反过来扩充模型对生物规律的理解。
新式科研组织方式
AI BioDesign 目前仍处在启动阶段,它还没有宣布由这套体系直接产生的新药或临床产品。现在能够看到的,主要是一套已经开始搭建的实验基础设施、一支跨计算与实验的研究团队,以及围绕持续学习建立起来的研究框架。项目预计在未来数年持续扩大规模。
当 AI 可以生成数百万个候选设计,而实验系统也能够并行读取数百万个结果时,研究人员面对的科研单位就不再只是一个蛋白质、一个基因或一次实验。这也许是 AI BioDesign 最值得期待的地方,重新设计「提出假设、开展实验、获得数据、形成新假设」这一整套科研过程。