大语言模型拥有金鱼般的记忆吗?
Agent 能写代码,但要让代码符合你的系统、团队规范和历史决策才是难点,结果就是在反复纠错中浪费时间和 token。
更多的 MCP、规则和更大的上下文窗口能让 agent 获取信息,但不等于理解。真正跑在前面的团队,都有一层上下文层,为 agent 精准提供当前任务所需的内容。
9 月 23 日免费网络研讨会,你将看到:
团队在 AI 成熟度曲线上的常见卡点,以及为什么常规方案不够用
上下文层如何同时解决质量、效率和成本问题
现场演示:同一个编码任务,有无上下文层的对比
如果你想让 AI agent 发挥最大价值,这场分享值得一听。
LLM 可以分析一份 100 页的文档,看懂复杂的编程讨论,还能引用几条消息之前聊过的内容。可一旦我们新开一个对话,之前的交流内容它就立刻忘得一干二净——看起来 LLM 的记忆和金鱼差不多。
这个观察没错。LLM 通常不会对之前的交互保留任何个人记忆或持久记忆。那它是怎么引用我们过去说过的话的呢?
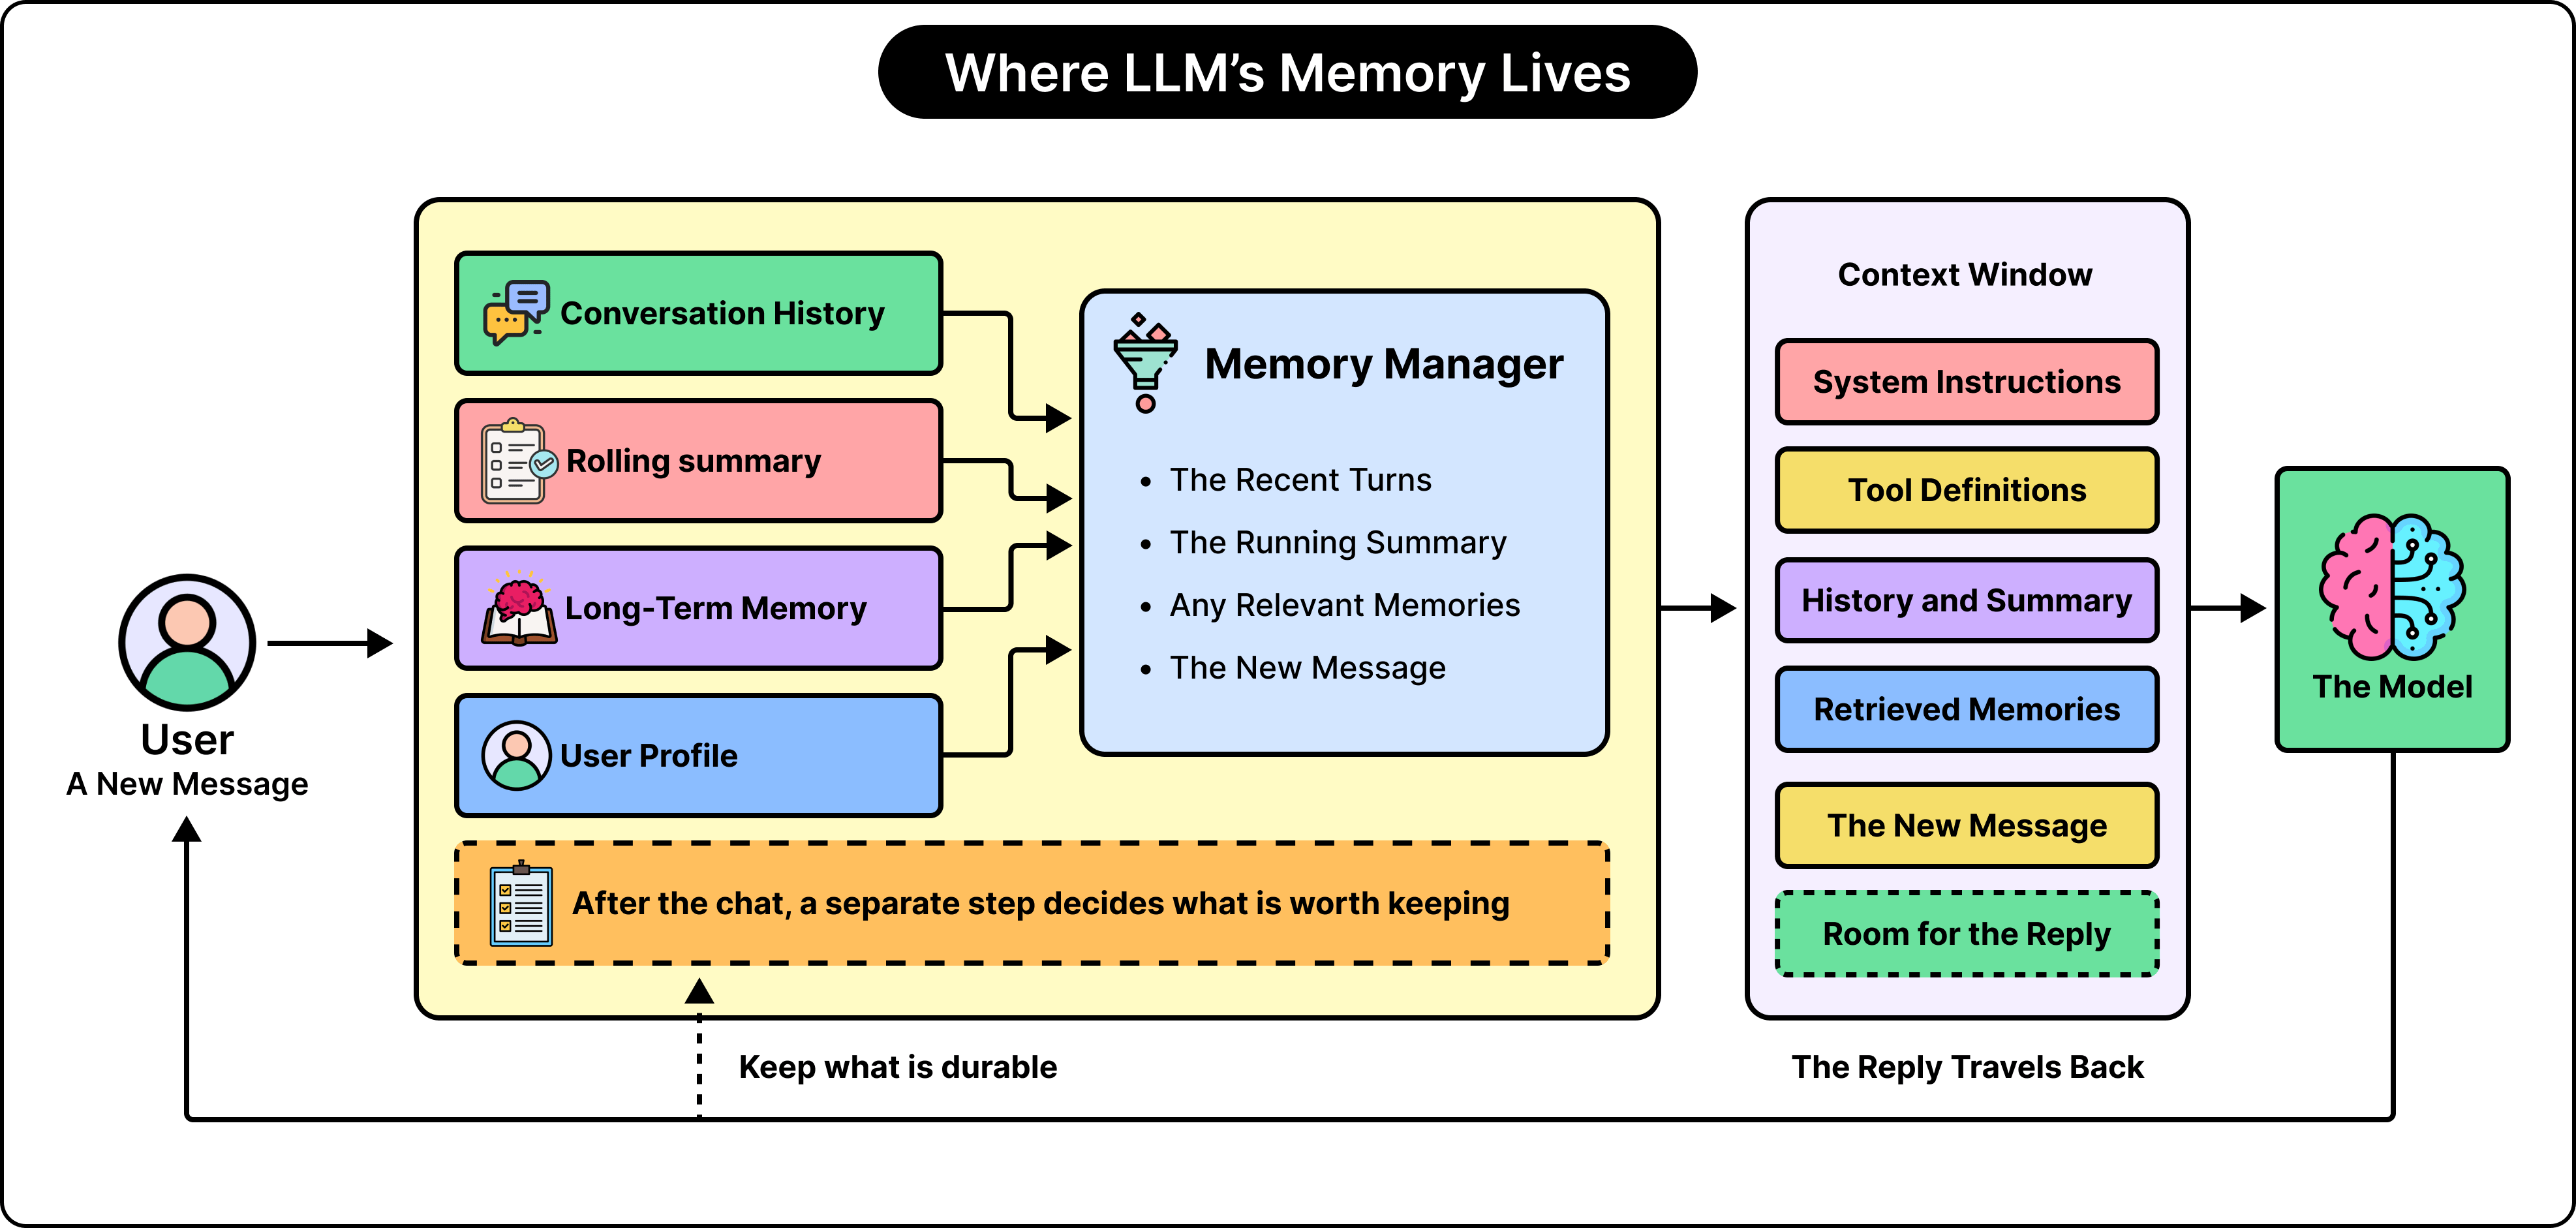
实际上,LLM 并不像人类那样记住一段对话,而是我们每发送一条新消息时,模型都会收到截至当前的完整对话信息。这些工作都是由围绕模型构建的应用来完成的,而不是模型本身。比如,一个聊天应用可能会存储消息、维护早期讨论的摘要、检索相关记忆、维护用户画像,然后按需把这些信息的一部分放在模型面前。从用户角度看,模型像是记得一切;但从技术上讲,做“记忆”这件事的其实是周边应用。
模型与其外围应用之间的区别,是理解 LLM 记忆的关键。
这种设计会带来重要影响。随着对话不断增长,应用必须处理越来越多的文本,从而推高成本和延迟。最终,对话会大到超出模型上下文窗口的容量。此时,较早的信息必须被移除、摘要,或存储到其他位置。
本文将介绍 LLM 如何处理记忆,使其能够在执行需要多轮对话和上下文保持的复杂任务时,对最终用户真正有用。
LLM 的「记忆」是什么意思?
在 LLM 语境下,“记忆”一词指代几种不同的事物,不应混淆。下面逐一详细介绍。
训练记忆
训练阶段,LLM 从海量数据中学习模式。这些模式被编码在数十亿个数值中,称为参数或权重。
正因如此,模型无需在当前的 prompt 中接收相关知识,就能解释 JavaScript、识别常见的历史事件或撰写邮件。
但这并非个人记忆。如果用户告诉模型“我最喜欢的编程语言是 TypeScript”,标准的 API 响应并不会重写模型的权重。基础模型不会通过对话永久记住这一事实。
工作记忆
模型的临时工作记忆就是其上下文窗口。它包含模型在生成当前响应时所能考虑的所有内容。
它可能包括:
系统和开发者指令
当前用户消息
对话中的历史消息
检索到的文档
工具描述与工具结果
保存的用户偏好
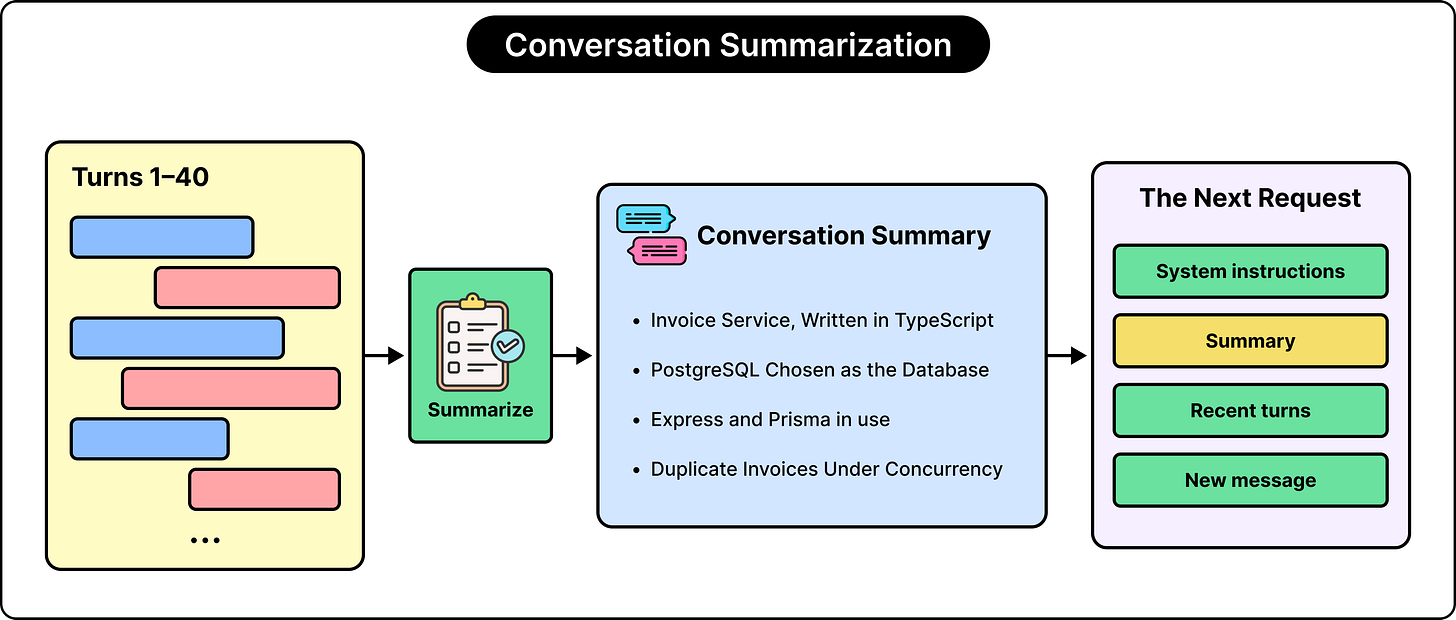
早期对话的摘要
为模型输出预留的空间
上下文窗口更像一张办公桌,而非人类记忆。模型只能处理放在桌上的文档。一旦桌子清空,除非应用程序再次将文档放回桌面,模型无法自行恢复这些信息。
持久化应用内存
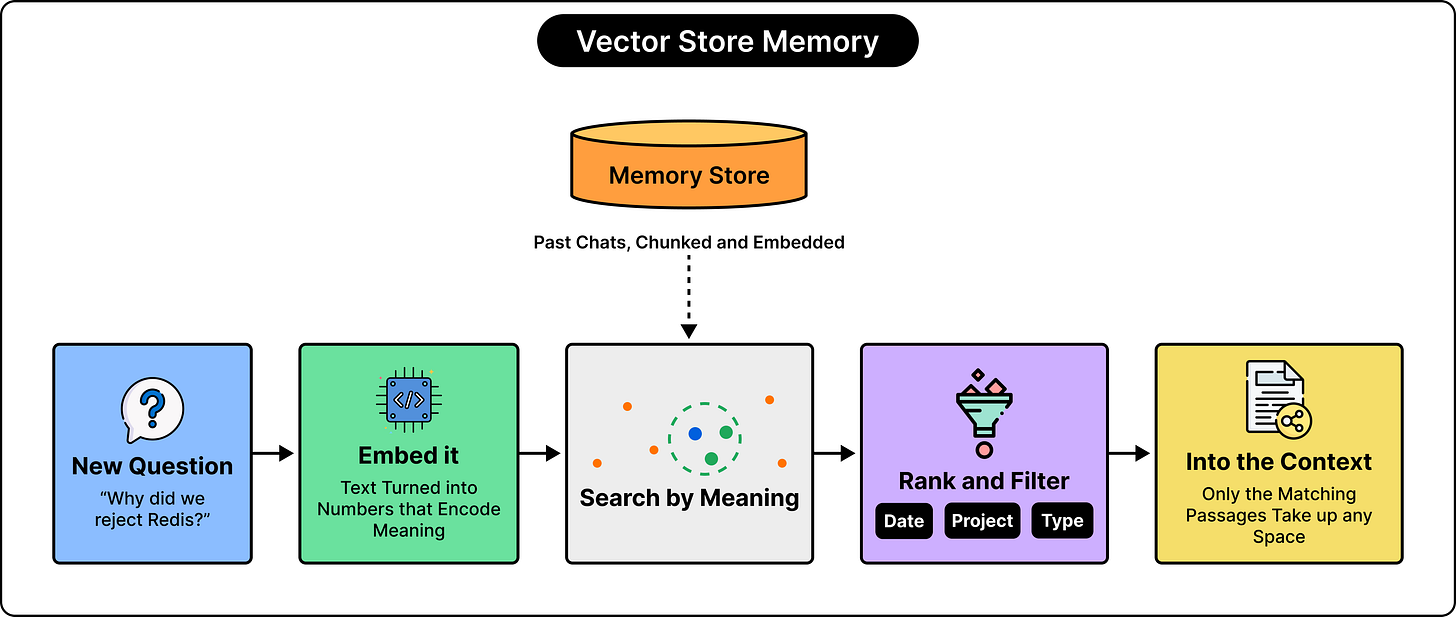
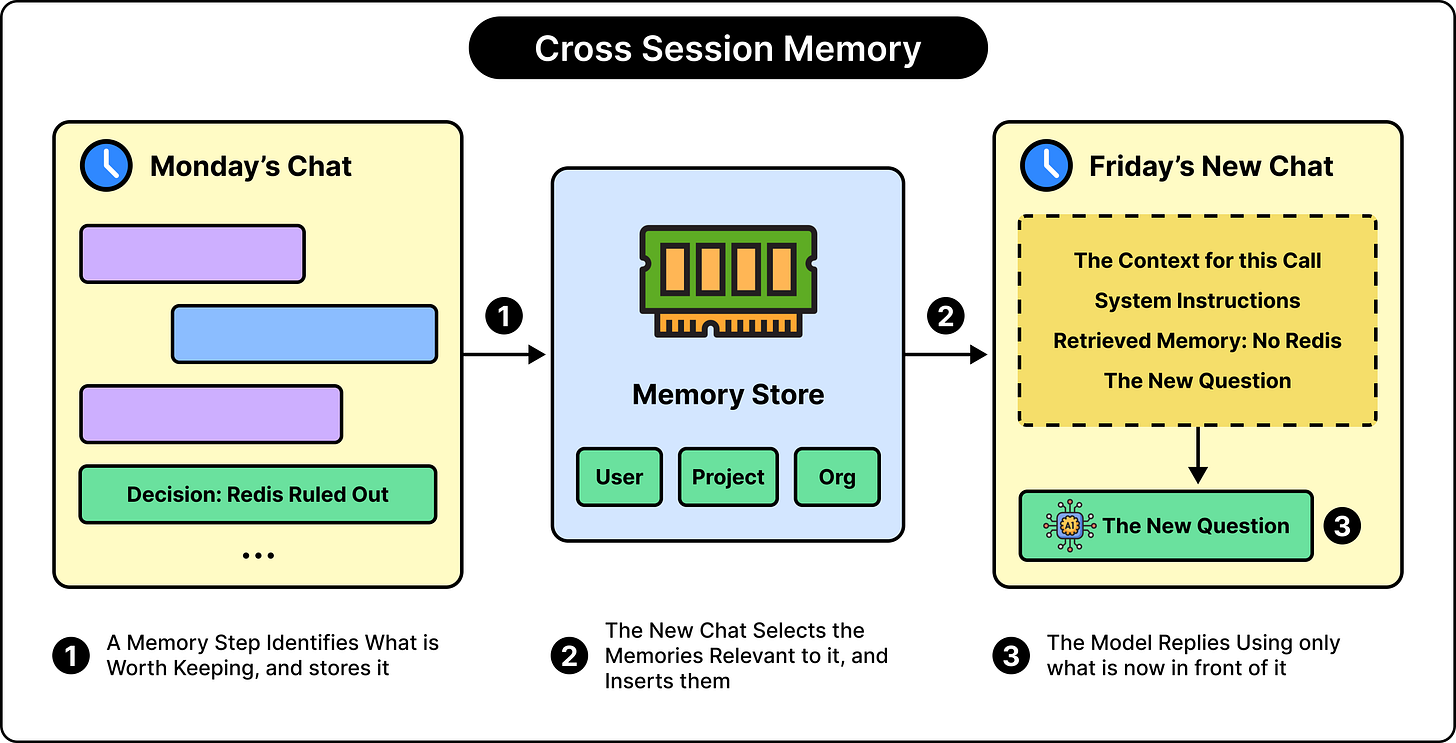
持久化记忆通常存储在模型外部,例如数据库、文件、向量存储或用户画像服务中。当模型需要这些信息时,应用程序会将其检索出来并插入到当前上下文中。
因此,模型本身并不具备持久化记忆。它只是从其他系统中接收持久化信息。
构建并扩展制胜的 AI 智能体策略(赞助内容)
将智能体部署到生产环境相对容易。挑战在于保持其可靠性、可治理性,并实现持续改进,大多数企业 AI 项目正是在这里停滞不前。
顶尖团队是如何做到的?他们采用智能体运营模型(AOM),这是一个逐步框架,旨在协调人员、流程和技术,使企业智能体在规模扩展的同时不断优化。
在 LangChain 的最新指南中,你将学到:
为什么 AI 智能体的故障模式不同于传统软件
覆盖智能体全生命周期的工程堆栈
从“构建与部署”转向“运营与持续改进”的思维转变
基础 API 调用过程中发生了什么?
考虑一个最简单的 API 请求:
{
  "messages": [
    {
      "role": "user",
      "content": "My name is Adam."
    }
  ]
}
模型可能会回答:“很高兴见到你,Adam。”
假设下一个请求只包含以下内容:
{
  "messages": [
    {
      "role": "user",
      "content": "What is my name?"
    }
  ]
}
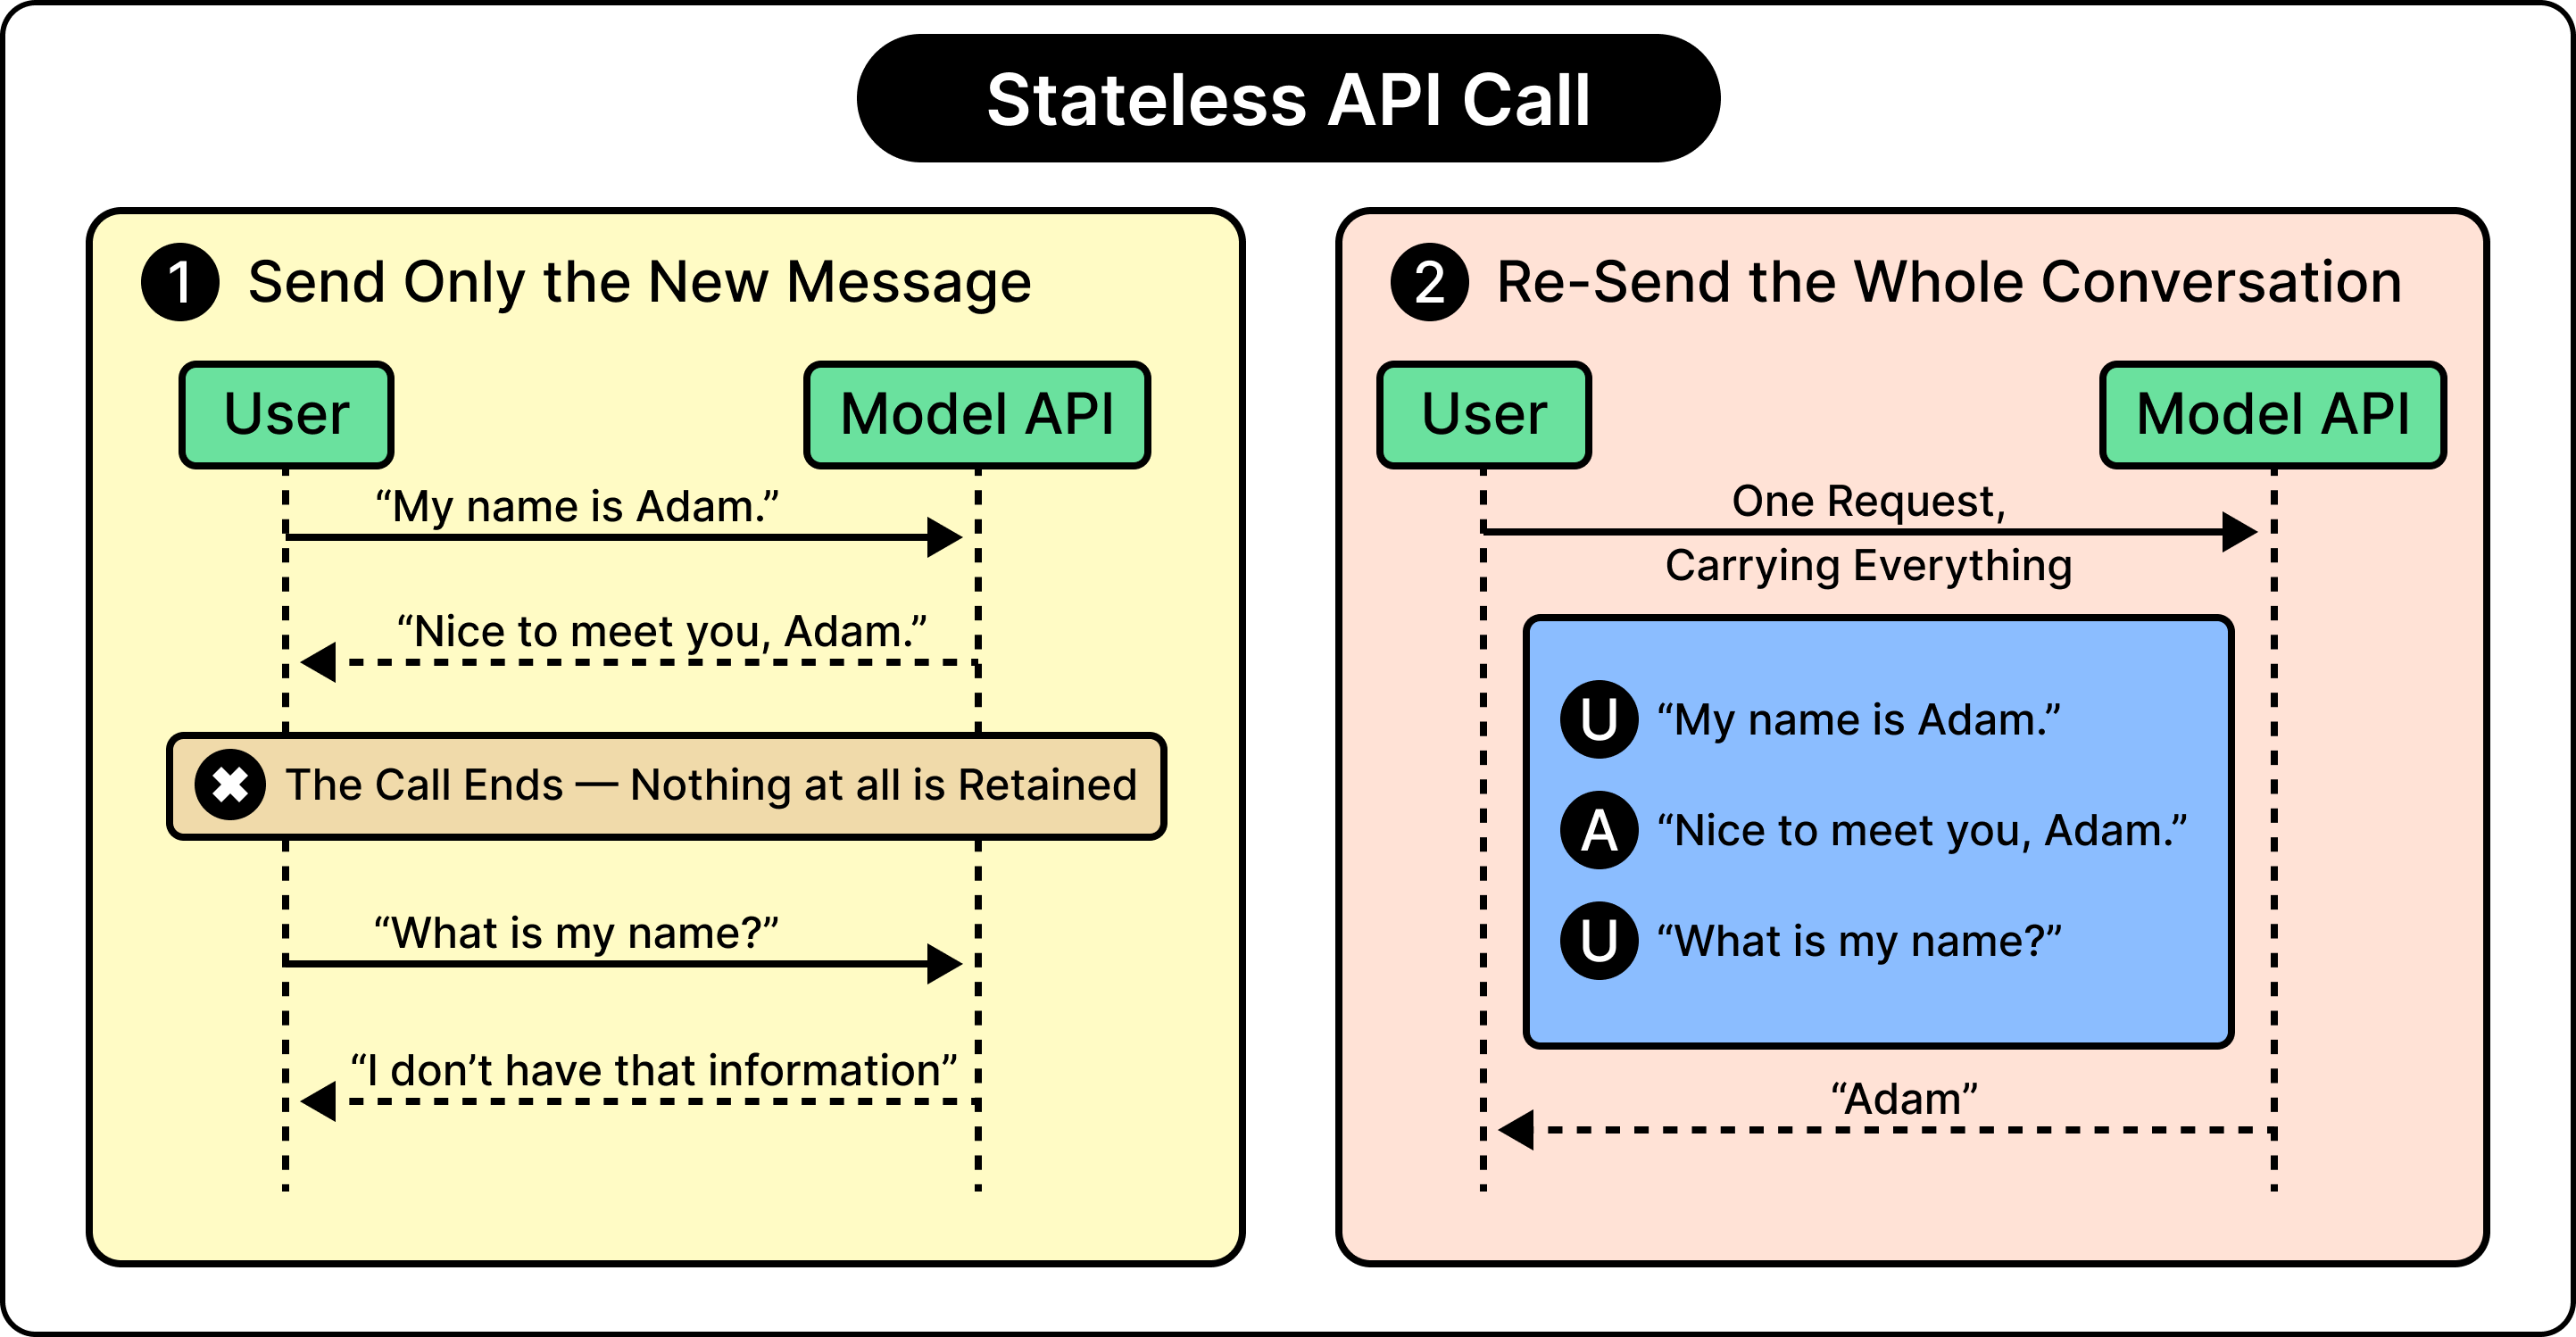
由于第二个请求中未包含姓名,且前一个请求已结束,模型无法可靠地回答。模型内部并不存在持续更新的私密日记本。
为了让对话能继续,应用必须把之前的对话内容重新发送一遍:
{
  "messages": [
    {
      "role": "user",
      "content": "My name is Adam."
    },
    {
      "role": "assistant",
      "content": "Nice to meet you, Adam."
    },
    {
      "role": "user",
      "content": "What is my name?"
    }
  ]
}
这样模型就能回答“Adam”了,因为名字出现在了当前的输入中。
大多数模型服务商提供的 Messages API 都是无状态的,进行多轮对话时需要调用方自己提供对话历史。
每次 API 调用真的是从零开始的吗?
一次新的模型调用通常并非完全“一无所知”。模型仍然具备以下东西:
训练得到的权重
通用的语言能力
训练过程中学到的知识
平台提供的安全和行为规则
当前上下文中的所有内容
它缺少的,是针对这个特定用户或这段对话的、自动更新的记忆。
更准确的说法是:模型的每次回复,都是基于它已有的权重加上当次可用的上下文生成的。对话历史中的信息并不会自动延续,除非外部系统主动把它传递下去。
有些 API 提供服务端管理的对话状态。这种情况下,我们就不需要手动重发每一条消息,只需提供一个对话标识符,服务端就能根据它找到之前的消息、重建所需的上下文。这让 API 更好用,但并不意味着模型真的产生了个人记忆。
AI 聊天机器人如何营造出“有记忆”的错觉
假设一段对话中包含五条用户消息和五条助手回复。
当用户发送下一条消息时,应用构造的输入可能包含以下内容:
系统指令

用户消息 1
助手回复 1

用户消息 2
助手回复 2

用户消息 3
助手回复 3

用户消息 4
助手回复 4

用户消息 5
助手回复 5

新的用户消息
模型会将上述内容作为单个大型输入接收。例如,在之前的对话中,用户可能提到过数据库问题,选择了 PostgreSQL,并要求提供 TypeScript 示例。因此,基于这些上下文,模型能够更自然地延续回答。
对用户而言,这可能感觉像是模型记住了之前的事物。然而,从模型的角度来看,这些细节只是当前正在处理的文本中的一部分。我们不应简单地称之为“伪记忆”,因为应用层面确实存在连续性。更准确的术语应该是“重建记忆”或“基于上下文的记忆”。
上下文窗口是工作记忆预算
LLM 的上下文窗口以 token 计量。Token 是文本的最小片段。短词可能对应一个 token,而较长或不常见的词可能会被拆分为多个 token。
上下文窗口通常包含的内容比可见对话多。它还可能包含隐藏指令、工具定义、搜索结果、文档以及生成回答的空间。假设某个模型的上下文窗口为 100K token,应用可能需要将以下内容装入该空间:
系统指令:3,000 token
工具定义:8,000 token
对话历史:55,000 token
检索到的文档:20,000 token
当前问题:1,000 token
剩余回复预算:13,000 token
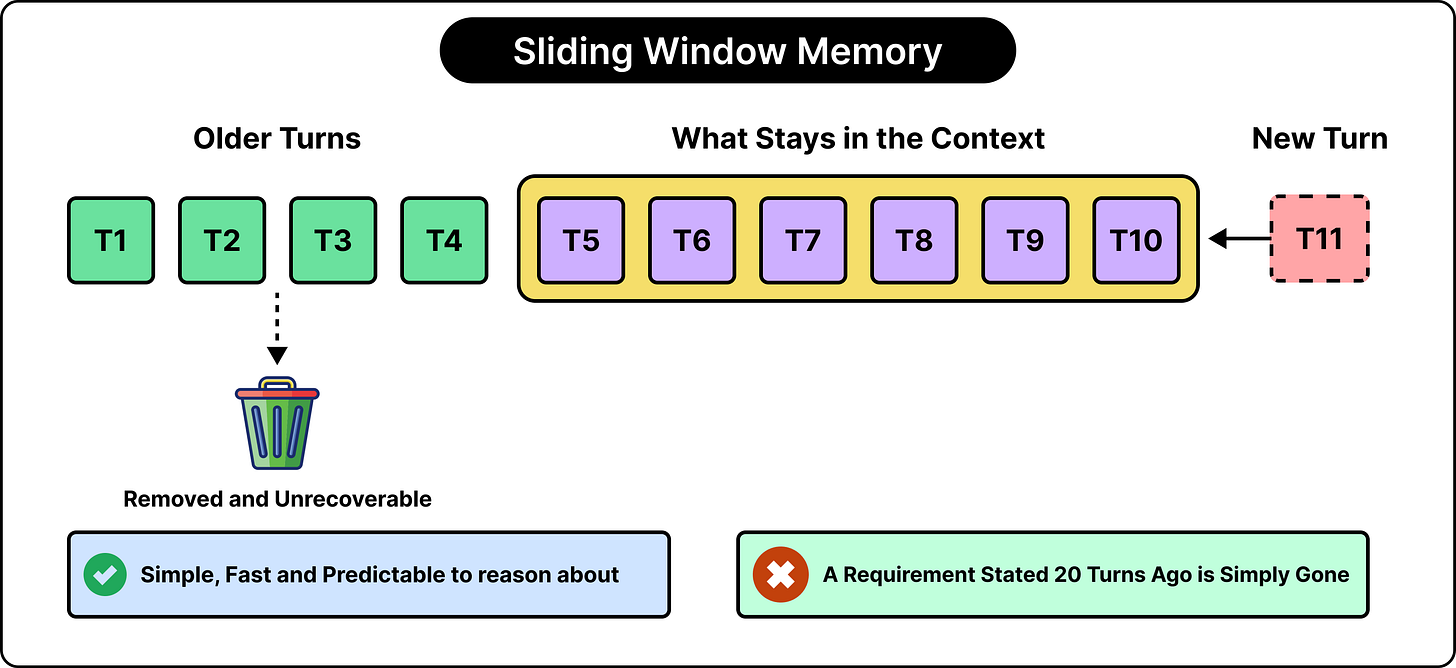
一旦可用空间耗尽,应用无法无限制地继续添加信息。它必须移除、压缩或替换某些内容。
较大的上下文窗口也并不保证完美的召回能力。随着信息量的增加,模型可能更难区分重要事实与无关、重复或矛盾的内容。这种退化