
2026 推理硬件革命
如今汹涌而来的海量推理查询,正迫使硬件厂商转型
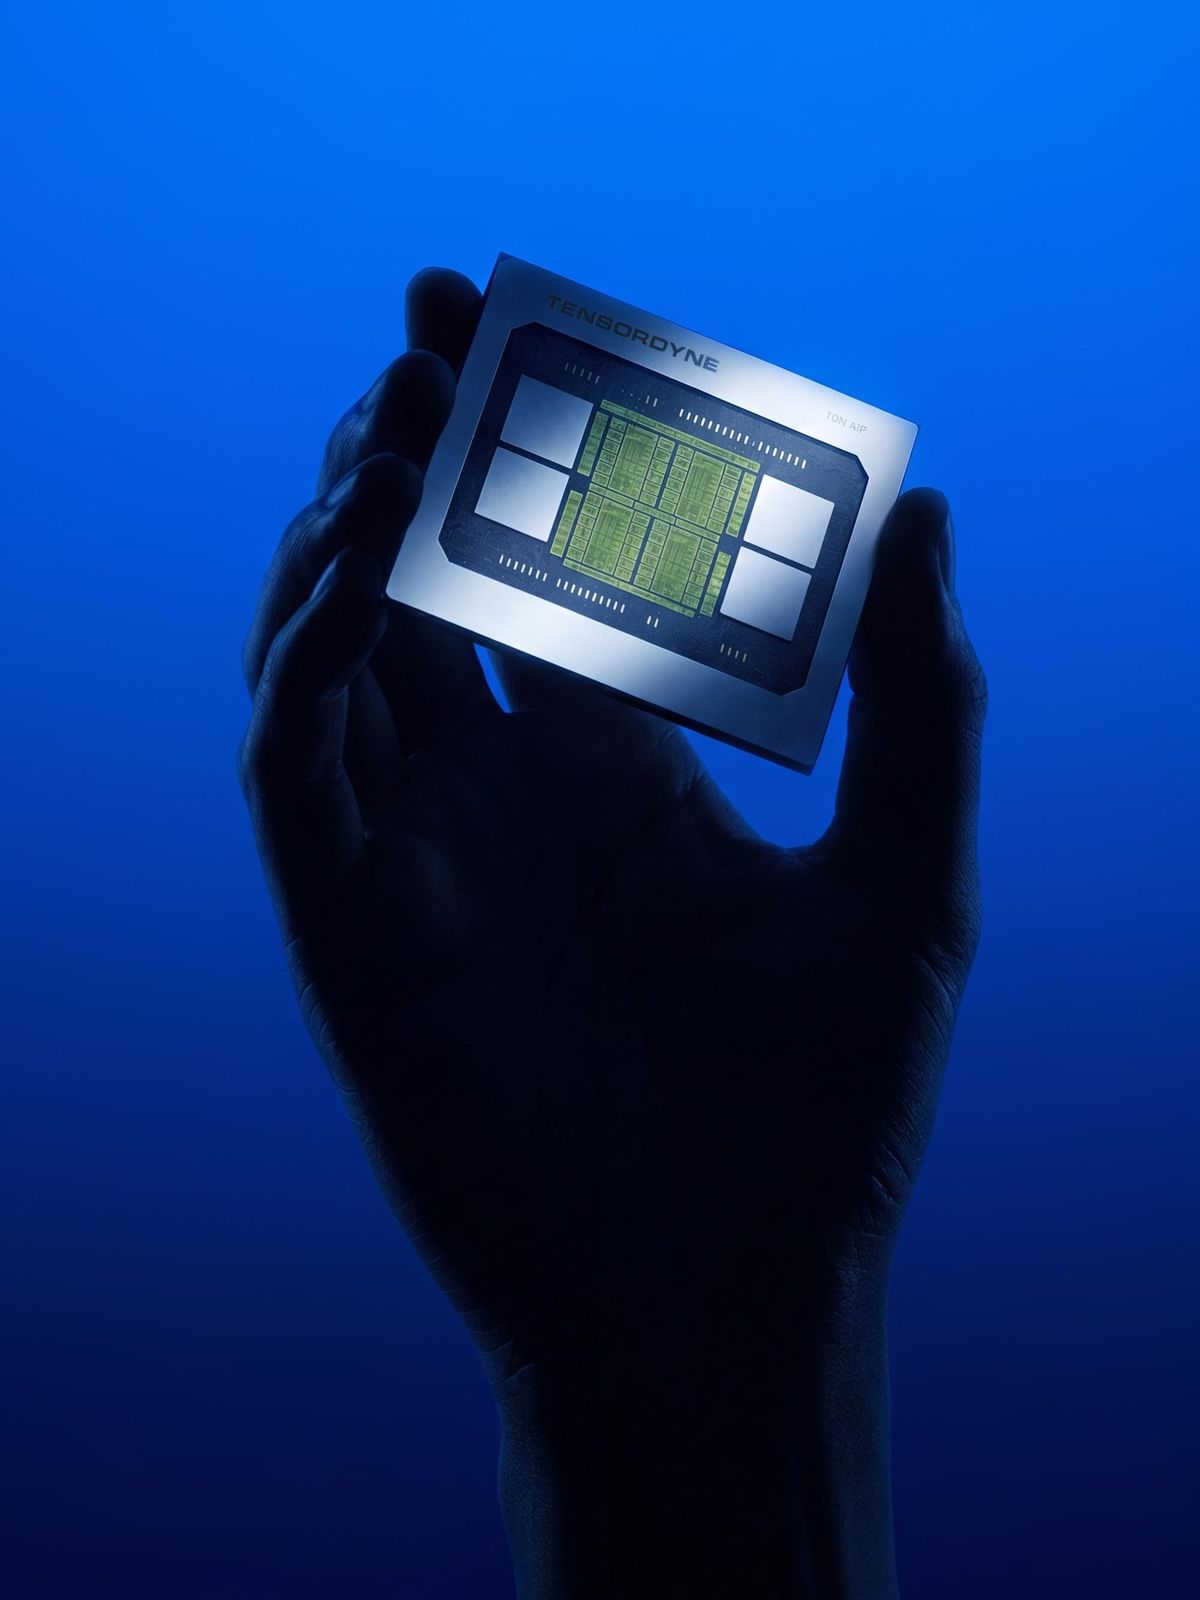
Tensordyne 的 Napier 芯片专为加速 AI 推理而设计。
Tensordyne DarkBlue1自 2020 年起,AI 领域的重心主要放在训练更大、更强的模型上。大语言模型(LLM)的参数规模从数百万膨胀至数万亿。这种策略被证明卓有成效:OpenAI 于 2020 年发布的 GPT-3 最大版本,在一项流行的知识与推理基准测试中,正确率仅为 43.9%。仅仅四年后,GPT-4o 在同一测试中的得分已 达到88.7%,基本追平了人类专家的水平。
尽管顶级 AI 实验室仍在训练规模更大的模型,但训练环节已逐渐退居 AI 讨论的背景。到了 2026 年,推理——即利用已训练的模型来生成代码、撰写文章或生成我们化身精灵的图片——已跃升至前台。
“训练已经变成了旧闻,”Moor Insights & Strategy 首席数据中心分析师 Matt Kimball 说道,“所有 CIO 想聊的只有推理。”Nvidia CEO 黄仁勋在 GTC 2026 大会上也推崇这一变化,称之为“推理的拐点”。
推动这一转变的原因之一其实很直接:大语言模型正在变得实用,人们开始大规模使用。此外,当前市场上的许多模型都是推理模型。面对用户查询,它们不止运行一次推理,而是通过反复自我提示来执行多次推理,这一过程被称为 思维链。推理模型生成的文本更长,高推理强度的模型相比低强度或无强度模型,产出的文本量最多可高出 20 倍。与此同时,Agentic AI的兴起进一步增加了全球推理负载:推理不再仅仅是实时响应用户查询,而是全天候自主运行,以达成用户定义的目标。
亚马逊的 Trainium 芯片最初为 AI 训练设计。但亚马逊云服务(AWS)将 AI 推理拆分为两部分:计算复杂度较高的部分由 Trainium 承担,而内存密集型任务则交给 Cerebras 的晶圆级引擎处理。Amazon
推理需求的爆发式增长催生了科技巨头间出人意料的联盟。尽管亚马逊拥有自研的Trainium芯片,但 OpenAI 和 亚马逊仍部署了由Cerebras设计的、直径约等于餐盘大小的芯片。Nvidia 以 200 亿美元的交易价格,从 AI 推理初创公司Groq收购了关键人才和知识产权,该交易颇具争议。而 Anthropic 每月向大模型竞争对手 SpaceXAI支付超过十亿美元,以租用闲置算力。
虽然看起来相似,但 AI 训练和 AI 推理在计算上是两回事。科技巨头的这些大动作表明,要支撑推理需求,所需硬件的组合方式,与专家几年前预想的可能截然不同。
AI 推理与 AI 训练有何不同?
一个未经训练的 LLM,就像散落在桌上的一堆拼字游戏牌块。只不过牌块上不是单个字母,而是词的片段,称为 token。写出几乎任何内容所需的素材都在这里,只是毫无条理。
训练模型的过程,就是通过大规模的猜词游戏来理顺这堆碎片。模型会看到一段真实文本,其中下一个 token 被隐藏起来,让它预测接下来是什么。每次猜测之后,正确的 token 会被揭示出来,与预测结果比对,差异则用来计算模型的准确度。这个游戏不是针对一句话,而是在数十亿篇文章上反复进行。
真实的拼字游戏可以边吃薯片边喝饮料轻松进行,AI 训练却是计算密集型的重活。模型通过反向传播来更新参数——这一过程反复计算模型的数十亿甚至数万亿个参数各自应该如何调整,才能让下一次预测更准确。这正是科技巨头们在建造史上更大数据中心的原因。
最终,模型开发者认为继续训练不值得投入,猜词游戏就此结束。反向传播停止,参数被冻结,LLM 成为预训练模型。再经过微调——即在更小、更专业的数据上进行的短期训练——做最后调整,模型便可部署上线。
Nvidia 的 Groq 3 语言处理单元通过在片上按使用顺序排布 SRAM 内存和计算单元,来尽量减少数据搬运。
Nvidia
接下来就是推理。这是使用已部署模型的过程——经过训练后,它已学会按合理的顺序吐出拼字牌块,也就是 token。
你可能认为,由于去除了更新参数所需的反向传播计算,AI 推理的算力需求其实更低。但推理硬件公司 d-Matrix 的创始人兼 CTO Sudeep Bhoja 解释称,推理环节其实带来了新的挑战。
模型在本质上具有“自回归”特性,即下一个输出依赖于前一个。Bhoja 解释道:“因此,为了生成下一个 token,你必须读取所有权重以及来自上一个 token 的全部上下文。”这里的上下文包括你的所有提示词、LLM 的所有回复以及你上传的所有文件。这意味着大量的数据和繁重的处理任务。
LLM 生成回复分为两个阶段:预填充(prefill)和解码(decode)。预填充即模型读取提示词的过程,它会一次性处理所有 token,计算每个 token 与其他所有 token 的关系。这一操作被称为 注意力机制(attention),是现代 LLM 背后的 Transformer 架构的标志性特征。它让模型能够结合单词在句子、段落及更大语境中的含义来响应,而不仅仅孤立地理解单词本身。这就好比在放置 Scrabble 字母砖前将它们排列组合:许多玩家会移动字母砖来构想它们如何连接。自注意力机制也扮演着类似的角色,只是它并非移动物理字母,而是让每个 token 向其他 token 发送查询,并接收一个表示相关性的分数。
这些查询会产生两种向量:键(keys)和值(values)。它们通常被存储在一个称为 KV 缓存(KV cache)的地方。从技术上说这并非绝对必要,模型本可以随每个新生成的 token 重新计算这些向量。但几乎所有 LLM 都使用 KV 缓存来减少计算量。KV 缓存驻留在内存中,充当 LLM 理解对话的便签本,起初它很小,但可能膨胀至数十 GB。
预填充是一个容易拆分并行处理的问题。这正是随着 LLM 普及度激增,GPU 成为主流 AI 加速器的原因。图像光栅化(计算屏幕每个像素的颜色)同样具有极高的并行性,因此 GPU 架构天然契合这类任务。
Cerebras 的晶圆级引擎芯片通过将所有组件——包括内存和计算单元——并排集成在比餐盘还大的芯片上,实现了内存带宽的最大化。
Cerebras
接下来是解码阶段。在此阶段,模型逐个生成回复 Token。每一步中,它都会获取最近的一个 Token,将其与 KV 缓存中的所有内容进行比对,利用这些信息预测下一个 Token,并将新 Token 的键(Key)和值(Value)添加到缓存中。随后,这一过程按顺序逐一重复。
模型这种自回归特性正是拖累推理速度的关键所在。预测每个 Token 都需要从内存中读取整个模型,而该模型可能包含数十到数百 GB 的参数(即模型在训练过程中学习到的数值表示)。更关键的是,这还不包括存储 KV 缓存所需的内存。
因此,这些海量数据在内存中的传输往往需要的带宽超过了推理硬件所能提供的上限。于是,GPU 中至少有一部分计算单元在等待数据时处于闲置状态。研究人员发现,运行开源 LLM 的 Nvidia H100 GPU 有 50% 到 80% 的时间处于闲置状态。
内存对推理的作用
曾担任 Meta 硅工程负责人、AI 初创公司 Majestic Labs 联合创始人 Shahriar “Sha” Rabii 表示,处理器闲置正是许多致力于提升 AI 推理性能的公司极度关注内存的原因。“采用基于 GPU 的方案,往往会导致算力严重过剩而内存资源不足。正是这种矛盾推动了[内存]的大规模扩展,”他说。
Bhoja 创立的 d-Matrix 和 Rabii 创立的 Majestic Labs 都将重点放在解决这一内存瓶颈上。不过,这两家公司设想的解决方案截然不同。
d-Matrix 的第二代 AI 加速器 Raptor 的目标是,通过缩短计算与存储之间的距离来提升推理性能。目前大多数 AI 推理部署中的 GPU 采用的做法,是把高带宽存储器(HBM)布置在 GPU 芯片的四周。每一块 HBM 都是多层 DRAM 芯片堆叠而成,通过一个超高速接口与 GPU 相连。这种方式用于训练很合适,但对于推理来说,能堆叠的内存容量以及所能提供的带宽就有些不足了。d-Matrix 的堆叠芯片架构
存储带宽——也就是数据从内存读取到逻辑电路的速度——是 AI 推理的一大瓶颈。初创公司 d-Matrix 通过把逻辑芯片直接堆叠在内存(这里是 DRAM)之上来提升带宽,从而实现大量极短的互连。
Chris Philpot
d-Matrix 的 Raptor 把 AI 加速器直接堆叠在 DRAM 芯片上,解决了这一瓶颈。不同于单纯堆叠内存,d-Matrix 堆叠的是内存与计算。Bhoja 表示,这把数据传输的距离缩短到了“微米级,而不是毫米级”。就像盖摩天大楼一样,向垂直方向发展,就能在同样的物理面积内实现更多功能。
Majestic 则采取相反的思路。它不追求缩短数据在计算与内存之间传输的距离,而是专注于改进内存接口,使其在保持高带宽的同时支持更长的走线。更长的走线让 Majestic 可以连接不直接紧挨 GPU 的内存堆栈,从而摆脱 HBM 的空间限制。
“内存接口能工作的物理距离非常短。以 HBM 为例,最多也就 2 到 3 毫米。GPU 四周就那么一圈‘海岸线’,是唯一能放 HBM 的地方,”Rabii 说。
Majestic 宣称其内存接口可将信号传输至约一米的距离。这一目标是通过专有铜链路和一颗负责协调数据的内存聚合芯片实现的。“聚合器是高速接口的终端,也是向海量通用 DRAM 芯片扇出的方式,”Rabii 说道。基于此,Majestic 可以在单个服务器机架中支持多达 128 TB 的 DRAM 内存,相比拥有约 20 TB HBM3E 的 Nvidia GB300 NVL72 机架,这是一个显著的突破。
Majestic Labs 的内存聚合架构
Majestic Labs 计划通过专有互连技术和内存聚合芯片来满足 AI 对内存的巨大需求,从而让单个机架能够访问多达 128 TB 的低成本 DRAM 内存。
Chris Philpot
d-Matrix 和 Majestic 有一个共同点:它们都使用现成的 DRAM 而非 HBM。DRAM 是全球最常见的计算机内存类型,从智能手机到汽车无处不在。内存分析师 Jim Handy 表示,HBM 的成本是 DRAM 的两到三倍。价格优势是 d-Matrix 和 Majestic 选择 DRAM 的重要原因之一。不过,包括 三星 和 SK Hynix 等内存巨头在内的 HBM 支持者并未坐视不管。
作为 HBM 内存的最新版本,HBM4 现已投产,并将用于预计于 2026 年下半年发货的 Nvidia Vera Rubin GPU。SK Hynix 内存系统研究负责人 Hoshik Kim 表示,HBM4 通过让最大内存带宽翻倍并增加每个堆栈中的 HBM 内存容量,“将彻底突破当前制约 AI 推理的内存瓶颈”。
芯片组合加速推理
巨头们——英伟达(Nvidia)和亚马逊(Amazon)——正在采取全面投入的策略。英伟达的 GPU 和亚马逊的 Trainium 训练加速器在推理工作的某些环节依然表现卓越,尤其是预填充(prefill)阶段,即计算所有上下文键值(keys and values)的过程。但为了加速解码(decode)阶段——也就是生成新 Token 的部分——他们正转向小型玩家推出的新型内存优先架构。
以英伟达为例,这家小型玩家是 Groq(注意不要与 SpaceXAI 训练的 LLM 系列 Grok 混淆)。英伟达在 2025 年底收购了 Groq 的知识产权并招揽其人才,仅仅三个月后,在英伟达 GTC 2026 大会上,黄仁勋便发布了英伟达 Groq 3 语言处理单元(LPU)。Groq 的架构核心在于内存——具体而言是 SRAM——其被直接构建在芯片架构内部。
除非你是芯片架构师,或是硬核 PC 游戏玩家,否则你可能从未想过 SRAM。SRAM 的优势在于与计算芯片架构紧密集成——它与处理器位于同一块硅片上——缺点是密度较低且成本高于 DRAM。大多数芯片仅包含几十兆字节(MB)的 SRAM。然而,AI 推理点燃了业界对 SRAM 的新兴趣,人们希望借此将内存中存储的模型权重拉近至计算单元。
Ian Buck,英伟达超大规模与高性能计算副总裁兼总经理,指出 LPU 的优先考量与公司 GPU 截然不同。LPU 的原始算力远低于标准 GPU,但它配备了 500 兆字节(MB)片上 SRAM,直接连接其浮点运算单元。“其优势在于内存带宽。LPU 的内存带宽是 GPU 的七倍,”他表示。
按照设想,Rubin GPU 与 Groq LPU 搭配使用,可以让 prefill 和 decode 两个阶段都获得加速,实现两全其美。“所有的注意力计算和上下文处理都在 Vera Rubin [GPU] 机架上完成,”Buck 解释道,“而专家计算……那些矩阵乘法,则由 LPU 来做。”这家公司将 256 颗 LPU 集成到 Groq 3 LPX 中,这套系统的体积相当于一个数据中心机架。
Nvidia 的双芯片推理方案
Nvidia 也计划把推理工作负载拆分到两颗芯片上。该公司最新的 Rubin GPU 将负责计算密集型的 prefill 阶段,而搭载大量片上 SRAM 的 Groq 3 语言处理单元(LPU)则处理内存密集型的 decode 阶段。
Chris Philpot
另一边,Amazon Web Services(AWS)与 Cerebras 达成了一项协议,将 Trainium 加速器与 Cerebras 的 Wafer-Scale Engine 3(WSE-3)配对使用。Cerebras 的思路与 Groq 类似,只是规模大得多。WSE-3 把整片硅晶圆做成一颗芯片,晶体管数量超过 4 万亿。这种设计不连接外部内存,而是在每片晶圆上直接蚀刻出 44 GB 的 SRAM。“我们把[模型]权重存在 SRAM 里,”曾任 Cerebras 产品营销总监、现已跳槽到 SpaceXAI 的 James Wang 说,“所以单颗芯片轻松就能支持 400 亿到 800 亿参数。”
Amazon 计划用 AWS Trainium 芯片做 prefill,用 Cerebras 做 decode。不过 Cerebras 的芯片也能独立完成推理。WSE-3 曾被 OpenAI 部署,用于驱动 GPT-5.3-Codex-Spark——该公司编程模型的一个变体,输出速度超过每秒 1000 个 token。作为对比,OpenAI 标准的 GPT-5.4 部署每秒只能输出 50 到 125 个 token。
AWS 的双芯片推理策略
AWS 将自家的 Trainium 芯片与 Cerebras 的晶圆级引擎(WSE,尺寸如同一块披萨)相结合,分别处理 AI 推理的不同阶段。Trainium 负责计算密集型的 prefill 阶段,而拥有片上 SRAM 内存的 WSE 则负责内存带宽受限的 decode 阶段。
Chris Philpot
Cerebras 无需将工作负载转移到其他专用芯片上即可独立处理 prefill。为此,它们将多块 WSE-3 芯片组网,形成单一的内存池。Cerebras 已展示其可支持高达 1T 参数规模的模型(如 Moonshot AI 的 Kimi 2.6),但 Wang 表示:“在能处理多少参数这一点上,该架构没有固有的限制。”
尽管策略存在差异,Nvidia 和 AWS 似乎都认同:大模型推理的未来将依赖系统性方法,即整合不同类型的芯片以支持最大的 LLMs。用 Buck 的话说:“要做到现代 AI 推理,你需要所有的芯片。”
用更少(位)做更多
Nvidia 设计出了全球最受欢迎的 GPU,并借此成为世界最具价值的科技公司。但业界的注意力并非全在提升推理硬件上。AI 研究人员也在同步优化 LLM 的软硬件架构,以最大程度利用内存和计算资源。
大多数计算机以 32 位或 64 位格式存储数字,这决定了一个数字可用多少位(bits)来表示。若位宽过窄,数字存储时会丢失信息。更精确的数字格式有利于提升 LLM 的质量,但这对推理性能提出了挑战。更高的精度并非零成本:描述这些数字的位需要占用更多内存空间,在计算时也消耗更多的硅片和能源。
Gilles Backhus 是 AI 加速器公司 Tensordyne 的联合创始人。他表示,这在模型尺寸和数值精度之间制造了张力。“你是希望模型体积为 x 但运行在 8-bit 精度,还是希望模型体积翻倍但运行在 4-bit 精度?”每种模型的内存和计算开销大致相同,“但 4-bit 方案能带来两倍的突触数量(打个比方)。人们正意识到 [4-bit 方案] 是值得的。”
将 LLM 从更精确的数值格式转换为更低精度格式的过程被称为 量化,这一技术已使用数年。然而,研究人员正在发现新的量化方法,能在大幅降低精度的同时保留模型大部分质量。
Nvidia 最近为此目的创建了一种新的 4-bit 数值格式 NVFP4。AMD、Intel 和 Qualcomm 则转而支持一种名为 MXFP4 的竞争性 4-bit 格式,Nvidia 也参与了该格式的开发。Nvidia 的 Buck 称:“这是 AI 的玄学。”据该公司称,当 Nvidia 将 DeepSeek-R1 从 FP8 量化到 NVFP4 时,七大主要基准测试的性能降幅不足 1%,而性能却提升了三倍。
量化很可能只是冰山一角,AI 研究人员和初创公司正在探索多种优化机会,其中一些可能会彻底改变 AI 推理硬件中的硅片架构。
Tensordyne 独特的 AI 推理方法结合了其对数数值格式和公司 Napier 芯片中的定制硬件。Tensordyne
Tensordyne 计划利用对数数字系统来加速 AI 推理,其原理基于对数的一条性质:log(A×B) = log(A) + log(B)。也就是说,芯片只需存储数字的指数,就能用加法替代原本的乘法。这在硬件层面意义重大,因为乘法器电路比加法器更耗电、占用的晶片面积也更大。Tensordyne 表示,其名为 Napier 的机架级硬件可以为每位用户提供最高每秒 1,300 个 token 的生成速度,而且功耗不到同级 Nvidia 硬件的十分之一。
位于加州圣何塞的初创公司 Etched 走得更远,它直接把 LLM 所用的 Transformer 架构“烧”进了芯片。这家公司不做通用 GPU,而是把高效 Transformer 计算所需的连接直接布线到芯片里——牺牲了灵活性,但在当前 LLM 最常见的任务上效率更高。该公司称,其首款 AI 加速器 Sohu 运行 Meta 的 Llama 70B 模型时,速度高达每秒 50 万个 token。不过这条路也意味着,一旦 LLM 偏离典型的 Transformer 架构,这颗芯片就无能为力了。
这些思路能否奏效,还有待时间检验。Etched 刚在 8 月交付了首个机架,Tensordyne 的首批硬件则预计 2027 年问世。即便如此,这些初创公司已经证明:对推理性能的巨大需求,正在催生各种不走寻常路的方案。
推理,人人都能入场
AI 推理加速的路线五花八门——把算力堆到内存旁边、把接口从毫米级延伸到米级、用整片晶圆做 SRAM、把模型压缩到 4 bit——这难免让人发问:谁会赢,谁会输?
但专家认为,这恐怕问错了问题。当下对 AI 的需求近乎永不满足,尽管 AI 泡沫的担忧始终笼罩着这个行业,增长却丝毫没有放缓。
恰恰相反,Moor Insights & Strategy 的 Kimball 认为,推理在长期内可能驱动 AI 硬件的旺盛需求,因为这种需求的边界尚不明确。他表示:“你可以向组织中引入一百万个智能体。这些系统可以全天候运转;不像我们要在晚上五点下班回家。”
如果 AI 推理确实如 Kimball 所预期的那样具有强大的吸引力,其演进轨迹很可能类似于 CPU。CPU 并非沿单一维度提升,而是同时在 多个层面 取得突破。当晶体管微缩进程放缓后,各类芯片与系统架构创新便纷纷涌现。要列出推动当今通用且强大的个人计算能力的所有单项创新,其篇幅足以填满数十本书。
几十年后,回顾 AI 推理创新的历程,将会展现出类似的深度。
From Your Site Articles