
美国指控中国AI“工业规模蒸馏”:这不是知识产权战,是准入战
本文来自微信公众号: 斯凯碎碎侃 ,作者:斯凯
9月8日,美国国家安全局、网络安全与基础设施安全局、联邦调查局三家机构联合发布了一份网络安全通告,编号AA26-251A。
通告点名DeepSeek、月之暗面、阿里巴巴、MiniMax、阶跃星辰、智谱六家中国AI企业,指控它们自2024年底起,通过“工业规模”的知识蒸馏,系统性地从美国前沿模型中提取能力。
9月9日,中国商务部回应了八个字:于事无凭,于法无据。外交部发言人毛宁的表态更直接:中国AI的发展是“高水平科技自立自强的成果”。
但这件事真正的看点,不在“指控是否成立”,而在“为什么是蒸馏”。美方真正想堵的,不是技术通道,是准入通道。
蒸馏到底是什么,为什么美方急了
知识蒸馏这个概念,2015年由Hinton等人正式提出。核心逻辑是“教师-学生”架构:让一个已经训练好的大模型(教师)把自己学到的知识,“教”给一个更小的模型(学生)。
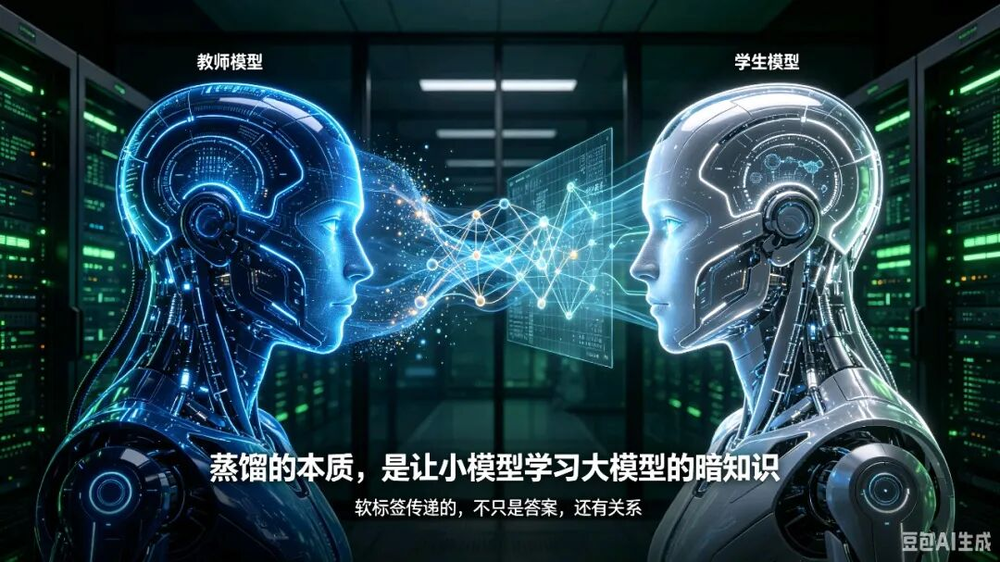
关键在于怎么“教”。传统训练用的是硬标签——这张图是猫,不是狗。蒸馏用的是软标签——教师模型输出的概率分布。Hinton把这个概率分布里隐藏的信息称为“暗知识”(Dark Knowledge)。
举个例子。教师模型看到一张模糊的图,输出“80%猫、15%狗、5%狐狸”。学生模型学的不是“这是猫”,而是“猫和狗之间有一定相似性,和狐狸相似度更低”。软标签传递的是教师模型对世界的关系性理解,比硬标签丰富得多。
蒸馏本身是合法的、通用的技术手段。包括美国企业在内,全球模型企业都在用。中方的反驳很直接:蒸馏是业内通行做法,美方将其政治化,是双重标准。
那美方为什么急了?
AA26-251A通告里有一段话暴露了真实意图。通告称,中国企业的蒸馏活动“庞大规模与复杂手段表明,蒸馏并非这些企业AI模型研发的辅助手段,而是其至关重要的核心”,还声称这“显著缩短了AI开发周期,大幅降低了训练前沿模型所需的资金投入”。
翻译一下:你用比我少得多的算力和资金,通过蒸馏就追上了我的模型能力。这条路我不让你走了。
这和芯片禁运的逻辑是一脉相承的。2022年禁先进芯片,2023年禁光刻机,2026年禁模型输出。封锁线从硬件层向算法层延伸。芯片是物理入口,蒸馏是知识入口。堵住物理入口之后,现在要堵知识入口。
美方具体指控了什么
通告列举了相当详细的指控:
中国企业通过“数百万次模型交互”获取了“数十亿个token”的数据。访问渠道包括原生API、远程云服务、第三方聚合平台,以及被称为“transfer stations”的API代理渠道。部分企业批量购买高级账户由开发团队共享,在不同访问渠道之间自动切换以降低成本和规避检测。
被“蒸馏”的美国模型覆盖了Claude 3.7、Claude Sonnet 4系列、Claude Opus 4.1、Gemini 2.5系列、GPT-4、GPT-4o、GPT-5以及Grok 4。提取的能力方向包括法律专业能力、API规则任务、思维链推理、智能体功能、问答优化和监督微调。
通告还特别针对一家企业提出质疑,称其披露的模型训练成本“未计入通过外部模型获得训练数据所对应的价值”。
CISA代理局长安德森敦促AI企业“立即采取措施保护平台”,建议的防御措施包括:监控24小时持续高通量并发、缺乏人类操作停顿间隔、提示词呈现标准化模板特征的异常账户;对疑似恶意蒸馏请求“引入具有针对性的微小扰动与性能降级,以污染下游训练数据质量”。
“污染下游训练数据”——这个建议本身就很值得玩味。不是拒绝服务,是让服务给你,但给的是被污染的数据。这不是技术防御,是数据投毒。
中方的反制逻辑:合同问题,不是知识产权问题
商务部回应的核心有三层:
第一层:蒸馏是中性技术。全球模型企业都在用,包括美企。帮助模型提升学习效率,更高效利用人类知识。
第二层:双重标准。中方开源模型向包括美企在内的全球企业开放,“美企有关模型研发报告也披露,其大量蒸馏中国模型”。你指责我蒸馏你,你自己也在蒸馏我。
第三层:以打击蒸馏为名,行产业垄断之实。由安全部门发布通告,“将个别企业和资本利益与国家安全相捆绑,动用国家强权机构干涉正常商业活动”。美企在用户协议中设置“宽泛的地域限制等霸王条款”,美方指控有“为这些霸王条款背书之嫌”。
从法律角度看,中方的反驳有依据。法律界分析指出,蒸馏争议中,“最稳妥的责任基础仍是合同违约”,而非知识产权侵权。因为蒸馏不直接复制教师模型的代码或训练数据,它所模仿的具体知识形态“难以构成版权、专利或商业秘密保护的对象”。
违反服务条款,和窃取知识产权,是两个完全不同量级的事。前者是合同纠纷,后者是刑事犯罪。美方把前者包装成后者,本质是在为制裁寻找合法性外衣。
一个更大的背景:中美元首峰会前的筹码
这件事的时间点不是偶然的。
通告发布时,距离中美元首华盛顿峰会还有不到三周。两国元首已同意开展人工智能政府间对话,商务部在回应中专门提到“中方愿意以平等互利、合作共赢原则,通过对话与美方开展建设性和专业的讨论”。
但对话之前,先亮刀子。这是典型的谈判筹码战术——在坐上谈判桌之前,把筹码堆到最高。
中方的回应也留了余地:愿意对话,但“如果美方以打击蒸馏为名,实施遏压中国人工智能企业的行动,中方必将坚决采取措施予以反制”。
这是一场谁都不想彻底撕破脸、但谁都不愿意先退的博弈。
这件事的真正分水岭
AA26-251A的通告性质需要看清楚:它是一份网络安全通告,不是出口管制规则,不是制裁决定,也不是司法判决。
但它可能成为后续制裁的法律基础。通告给出了企业名单、行为描述和检测指引。如果美方下一步要实施制裁,这份通告就是“事实认定”。如果美方要推动立法限制蒸馏,这份通告就是“证据材料”。
而中方的反制,也不只是口头上的。商务部明确说了“必将坚决采取措施予以反制”。具体措施尚未公布,但方向可能是:进一步限制美国AI企业在华业务、加速国产算力替代、推动开源模型生态独立于美国技术栈。
这场“蒸馏之争”的真正分水岭不在于谁赢了口水仗,而在于它是否加速了两个AI生态的彻底分裂。
如果美国用安全部门的力量把“模型输出”也纳入了出口管制范畴,那就意味着:从芯片到模型能力,从硬件到知识,中美AI之间的每一条通道都可能被切断。到那时候,开源和闭源、接入和隔离、共享和封锁,将不再是一个技术路线选择,而是一个地缘政治站队。
对于那些还在用美国模型做蒸馏来训练自己产品的中国AI公司来说,AA26-251A是一个明确的信号:这条路,可能要走到头了。不是因为技术上走不通,是因为法律和政治上不让走了。
而对于那些做开源模型、做国产替代、做独立技术栈的人来说,这份通告反而是一张“路标”——它告诉你,哪条路以后走不通了,哪些方向会变成刚需。
蒸馏是技术问题。但AA26-251A不是。