
NVIDIA NVLink 6 如何实现多层弹性支撑 AI 工厂
对于大规模 AI 工厂的运营者而言,最大化持续产出是提升生产力的关键。在超大规模 AI 训练中,集群中的每个 GPU 必须每秒在数千次集合通信操作间同步梯度。同理,在推理阶段,非计划停机直接减少了服务的总请求量,严格限制了收入生成。
随着 AI 模型呈指数级增长,支撑其训练和服务所需的网络基础设施必须同步扩展。然而,在大规模部署中,瞬时错误、链路退化和节点中断是数学上的必然。
为了维持集群的最佳利用率,网络必须保证这些紧耦合的工作负载能无中断地推进。任何丢包都不应导致推理延迟激增或干扰训练集体通信。在规模化场景下,即使是罕见的丢包也可能累积为显著的有效吞吐量(goodput)下降。因此,真正无损的 fabric(通信架构)是生产级 AI 基础设施的先决条件。
NVIDIA Vera Rubin 是一个全栈式 AI 工厂平台,在各类 AI 和加速计算工作负载中提供可互换的计算能力。针对 AI 工作负载,它旨在以 1/4 的 GPU 数量完成训练,并以最低的 token 成本实现每瓦特最高的推理吞吐量。Vera Rubin NVL72 作为该平台的核心机架级计算引擎,通过 NVIDIA NVLink 6 扩展网络 fabric 将 72 个 Rubin GPU 连接为单一的扩展域(scale-up domain),使其作为统一的计算单元运行。
NVIDIA NVLink 6 通过综合的弹性框架,为这些工作负载提供了不可妥协的可靠性。通过原生检测、隔离并恢复瞬时信号错误,NVLink 确保了连续运行和集群的最大生产力。
为何多层弹性是唯一路径
在现代 AI 工厂的规模下,被动式协议和单点修复从根本上不足以应对挑战。作为 AI 互连领域的行业领导者,NVIDIA 将 NVLink 的弹性设计为一个精心集成的多层堆栈,涵盖硬件、系统设计和软件。
首先,在物理层和链路层,NVLink 强制执行一个原生无损的传输架构。它通过结合前向纠错(FEC)、物理层重传(PLR)以及通用物理层(UPHY)恢复技术,快速完成纠错以维持链路稳定性。此外,它利用基于信用的流控(CBFC)从数学角度彻底消除数据包丢失,并部署主动式错误控制,在故障级联扩散之前立即将其隔离。
其次,由于任何低于整体系统冗余程度的设计都可能带来隐患,该架构旨在实现零单点故障。冗余交换机托盘、分布式 NMX 控制器以及双通道的带外管理路径共同确保,即使个别组件失效,整个域也能保持正常运行。
最后,在应用层和软件层,Dynamo Shadow Engine Recovery 等功能利用预热的副本进程执行近乎即时的故障切换,而应用级的检查点与恢复机制则确保长时间运行的任务得以完整保留。这种紧密集成的多层策略是维持硬件异常无缝隔离、确保运行中工作负载不中断、并满足大规模 AI 对极高可用性严苛要求的唯一经证实的方法。
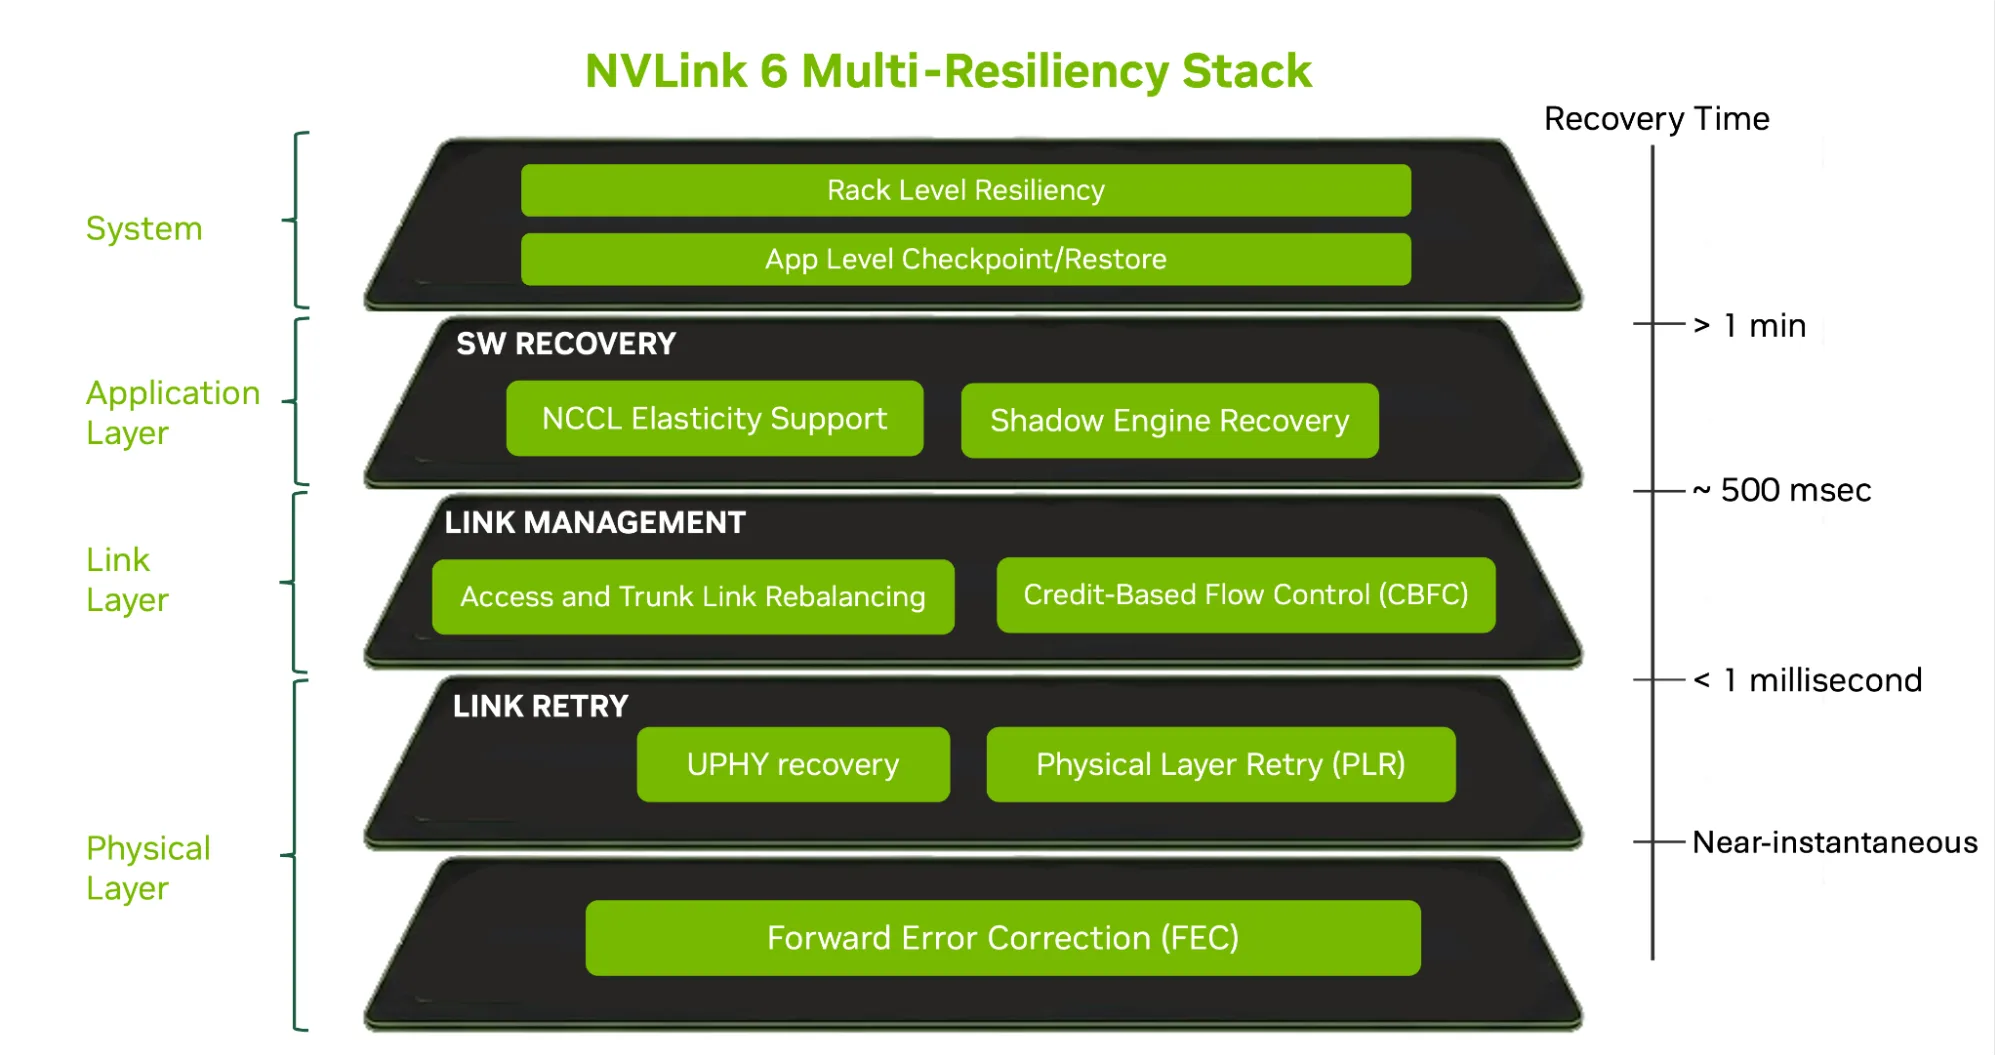
图 1. NVLink 的多层韧性架构
下面我们详细介绍这套多层架构在实际中是如何运作的。
通过物理层从源头消除错误
在最底层的物理层,NVLink 直接在硅片层面应对电气噪声和信号衰减。在极高的信号速率下,噪声引起的比特错误在所难免。普通网络架构依赖标准的重量级 FEC 算法,这会带来可观的处理开销和多跳延迟。而 NVLink 是专为紧耦合的 scale-up AI 工作负载设计的。
关键在于,NVLink 以 PLR 作为快速的第二道防线,从而避开了这些重量级 FEC 算法。这种架构上的配合让 NVLink 可以采用轻量高效的 FEC 设计。它不像基本的奇偶校验那样只能检测故障,而是让发送端口在数据流中附加先进的纠错码。
接收端则利用这些纠错码在线上以数学方式重建损坏的比特,以近乎零延迟的代价纠正单比特或多比特错误。这种高效设计直接成就了 NVLink 端到端延迟降低 3 倍、包速率提升 10 倍的能力,远超通用 Ethernet 方案。
当错误突发超出轻量级 FEC 的纠错能力时,第二道防线会立即启动。PLR 是一种成熟且经过充分验证的物理层报文重传机制。由于重传直接在物理层完成,PLR 能把丢包有效降为零,完全无需动用更高层的软件栈。
最后,如果严重劣化触发了物理层的 Link Down 事件,UPHY 恢复机制会快速重新校准物理参数,同时报文被安全地保存在硬件重放缓存中,确保零数据丢失。
通过链路层确保无损传输
向上层栈扩展来看,NVLink 依靠链路层管理网络拥塞,无需上层软件介入。支撑该层的关键机制是 CBFC(基于信用的流控),这是 NVLink 构建原生无损 Fabric 与传统协议的核心差异所在。基于标准以太网的 Scale-up 替代方案通常依赖 PFC(优先级流量控制)和 ECN(显式拥塞通知)等附加机制,试图模拟无损传输。 然而,这些被动应对机制会引入新的失效模式,例如队头阻塞、PFC 风暴以及死锁。这些缺陷使拥塞管理本身也成为可靠性风险。此外,传统的基于确认的机制要求接收方在事后报告成功或失败,当缓冲区溢出并需要重试时,会进一步增加延迟。 在 CBFC 机制下,只有当发送方持有表示下一跳已有足够缓冲区空间接收其数据包时,才会向网络注入新数据包。这种主动式设计从根本上消除了丢包,在硬件层面保证了无损传输,同时避免了以太网 PFC 带来的网络停顿。 由于传输过程中不会出现静默丢包,网络行为保持高度可预测,延迟始终稳定较低。与此同时,如果底层物理链路性能下降,链路管理器会自动修复 NVLink 网络,通过执行接入链路和主干链路的再平衡来恢复服务。 最重要的是,该机制确保了硬件故障能在本地被隔离处理,避免触发那些常见于现成以太网 AI 集群的级联重传、超时或整体停滞等问题。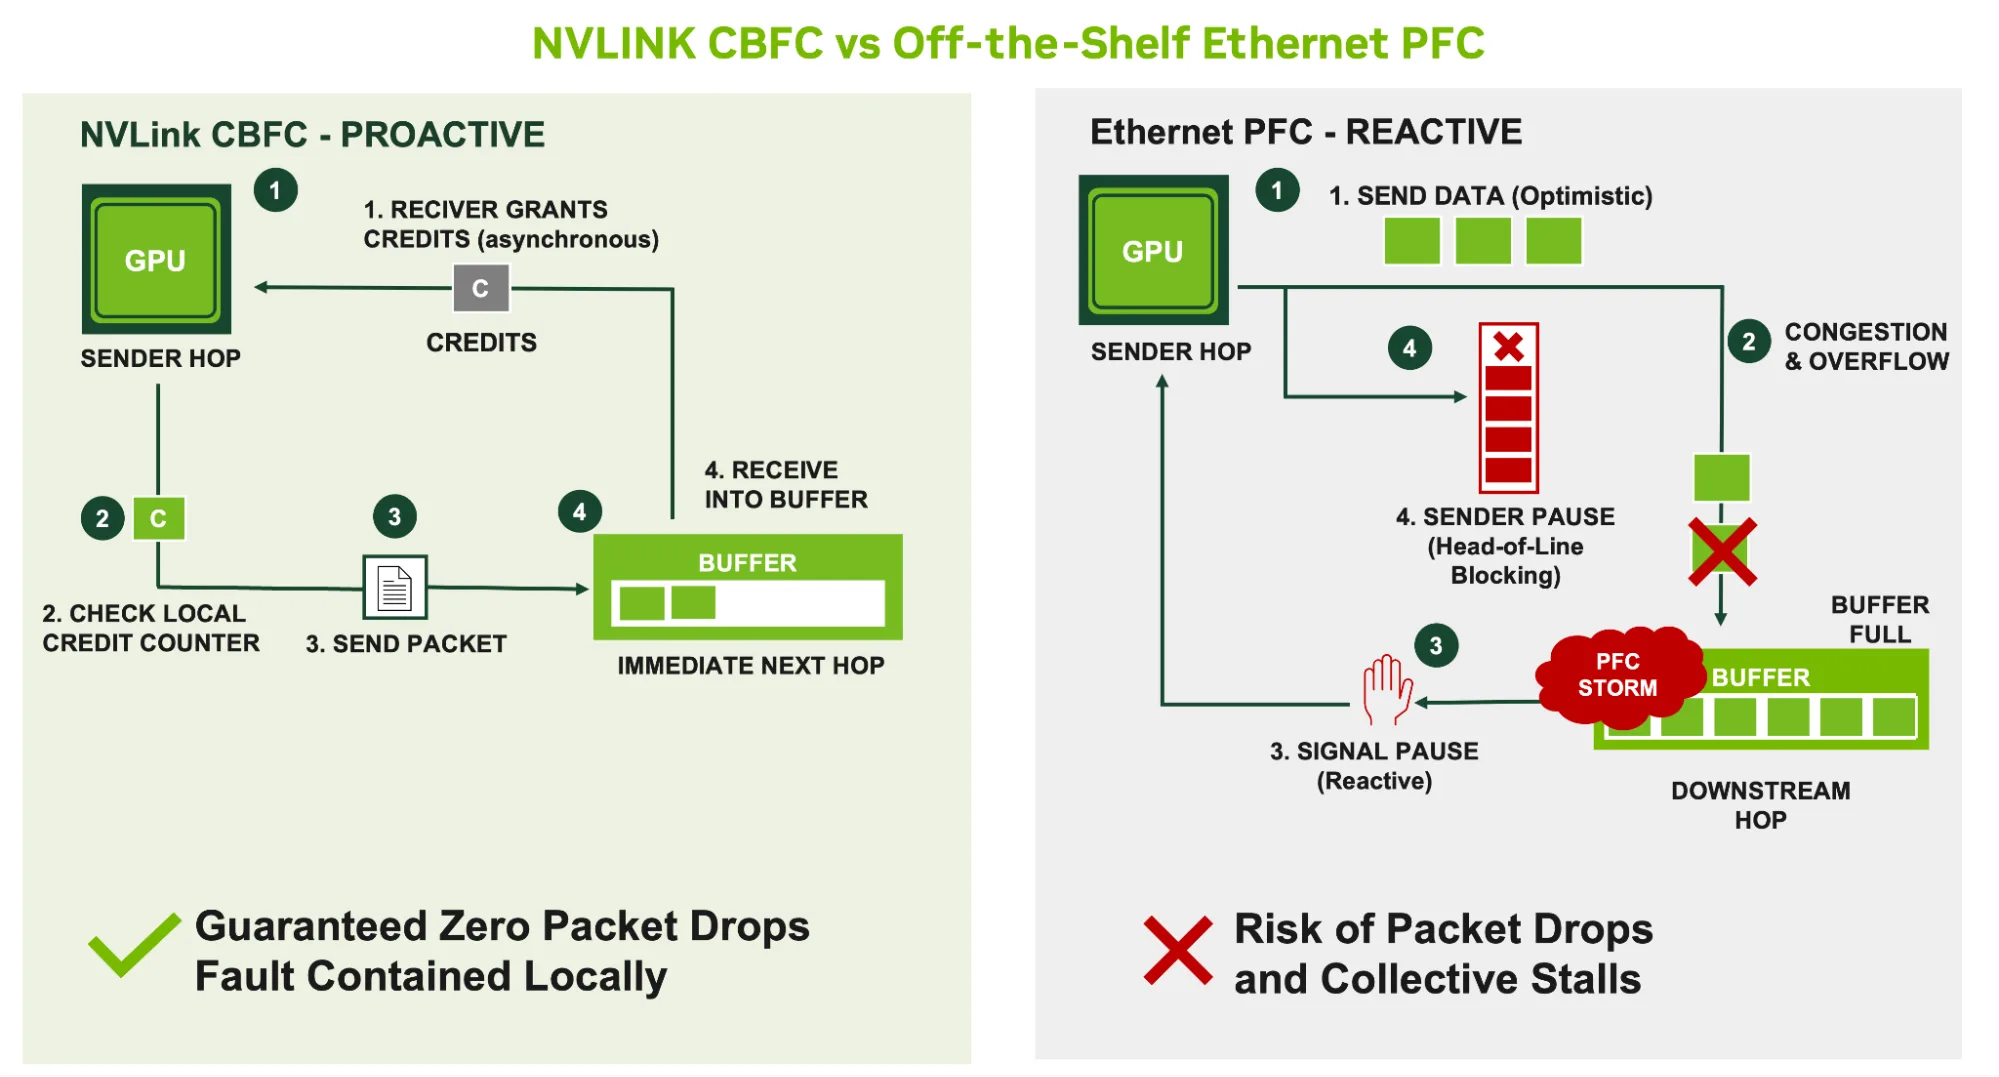
通过应用层软件恢复实现故障隔离
应用层提供智能的软件驱动事务恢复 (SW Recovery),耗时约 1.5 秒。当链路发生错误时,NMX 控制器直接配合 GPU 驱动程序,将受影响的链路置入“包含并排空 (contain and drain)”状态。这使硬件能够在防止全系统背压 (back-pressure) 的同时,自动对劣化的链路进行重新训练,且不会导致数据损坏。
为了消除控制平面的单点故障,NVLink SDN 控制 (NMX-C) 采用 NMX 高可用性 (NMX-HA) 机制。它部署在交换机托盘之一上,如果主用主机故障,NMX-C 会在数秒内自动将功能控制器迁移到备用托盘。此外,NVLink 交换机托盘的数据平面与运行 NVOS 的交换机管理 CPU 完全解耦。即使在非计划的 CPU 重置或操作系统故障发生时,数据平面也会持续不断转发数据,从而允许 NVOS 在不丢包或中断业务负载的情况下恢复。
NCCL 软件层弹性与影子引擎恢复
虽然 NVLink 的物理层和链路层能够成功拦截并纠正绝大多数信号错误,但偶尔还是会有无法修复的链路劣化问题传递到软件栈。在多 GPU 推理部署中,LLM 依赖 NVIDIA Collective Communications Library(NCCL)在 NVLink fabric 上快速同步数据。一旦某条 NVLink 连接发生严重中断,就会引发瞬时的通信故障,导致 NCCL 操作失败,迫使正在运行的 LLM 引擎中止。
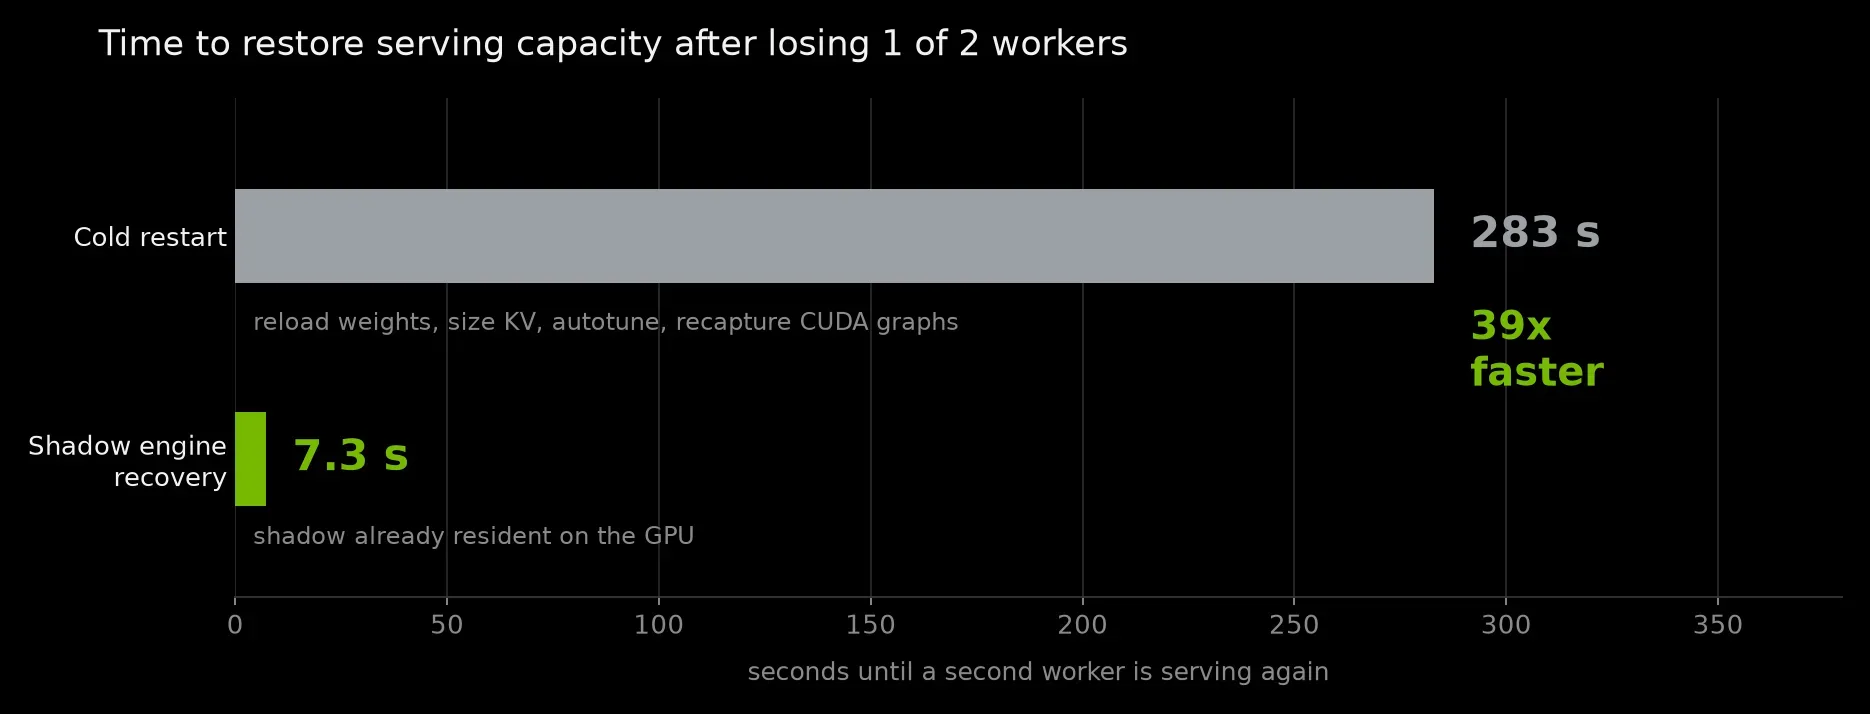
以往遇到这种情况,需要对推理引擎进行完整的冷重启:重新加载模型权重到 HBM、重新编译 kernel、重新捕获 CUDA graphs——整个过程可能让推理服务中断数分钟,严重拖累 token 吞吐量。为了消除这一瓶颈,软件韧性栈引入了 Shadow Engine Recovery,这是 NVIDIA Dynamo 中的一项功能,可以跳过冷重启,在几秒内恢复推理能力。
问题在于,NCCL 通信器与其创建时的活跃进程集合紧密绑定,崩溃后无法动态交接给替代进程。
Shadow Engine 架构的解决方案是:在活跃推理引擎旁边维护一个完全初始化好的空闲副本进程。启动阶段,这个备用引擎会预先建立自己独立的 NCCL 和 NIXL 通信器。当硬件故障中断主进程的通信上下文时,shadow engine 已经持有一条绑定 NVLink fabric 的健康、预热完毕的网络拓扑,可以立即恢复 Tensor Parallelism(TP)等分布式操作,无需等待重建 NCCL 通信器或重新加载模型权重。在 NVIDIA B200 GPU 上的基准测试部署中,shadow engine 恢复将推理停机时间从 283 秒缩短到了 7.3 秒。
此外,对于需要在硬件故障期间适应节点数量变化的负载,软件栈还集成了 NCCL 弹性支持,可动态伸缩通信器,保证任务平稳运行。
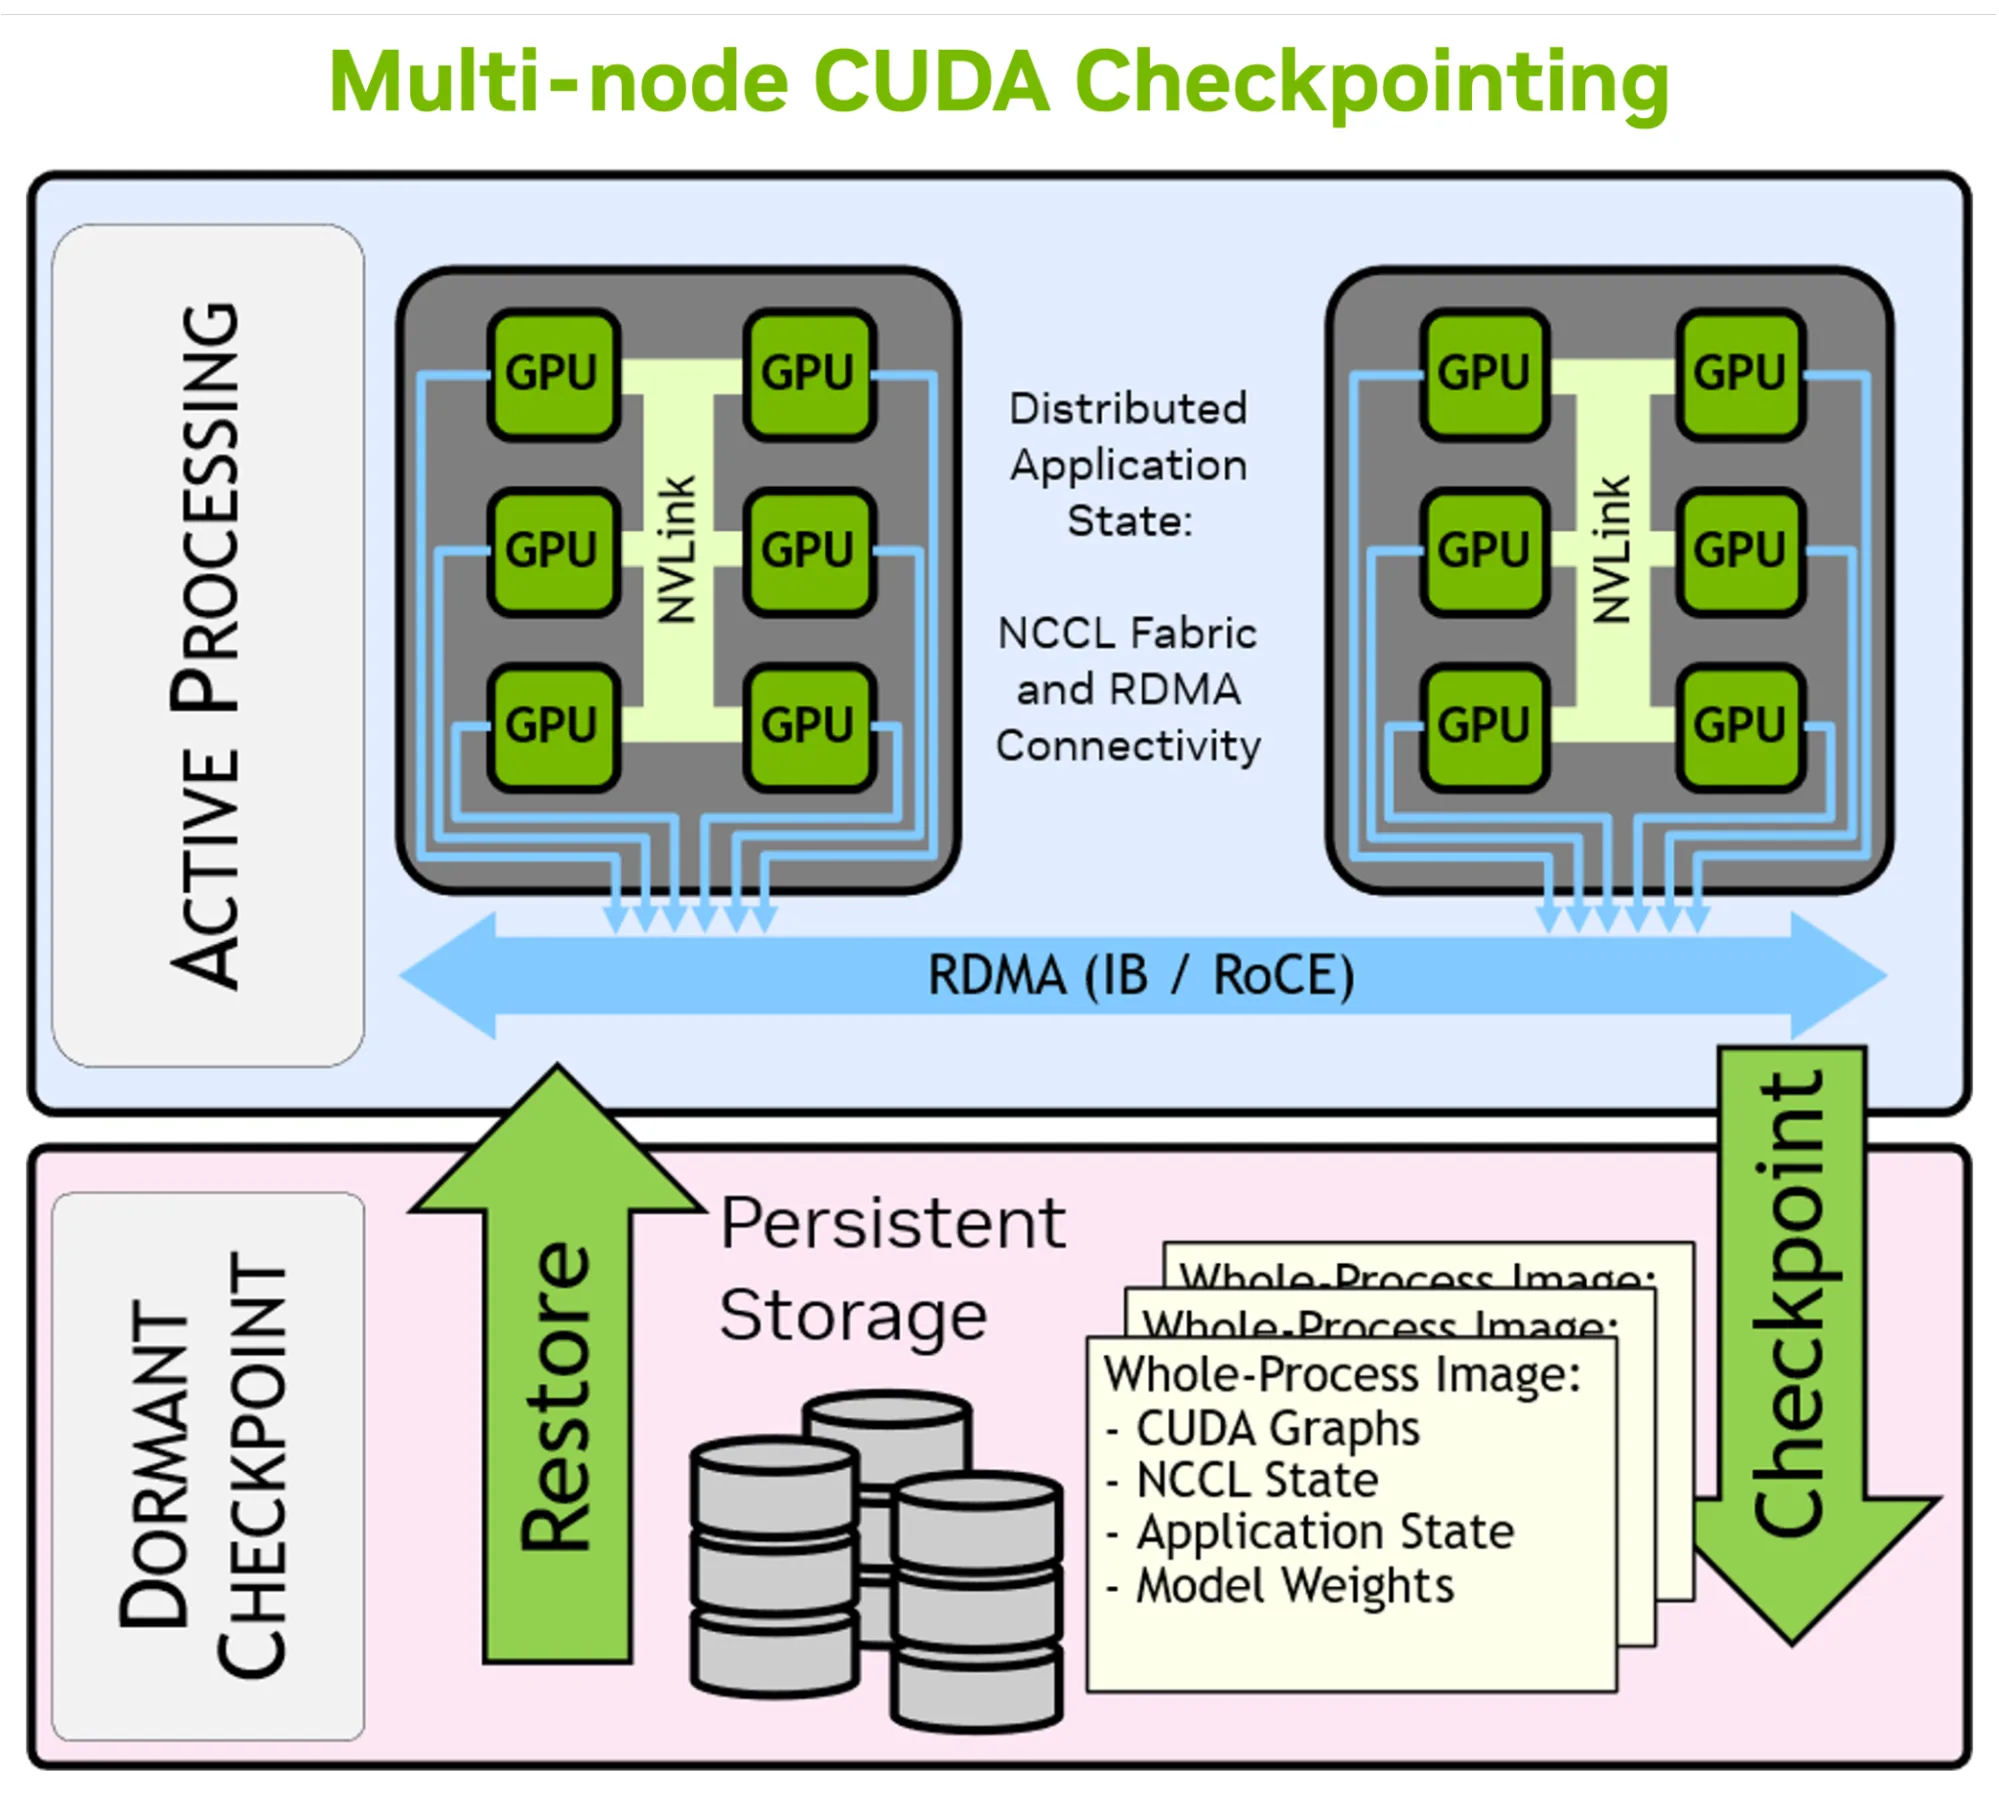
基于 CUDA 检查点的 NCCL 软件层弹性机制
偶尔会发生中断,导致推理引擎的部分或全部进程需要在新节点上重启。为了加速这类场景,CUDA 支持使用 CRIU 进行进程级检查点管理。这使得完整的 LLM Worker 进程可以在 GPU 上快速进行检查点和恢复,从而绕过启动开销。Dynamo Snapshot 集成了这项技术,将启动时间提升了一个数量级。
直到最近,这种检查点方法仅包含节点本地状态,且必须在建立任何网络连接或创建 CUDA graphs 之前进行。为了突破这一限制,NCCL 引入了 cuda-checkpoint 的原型支持(预计年底正式发布),允许多节点检查点捕获启动和加载 LLM 推理引擎期间执行的几乎所有操作。这一方法显著降低了推理服务和 Agent 等对延迟敏感工作负载的启动和重启开销。
在这一弹性软件基础之上,应用还能可靠地借助 NVIDIA NeMo 框架实现异步 checkpointing,或通过NVComp 进行 checkpoint 压缩,将状态数据保存至高带宽 NVLink 网络,从而进一步缩短耗时。对于超大前沿模型而言,这种组合能大幅减少同步阻塞时间,将 checkpoint 开销从分钟级压缩至秒级,并在发生故障时确保快速恢复。
通过机架级可服务性维持持续运行
在宏观层面,System Layer 负责长期状态保留以及物理机架级别的健康监测与可服务性管理,处理的恢复时间尺度超过一分钟。这种宏观层面的弹性依赖于网络与计算栈的深度融合。NCCL 原生支持 NVLink 拓扑感知,能够通过重建集合通信环或树形结构来绕过故障硬件,从而动态适应链路性能下降。
CUDA 与之协同工作,为有序内存操作提供更丰富的错误报告和恢复机制。它将硬件故障清晰地呈现给运行时,而不是让系统无声地挂起,从而保证应用始终可感知、可响应。
在数据中心物理运维层面,Switch Admin State 让 NVSwitch 托架维护变成有针对性、无中断的操作。系统管理员可以更换单个交换机托架,而无需清空整个 NVLink 域,也不会影响正在运行的 AI 作业。管理状态会将更换后的链路保持在非工作模式,避免其过早投入使用,直到经过显式验证并启用。
此外,NVLink 原生支持部分装配的机架。NMX Controller 会自动发现可用的硬件,并根据实际存在的计算或交换机托架配置路由,让分阶段部署或维护期间也能平稳运行。
通过 NVLink Fusion 将多层可靠性延伸到自研 XPU
上述完整的可靠性体系并不局限于使用 NVIDIA GPU 的部署。随着超大规模云厂商和 AI 原生公司越来越多地为特定工作负载打造自研 XPU,他们同样需要在大规模场景下拥有这种毫不妥协的可靠性。而从历史上看,将最先进的容错 scale-up 网络集成到自研芯片中,一直是一道巨大的工程门槛。
NVLink Fusion 通过将 XPU 接入 NVIDIA AI 基础设施来解决这些难题。借助这一集成,第三方芯片可以无缝继承与本文所述完全相同的 NVLink scale-up 网络架构和多层可靠性体系。依托这一经过验证的成熟平台,NVLink Fusion 帮助超大规模云厂商和 AI 原生公司提升性能、加快上市速度,并获得当今 AI 工厂所需的可靠性。
在大规模场景下确保毫不妥协的可靠性
当企业为大规模 AI 和加速计算工作负载评估 scale-up 架构时,仅对比带宽数字是远远不够的。真正的规模化,需要的是全栈层面的容错能力。
NVLink 6 专为最大化 MTBI 而生,采用全方位的多层级容错设计。从亚毫秒级的物理层纠错、原生基于信用的流量控制,到解耦的管理平面以及机架级可维护性,NVLink 提供了所需的韧性,确保全球最复杂的 AI 工厂不间断运行。
欲了解更多关于 NVIDIA Vera Rubin 平台、NVLink 以及 NVLink Fusion 的信息。
或者查看 大规模扩展网络如何决定 AI 工厂的经济效益。