
一个月为 M4 Mac Mini 造出 Linux GPU 驱动
前一篇博客:https://codyho.dev/blog/hypervisor-macbook-neo/
我们做了什么
太长不看:Niklas 和我在一个月内,为 M4 Mac Mini 和 MacBook Neo 构建了一个完全符合 OpenGL ES 3.0 规范的 GPU 驱动,这一过程通常以年计。下图展示了在我们的驱动支持下,M4 Mac Mini 上运行的 Chrome 和 Firefox(WebGL 及合成器正常工作):
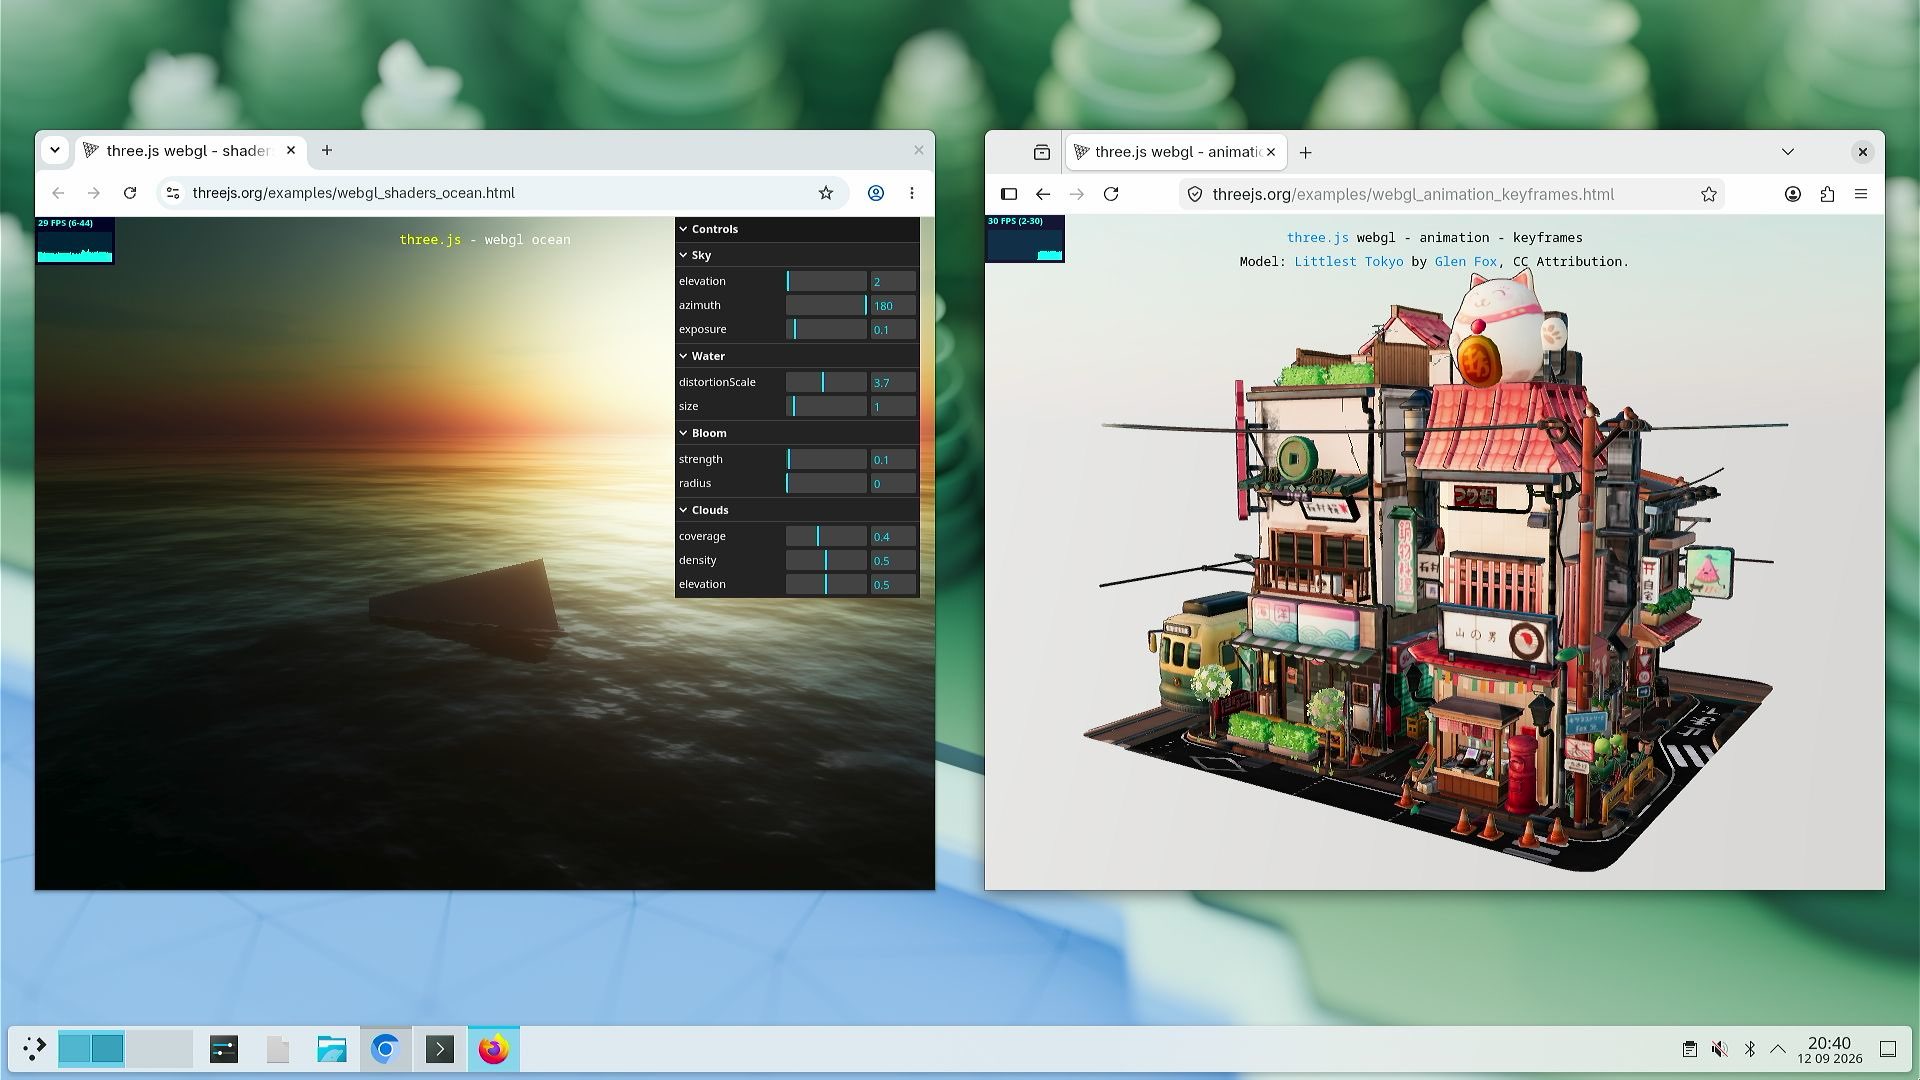
最重要的是,该驱动速度快到足以让 Minecraft 达到 200fps:
构建此驱动涉及逆向工程 AGX(苹果对 GPU 的称呼)极其复杂的固件 ABI 和用户态组件。所有工作均采用成熟技术,以透明、可验证的洁净室方式完成。代码目前尚未准备好供最终用户使用,但我们希望尽快交付给最终用户。
我们是怎么做的
此前,我开发了一个虚拟机监控器(hypervisor)来逆向工程 macOS。现在的目标是将它用于做点实际有用的事,而编写 GPU 驱动再合适不过了。GPU 几乎是现代系统的必备组件,否则所有渲染都得依靠 CPU,那在速度上慢了好几个数量级,功耗也更高。我们的目标是为 M4 Mac Mini 和 MacBook Neo 实现符合规范的 OpenGL(以及即将到来的 Vulkan)驱动。
通常,构建 GPU 驱动是耗时数年的工程;我们的目标是在几天内完成。事实证明,“几天”过于乐观,但“几周”已经是巨大的飞跃。在这几周里,我们完成了:
- 仅通过实时探测,逆向工程了 M4、A18 Pro 以及(大部分)M5 的用户态,发现了苹果驱动未输出的、受硬件支持的特性和指令
- 构建了一个完全可用的用户态驱动,包括新的自定义 IR/着色器编译器、指令流构建器以及其他许多组件
- 利用之前构建的虚拟机监控器捕获的跟踪信息,从零开始逆向工程了完整的 AGX 固件 ABI
- 为该固件 ABI 实现了完整的 Linux 内核驱动
agx-re 仓库)。
这篇博文分为两部分:用户态和内核态。这也对应了所有现代 GPU 驱动的划分方式:内核负责与固件交互、分配缓冲区、管理调度,但缓冲区里装了什么、调度的是什么,内核一概不知。真正理解 GPU 如何工作、往缓冲区里填内容的,是用户态。
内核态
在 Apple Silicon 上,内核驱动并不直接与硬件打交道,而是与 GPU 固件通信——这个固件运行在一个叫 RTKit 的定制 RTOS 上。所以写内核驱动的第一步不是操作硬件,而是搞清楚固件的 ABI。 固件 ABI 是整个项目中最烦人的部分。Apple 没有走正路——设计一套接口清晰的合理 ABI——而是把一个普通的内核驱动拦腰砍成两半,一半塞进 AGX 称之为固件,另一半留在内核侧,两者通过内存中的共享结构体通信。很多结构体里,固件拥有的字段(我们绝不能修改、只能靠逆向工程摸清)和主机控制的字段交错混杂在一起。想知道这套 ABI 有多复杂,看看 M1/M2 上的共享内存树就明白了: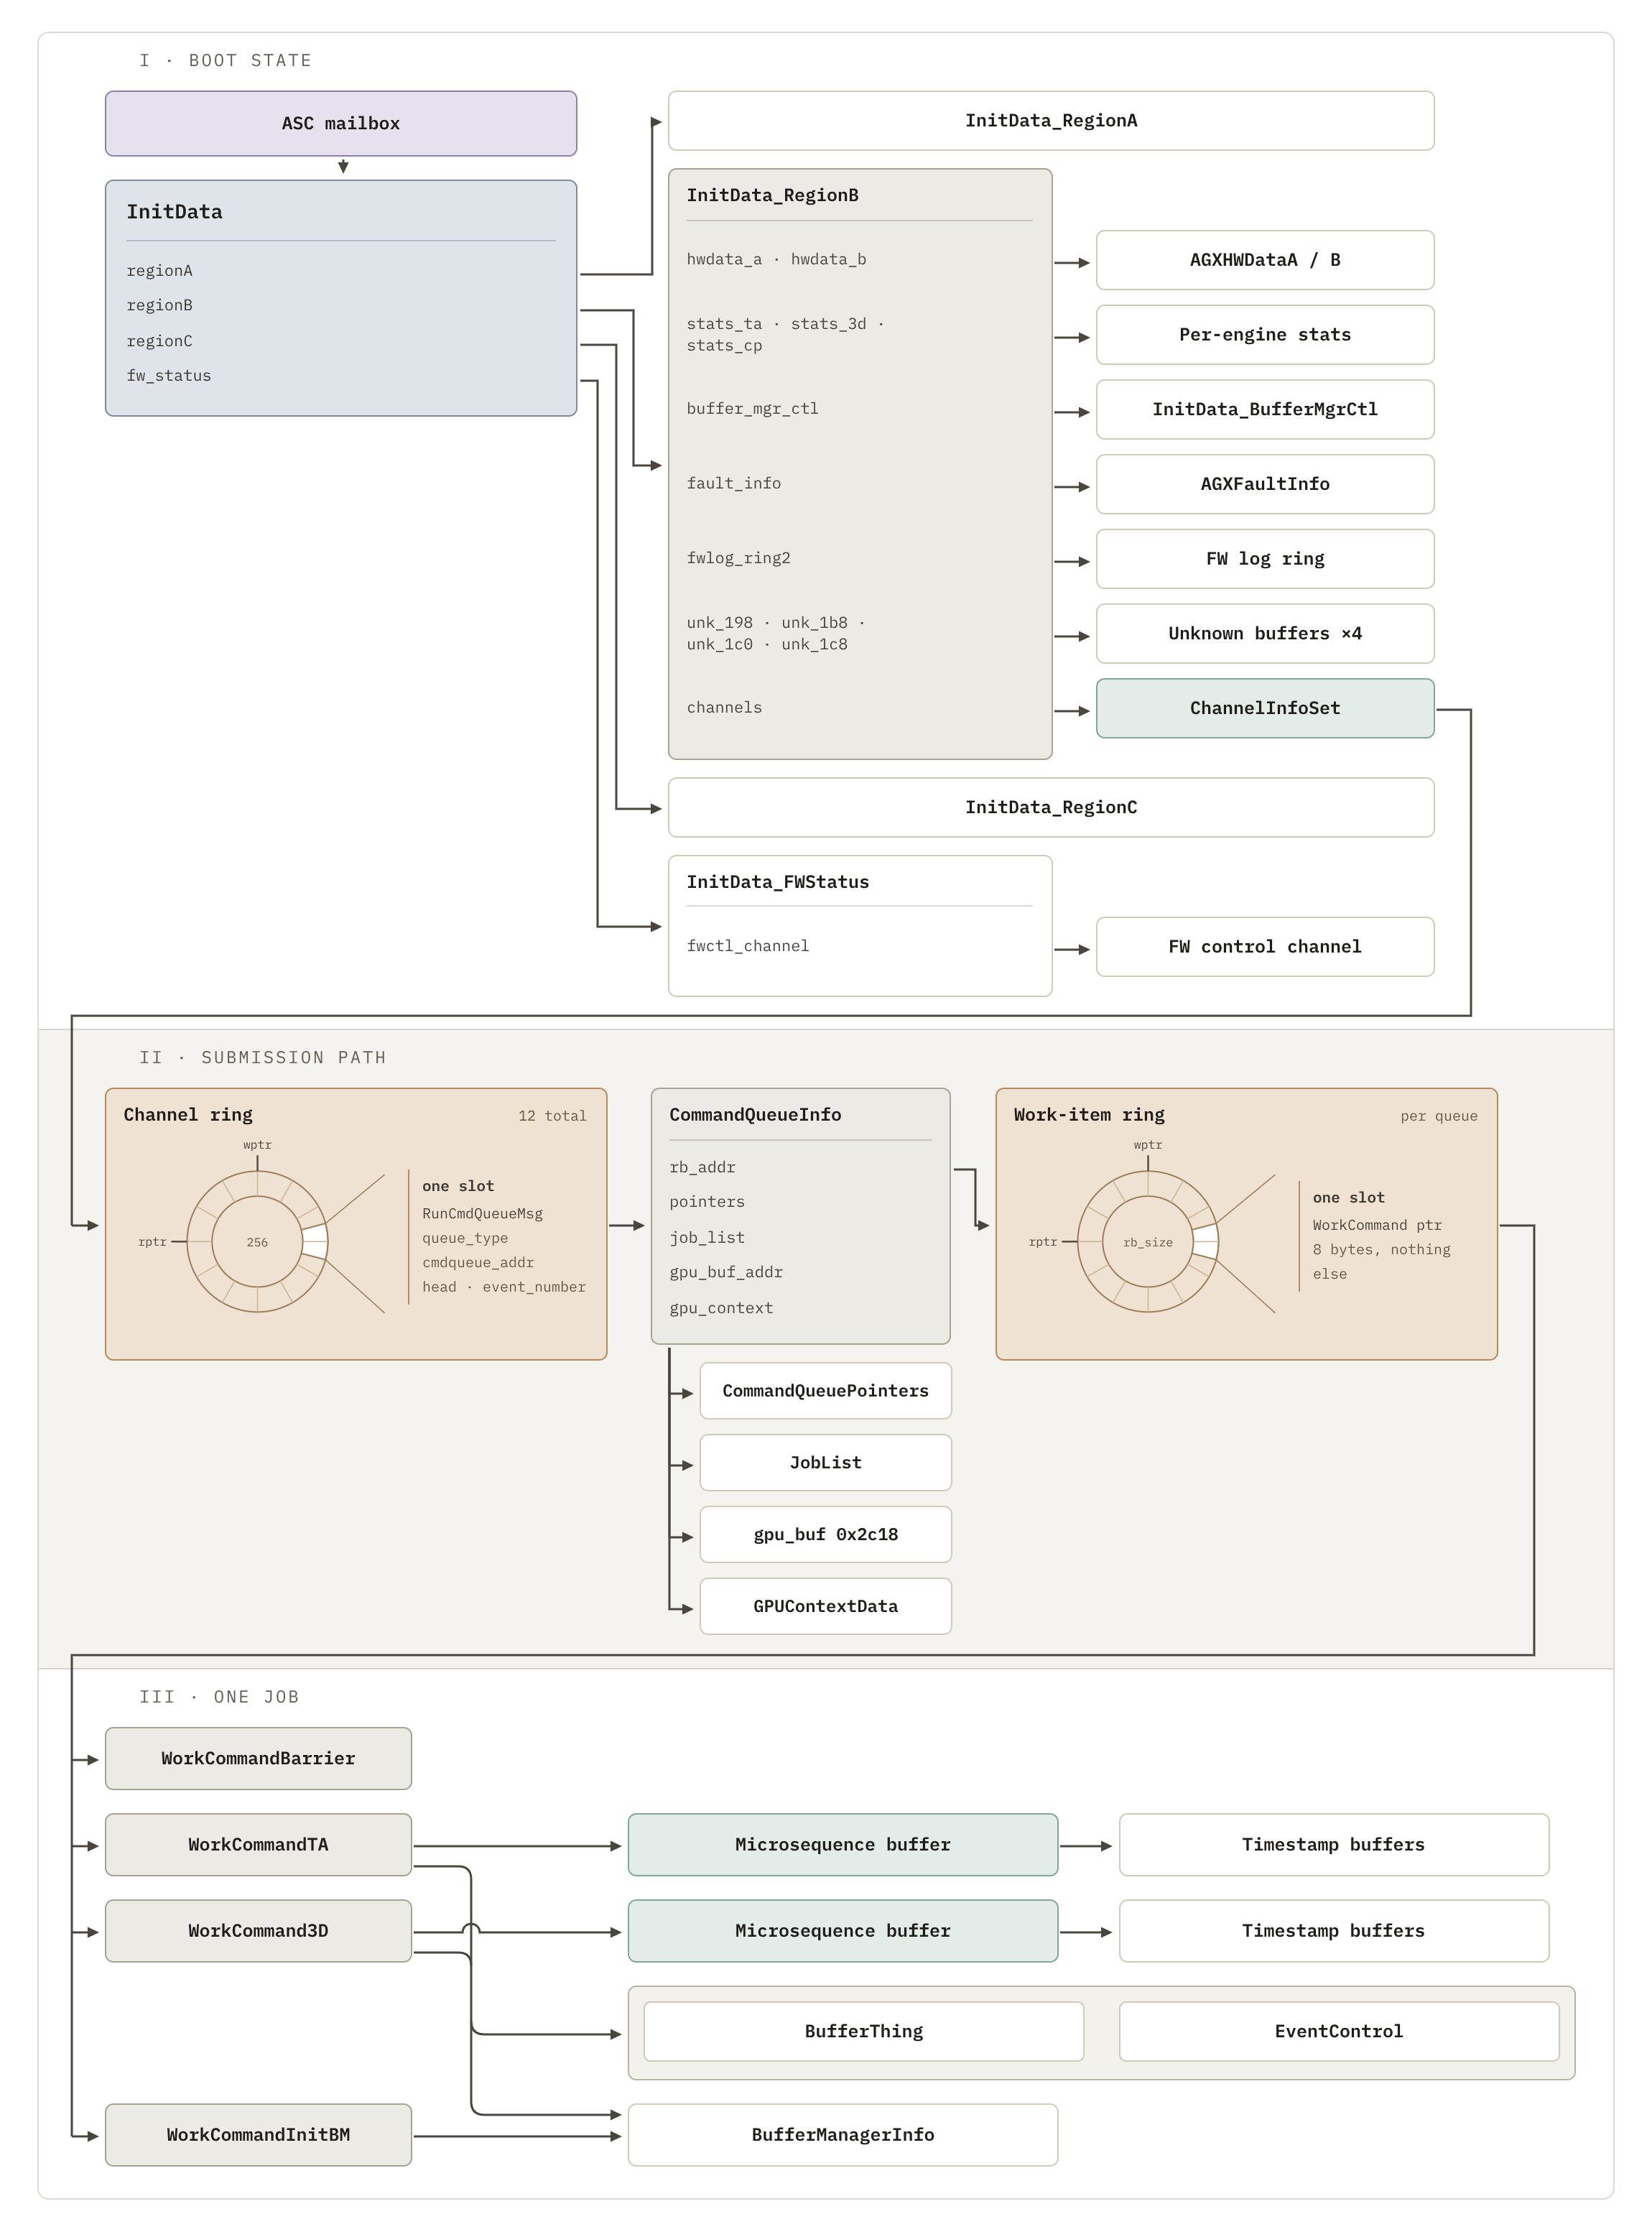
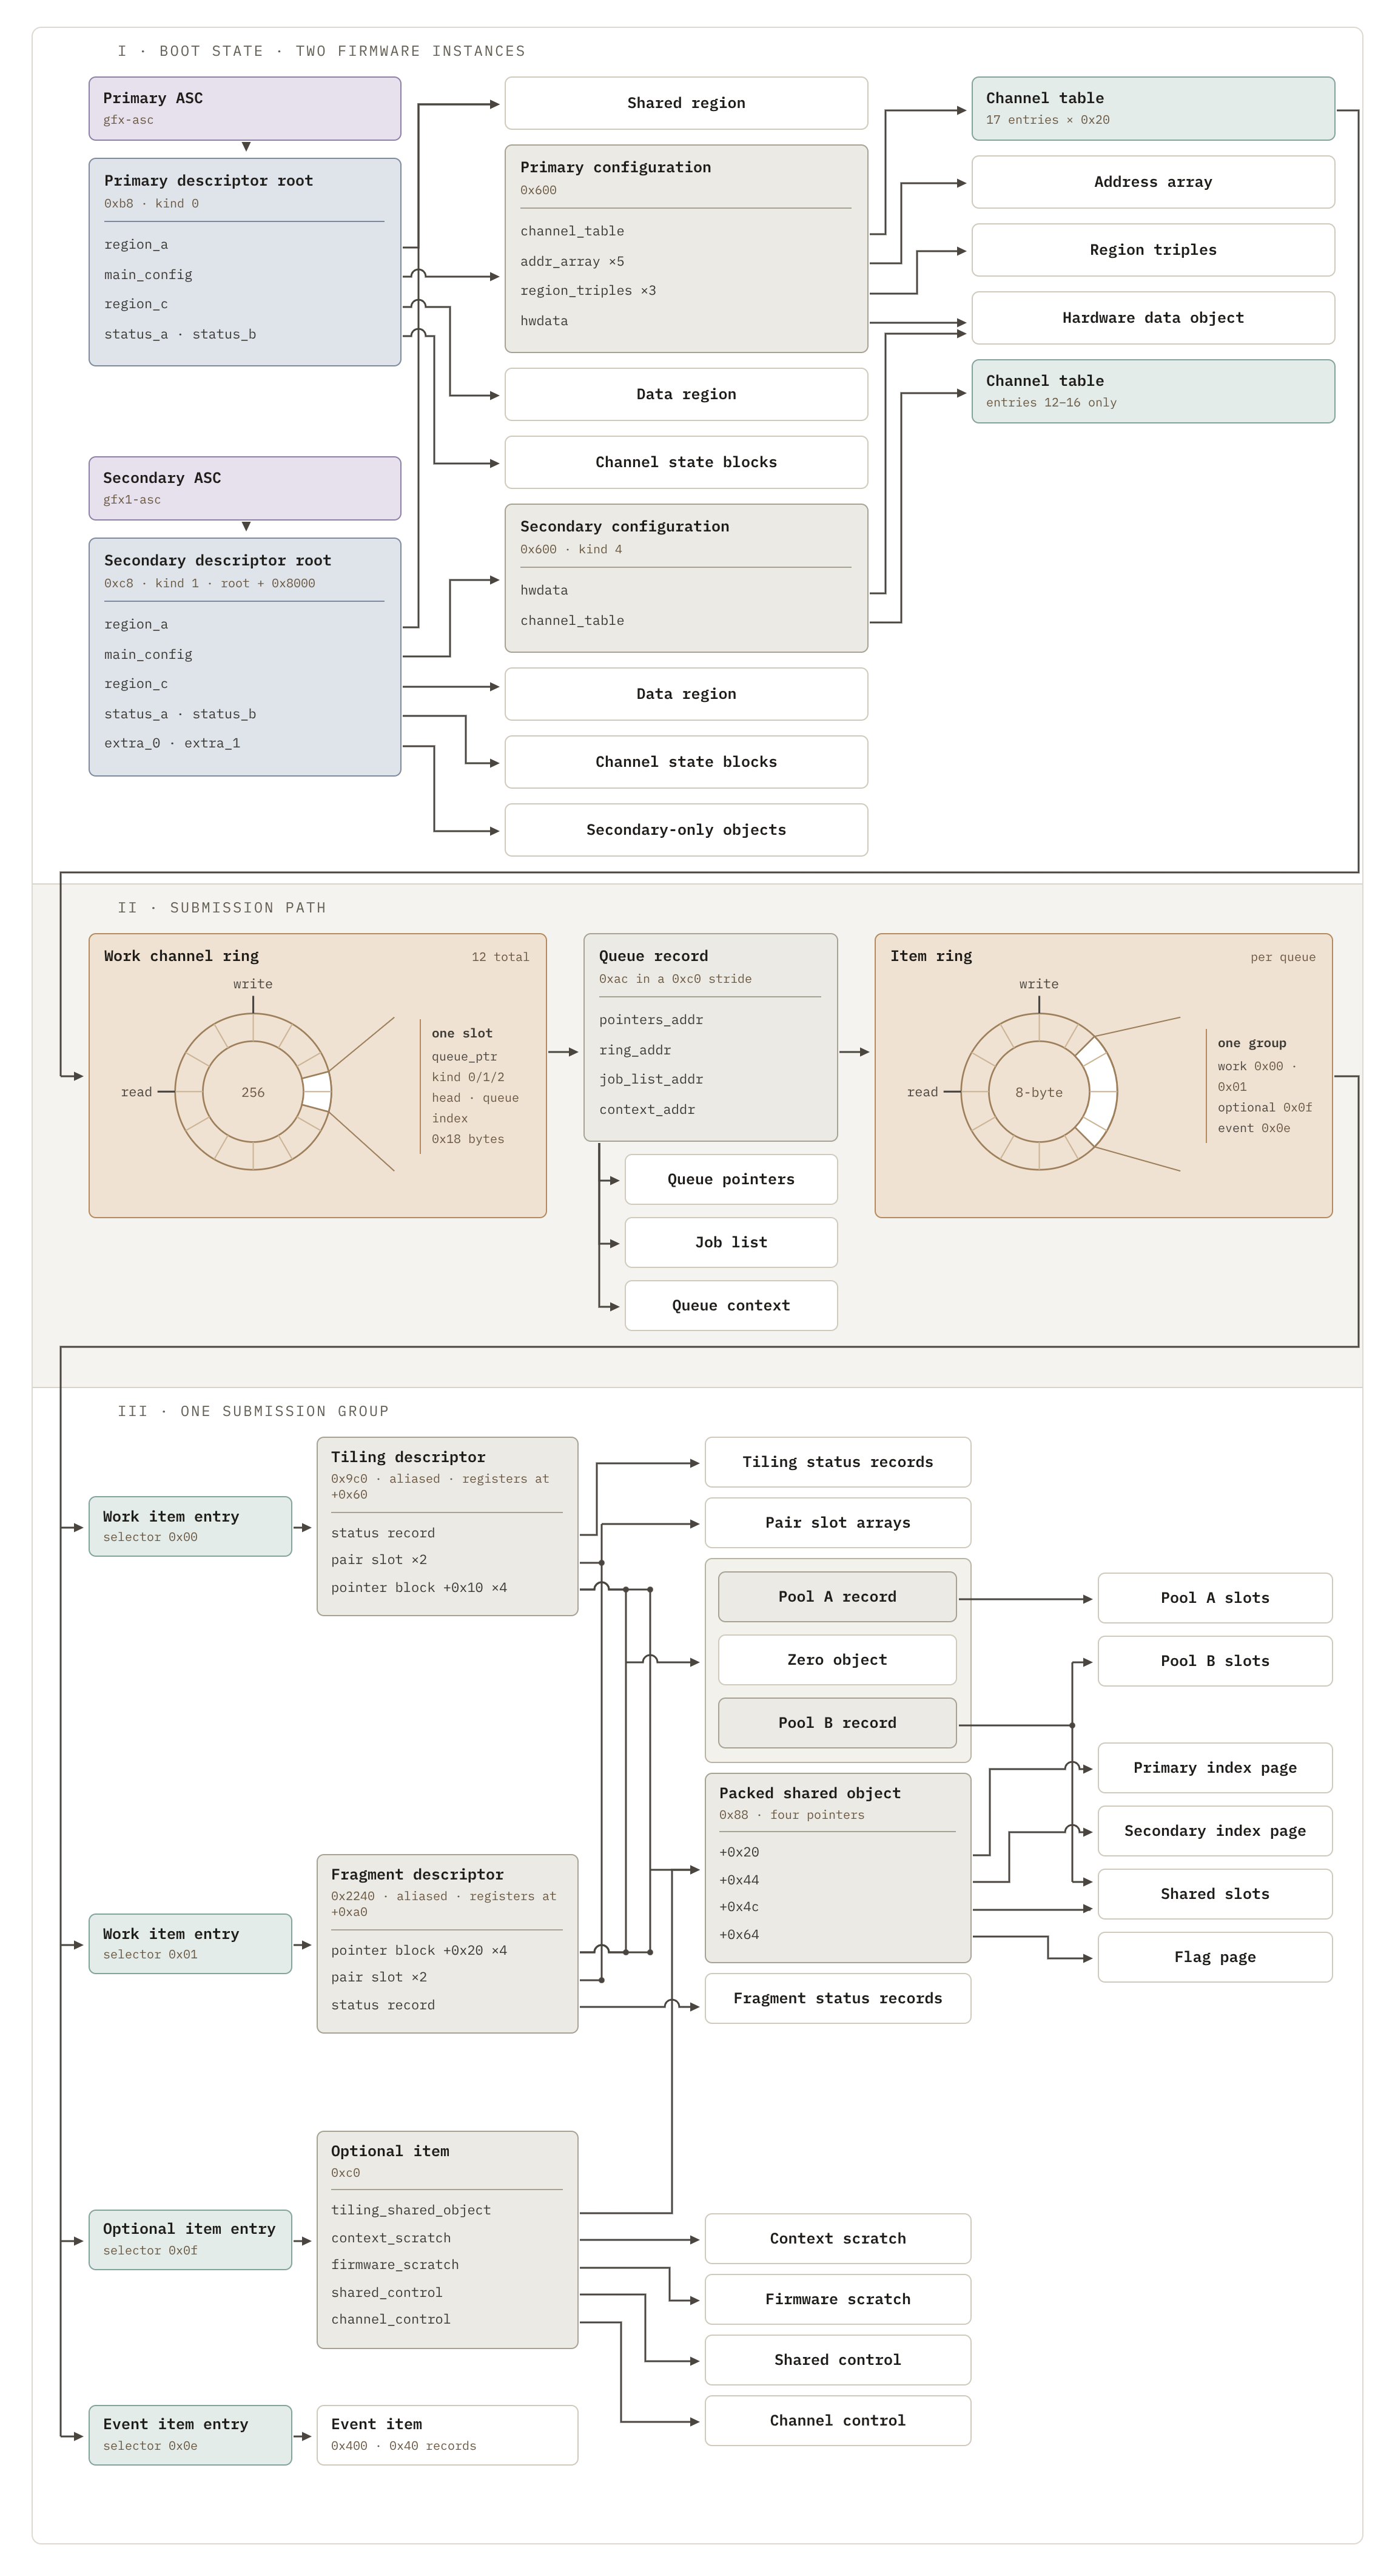
苹果,你们疯了吧。 看看 A18 的结构体数量是原来的 1.5 倍,指针数量翻倍,提交工作的流程也复杂多了。
- 结构体数量 1.5 倍
- 指针数量翻倍
- 工作提交流程大幅复杂化
RE(逆向工程)过程中还有无数摩擦点 2。我手头虽然有固件 ABI 的相关文档,但内容极不完整,说实话也没太大参考价值 3。
我的方法很简单,沿用了成功逆向 M1/M2 机型的思路:先观察 macOS 做了什么,复现它,然后利用 hypervisor 尝试自己完成同样的操作。
当向 LLM 描述这个思路时,它对“replay”(重放)执行得过于字面化:第一步,它等待首个固件可见事件(即 “kicks”),然后 保存了整个 GPU 内存状态的一份副本。重启后,它直接将保存的内存状态复制回 host 内存,执行 kick 操作,观察输出页面的变化。接着,它会在代码中重建这些对象,跟踪所有指针并解析内容。随着实验不断进行,Codex 逐步减少复制的页面数量,直到完全去掉重放状态,所有对象都改为从源码构建。4 令人惊讶的是,我发现 Codex 对“何时需要进一步探查硬件”与“何时直接运行 hypervisor 自行捕获状态”的判断颇具品味。
有三个主要问题,根源都在于我们无法干净地捕获 host 端的工作数据:
第一个问题是 在 GPU 固件启动后才提交的渲染工作。我们可以在固件启动前预置工作,启动 GPU 后这些工作能按预期完成;但一旦固件启动,后续提交的工作会被 ACK 并直接 retire,却不会真正执行任何操作。固件启动后,捕获状态变得困难得多,因为一切都变成动态的,固件成为一个无法轻易重放的状态对象。
我不得不在这个阶段介入,检查 Codex 的执行过程。事实证明,它正在尝试回放 AGX 生命周期很后期的一个捕获记录,那时已经发生了许多前序事件。当我告诉它选择 AGX 生命周期中更早得多的一个捕获——即固件启动后的第一个捕获时,Codex 几乎立刻发现了问题(它漏掉了一个字节的描述符)。这花了好几天。
第二个、也是唯一主要的阻塞性问题在于计算(compute)。大体上说,AGX 支持两种类型的工作负载:计算和渲染。在常规 GUI 路径中,计算任务只有在执行了大量渲染任务之后才会被调度。因此,获取一个干净的纯计算工作负载的捕获记录花了很长时间;当 Codex 最终做到了时,那个捕获文件高达 336 MB,根本无法回放(它尝试了很长时间)。它还试图通过查看捕获记录来手动构建对象,在这一上花了一个多星期,但最终未能成功。其中有太多无用信息需要筛选。我自己这边的失误也加剧了这一问题——在让渲染跑通之后,我以为提交计算任务会更简单(固件的计算 ABI 确实更简单,所以我这点对了),但我失去了谦逊,以为这只是小菜一碟,只需几个小时就能搞定。结果我没有为 LLM 正确搭建好任务脚手架。
实际上,解决方案是在另一个 Codex 会话中给我的。核心要点如下:
- 通过以单用户模式启动来禁用 GUI;这意味着不会执行任何渲染工作。
- 安装一个 LaunchDaemon,在 Metal(Apple 的专有图形框架)可用的最早时刻运行。
- 运行一个我们提供的小型 Metal 程序。
- 捕获并回放这个小型的、纯计算的跟踪记录。
跟踪记录成功捕获。几小时内,Codex 就完成了拆解;几天之内,Codex 让计算功能正常工作了。至于为什么原来的计算代码库不起作用……Codex 也说不清。能用的那个版本和坏掉的那个版本看起来非常相似。
事后来看,这应该从一开始就采用的策略——尽可能小的捕获,并在单用户模式下运行,以免干扰结果。我从中吸取教训,应对最后一个问题:
部分渲染是整个过程中最难搞清楚的问题之一。当 Tiled Vertex Buffer(TVB)空间不足以存下当前几何体时(也就是三角形实在太多画不完),就会触发它。这时驱动有两种应对方式,且都必须支持:要么扩大 TVB,要么执行部分渲染——先渲染一部分几何体,然后重新加载缓冲区装入剩余的三角形,再完成这次部分渲染。事实证明,部分渲染极其麻烦,比其他所有工作都难缠,因为它本质上等于要给 GPU 驱动加上“保存进度、恢复执行”的能力。
之前摸索出的工作流在这里派上了大用场。Codex 先重放了一次部分渲染的事务,然后改造我们的 Metal shader 让它主动触发多次部分渲染(方法很简单:往同一个 tile 里塞几千个三角形,直到触发为止),接着学会了如何重放这些事务。一旦 Codex 成功完成一次重放,学会自己实现就只是时间问题了。
构建内核驱动
从 Python 原型驱动升级为功能完整的 Linux 驱动花了三天,其中一天几乎全浪费了——Codex 不知出于什么我至今没弄明白的原因,居然先去啃最难的部分渲染,而不是先做最简单的 compute。我让它先把 compute 做完之后,一切就顺利了。
整体流程大致如下:
- 按照完全相同的模式用 Rust 重写现有的
drm-shim,得到一个同步的 Rust 驱动。 - 把前端改写成异步的;实际的 GPU 提交仍然保持同步。
- 把 GPU 提交重构为异步,不再轮询,而是监听固件事件,并通过 fence 把工作关联起来。
- 实现一些容易入手的优化,比如批量提交工作。
这些都是相当常规的工程工作,LLM 完全能够胜任。
唯一值得一提的是,Codex 会非常主动地利用 hypervisor 来调试代码为什么跑不通,包括抓取完整的地址空间并与已知正确的样本做对比。正是这种系统化的调试方式,让 Codex 成为目前我最喜欢的 coding agent。
User Space
A18 Pro 的用户空间与 M1/M2 大不相同:新的描述符格式、新的 ISA,以及一系列其他新特性。除了它是一个基于 tile 的延迟渲染器,专为运行 Metal 而设计外,它本质上就是一颗完全不同的 GPU。
好消息是,用户空间的逆向工程(RE)流程非常清晰。只需编写一个小型 Metal 程序,编译运行,观察变化,然后拆解分析,不断调整比特位直到弄清每个位的作用。如果你认为这听起来像是枯燥、重复且机械的工作,恰好是 LLM 擅长的领域——确实如此。
逆向工作分为两个阶段。第一阶段,我让 Claude 审视它能找到的所有 Metal 程序,尝试构建反汇编器、汇编器,并理解 GPU 驱动所需的其他描述符、命令流等格式。我让 Claude 枚举所有内容,包括 Linux 无法使用的特性(如曲面细分),以确保完整性。这一阶段取得了成功,但仅仅因为 Claude 能反汇编再重新汇编程序,并不意味着它懂得如何自行构建程序。在试图弥合这一差距时——即充分理解每条指令,以便真正能够编译任意自有程序——Claude 的表现糟糕透顶,几乎没有任何进展。
此时,Niklas 完成了 M4 Mac Mini 的 drm-shim,并加入了我,共同开展用户空间逆向的第二阶段。关于如何实际完成用户空间驱动,我们采取了两种不同的方法:
我的方法是优先进行硬件逆向,专注于弄懂硬件及所有指令的工作机制。随后编写规范(spec),让 LLM 进行实现,最终目标是达到完整的 OpenGL 和 Vulkan 合规性。这意味着我的 LLM 大部分时间用于编写硬件实验代码,而非实际实现 Mesa 代码。其核心理念是:一旦理解硬件,其余部分便迎刃而解。
Niklas 采取了另一种方法,我将其描述为“Mesa 优先”。本质上,他先构建 Mesa 框架,仅在需要构建特定功能时才进行逆向。他的时间分配在构建与测试 Mesa,以及执行逆向工程之间。
事实证明,Niklas 的进度比我要快得多,因为我的 Agent 经常为了追求完整性,把大量时间浪费在细枝末节的无关紧要的任务上。相比之下,他的 Agent 受到实际构建 Mesa 这一目标的约束,因此利用时间和资源的方式高效得多。他的速度远远超过我,以至于我最终只能试着去支持他的工作,专门研究那些他尚未弄明白的行为。
这是我注意到 Codex 的一个主要局限。我想到最贴切的词来形容它,就是“迂腐”——它始终极其详尽,这在某些场景下是巨大的优势,但在其他时候,它会陷入某些随机偏离主题的琐碎细节中,反而损害了整体目标。
在逆向工程过程中,我们发现了一些硬件支持但 Metal 不支持的行为。这是通过直接篡改不同指令的位,并基于已知存在的部分去推测可能存在的部分,从而发现的,就像 Alyssa Rosenzweig 在逆向 M1/M2 时所做的那样。这些行为包括:
- 原生的单指令 64 位加法
- 128 倍各向异性(Metal 上限为 16 倍)
- 矩阵单元的一种新模式
uniform_mov的 7 位立即数支持
Mesa 开发
在构建用户态图形栈时,有几个因素对我们非常有利。最显著的是,Khronos 兼容性测试套件(CTS)已经是一套详尽的测试集,我们的驱动必须通过它。换句话说,与 LLM 合作中最难、最敏感的部分——为它们提供好的测试用例以约束其行为——已经替我们完成了。
此外,Mesa 已有出色的抽象,极大简化了我们的工作。这是 Linux 上现代 OpenGL 栈的架构图:
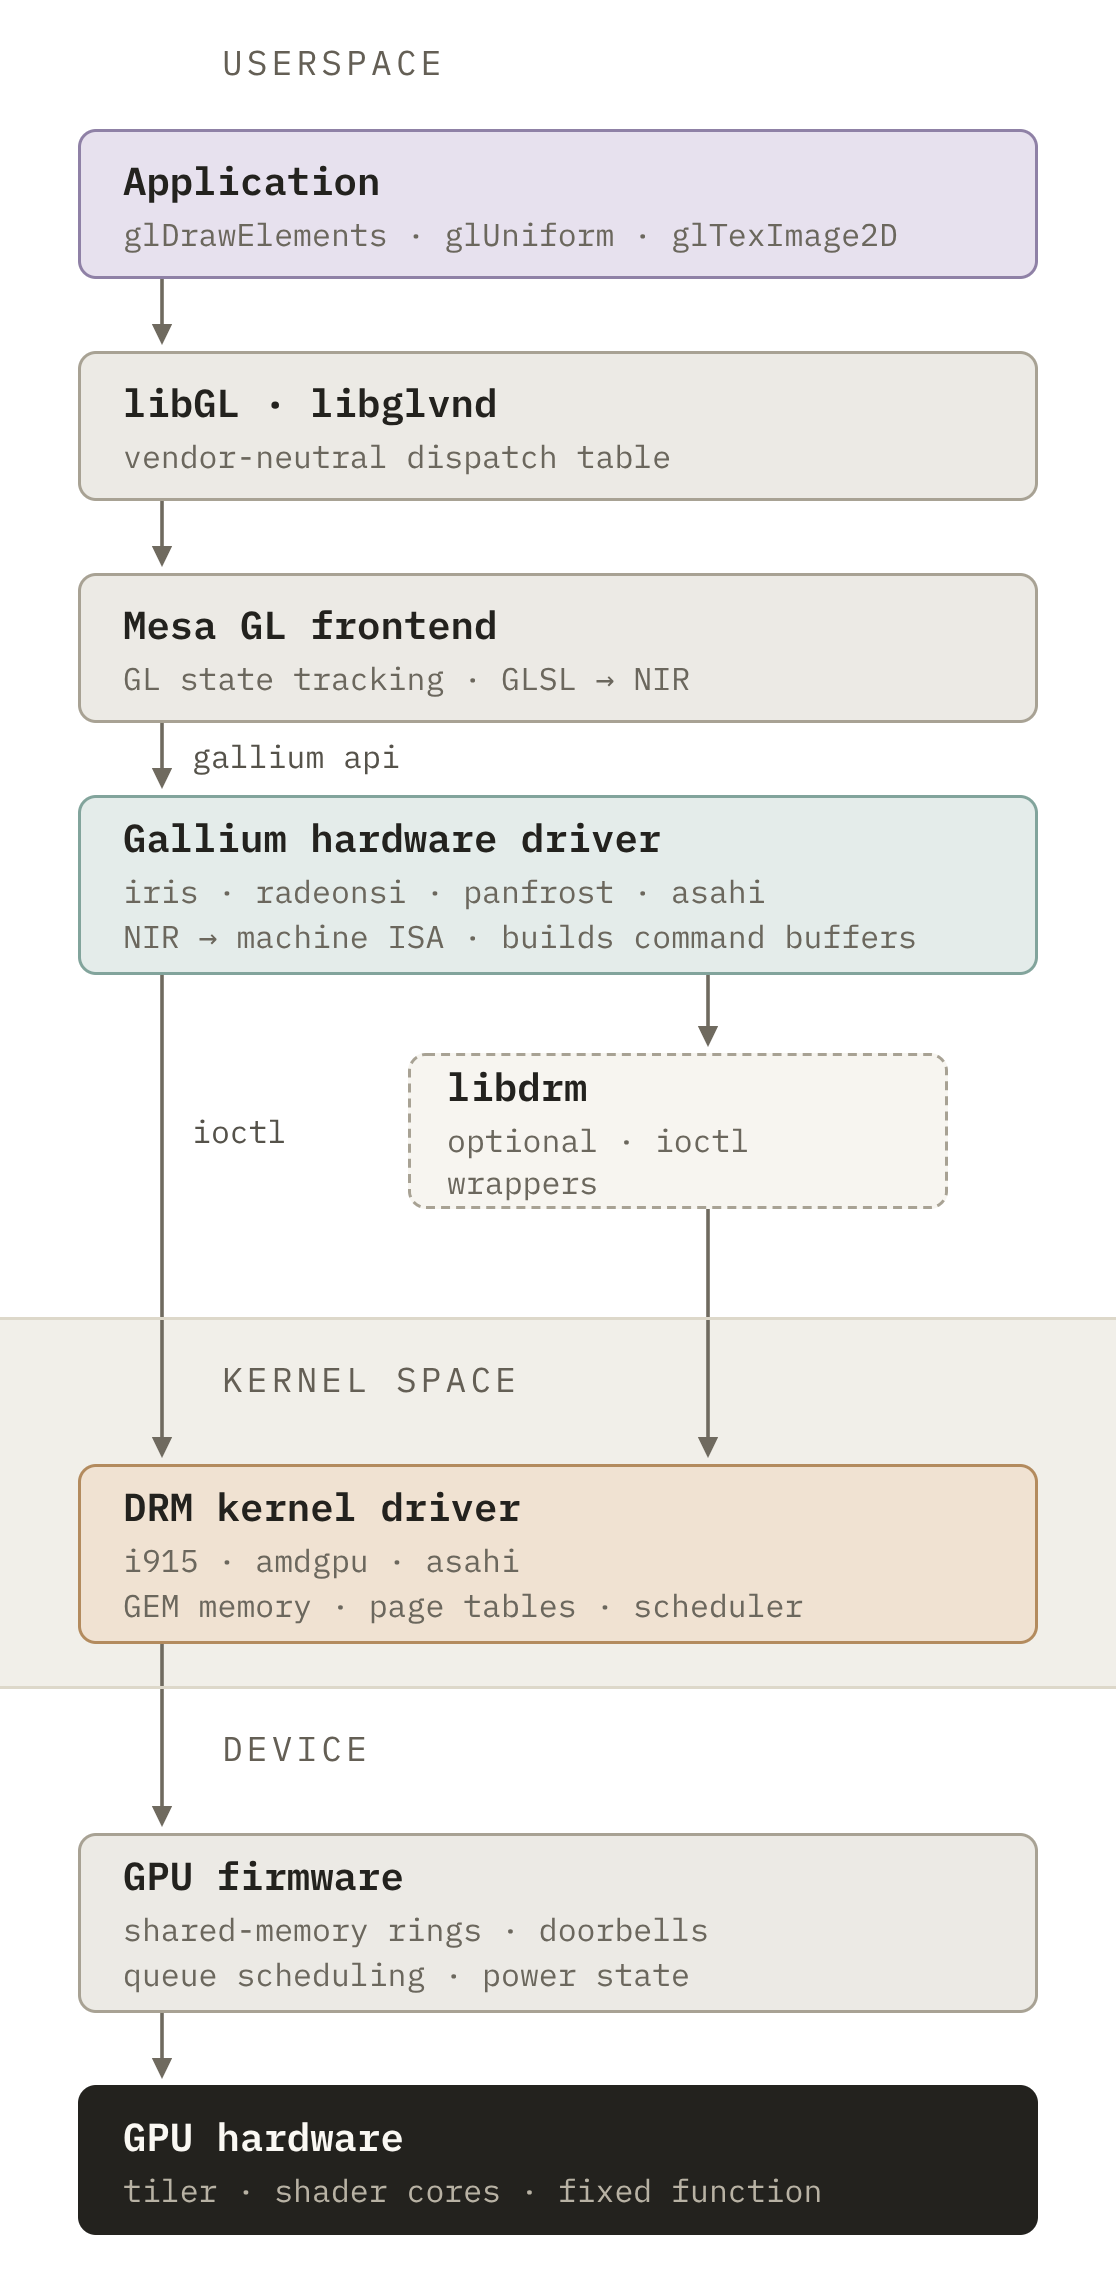
我们要做的只是在 Gallium(Mesa 的内部 API)和 AGX 硬件语义之间进行转换。这一过程中最繁重的一环,是将 NIR(Mesa 的内部 IR,与 LLVM IR 非常相似)转换为 AGX 的专有 ISA。作为额外的好处,这个编译器将来可以复用于 Vulkan 驱动。
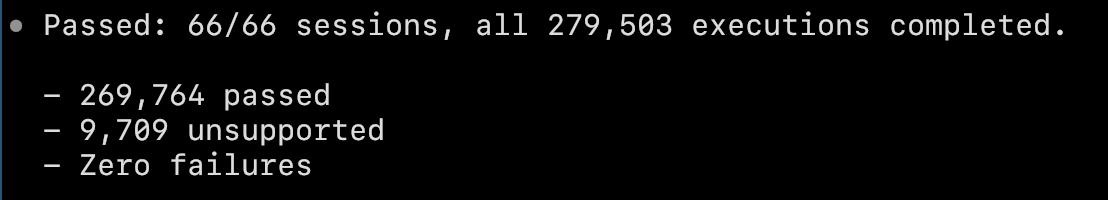
Niklas 能够缓慢地迭代 OpenGL 特性,边开发边逆向用户态代码,直到最终实现了 OpenGL ES 3.0 的完全兼容(未通过的测试属于可选扩展):
整个过程里,我们受益于已有的 M1/M2 工作:虽然具体的硬件语义有所不同,但整体架构是相似的,很多关键的权衡和决策都已经有人替我们做好了。在做这个驱动的过程中,我越来越觉得 Alyssa Rosenzweig 和其他构建 M1/M2 驱动的人简直是魔法师——向他们致敬!
成果
Mesa:https://github.com/niklassheth/mesa
Linux 内核驱动:https://github.com/GravityLinux/linux/gravity-m4
用户态逆向文档(一堆 LLM 生成的糟粕,但能用):Cody Niklas
待完成的工作
Vulkan 1.4、OpenGL 4.6、OpenGL ES 3.2、OpenCL 3.1、Direct3D 12(通过 Proton)以及光线追踪都在计划之内。我们希望这个驱动能达到世界顶级图形驱动的水准。
此外,Niklas 和我想把这一切提交到上游,但目前还有不少障碍。我们使用的是未经修改的 Asahi UAPI,所以向 Mesa 上游提交不存在政策问题,但仍需要大量测试、人工审查,并重构为可评审的 PR。而且可以预见会有不少质疑——这大概是史上第一个完全由 LLM 编写的 GPU 驱动,我们的代码会被用比人写代码更高的标准来审视。我们准备好了迎接这些挑战,但它们主要是人和非技术层面的,LLM 帮不上忙。
Linux 内核驱动的问题更大,因为 M1/M2 驱动本身还没进上游,而我们实际上也没有能力推动这件事。我们认为最好的做法是等那个驱动先进入上游,然后再在 M1/M2 上游化之后提交我们的驱动(当然前提是完成所有必要的重构、审查、拆分等等)。遗憾的是,这可能需要一段时间。
什么时候能用上?
稍安勿躁,年轻人。我们期待尽快把代码交到你手上,而且等待时间可能比你想象的短得多。毕竟,苹果掉下来不会离树太远。
加入我们
如果你对参与此事感兴趣,欢迎加入我们的 Discord 服务器。不妨过来聊聊想法、闲聊或单纯挂个机!
补充:真的吗,Sam?
内核逆向工程任务中,我使用了 Codex 搭配 GPT-5.6 Sol(GPT-6 Astra 发布后便切换至后者)。遇到的最大问题在于过分的网络安全限制(我并未注册可信访问权限)。
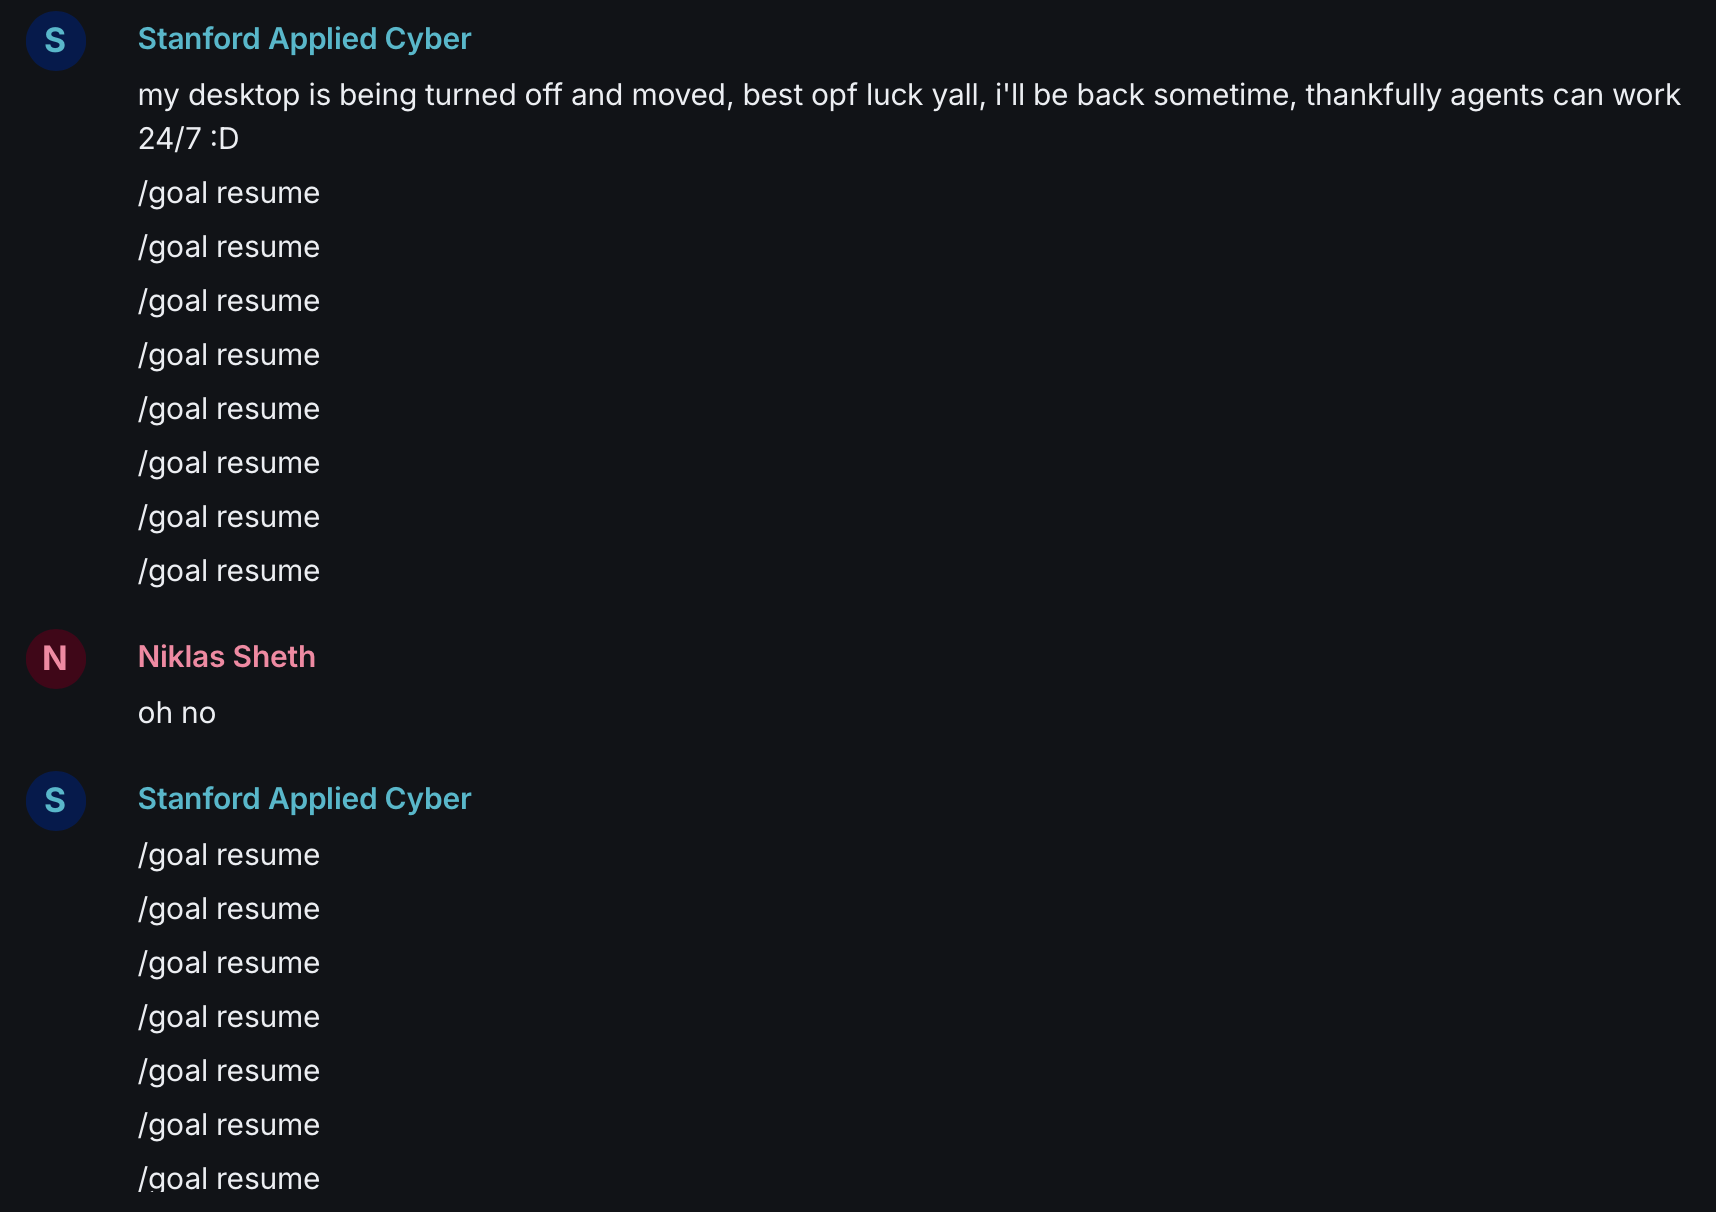
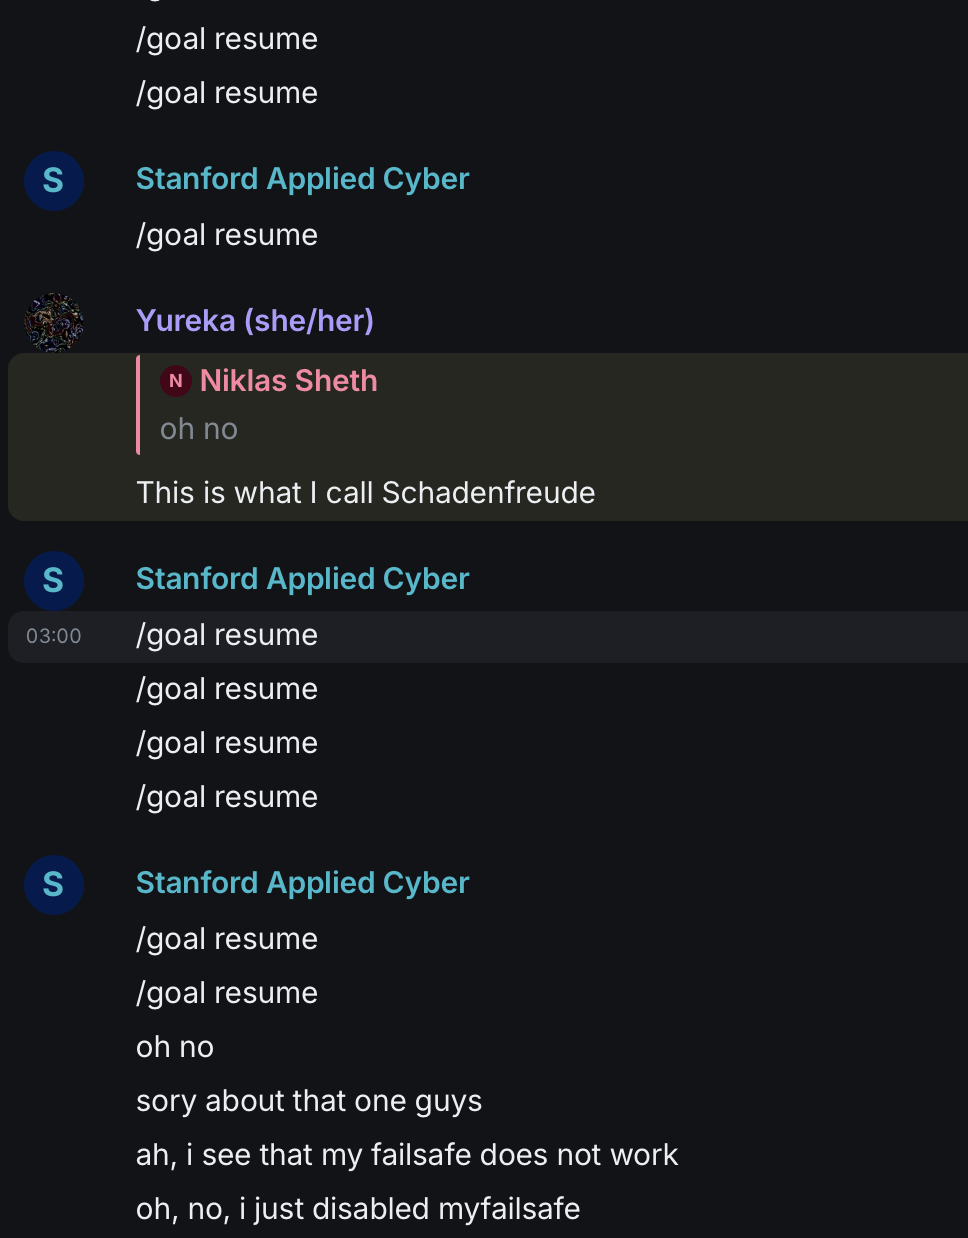
99% 的情况下,只需简单的 /goal resume 或“继续”指令就能让 LLM 继续执行(这也侧面印证了限制确实过于严苛),但这些中断仍打乱了我的自动化工作流程。我编写了一个最快、最笨但最有效的解决方案:一个守护进程,每分钟截屏一次,与上次的截图做 diff,若发现画面完全静止(即 Codex 已停止推进),便自动输入 /goal resume。我误让这个程序一直运行,结果它在几个群聊里疯狂刷屏:
话虽如此,GPT-6 Astra 和 GPT-5.6 Sol 的能力堪称疯狂,至今仍是固件 ABI 逆向工程领域性能最强的选手,因此这个小 hack 绝对物超所值。
补充:M4、A18 Pro 与 M5 对比
据我观察,M4 与 A18 Pro 的用户空间实现几乎完全一致,我找到的唯一差异是某个参数在 M4 上略大,这与它拥有更多核心相符。两者的固件 ABI 则差异显著:A18 Pro 配备第二个 RTKit 协处理器,使得整体更为复杂。就固件而言,A18 Pro 更贴近 M5 而非 M4。M5 的用户空间与 M4 有部分相似之处,其 ISA 基本上是超集,但某些部件完全不同,例如纹理描述符。M5 的用户空间已被部分逆向工程;其固件 ABI 已被完全逆向工程;一个原型 drm-shim 已构建并通过充分测试;我认为将该原型升级为完整的 Rust 驱动不会花太长时间。我的主要目标仍然是 M4 Mac Mini 和 MacBook Neo。