
开发团队端侧数据防泄漏 (DLP) 策略构建指南
开发者的笔记本电脑里藏着的敏感数据,远比大多数人想象的多:API 密钥、数据库凭证、预发环境密匙,甚至有时为了测试目的拉下来的整套生产数据副本。
内部数据泄露事件中,75% 由终端用户造成,且大多数属于无心之失而非恶意行为。对于开发团队而言,这一风险高度集中在端侧——即编写、测试和推送代码的那台机器上。
以下是如何制定一套保护端侧而不拖慢团队效率的策略。
目录
如何制定端侧数据防泄漏策略
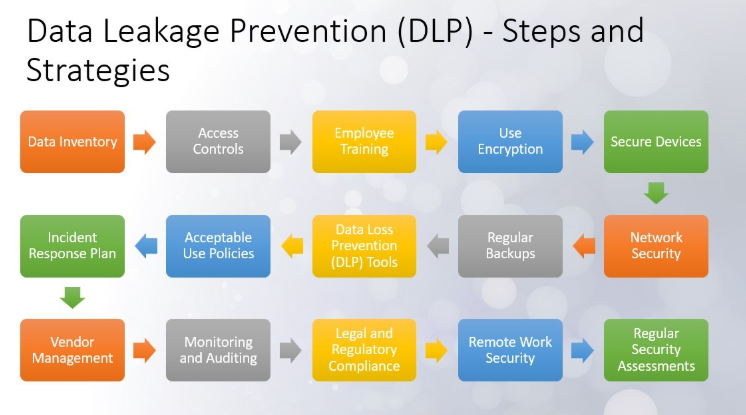
第一步:梳理端侧敏感数据的存储位置
第一步是搞清楚团队各台机器上都存放着哪些机密和敏感数据。常见的“重灾区”包括:硬编码了凭证的配置文件、没来得及加进 .gitignore 的 .env 文件,以及半年前调试时生成的、没人记得删掉的数据库缓存转储。
任何备份,哪怕是临时备份,都应被视为敏感数据来对待。如果没启用备份加密,这份副本就和原始数据一样容易泄露。
大多数团队一旦开始排查,都会对发现的问题感到意外。对几台笔记本电脑做一次简单审计,往往就能发现整个团队重复着同样的坏习惯——因为某个开发者的捷径只要奏效一次,就会迅速传开。
用一张简单的表格记录敏感数据的类型、存放位置和所在机器,就能为后续策略打下具体的基础。跳过这一步,后面所有的控制措施都只能瞎猜自己到底在保护什么。
不妨先这样做:
挑选三到五台开发机,启动初步审计。
在常见位置搜索环境文件、凭证、数据库转储和私钥。
记录发现的问题、文件位置、数据类型、负责人,并标注数据是否仍需保留。
删除不必要的副本,并更换可能已暴露的凭证。
在 Linux 机器上,第一轮基础排查可以这样:
find ~ -type f \( -name ".env" -o -name "*.pem" -o -name "*.key" \) 2>/dev/null
这种方法查不出所有机密,但能为团队提供一份可靠的初始清单。
比如,如果审计发现 ~/projects/client-api/.env 里存着数据库密码,你就应该把凭证迁移到 secret manager,删除本地文件,并更新密码。
第二步:以访问控制为基础
任何端点 DLP 策略都建立在有效的访问控制系统之上。如果每位开发者不管什么角色都能随意获取生产环境凭证,那再多的下游监控也无法弥补这个缺口。
围绕角色和属性构建的可扩展的访问控制,从根本上限制了被入侵笔记本所能暴露的信息。毕竟,泄露的凭证本身危害有限,关键在于其背后附带的权限范围。
这也是最容易实施错误的控制措施,但修复起来相对简单。
定期审查访问权限,而不仅仅在入职时检查一次,才能发现那些项目结束后没人记得撤销的权限缓慢累积现象。
简单的实施流程:
列出生产系统和敏感资源。
创建开发者、高级开发者、DevOps、管理员等角色。
记录每个角色实际需要的资源。
移除与当前工作无关的权限。
每当有人更换项目或离开团队时,重新审查其访问权限。
并排对比能更清晰地看出权限过多的问题。以下是同一开发者角色在 Postgres 中两种不同的授权方式:
权限过多:
-- 一个角色,所有数据库,所有表,所有操作

GRANT ALL PRIVILEGES ON DATABASE prod_db TO dev_team;

GRANT ALL PRIVILEGES ON ALL TABLES IN SCHEMA public TO dev_team;
权限适度:
-- 仅在实际工作发生的数据库赋予完全访问权

GRANT CONNECT ON DATABASE staging_db TO dev_team;

GRANT USAGE ON SCHEMA public TO dev_team;

GRANT SELECT, INSERT, UPDATE, DELETE ON ALL TABLES IN SCHEMA public TO dev_team;
-- 完全不保留生产环境的常驻连接

REVOKE ALL ON DATABASE prod_db FROM dev_team;
同样的逻辑可以清晰地映射到角色表中,这通常是更容易交给团队管理的版本:
角色 | Dev / Staging 数据库 | 生产数据库 | 密钥管理器 | 云控制台 |
|---|---|---|---|---|
开发者 | 读写 | 无 | 读取,仅限自己项目 | 无 |
高级开发者 | 读写 | 只读,限时 | 读取,所属团队项目 |
只读 |
DevOps | 读写 | 写(限定于部署) | 读写 | 管理员(限定范围) |
管理员 | 读写 | 完全 | 完全 | 完全 |
第三步:加固终端操作系统层
大多数开发机器都运行某种 Linux 发行版,无论是直接安装还是通过 WSL,操作系统层正是日常执行数据防泄露(DLP)控制措施的地方:文件权限、磁盘加密以及保持用户权限的适当隔离。 熟悉核心 Linux 命令将大大方便你审计机器上正在运行的内容、正确锁定文件权限,并在问题变成实际故障前及时发现异常。 磁盘加密也值得一提。如果笔记本丢失且硬盘未加密,一旦有人将硬盘拔出并在其他地方挂载,所有数据便会直接暴露,无需任何密码。 启用全盘加密后,即使笔记本被盗,也会大大减轻后续的困扰。 对于 Linux 开发者,以下是在终端审查期间可以执行的几个命令:whoami
sudo -l
ls -la ~/.ssh
df -h
ls -la ~/.ssh
find ~/projects -name ".env" -exec ls -l {} \;
-rw-r--r-- 1 dev staff 1704 Mar 12 09:14 /home/dev/.ssh/id_ed25519
-rw-rw-r-- 1 dev staff 612 Mar 12 09:14 /home/dev/projects/client-api/.env
末尾的 r-- 权限位意味着同组用户以及机器上的所有其他用户都能读取私钥和一组凭据。收紧权限,只让文件所有者访问:
chmod 700 ~/.ssh # 目录:仅所有者
chmod 600 ~/.ssh/id_ed25519 # 私钥:所有者可读写
chmod 644 ~/.ssh/id_ed25519.pub
chmod 600 ~/projects/client-api/.env
如果要一次性扫描整个项目目录:
find ~/projects -name ".env" -exec chmod 600 {} \;
接下来是具体的加固步骤:
启用全盘加密。
及时更新操作系统和安全补丁。
移除不必要的管理员权限。
审查 SSH 密钥,清理不再使用的密钥。
启用屏幕锁定。
在合适的地方配置终端监控。
举个例子,如果开发者的笔记本上还留有属于旧项目的 SSH 密钥,应该删掉它并撤销对应的访问权限,而不是让它一直留存下去。
有些团队选择从源头上规避这类风险,把开发工作迁移到虚拟桌面基础设施(VDI)上,让敏感数据集中存放而非留在物理机器上。但这只是转移了 DLP 负担,并没有消除它——虚拟环境本身同样需要访问控制和监控来防止 VM 数据丢失。
第 4 步:锁定容器和本地环境
本地开发越来越多地在容器中进行,而每个容器都是一个独立的小环境,如果开发者不注意往里面存了什么,它最终可能囤积大量机密信息。
比如 .env 文件可能被打包进镜像,或者凭据一直留在容器的环境变量里,项目早已结束却无人清理。
FROM node:20
WORKDIR /app
# 问题 1:整个目录全拷进去,包括 .env、*.pem 和 .git 历史
COPY . .
# 问题 2:这个值会被写进镜像层,永久留在里面
ENV DB_PASSWORD="prod-9f2a-4c11-secret"
RUN npm install
CMD ["node", "server.js"]
docker history --no-trunc my-app:latest | grep -i password

docker run --rm -it --entrypoint sh my-app:latest -c "cat .env"
# .dockerignore

.env

.env.*

*.pem

*.key

.git

node_modules
FROM node:20

WORKDIR /app
COPY package*.json ./
RUN npm ci --omit=dev
# 只拷应用代码,不是整个目录
COPY src ./src
CMD ["node", "src/server.js"]
docker run -e DB_PASSWORD="$DB_PASSWORD" my-app:latest
实用检查项: 推送镜像前,扫一遍镜像里有没有 .env 文件、私钥、凭据或其他敏感数据。
第五步:让泄露在上线前就被抓住
越早发现泄露,损失可能越小。
在 CI/CD 流水线里接入自动密钥扫描,硬编码的 API key 在进公开仓库之前就会被标记。
Gitleaks 和 TruffleHog 都能很好胜任,它们直接跑在流水线里,一旦提交中出现疑似凭据就立刻让构建失败。
调整告警规则需要一些耐心,但跳过这一步往往会适得其反。如果扫描器不断误报,团队很快就会对每条警告视而不见,甚至懒得细看。因此,值得花时间把规则配置得贴合你的代码库。
例如,GitHub Actions 工作流可以在代码上线前运行 Gitleaks:
name: Secret Scan

on:

  pull_request:

  push:

jobs:

  gitleaks:

    runs-on: ubuntu-latest

    steps:

      - uses: actions/checkout@v4

        with:
          fetch-depth: 0

      - uses: gitleaks/gitleaks-action@v2
通过这种配置,每当开发者推送代码或发起 pull request 时,仓库都会接受扫描。如果 Gitleaks 检测到疑似凭证,工作流会在变更进入后续部署流程之前将其拦截。
被捕获的秘密信息会在工作流日志中以类似这样的形式呈现:
Finding:     AWS_SECRET_ACCESS_KEY=wJalrXUtnFEMI...
Secret:      wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY
RuleID:      aws-access-token
Entropy:     4.31
File:        services/billing/.env.staging
Line:        12
Commit:      8f2a1c9dbe4477a1c0f9e2b3a5d7c8e1f0a2b3c4
Author:      dev@example.com
INF 14 commits scanned.
WRN leaks found: 1
Error: Process completed with exit code 1.
非零退出码是实际阻止合并的关键。文件名、行号和 commit hash 能让处理者精准定位问题位置。
调整告警规则确实需要耐心,但省略这一步往往弄巧成拙。总之,避免频繁的误报导致团队对警告麻木视之。务必花时间让规则适配你的代码库。
这种调整通过仓库根目录下的 .gitleaks.toml 完成,在其中可以豁免那些合法包含假凭证的路径:
[extend]
useDefault = true

[[rules]]
id = "aws-access-token"
  [rules.allowlist]
  paths = [
    '''tests/fixtures/.*''',
    '''docs/examples/.*'''
  ]
  regexes = [
    '''AKIAIOSFODNN7EXAMPLE'''
  ]
保持豁免列表(allowlist)范围狭窄。若因某个文件反复触发扫描器就豁免整个目录,真实的凭证就会趁机漏网。
比如,开发者不小心把 API key 提交到了 pull request。Gitleaks 在工作流中标记出来,pull request 无法继续,团队在合并代码前删除了密钥并轮换了凭证。
第 6 步:将覆盖范围扩展到面向公众的资产
大多数端点 DLP 策略只关注笔记本和开发机,但公开网站同样需要严格审查,哪怕它们不由工程团队维护。
你可能有一个配置不当的联系表单、一个被人遗忘却仍在线上的 staging 子域名,还有一个没人 properly 加固过的管理后台。API 安全测试平台可以在暴露的 API 危及敏感数据之前,检测其中的漏洞和业务逻辑缺陷。上述任何一项导致数据泄露的可能性,都不亚于一次粗心的提交。
问题的一部分在于,网页设计和安全往往被视为由不同人员负责的两项独立工作。那些从建站之初就将托管、维护和安全整合进流程的网站,远比出事之后才临时补救的网站更加稳固。
对于面向公众的网站,这种持续监督的重要性不亚于开发者机器上的端点监控。无人看管的资产正是问题悄悄累积的地方,直到某件事迫使你认真检查。
如果你的开发团队同时也负责营销网站,就应把它纳入同一个 DLP 范围,像对待其他资产一样例行维护,而不是等有空了才想起来处理。
一个简单的月度检查就能在这些隐患变成被遗忘的基础设施之前发现它们。首先列出所有在用的域名和子域名,然后逐一确认它们是否仍需要对外开放。
实际情况通常是这样的:团队重写了客户门户,并搭了一个 staging-v2.example.com 用来给相关方演示。上线很顺利,但没人删除这个 staging 环境,它一直运行着为演示而加载的一份生产数据库副本。
八个月后,一次例行的子域名排查发现了它:
# Every subdomain still resolving
dig +short staging-v2.example.com
203.0.113.47
# 该端点是否公开可访问?是否需要认证?
curl -s -o /dev/null -w "%{http_code}\n" https://staging-v2.example.com/api/v1/customers
200
未附带任何凭证就返回 200 状态码,这就是问题所在。拉取第一条记录即可证实:
curl -s https://staging-v2.example.com/api/v1/customers | head -c 200
[{"id":4471,"email":"real.customer@example.com","phone":"+1-555-0142",
"plan":"enterprise","last_invoice":"2025-11-03"}]
这是生产环境的客户数据,竟然放在一个无需认证即可访问的端点上,任何扫描证书透明度日志寻找子域名的外部人员都能将其索引并获取。修复步骤有严格的先后顺序:
立即将该环境下线,优先于其他所有操作。
检查访问日志,确认是否已有人先一步发现并访问过。
确定该环境是否仍需保留。若不再需要,直接删除并移除对应的 DNS 记录。
若仍需用,则将其置于认证机制或 IP 白名单之后,并用生成的测试数据替换原有数据库。
将该子域名纳入每月的资产清单,避免下一个类似端点再在无人察觉的状态下存在八个月。
对公网表单、管理后台、云存储以及闲置的 API 端点,都应执行同样的审查流程。目标是让团队清晰掌握并主动维护每一个面向互联网的服务面。
第 7 步:监控、量化,确保策略真实有效
缺乏度量的数据防泄漏(DLP)策略算不上合格策略。团队需要在实际操作中看清数据暴露的具体位置,正如营销团队开始在各类 AI 平台上追踪品牌曝光度一样。
在保险行业,Similarweb 专为这一目的构建的 AEO 平台 能够追踪品牌在 AI 生成答案中被提及的渠道与方式,捕捉到那些人工逐条测试提示词时根本发现不了的规律。
面向终端的安全监控也是同样的道理。如果没有仪表盘来显示密钥暴露的位置或哪些机器已偏离合规要求,团队就会把精力耗在事后清理事故上,而非提前预警。
备份也遵循同样原则:未经测试的备份只是假设。定期测试灾难恢复计划,才能确保数据备份策略在问题真正发生时切实有效。
这一原则也并非止步于笔记本电脑。大多数公司将敏感数据分散存储在 Microsoft 365 的各个角落(包括邮件箱、SharePoint 站点、OneDrive 文件夹或 Teams 频道),而确保这些数据真正受到保护而不仅仅是留存,通常正是开发团队或 IT 团队的责任所在。
Microsoft 原生的保留策略仅能在较短的时间窗口内覆盖意外删除的情况。它并非设计用来应对勒索软件攻击,或是应对潜伏数周才被发现被入侵账户的恢复场景。如果团队仅依赖这种保留机制,而没有为 Microsoft 365 数据配置独立的备份,那么他们所做的假设,正是本文在讨论本地备份时早已警告过的那种未经验证的假设。
在此处,策略的重要性与工具本身不分伯仲。
只有当受约束的人真心认同策略时,策略才会发挥作用,而这一维度的衡量比工具合规性更为艰难。这正是匿名员工信心工具的价值所在,它能揭示团队是真正信任安全规则,还是在默默寻找绕行之道。
安全策略面临着类似的挑战。缺乏背景说明、笼统的“一刀切”规则很难让开发者在实践中遵循。给团队一套没人看得懂的策略,最终他们总会设法变通执行,无论当初制定者出于多么良好的初衷。
与那些埋藏在入职文档第三层文件夹里的通用 PDF 相比,具体且附带清晰解释的规则往往更能经受住时间的考验。
安全仪表盘简化了审查流程。你可以追踪检测到的密钥数量、未受必需控制约束的端点、权限变更情况,以及每个问题的解决时长。
对于一个由二十名开发者组成的团队而言,该仪表盘无需比以下内容更复杂:
指标 | 上个月 | 本月 | 目标 | 趋势 |
|---|---|---|---|---|
CI 中捕获的密钥 | 6 | 2 | 0 | 改善中 |
合并代码中发现的密钥 | 1 | 0 | 0 | 改善中 |
启用全盘加密的端点 | 17 / 20 | 20 / 20 | 100% | 已达成 |
缺失安全更新的机器(30天以上) |
4 | 5 | 0 | 恶化 |
长期拥有生产数据库访问权限 | 9 人 | 3 人 | 0 | 已达标 |
未审查的子域名 | 11 | 0 | 0 | 已达标 |
泄露凭据轮换的中位时间 | 3 天 | 6 小时 | 24 小时以内 | 改善中 |
这样的表格能立刻看出两个问题,而从事件报告里是看不出来的。
密钥在 CI 阶段就被拦截,而不是合并之后才发现,说明第 5 步在发挥作用。
补丁情况在倒退,说明更新流程出了问题,再发几封提醒邮件也无济于事。
举个例子:如果发现密钥扫描器在某个 pull request 中检测到 AWS 凭据,就应停止合并、撤销或轮换该凭据、从仓库中移除它,并检查它是否还出现在其他地方。然后调查开发者为什么能接触到这份凭据,并改进工作流程以防再次发生。
务必定期跟踪这些指标,而不是等到出事才看。如果同样的违规反复出现,与其继续发警告,不如考虑制定更清晰的政策、升级工具或优化开发流程。
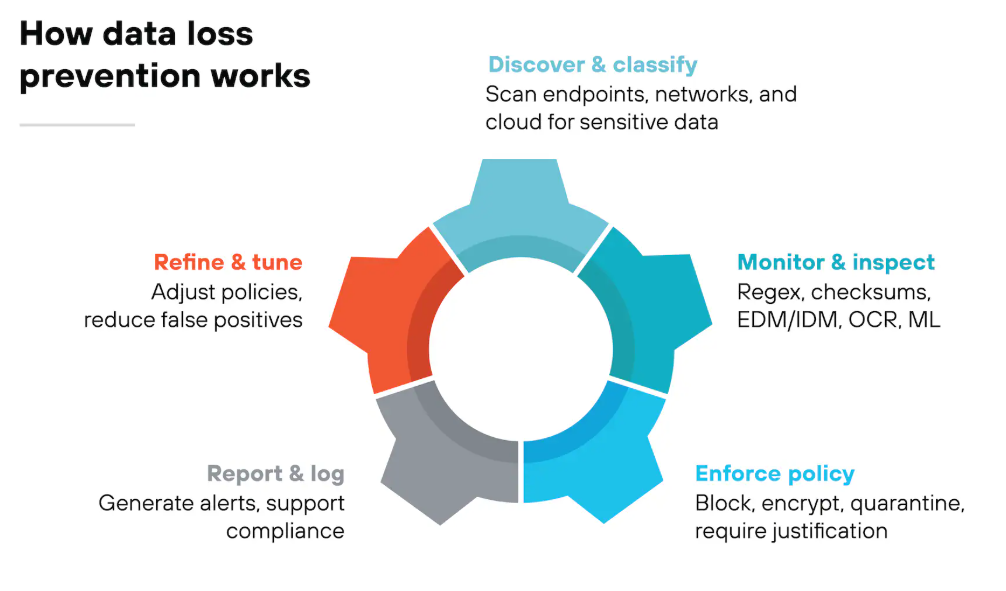
把安全融入团队现有的工作方式
一套好的 DLP 策略,并不是用没完没了的审批流程拖慢工程师,也不是把每台笔记本都锁死在刻板的企业镜像里,更不应以牺牲用户体验为代价——毕竟快速发布的意义就在于更好地服务用户,同时不让他们的数据暴露在风险中。
最强的端点 DLP 策略只需在后台默默运行,日常几乎感觉不到它的存在:访问控制把影响范围压到最小,CI/CD 检查在问题上线前就把它拦住,监控则让团队看到真正的短板,而不是让所有人瞎猜。
先从访问控制和 CI/CD 入手,这两项能以最低的 摩擦 成本拦住常见错误,等基础打牢后再向外扩展。 为每个环节选配合适的工具,包括顶尖的 备份软件,能显著降低搭建和长期运维的难度。 若想夯实这些基础,无论是 Linux 基础、容器化还是 CI/CD 流水线,freeCodeCamp 都有免费且实用的指南,恰好覆盖这类工作内容。