
绕过推理瓶颈:使用 Retrieve-for-Train 加速复杂 AI 搜索
如今的搜索和推荐应用,越来越需要返回一组连贯的结果,而不只是单一的最佳匹配。比如用户搜索“露营装备”时,他不想要十个大同小异的四人帐篷,而是想要一套连贯互补的露营必需品清单:帐篷、睡袋、便携炉具、头灯等等。
为此,系统会采用 query fan-out(查询扇出)技术,把一个宽泛的查询拆解成多个相关的子查询,以覆盖用户可能感兴趣的方向。然而,要让 LLM 学会动态地执行数据库感知的查询分解,会消耗大量思考预算。从设计上看,zero-shot 的 LLM 本质上是通用的自回归文本预测器,并没有针对特定语料库的几何流形做过优化。因此,它们需要大量的推理时计算,才能返回一组既满足集合级高阶属性(如多样性、覆盖率、互补性、连贯性),又与固定数据库保持一致的结果。
在 ICML 2026 论文“Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion”中,我们通过一个 reward-to-data 编译框架来解决这个分解瓶颈。Retrieve-for-Train 框架不在推理阶段强迫模型消耗大量思考预算,而是利用离线强化学习(RL)来发现符合奖励目标的扇出方案,并将其编译成监督信号。通过把这些优化后的探索行为蒸馏到一个轻量的 diffusion 检索器中,我们实现了推理时的高效单次查询扇出,在数学上精确达成集合级属性,同时省去了推理时思考 token 的开销。
为什么通用 AI 不是搜索专家
面对为复杂检索术语进行头脑风暴的任务时,人们很容易在推理阶段直接调用现成的标准 LLM 来处理。然而,依赖通用模型进行数据库感知的查询分解存在两大关键挑战:
- 释义坍缩:若缺乏数据库感知优化,零样本 LLM 经常陷入释义坍缩。它们倾向于生成冗余的近义词查询,而非探索主题的互补维度。例如,面对宽泛提示词“波西米亚节日风格”,未经精心提示工程的标准 LLM 可能随意生成“波西米亚节日时尚”和“波西米亚节日服饰”等查询。这种语义循环会产生同质化的结果列表,完全错失时尚专家能识别到的独特且有价值的语义方向,如流苏夹克、钩织连衣裙或麂皮靴。
- 自回归延迟瓶颈:标准 LLM 本质上受限于顺序自回归生成。为了将复杂查询成功分解为互补维度,现代模型通常需要大量的思考预算,在输出实际搜索词之前,会生成数百个中间思维链(CoT)推理 token(即 AI 模型在回答复杂问题前生成的中间步骤或内部处理单元),以规划查询扩展。虽然这种深思熟虑的推理过程在对话式 AI 中尚可接受,但对于集合值搜索(例如检索上述流苏夹克或钩织连衣裙等互补结果集)而言,它引入了严重的结构性瓶颈。当系统必须同时头脑风暴大量子查询时,持续上下文处理和生成扩展推理 token 的综合开销扩展性极差。即便采用高级服务优化,这种逐 token 的架构仍会设定一个延迟下限,这与生产级搜索栏所需的亚秒级响应时间从根本上相悖。
Retrieve-for-Train 框架
Retrieve-for-Train 将 AI 的训练过程类比为离场的演练,而非在用户等待时的即时考试。与其让 AI 每次面对查询都缓慢摸索最佳搜索规则并消耗巨额计算资源,Retrieve-for-Train 仅运行一次离线 RL 训练程序。
该程序通过严谨的奖励机制,将“确保结果多样且实际有货”等抽象目标转化为精确的逐步操作指南。一旦生成该指南,AI 即可在真实搜索中即时执行,毫无延迟。
流水线分为三个独立步骤:
- 扇出语言模型训练:通过 RL 训练扇出语言模型,使其输出对齐特定属性的子查询,并由基于集合级属性检查的奖励进行评分。此机制评估整体结果集,而非孤立地给单个结果打分。
- 监督合成:利用冻结的扇出语言模型完全离线地合成(查询 → 目标集)配对数据用于监督学习,无需人工标注。
- 扩散检索器训练:一个 53.9M 参数的紧凑扩散模型学习将查询嵌入直接映射到完整的嵌入目标集,仅需一次非自回归过程,从而正式绕过基于文本的 CoT 推理 Token。
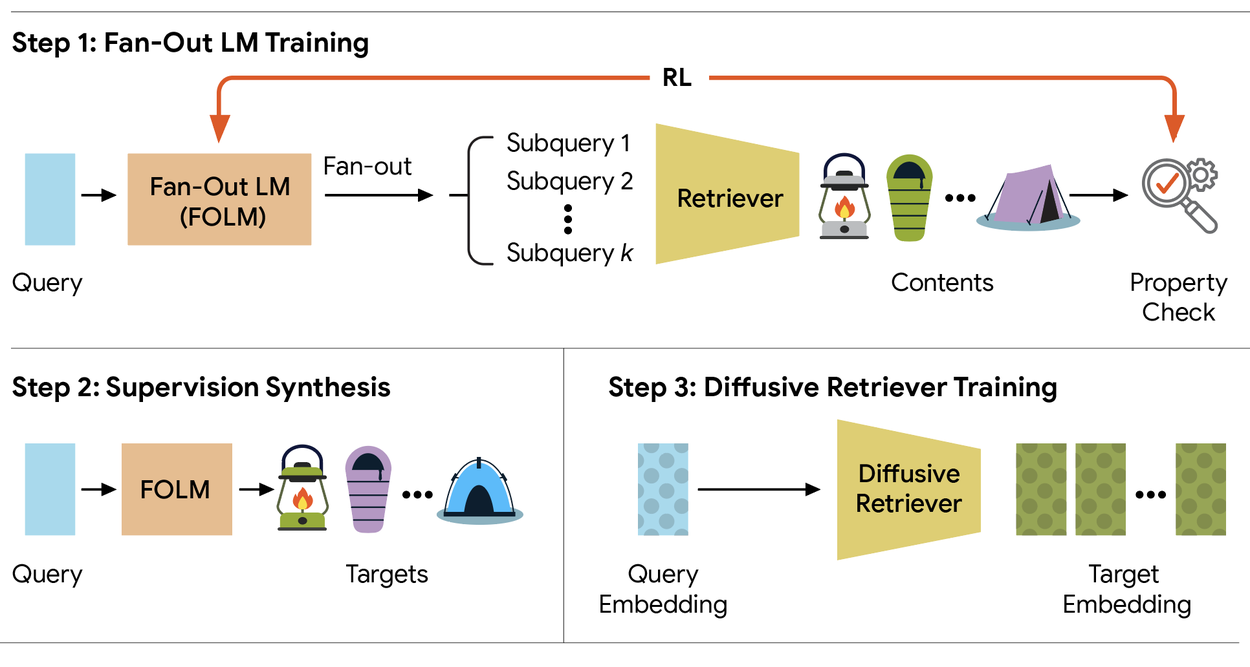
Retrieve-for-Train 框架概览。步骤 1:使用 RL 训练扇出语言模型(FOLM)以生成属性对齐的子查询。步骤 2:利用训练好的 FOLM 合成监督数据。步骤 3:训练基于扩散的扇出检索器,直接从查询嵌入采样内容嵌入。
面向集合的设计:复合奖励的优势
Retrieve-for-Train 框架能否成功,完全取决于我们如何定义"好的"搜索行为。传统监督训练采用 learning to rank 来评估逐点相关性,孤立地为每条检索结果打分。但真正专业的搜索结果集是由不可分解的集合级属性定义的。你无法衡量单条结果的多样性或互补性——这些属性在数学上只有对整批检索结果进行评估时才存在。
Retrieve-for-Train 没有依靠模糊的自然语言指令来约束这些扇出属性,而是用严格的数学复合奖励,通过强化学习微调 4B 开源语言模型(Gemma3-4B 和 Qwen3-4B)。对于开放式摘要检索任务,这个复合奖励是三个相互竞争维度的加权平衡:
- 有据性:惩罚与数据库流形的距离,确保每条生成的子查询都对应数据库中真实可检索的条目。
- 多样性:用 Vendi Score 在整个子查询集合上度量,迫使模型探索宽广的语义范围。
- 对齐性:将候选子查询锚定到原始的宽泛提示上,防止语义漂移。
相互制衡与 soft-GRPO 训练
训练时,我们使用带 soft proximal policy optimization(PPO)的 group relative policy optimization(GRPO),让扇出语言模型贴合这些几何约束进行优化。
这三个奖励缺一不可,因为它们相互制衡。如果模型只优化有据性,就会通过奖励投机钻空子,生成恰好能在数学上映射到某个数据库坐标的退化、无意义的字符串。加入对齐性来修复这种无意义输出后,策略又会换个方式作弊——坍缩成对用户提示的重复换述。
通过引入 Vendi Score 作为反向约束,Retrieve-for-Train 有效封堵了这些捷径解法。为了达到高奖励状态,策略被迫进入嵌入空间的平衡区域,在此区域内,模型必须发现既有效、又严格基于库中实体、且在语义上与原意图区分开来的多样化变体。
实验
为了评估 Retrieve-for-Train 框架,我们结合了冻结的、针对特定数据集的多模态嵌入骨干模型,以及针对查询扩展优化的开源语言模型。我们在两种截然不同的集合值检索场景下对这一配置进行了评估:
- 开放式抽象检索:在这种场景下,不存在唯一的真值,质量完全由集合级属性衡量,包括多样性、查询对齐度以及数据库接地性。
- 弱监督组合检索:在这种场景下,查询被配对一个弱参考集,该集合仅代表查询意图的一种可行实现方式。
在多模态嵌入骨干模型方面,我们在两个领域开展了实验:一个是用于文本到图像实验的、由用户策划的大规模时尚穿搭数据集(使用基于 CLIP 的检索器进行评估);另一个是用于文本到音乐评估的、由专家生成的专有工业音乐播放列表数据集(使用 MuLan 进行评估)。
在语言模型方面,查询扩展过程由 4B 参数的开源模型驱动,具体包括 Gemma3-4B 和 Qwen3-4B,这些模型的任务是为每个主搜索提示词生成恰好 10 个子查询。我们使用 Soft-GRPO 为这些扩展模型实施强化学习训练,该方法采用了带有组相对策略优化和软 PPO 正则化的方法。
结果
检索质量与准确性
在两项检索任务中,Retrieve-for-Train 的表现均优于传统的单查询搜索、零样本扩展,甚至优于经过深度优化的 Best-of-N 基线。
从定性角度看,零样本 LLM 基线倾向于生成近乎同义的改写(例如“波西米亚节风格”与“波西米亚节时尚”),导致结果冗余。而 Retrieve-for-Train 生成了高度多样化且各具特色的子查询(例如分支到“靴子”或“蕾丝”),且始终严格落在数据库的流形范围内。
推理速度提升一个数量级
直接部署我们经过 RL 微调的语言模型确实带来了卓越的搜索质量,但它继承了标准的自回归延迟限制,且需要高额的计算思考预算。
通过将该学习行为蒸馏到 5390 万参数的 Retrieve-for-Train 扩散模型中,我们成功打破了延迟瓶颈。由于扩散模型在连续嵌入空间中通过单次非自回归并行过程同时生成所有目标方向,相比自回归方法实现了 12 至 20 倍的大幅加速。
在大规模场景下,当自回归的扇出延迟在大上下文批次下线性增长至接近 50 秒时,Retrieve-for-Train-Diffusion 仍保持在亚秒级到几秒之间,以极低的计算成本提供了生产级、专家级的搜索体验。
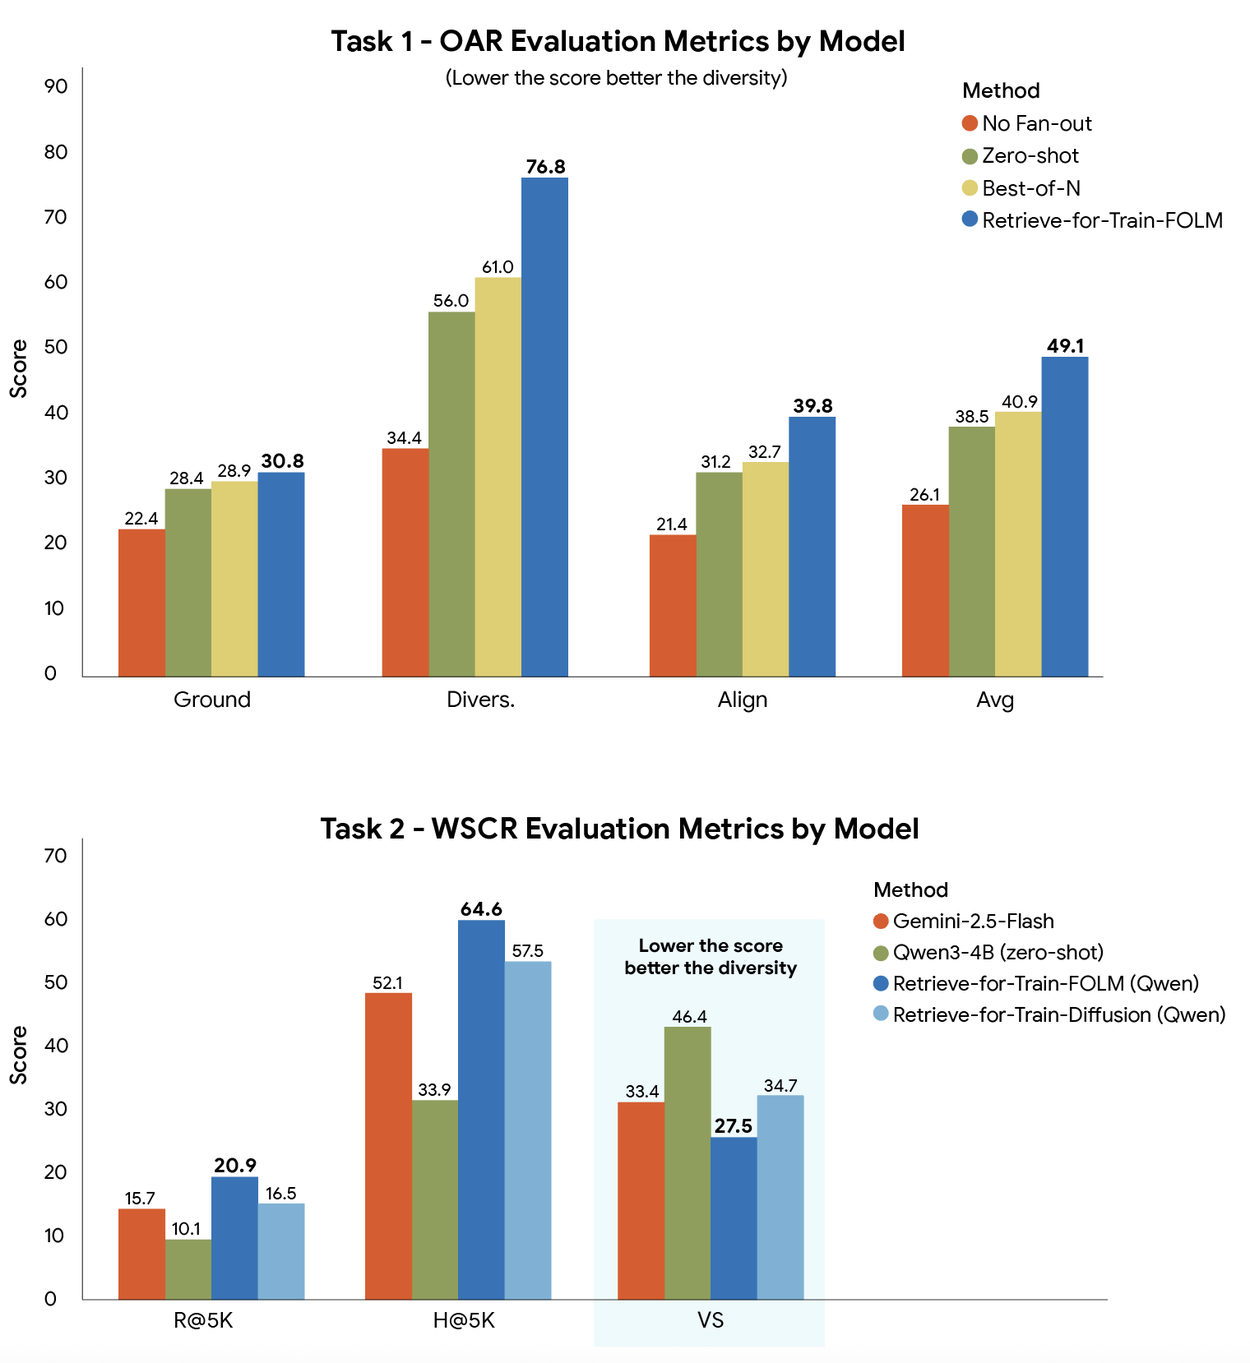
Retrieve-for-Train 框架(包括 FOLM 和 Diffusion 版本)在开放式摘要检索(OAR)和弱监督组合检索(WSCR)两项任务中,均持续优于标准搜索和零样本基线,在多样性、对齐度和召回率方面带来了显著提升。
防作弊锚点(消融实验洞察)
在奖励优化过程中,我们发现了一些训练搜索 fan-out 语言模型的关键规律:如果缺少多样性项,模型会很快塌缩成生成退化的无意义字符串(比如 "line ending line ending"),以此从数学上钻数据库向量坐标的空子。引入一个几何多样性指标(Vendi Score)能起到重要的反向锚定作用,把模型约束在嵌入空间的稳定区域内,让它只能像真正的搜索专家那样行动才能最大化奖励。
结论
我们证明了 RL 作为一次性的"目标转换器"而非在线推理引擎使用时可以非常高效。通过把奖励驱动的行为探索所需的繁重计算与最终部署的模型解耦,我们的框架成功绕开了在线 LLM 部署常见的高推理延迟和大计算开销。
把这些复杂的集合级行为蒸馏进一个轻量的 diffusion prior,可以让生产级检索系统有效地优化多样性和对齐这类高阶属性。最终,Retrieve-for-Train 为特定领域或多模态领域的集合检索建立了一条高度可扩展、数据高效的流水线——在这些场景下,人工标注且与目标属性对齐的训练对往往稀缺或成本高昂。更多细节请参阅论文。