
Dense 与 MoE 模型对比:激活参数、吞吐量及架构选型指南
一个 30B 参数量的模型,为什么每处理一个 token 只激活 3B 参数,却依然能利用大模型的容量?Nemotron 3.5 Lightning 给出了答案:它采用混合专家(MoE)架构,仅选取部分参数来处理每个 token。
目前有两种主流的模型架构:Dense 模型和 MoE 模型。模型如何组织参数,与其参数量同等重要。相比原始参数量,这一选择对吞吐量、内存成本和服务复杂度的影响更大。因此,两者的选择取决于你的部署限制。
可以把这种差异想象成两台总排量相同的发动机:一台在每个工作循环中点燃所有气缸,另一台则只激活所需的气缸。
本文解读:
- Dense 和 MoE 架构的运作机制
- 它们对性能的影响
- 何时选择哪种架构
Dense 模型 vs. MoE 模型
简单来说,Dense 模型和 MoE 模型的区别在于参数使用方式。Dense 模型在处理每个 token 时会激活所有参数。MoE 模型则存储多个专家网络,但仅通过选定的子集来路由每个 token。
Dense 模型通常更适合简单、可预测的部署;而 MoE 模型在内存和服务复杂度可控的前提下,能提供更大的容量和更高的吞吐量。
参数差异
在 Dense 模型中,每个参数都参与每次前向传播。例如,一个 27B 模型的所有 27B 参数在每个 token 处理时都会激活,通过每层解码器中单一的共享前馈网络(FFN)块完成。
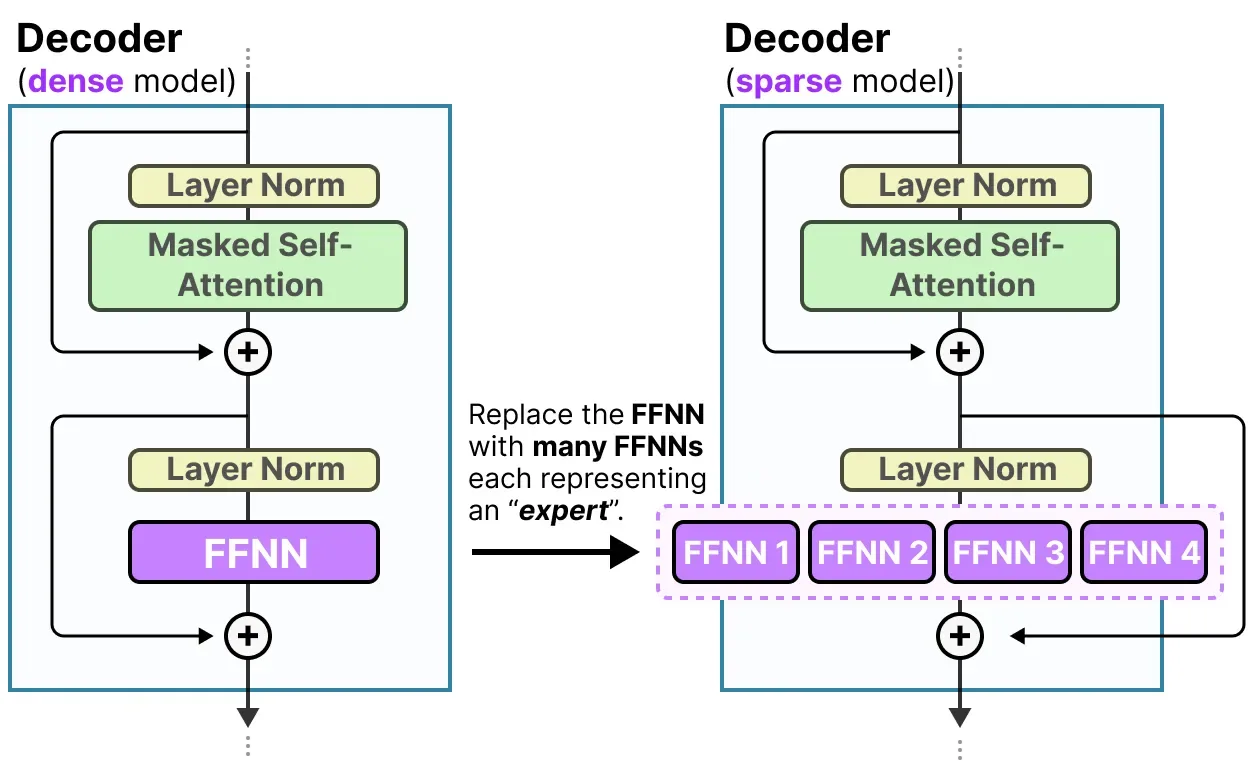
MoE 模型用多个 FFN 模块(即专家)替换了那个唯一的共享 FFN。通过内部路由机制,输入的 token 只会经过一小部分专家处理,而不是全部参数。从结构上看,在 dense 模型只有单个 FFN 的每个 decoder 层里,MoE 层有多个 FFN(比如 8、64 或 128 个)。一个通过学习得到的 gate 网络(通常称为 router 网络)位于所有专家之前,为每个输入的 token 分配得分最高的 top k 个专家。被选中的 FFN 模块才会为该 token 运行,其余的在该层被跳过。不过,大多数现代 MoE 模型(如 Mistral Small 4)还会运行一个“共享”专家,所有 token 无论路由结果如何都会经过它。
MoE 路由的工作原理
MoE 模型的路由决策是逐层独立进行的,也就是说,token 不会在某层被分配给某个专家后就一直停留在那里。在每个 decoder 层,它都会根据当前在网络中所代表的内容重新路由。每一层的这些专家并非传统意义上在某个学科上专精的专家,它们的专长主要在于语法和 token 类型模式(标点、数字等),当然具体表现会因架构或训练方法而异。
虽然 router 机制决定每层跳过哪些 FFN 模块,但 token 仍然会照常通过完整的注意力机制。因此,模型卡上写的“3B 激活参数”,既包含每个 token 都会经过的注意力和 embedding 权重,也包含被选中的 FFN 权重。
MoE 的变体
MoE 也存在多种变体,例如 NVIDIA 在 Nemotron 3.5 Lightning 模型卡片中采用的 Mamba-2 + MoE + Attention 混合架构。在大多数层中,Mamba-2 层替代了注意力机制,使用大小恒定的递归状态而非不断增长的 KV Cache。这种变化从根本上改变了长上下文场景下的内存占用特征,这一点仅靠稀疏化无法解释。
Lightning 并非直接利用整个模型的宽度来进行路由决策,而是先将信息压缩到较小的空间,从而降低模型做出路由决策的成本。下文的图 1 展示了典型的 Transformer-MoE 结构。需要注意的是,MoE 模型属于稀疏模型的一种。
哪种更快:Dense 还是 MoE 模型?
MoE 模型在 Token 吞吐量方面通常更快,因为它们为每个 Token 仅激活前馈参数的一部分。Dense 模型则激活整个网络,但部署更简单,延迟更可预测。
在高并发场景下,路由和内存数据移动会削弱 MoE 的优势。性能结果还取决于硬件、精度、推理框架和模型设计。例如,Nemotron 3.5 Lightning 就采用了 Mamba-2 层和推测解码技术。
关键模型性能差异
两者的性能差异主要源于两点。首先,在总参数量相同的情况下,跳过的 FFN 块使 MoE 速度更快。更关键的差异在于,MoE 将内存(总参数 → 主机 VRAM)与计算(激活参数 → 每 Token FLOPs)解耦了。
在稠密模型中,托管成本与推理成本是联动的,而 MoE 打破了这种关联。对于 MoE,显存(VRAM)开销是预支的。当所有专家模块加载到内存时,算力成本按令牌计费,且仅随被激活的专家数量增长。闲置专家不产生算力成本,但仍需支付存储所需的显存开销。因此,从每令变动算力成本转变为固定显存成本,是主要的权衡取舍。
在批量大小为 1 时,解码速度受限于内存而非算力,这正是 MoE 表现优异的场景,因为每个令牌读取的权重字节数更少。随着批量大小增加,集合中的令牌会共同使用网络中的大部分专家,这一优势逐渐缩小,但每令牌的计算量减少这一特点依然存在。MoE 在各个批量大小下均保持吞吐量优势,但与传统优化良好的稠密模型相比,在高并发场景下的延迟优势会被压缩。
现代推理框架通常处理路由过程而不丢弃令牌,尽管所有专家模块必须同时驻留在 GPU 内存中。这导致与同等规模的稠密模型相比,留给 KV cache 的空间更少。
对比示例
下表(表 1)展示了直接对比。在总参数量相同的情况下,稀疏性在推理吞吐量上的差异显而易见:Gemma 4 31B 和 Nemotron 3.5 Lightning 的总参数量均为约 30B,但在 NVIDIA GPU 供应商中,二者的输出速度范围完全没有重叠。每个令牌仅激活 3B 参数是主要原因之一,但并非唯一因素。Lightning 的 Mamba-2 层 及其投机解码 技术独立于混合 MoE 架构,也做出了贡献。
| 模型 | 架构 | 总参数量 | 激活参数量 | VRAM(原生) | VRAM(4-bit) | Artificial Analysis 智能指数 | 输出速度‡ | 每 M 输出成本$‡ |
|---|---|---|---|---|---|---|---|---|
| Gemma 4 31B | 稠密;多模态 | 31B | 31B | ~61 GB BF16 (1×H100) | ~16 GB | 30 | 36.9 – 222.4 t/s | $0.40 |
两者的取舍清晰可见:例如 Lightning 的输出速度是 Qwen3.8-27B 的四到五倍,价格只有十四分之一,但通用能力得分不到后者的一半。这种特性适合作为 agentic 执行层,批量运行步骤明确的任务;但如果结果取决于一次高难度的推理,它就不合适了。
什么时候该用 Dense 模型,什么时候该用 MoE 模型?
选哪种模型,关键看哪种更契合你的部署场景。
需要考虑以下几个因素:
- 内存预算:内存占用取决于总参数量而非激活参数量,所以 30B 的 MoE 和 30B 的 Dense 模型都需要约 60 GB。真正的问题是这些内存换来了什么:Dense 把它换成能力,MoE 把它换成吞吐量。
- 并发:单请求场景下 MoE 优势明显。随着并发增加,其吞吐量优势依然保持,但延迟差距会缩小。如果你在高并发下对延迟敏感,建议先对两者做基准测试再做决定。
- 微调计划: Dense 模型微调更简单,所有参数全部激活,梯度均匀流动。对 MoE 模型进行全量微调可能会破坏路由器的平衡,导致部分专家被过度使用,甚至使某些专家彻底失效。采用 LoRA/PEFT 方法并直接冻结路由器可以有效避免这一问题。NeMo 针对 Lightning 模型的监督微调方案已对此进行了正确处理
- 量化:架构差异并不体现在压缩率上。实际应用中更有意义的是另外两点。首先,确认检查点出厂时的精度:Mistral Small 4 原生为 FP8,因此 4-bit 量化只能带来约 1.7 倍(121GB → 71GB)的节省,而非 4 倍。其次,两种架构都有难以量化的模块,但具体位置不同。在 MoE 中,敏感点是路由器,微小的扰动就会改变离散路由决策;而在混合注意力模型中,则是循环投影部分容易翻转路由决策。例如,量化后的 Qwen3.8-27B 构建版特意将线性注意力块保留在 BF16,原因正在于此。
核心权衡
Dense 和 MoE 是对同一权衡的两种回应:每参数能力对比每 token 计算成本。Dense 保持简单且全参数激活,便于微调和部署。MoE 以内存换吞吐量,代价是部署复杂度更高。
Nemotron 3.5 Lightning 完全开放了权重、数据和配方,便于适配工作流并在任意环境部署。可在 build.nvidia.com 或 OpenRouter 上立即试用。权重可从 Hugging Face 和 ModelScope 下载。
在 物理 AI 工作负载场景中,AgiBot GO-1 和 Tencent Hy-Embodied-VLM-1.0 是生态系统中广受欢迎的选择。