
从兆瓦到令牌:NVIDIA 如何最大化 AI 工厂生产效能
八月一个闷热的傍晚,硅谷日落时分,空调用电量飙升。Silicon Valley Power 向一家 AI 工厂发出信号,要求其调整用电量。
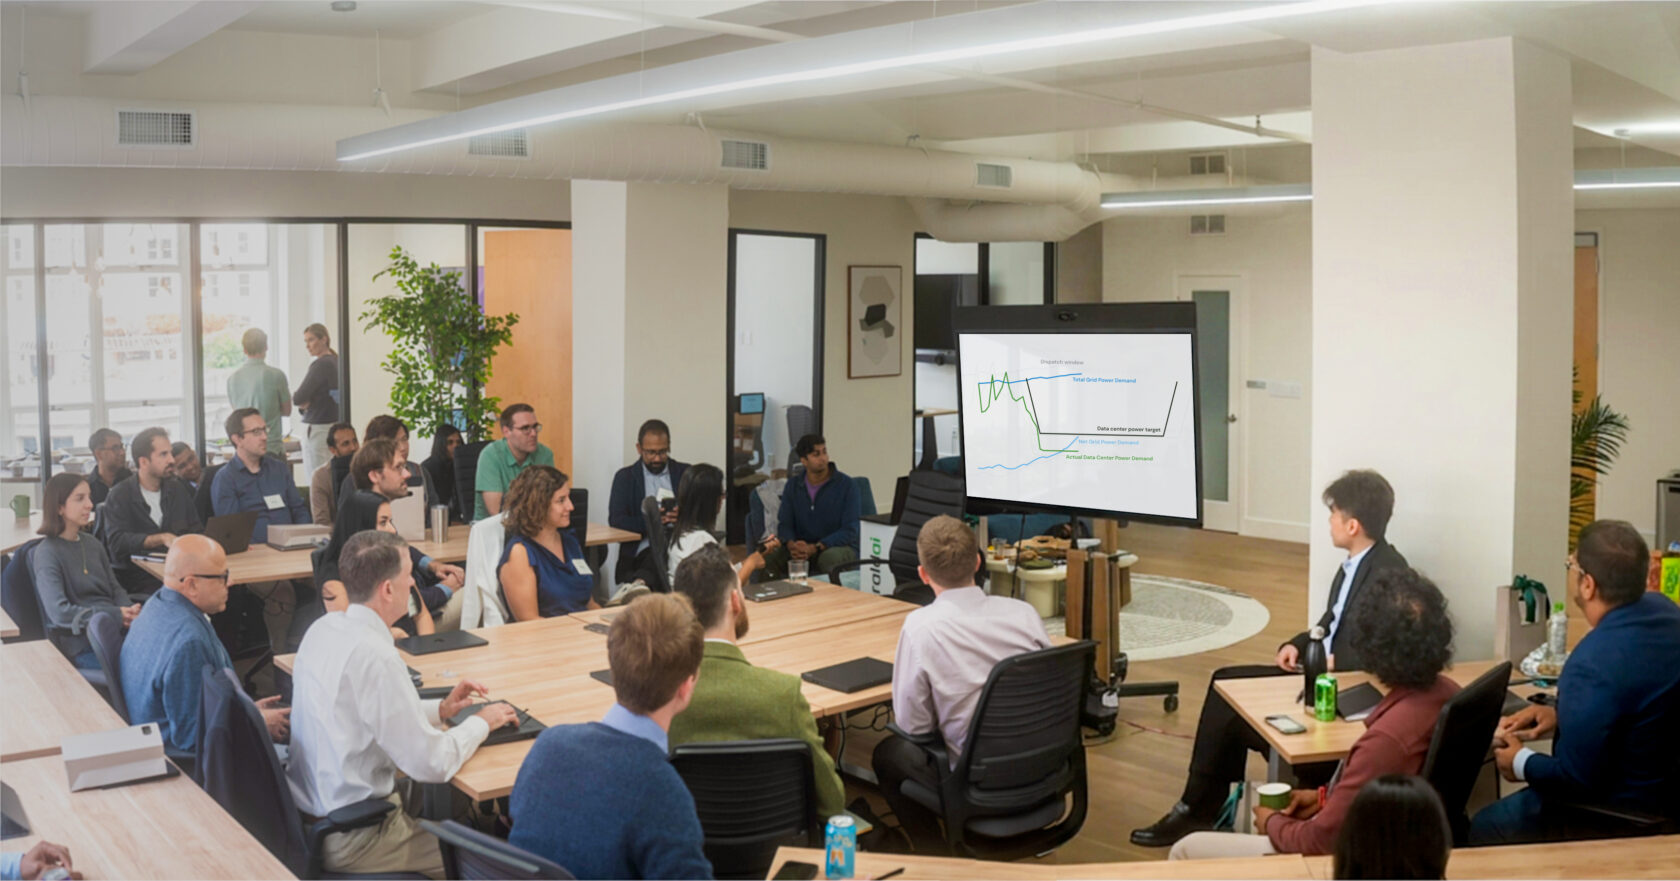
Varun Sivaram 和大约四十个人一起在 Zoom 上紧盯屏幕——他位于 Emerald AI 的团队在旧金山的会议室里,还有数据中心的工程师和电力公司的人。所有人都屏息以待,没人动任何东西。
Emerald AI 的 Conductor 平台——由 NVIDIA 合作伙伴 Emerald AI 打造的电网调度平台,也是 NVIDIA DSX Flex 所要提供的灵活性的早期范例——接收电网状态信号,并相应调整数据中心的弹性计算工作负载:不急的任务被降速或重新安排,高优先级服务则继续运行。
目标是当电网供电紧张时降低电力需求,同时不中断关键 AI 工作负载——这正是 Silicon Valley Power 需要的。
当降幅出现在屏幕上时,所有人欢呼起来。
“我们全程紧张地盯着,”Sivaram 说,“这是我们第一次在数千块 NVIDIA GPU 上部署。”他的产品负责人 Mansi Shah 也很激动:“这感觉有点像 SpaceX 火箭发射。”
此后,Silicon Valley Power 又向这家 AI 工厂发出了 200 多次需求信号,每一次都成功了。
这就是已经在生产环境中落地的电网灵活性。而它指向的远不止 Santa Clara 的一座设施:这是一条解锁美国 AI 工厂所需电力的路径,不必再苦等十年新建输电线路。
在周二的 AI Infra Summit 上,NVIDIA 超大规模与高性能计算副总裁 Ian Buck 在基础设施主题演讲中,把 AI 工厂能效作为核心议题。
云服务商 Lambda 当天发布的首次部署环境验证结果给出了具体数字:通过智能化管理,固定的电力预算可以支撑多 24% 的 token 吞吐量。
“通过概念验证,我们相信我们已经突破了固定电力预算的限制,”Lambda云服务总裁 Dave Ward 说道。“NVIDIA DSX MaxLPS 为回收闲置容量并将其转化为实际生产力铺平了道路,在相同的占地面积内实现了显著的算力密度提升。”
那个八月的傍晚,当 SVP 来电时,Conductor 按照预设的工作负载层级执行了策略:低优先级任务让位,高优先级推理任务继续运行,功耗从四兆瓦降至三兆瓦。全程自动化,无需人工干预。
在 AI 工厂经济中,电力是核心约束。每吉瓦产出多少工作负载是关键指标。数据中心运营商对效率极其苛刻——每一瓦被利用的电力都在产生有效的算力,行业在从设施设计到机架级电力转换的每个层面都取得了显著的能效提升。
DSX 将这种严谨性延伸到了 AI 工作负载本身。更智能的机架配置能将电力精准分配给工作负载真正需要的地方。运营智能——包括更紧密的调度、更快的重启和更精简的检查点——让 GPU 保持运行而非等待。目标始终如一:用现有的电力产出更多工作。
“一个吉瓦的工厂永远不可能变成两个吉瓦的工厂,”NVIDIA 创始人兼 CEO 黄仁勋曾这样说。
当系统触及物理极限时,工程师给出的答案总是相同的:停止优化局部,开始设计整体。
在五月 GTC 台北大会上发布的 NVIDIA DSX 正是 AI 工厂的这剂解药——而早期的部署已经初步验证了其有效性。
完整平台涵盖网络、冷却、水效及设施设计;以下内容聚焦于目前在电力管理和电网参与方面取得的部分成果。
相同预算,更多算力:DSX MaxLPS
在 AI Infra Summit 上发布的 Lambda 成果,首次验证了 DSX MaxLPS 在 NVIDIA HGX B200 GPU 服务器上的表现。
DSX MaxLPS 监控 GPU 和机架级的功耗,并根据工作负载类型在节点间重新分配电力余量,回收静态配置中闲置的容量。训练和推理的功耗模式不同;MaxLPS 优化了同时运行这两类负载的 AI 工厂中的电力分配。
Lambda 是一家 GPU 云服务商,客户数量超过 1 万,涵盖 AI 原生初创公司到超大规模数据中心。他们在一个由五个机柜、19 个节点组成的集群上运行了该软件。
结果显示:在功耗预算等同于 16 个节点满功率运行的前提下,Lambda 仅用 19 个节点便将集群整体 Token 吞吐量提升了 24%——从每秒约 400 万 Token 增至 500 万。每瓦性能也提高了 23%。
根据 NVIDIA 的预测,在合适的部署环境下,DSX MaxLPS 能在相同的兆瓦级功耗预算内,为下一代 Vera Rubin NVL72 AI 工厂释放高达 40% 的额外 GPU 算力。
自动需求响应,经生产环境验证
圣克拉拉案例并非 DSX Flex 的落地部署,而是更早且更为关键的证明:这一概念在商业规模下切实可行。
NVIDIA 的 Eos AI 工厂正在硅谷电力(Silicon Valley Power)的“柔性负荷互连计划”中运行 Emerald AI Conductor。这是首个旨在将 AI 工厂视为可调度资源的商业化电网公用事业项目。
当硅谷电力发出信号时,Conductor 能在不到一分钟内做出响应。愿意进行功率灵活调节的工厂,便获得运行更大规模集群的机会。
DSX Flex 正是为了泛化这一模式而设计,随着平台成熟,Emerald AI Conductor 将被整合进 DSX Flex。首个专门的 DSX Flex 商业部署项目将落户弗吉尼亚州马纳斯斯(Manassas):这是 NVIDIA AI 工厂研究中心内的一座 96 兆瓦 Vera Rubin AI 工厂,其基础源于此前跨越两大洲的五次验证。
下一层电力架构:800V 直流电力架构
当前 AI 工厂内部的能效提升真实存在且可立即部署。下一层级的关键在于如何向更高密度的加速计算机架供电。
随着 AI 工厂规模扩大,传统低压供电路径会增加转换复杂度并带来配电约束。
NVIDIA 的 800 VDC 架构旨在简化转换流程、提升供电效率,并支持更高密度的加速计算机架。
NVIDIA DSX 正在将其参考设计中融入 800V DC 技术。
着眼全厂,而非局部部件
任何单一组件都无法独立优化 AI 工厂:GPU 再快也得等网络,电力规划不当就会被闲置,散热开销也始终在分走本可用于计算的电力——采用直接液冷的 GB200 NVL72 机柜,每台约产生 120 kW 热量,必须先处理好散热,这些电力才能真正用于计算。
想提高每兆瓦产出的 token 数,唯一的可靠路径是对整个工厂进行优化——装机之前用 DSX Sim 做仿真,运行后靠 DSX OS 和 DSX Exchange 管理,再借助 DSX Reference Designs,让建设者从经过验证的架构起步,而不是从零摸索。(完整 DSX 套件一览见侧栏。)
吉瓦级基础设施标准
归根结底就是一个问题:工厂每消耗一兆瓦电,能产出多少有效工作?
NVIDIA DSX 为基础设施建设者提供了参考设计、仿真工具、运维软件和电力管理技术,让他们无论在现有硬件还是下一代硬件上,都能在这个指标上展开竞争。
当电网需要减负时,工厂立即响应——不中断任何任务,也不额外要电。
有了 NVIDIA DSX,这就是 AI 工厂应有的新基准。