
Agent 任务表现优异,能稳定复现吗?
你的 Agent 在排练时表现出色,可到了现场演示,它却走了另一条路径,导致同样的任务失败。
这发生在舞台上非常丢人,在生产环境中则是一致性问题:之前成功过的工作流,下次用户提出相同请求时可能会再次失败。对于财务对账或合同合规检查这类关键任务,这往往是致命缺陷。
大多数基准测试用平均值掩盖了这种波动。在 AppWorld 上,基于 GPT-4.1 的 ReAct Agent 在 5 次重复测试中达到了 77.4% 的成功率。但只有 53.0% 的任务在全部 5 次测试中都能成功——这意味着存在 24.4 个百分点的一致性差距。
多数基准测试只报告前一个数字。我们开发了一种方法来衡量后一个数字,并尝试改进它。
在之前的文章中,我们介绍了 ALTK-Evolve——一个自动将 Agent 过往轨迹提炼为可复用指南,并在推理阶段注入其中的系统。它显著提升了任务成功率,但那些结果依然只关注了平均水平。本文引入一致性指南,这是在 altk-evolve 基础上新增的一种指南类型,基于我们自研的诊断工具一致性分析器(Consistency Analyzer)构建,专门针对这一差距进行优化。
太长不看版
- 准确率掩盖了可靠性问题。 一个平均成功率 77.4% 的 ReAct Agent(使用 GPT-4.1 处理 AppWorld 的
test_normal集),仅在 53.0% 的任务上实现了 5 次全对——存在 24.4 个百分点的一致性差距。在处理高难度任务时,这一差距可达 30 个百分点。 - 我们为此构建了专用诊断工具。 一致性分析器对 Agent 记录过的轨迹进行重新采样,以发现容易翻转的决策点,即模型只需一次采样就能做出不同选择的步骤。它只需要一条轨迹,无需标准答案,通过为轨迹中的每个决策点发起 k 次补全(默认 k=5)来重新采样,而非从头重新运行任务。
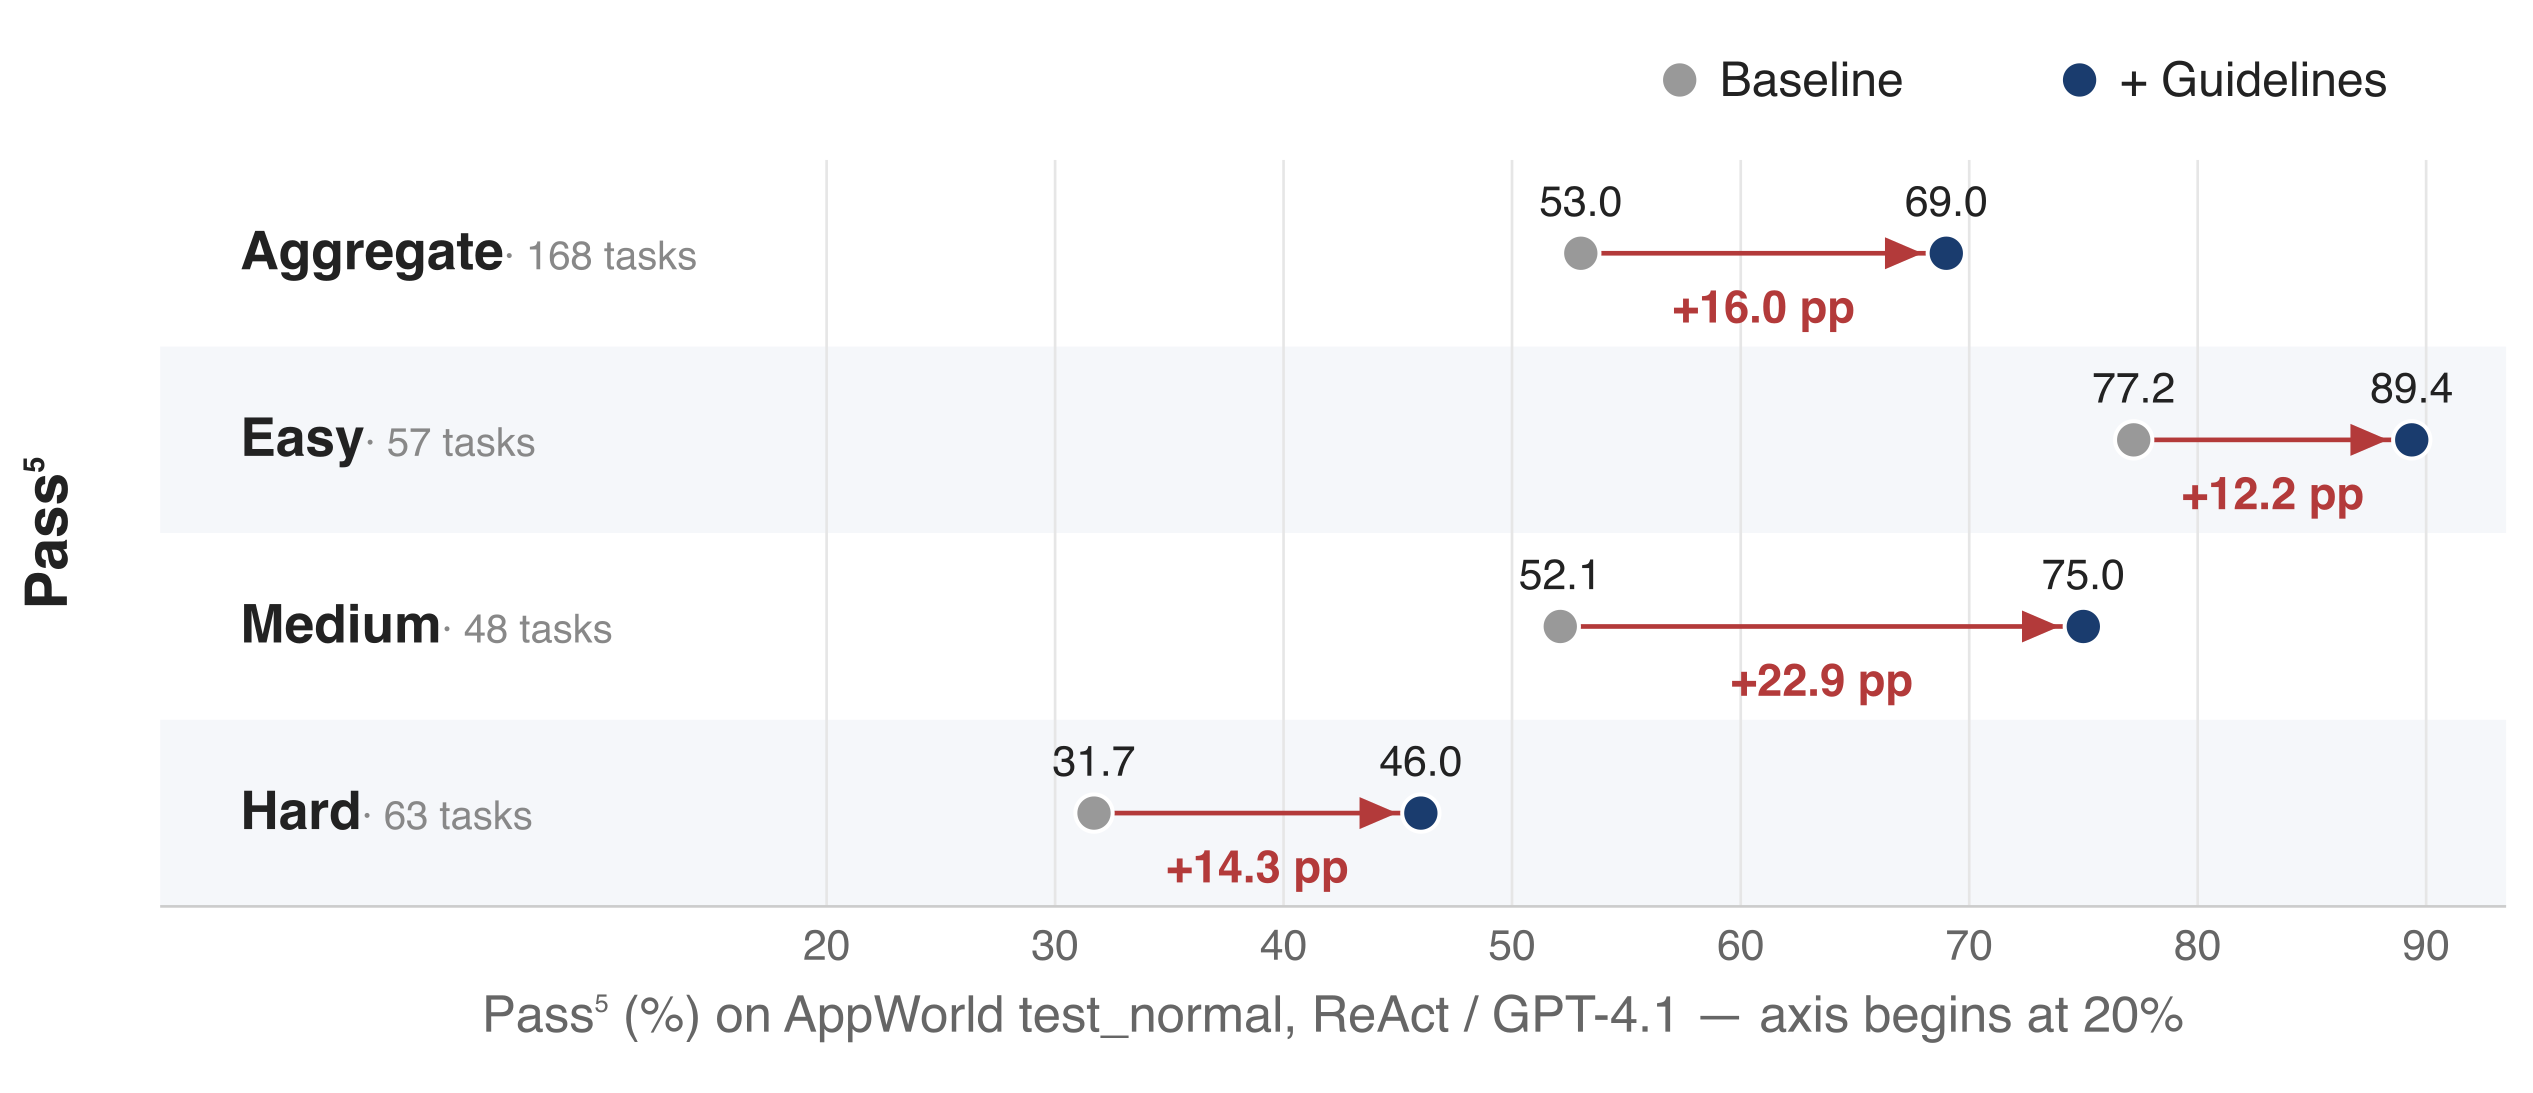
- 将该诊断转化为指南后,一致性差距减半,从 24.4 个百分点降至 12.0 个百分点(同任务 Pass⁵ 提升 16.0 个百分点,类似任务提升 13.0 个百分点),且不牺牲平均准确率。
- 完整的评估方法论请参阅arXiv 上的技术报告。
几乎无人报告的指标:一致性差距
标准的 Agent 评估通常报告 Mean@k:将基准测试运行 k 次,并计算通过率的平均值。通常 k 设为 3,有时仅为 1。这是各大排行榜上最常见的数值,也是实际场景中“准确率 77%”的含义所在。
Mean@k 回答的是“这个 Agent 平均水平如何?”但它没有回答真实用户真正关心的问题:如果我再次提出完全相同的问题,它还能保持同样的水平吗?要回答这个问题,你需要 Pass^k:即在 所有 k 次运行中均成功完成的任务比例。
⚠️ Pass^k 不同于 Pass@k。常见的 Pass@k 偏向乐观——它询问 k 次尝试中至少有一次成功,这适用于可以验证结果并重试的场景。而 Pass^k 是其悲观的镜像:每一次尝试都必须成功。字母相同,问题却截然相反。始终有 Pass^k ≤ Mean@k ≤ Pass@k 的关系。
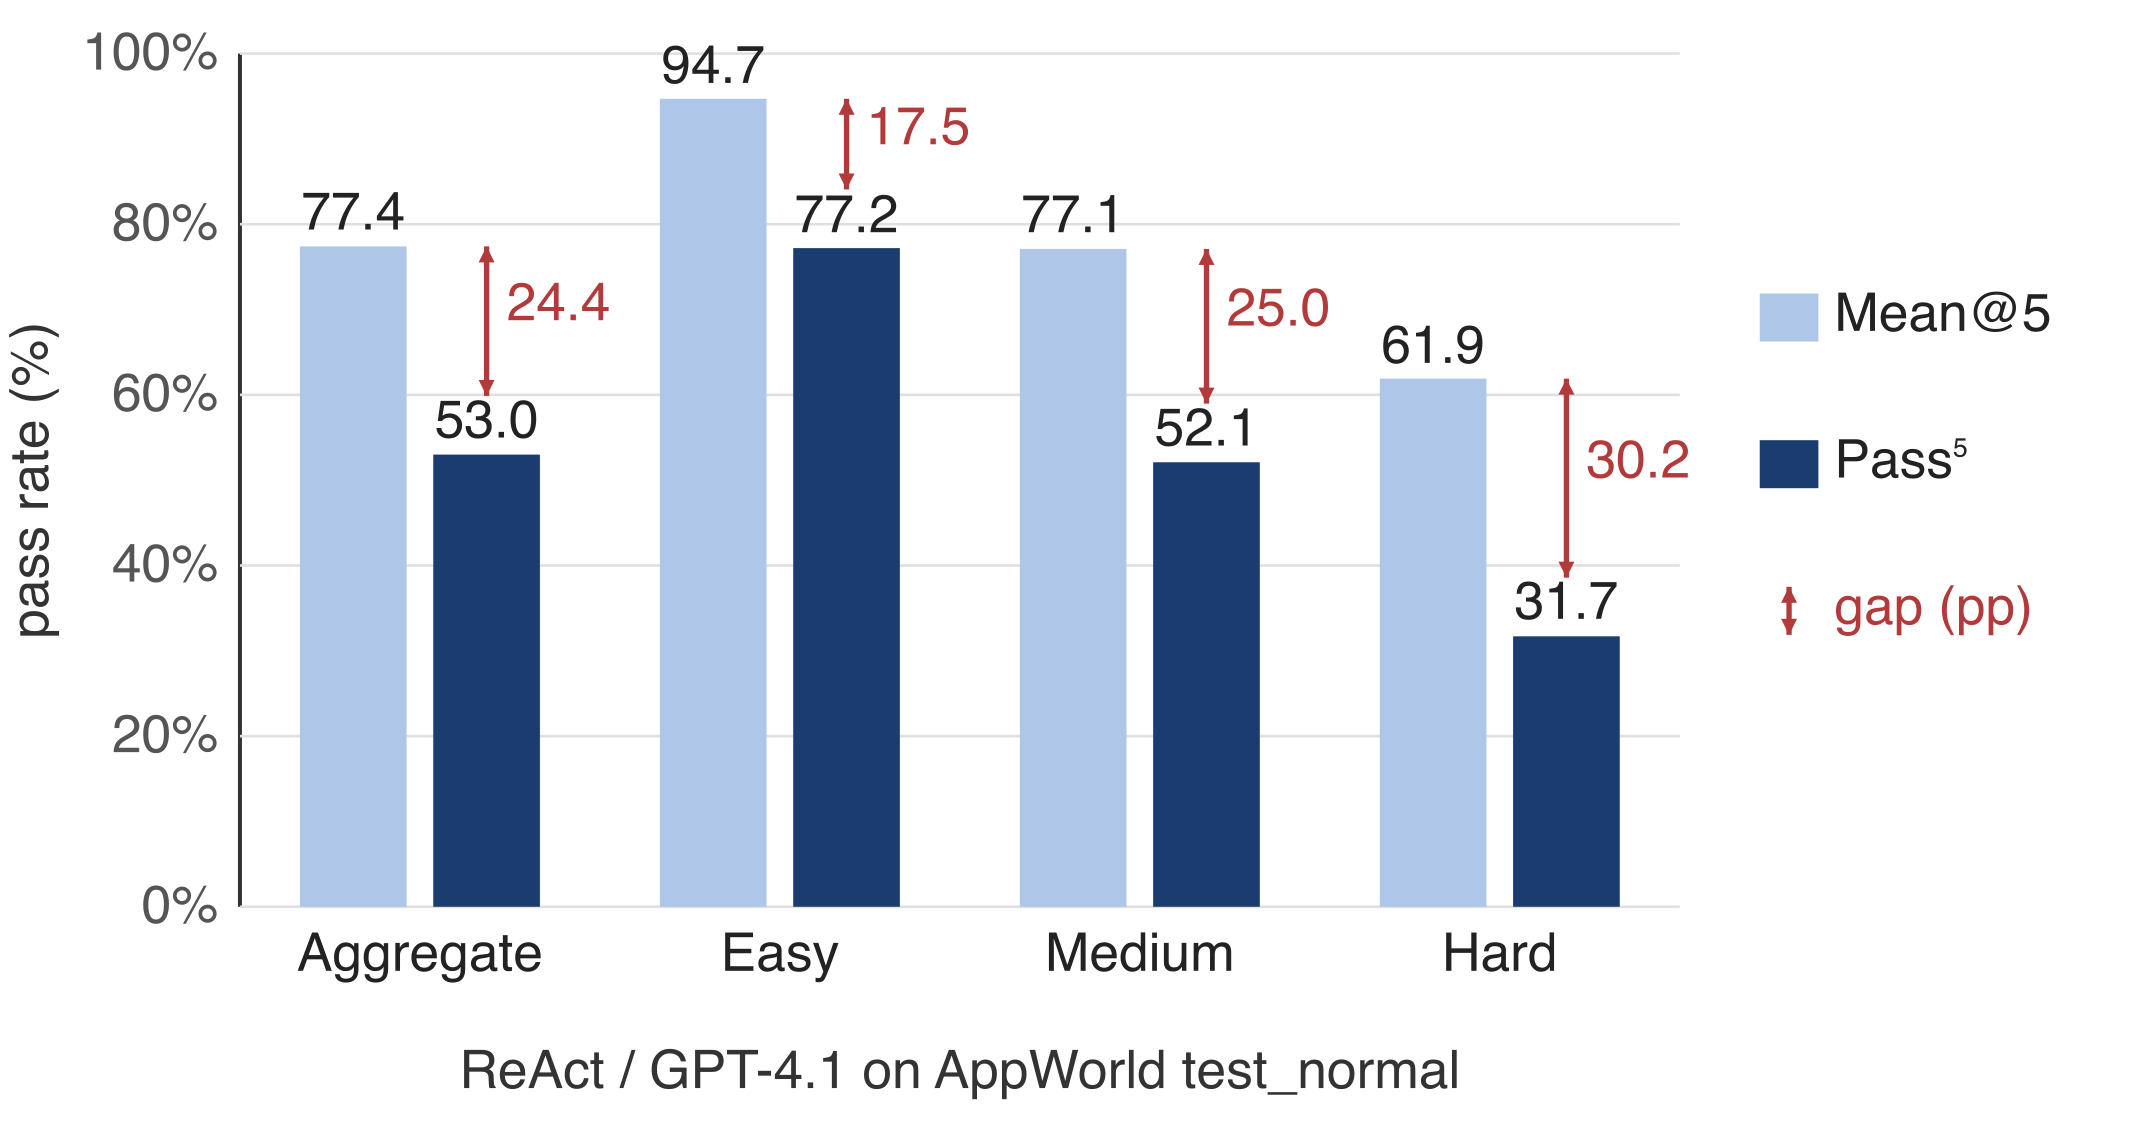
基于 GPT-4.1 的 ReAct Agent 在 Mean@5 上取得了 77.4% 的成绩——这确实很强。但 Pass^5 仅为 53.0%。基准测试中近四分之一的任务,Agent 有时能做对,有时又做错,而在不同运行之间,任务本身没有任何变化。我们将这个差距——Mean@k 减去 Pass^k——称为一致性差距(consistency gap)。
这并非单纯靠升级更大模型就能解决的“能力”问题。它是一个正交维度:一个 Agent 可以同时具备高能力和低一致性。
为什么 Agent 会摇摆:尖锐决策 vs. 扁平决策
LLM agent 每次做决策——调用哪个 API、传什么参数、要不要重试——本质上都是从下一个 token 的概率分布里抽样。关键在于这个分布的形状。尖锐的分布把大部分概率集中在单个 token 上:第二名远远落后,所以每轮运行都会做出同样的选择。平坦的分布则把差不多的概率分给几个不相上下的 token,最后谁胜出几乎等于抛硬币。
分布的形状决定了需要多大的扰动才能改变结果。尖锐的分布很稳健——GPU 浮点运算的不可结合性、请求批处理等平台层面的副作用只会轻微扰动数值,远不足以撼动明显的赢家。平坦的分布恰恰怕这种扰动:概率接近持平的选项,在微小扰动下排名就可能反转。而一条轨迹串联了几十个决策,每一步微小的翻转概率累积起来,某些运行就会走出不同的路径。24 个百分点差距就是这么来的。
这也解释了为什么调解码参数解决不了问题。贪心解码和固定种子控制的都是分布如何变成一个 token——对分布本身毫无影响。在托管端点上,每次运行的概率都会有细微波动,所以哪怕 temperature 为零,同一个 prompt 发给同一个模型,今天可能这样打破僵局,明天又换成另一种方式。
我们的实验设置:ReAct agent 以 temperature 0.0 运行,所以上述波动都不是普通的采样随机性。
先诊断,再修复
于是问题变成了一次排查:轨迹中哪些步骤的分布是平坦的——查出来之后又该怎么处理?
一致性准则来自一个两阶段流水线,它接入 ALTK-Evolve 的现有机制,用一个新的信号源驱动生成什么样的准则。
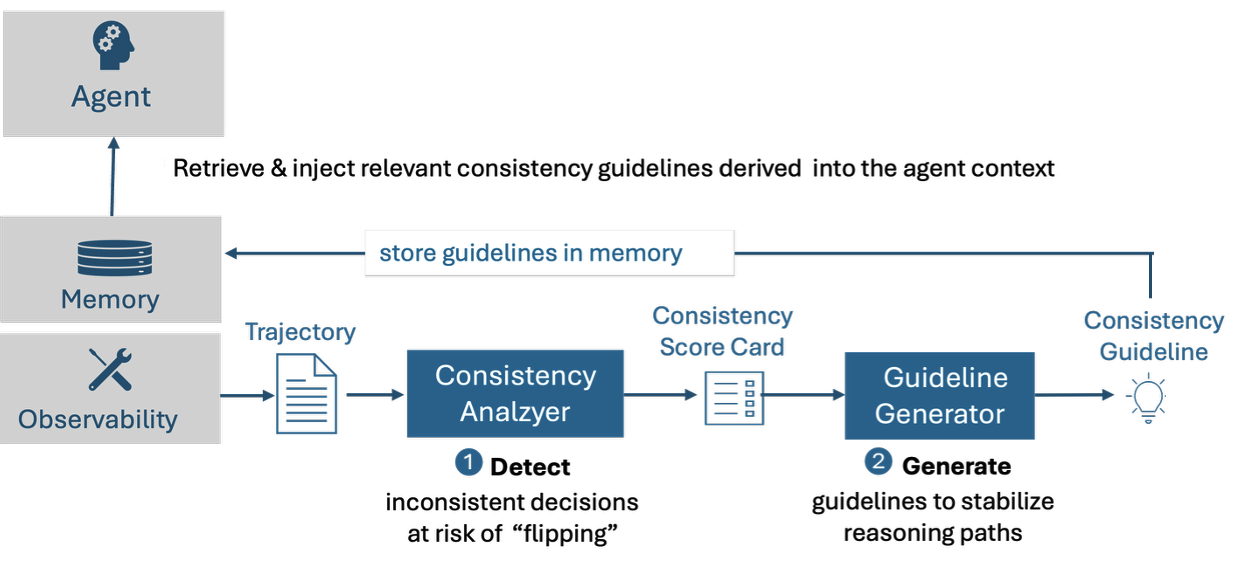
1. 检测 —— 一致性分析器。 给定一条已记录的任务轨迹,分析器会对每个决策步骤进行受控重采样,以衡量模型在该点的输出实际有多少波动。具体来说,每个决策步骤额外调用一次模型,且在离线环境下仅执行一次:采样参数被设置为一次性生成 k 个补全结果(默认 k=5),并基于已记录的上下文进行回放。这一过程不涉及新的工具调用、新的环境交互,也不会进行第二次端到端的任务演练。由此得到的每个决策步骤的一致性得分会被写入记分卡,以精确识别哪些决策在下次运行中容易反转。检测过程是完全黑盒的——无需访问 logits、模型内部状态,也不需要超出已有轨迹之外的任何插桩。
2. 生成 —— 针对性指导准则。 每个被标记的步骤都会转化为标准 ALTK-Evolve 格式的候选一致性指导准则,从而直接接入现有的存储与检索流水线。这里有一个由 GPT-4.1 根据 AppWorld 任务「根据我的 SimpleNote 笔记,我的愿望清单中完成了多少项活动?」的轨迹实际生成的例子:
[准则 1] 当统计笔记内容中复选框式标记时,应使用以行为锚点的正则匹配,而非简单的子串计数——笔记标题常常会在图例行中重复该标记符号。
[准则 2] 始终需验证笔记查询的搜索结果,确认存在多个匹配项并核实正确的笔记后再继续。
以上条目并非任务特有的琐碎知识。字符串计数错误和未经验证的搜索结果,是在许多 AppWorld 任务中表现出高不确定性的典型决策点。这正是该方法的关键:分析器针对的是不稳定性,而非失败——因此它能捕捉到那些本次恰好做对、但下次很容易出错的步骤。
观看 2 分钟演示 —— 该智能体并行运行五次的结果在此任务上以 3:2 分裂,原因是智能体对计数策略存在不确定性;在这些准则加入上下文后再次运行,五次结果完全一致。
结果:在保持准确率的同时缩小差距
我们在 AppWorld 的 test_normal 数据集(包含 168 个任务)上进行了评估。使用基于 GPT-4.1 的 ReAct agent,针对每个任务仅生成一条基线轨迹并据此提取一致性准则,随后在 5 次新的运行中验证这些准则的效果。
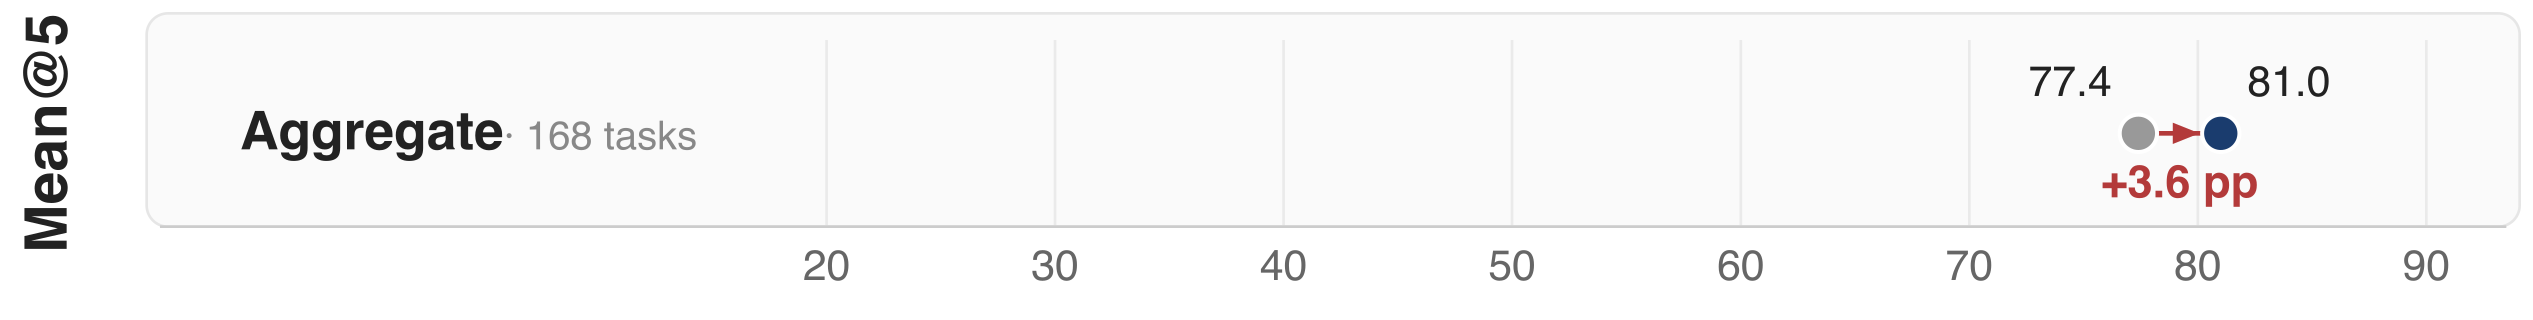
Mean@5(%),聚合值——与上方 Pass^5 图表使用相同标尺。
一致性差距几乎减半。 聚合 Pass^5 从 53.0% 提升至 69.0%,同时 Mean@5 从 77.4% 提升至 81.0%。这使得“看起来有能力”与“可以被信赖”之间的差距从 24.4 个百分点缩小至 12.0 个百分点。此前近三分之一的不一致任务,现在变成了 agent 在每次运行中都能通过的任务。
中等难度和困难层级获益最大。 中等难度提升 22.9 个百分点(相对提升 44%),困难难度提升 14.3 个百分点(相对提升 45%)——两者在相对提升幅度上基本持平,但中等难度在绝对提升上领先。简单难度提升 12.2 个百分点,因其初始提升空间最小。这正是 consistency guidelines 设计初衷的体现:识别并稳定那些 agent 自身不确定性原本会影响结果的关键决策点。
Mean@5 从未下降。 保持平均准确率是一项硬性要求,而非锦上添花:如果系统通过牺牲 Mean@5 来换取 Pass^5 的提升,那只是在不稳定性之间转移,并未真正解决问题。在所有难度级别上,平均准确率均得以保持或提升。
准则具有泛化能力——并非针对单一轨迹的补丁
将准则应用于同一 AppWorld 场景中另一相关但不同的任务——即提取准则的场景的另一个变体——一致性准则仍能将 Pass^5 提升 +13.0 个百分点,仅比同任务测试的数值低 3 个百分点。这说明从单次运行中得出的准则不仅仅是在修补那一次运行,而是捕捉到了可以迁移的通用特性。
更有说服力的证据来自一个更弱的模型 gpt-oss-120b。它在同任务上的 Pass^5 从低得多的基线提升了 +6.0pp(10.1% → 16.1%)——而且有意思的是,相似任务的泛化提升(+8.7pp)甚至超过了同任务本身的增益,这说明这些指南捕捉到的是真正可复用的失败模式,而不是在死记某条轨迹的细节。
如果你正在上线 Agent
- 在 Mean@k 旁边报告 Pass^k。平均值无法区分一个可靠的 agent 和一个碰运气的 agent;哪怕只取 k=3,也能暴露出你之前没意识到的差距。
- 任务越难,差距越大。在你最难的那批任务上,单一的平均值最具误导性。
- 别一上来就换更大的模型。一致性和能力是两回事。更强的模型能提高 Mean@k,但不一定能缩小一致性差距。
- 诊断不需要评分器,也不需要实时重放。每个决策步多一次 LLM 调用(默认采样 k=5 个 completion)就够了——不需要 ground truth,也不需要对着环境重跑任务。这正是它能用于生产流量的原因,毕竟在生产环境中,同一个任务你往往连一次完整的重放都做不到。
试用
试试 ALTK-Evolve toolkit——这个开源仓库现在包含了实验中用到的 Consistency Analyzer 和一致性指南生成功能——或者阅读 arXiv 上的技术报告 了解完整方法论。
如果你也在自己的任务上遇到过无法复现的准确率数字,欢迎告诉我们——你自己 agent 中那些"时灵时不灵"的具体案例,正是决定我们下一步做什么的关键反馈。提一个 issue 或发起讨论。
附录:理解各项指标
- Mean@k。把同一个任务跑 k 次,报告平均通过率——也就是大多数 benchmark 所说的"准确率"。
- Pass^k。agent 在 全部 k 次独立运行中都成功的任务占比。永远 ≤ Mean@k。它对应的是用户把同一个查询跑两遍时的真实体验。
- Pass@k 在 k 次运行中,至少有一次 成功——这是乐观的评估指标,常见于代码生成类论文。
- 一致性差距。 Mean@k 与 Pass^k 之间的差值,以百分点表示。
关联资料 / 参考文献
- ALTK-Evolve 开源代码库 — github.com/AgentToolkit/altk-evolve
- 技术报告 — arXiv
- 一致性准则演示 —2 分钟视频