
借助 NVIDIA FLARE 实现 Docker、Kubernetes 与 Slurm 上的联邦学习规模化部署
联邦学习(FL)项目通常起步很简单:一个服务器、几个客户端,每个站点一份数据集。但随着项目扩展,核心挑战便从运行算法转向运维共享基础设施。GPU 资源需在任务需要时动态分配,多项研究必须保持隔离,且每个参与机构都必须对自身的数据、密钥及计算策略拥有绝对控制权。
当不同组织依赖的环境各异时,运维复杂度进一步激增。某站点可能使用 Docker 主机,另一处可能运行 Kubernetes 集群,而某研究中心或许通过 Slurm 调度 GPU 工作负载。若要求所有参与者采用统一的基础设施,平台标准化将变成合作的前提,从而形成阻碍。
NVIDIA FLARE 通过将持久化的联邦层与各任务的具体执行过程解耦,解决了这一难题。
FLARE 的双层架构将持久化的联邦服务与任务执行分离开来,允许同一联邦内的各站点选用契合自身基础设施的执行后端——例如某站点用 Docker,另一站点用 Kubernetes,第三站点用 Slurm。各站点保留对本地计算分配的管控权,并可独立管理每项研究所用的数据集、镜像、密钥及调度策略。
NVIDIA FLARE 2.8 已支持 Docker 和 Kubernetes 部署,FLARE 2.9 新增了对 Slurm 的支持。
解耦联邦协调与任务执行
FLARE 部署包含两个运维层。长期运行的服务端和客户端父进程负责维持联邦状态、进行连接认证并协调工作;独立的服务端和客户端任务工作进程则负责执行已提交的 FL 任务。
这种分离支持资源感知的执行方式。父进程保持在线即可,无需占用训练所需的 GPU 资源。当数据科学家提交任务时,各父进程通过其配置的execution平台启动工作进程。工作进程接收任务、使用所需资源、返回结果,并在完成后退出。
任务描述将资源需求与平台细节分离。任务可请求 GPU、完整的可调度 CPU 单元及主机内存。各站点的启动器将这些需求与本地研究配置结合,并将其转化为 Docker 容器、Kubernetes Pod 或 Slurm 资源分配。
这些层级协同工作,确保联邦服务持续可用,同时各站点可按需创建任务工作节点及其资源。
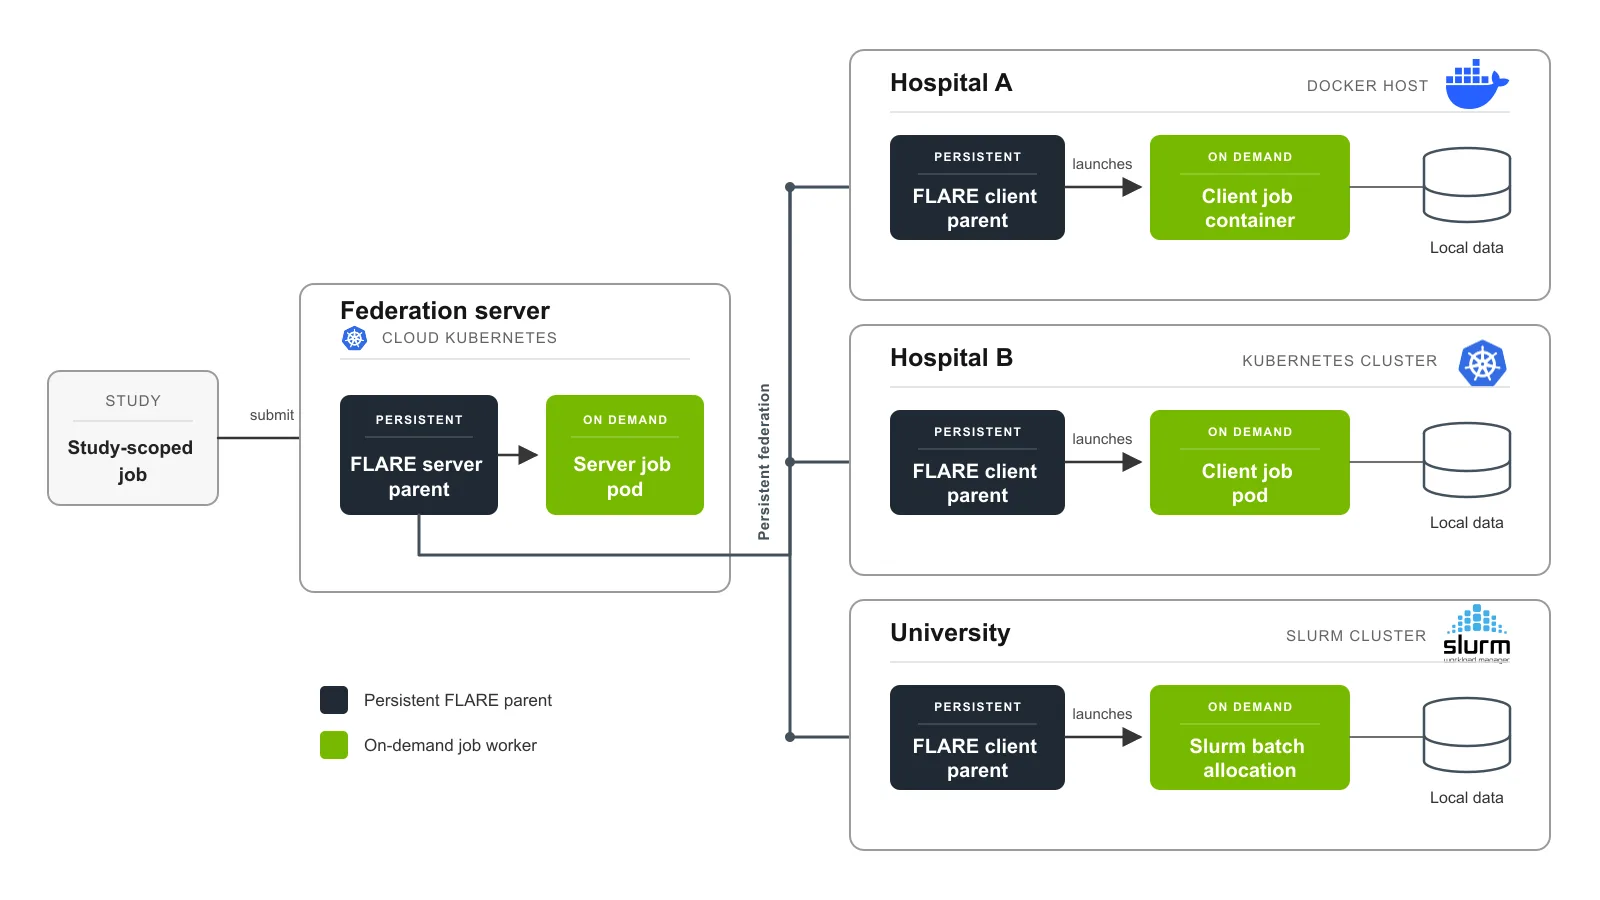
使用 Docker、Kubernetes 和 Slurm 部署任务工作节点
NVIDIA FLARE 与标准的部署和调度系统集成。站点运维人员可选择匹配本地环境的运行时,并负责管理其相关策略。
| 运行时 | 典型环境 | 动态执行单元 | 资源管理方 |
|---|---|---|---|
| Docker | 工作站或单主机站点 | 任务容器 | Docker 主机 |
| Kubernetes | 云端或本地集群 | 任务 Pod | Kubernetes 调度器 |
| Slurm | HPC 或共享 GPU 集群 | 批量分配 | Slurm 调度器 |
Docker:单主机上的容器化执行
Docker 适用于工作站、实验室服务器、边缘系统等单机环境。常驻的 FLARE 服务器或客户端运行在一个由父镜像构建的父容器中;每提交一个作业,FLARE 就会动态启动一个由作业镜像构建的独立容器。
父镜像包含 FLARE 运行时和启动容器所需的组件,而单独的作业镜像则可以包含训练框架、模型代码和应用依赖。站点可以通过 NVIDIA Container Toolkit 把申请的 GPU 暴露给作业容器,并利用 Docker 设置来配置共享内存、挂载、网络等主机层面的需求。
把父镜像和作业镜像分开也让更新变得更简单:基础设施负责人可以保持父环境稳定,研究人员则可以在遵守站点镜像和代码审批策略的前提下,独立更新自己的训练环境。
用 Kubernetes 动态调度作业 Pod
在 Kubernetes 上,通过 Helm chart 把每个常驻的 FLARE 服务器或客户端部署为父 Pod;每提交一个作业,父 Pod 就会创建一个独立的服务器或客户端作业 Pod,由 Kubernetes 调度器根据其 CPU、内存、GPU、存储和放置需求分配到合适的节点。
这种方式让 FLARE 作业可以直接复用大家熟悉的 Kubernetes 能力,比如 namespace、ServiceAccount、Secret、持久卷、node selector、toleration 和准入策略。例如,一项研究可以用 pod 模板选择 H100 节点,另一项研究则使用不同的节点池。
平台运维负责为集群配置存储类、镜像仓库凭证、网络策略、GPU 支持以及基于角色的访问控制(RBAC),FLARE 则借助这些能力来启动和监控作业 Pod。
用 Slurm 调度 GPU 和多节点资源
许多高校、科研机构和企业计算环境都使用 Slurm 来共享 GPU 集群。FLARE 的 Slurm 启动器会把每个服务器或客户端作业 worker 作为一个批处理作业提交,由 Slurm 选择计算节点,并强制执行申请的 GPU、CPU、内存、分区、账户、服务质量(QoS)和时间限制。
任务可指定单节点或多节点。FLARE 负责提交资源分配、监控其状态、传递成功或失败信息,并在必要时取消任务。启动器支持裸机执行(无沙箱)、Pyxis/Enroot 容器以及 Apptainer 容器。
Slurm 仍是资源管理的权威机构。其账户、关联关系、分区、QoS 规则、cgroups、文件系统权限及设备控制决定了分配资源的使用范围。这保留了集群管理员在非联邦学习工作负载中已有的运维模型。
NVIDIA FLARE 提供参与者身份验证、安全通信和授权功能,而各站点的执行平台则负责实施本地资源和负载策略。站点运营人员配置主机和集群安全策略、批准的镜像、密钥和访问控制,并针对所选运行时验证工作负载隔离性。
通过研究实现实验隔离
共享基础设施引入了另一个问题:多个团队如何在不混合其用户、任务或数据的情况下运行 FL 实验?
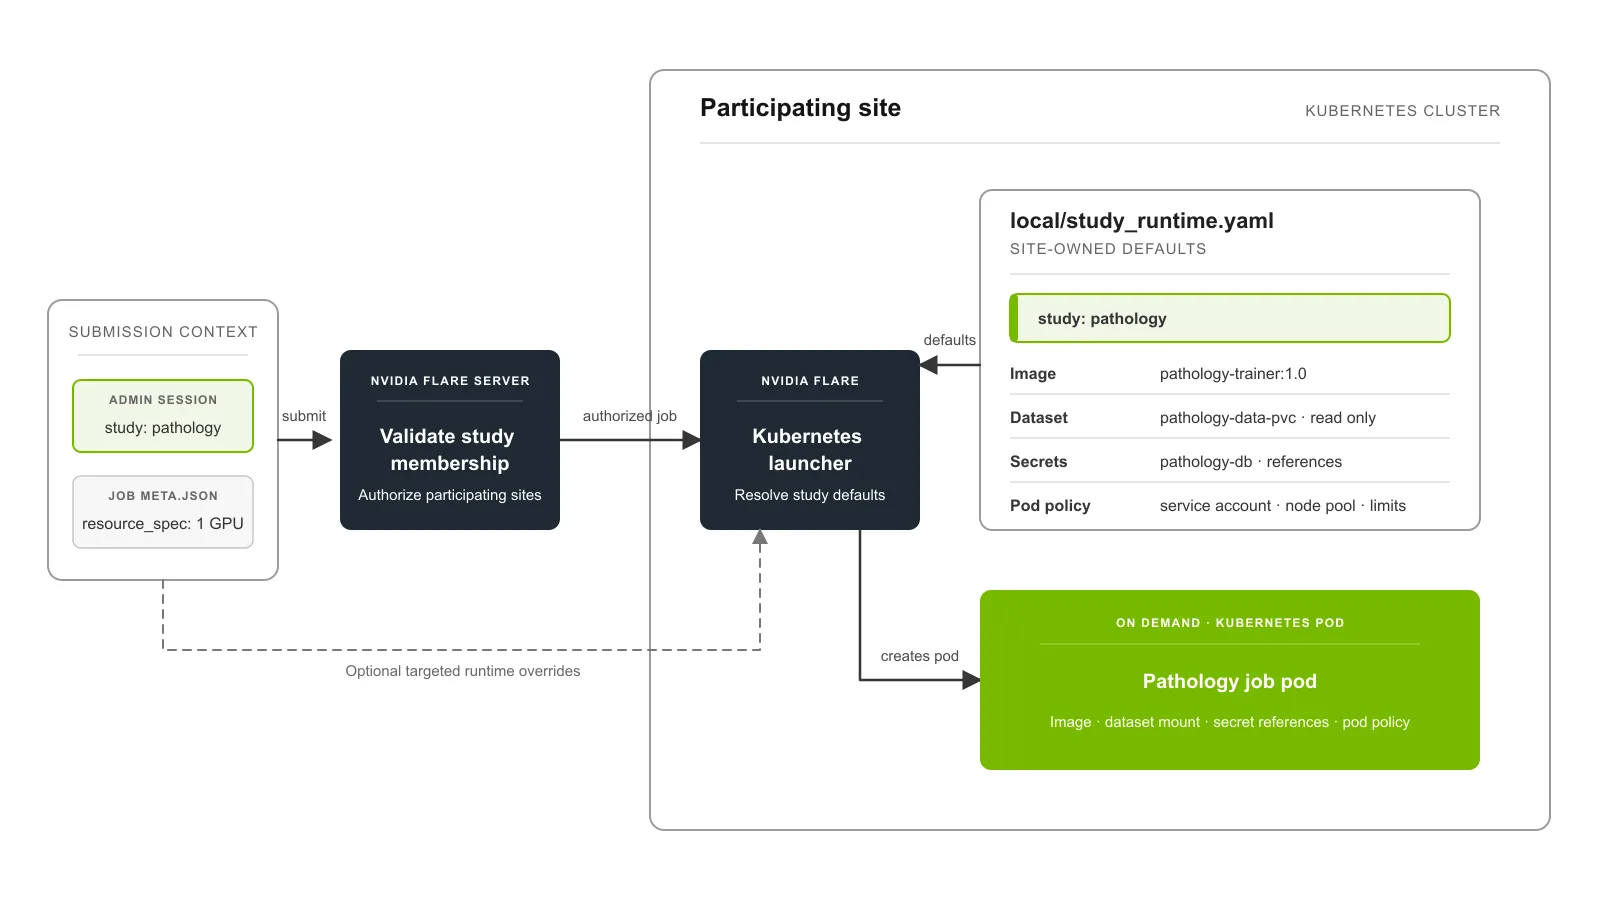
FLARE 研究(Study)在一次部署内提供逻辑上的多租户边界。每项研究定义其参与的客户站点以及可为该研究开启会话的管理员用户。基于研究的运维操作将任务可见性、客户状态、提交目标和部署映射限制在当前研究范围内。
研究边界在每个参与站点持续生效。站点自有的 local/study_runtime.yaml 文件将研究映射到其本地可用资源。根据运行时的不同,此配置可定义:
- 数据集挂载
- 环境变量
- 基于密钥的环境变量和文件挂载
- 站点批准的默认任务镜像
- Kubernetes Pod 模板
- Docker 运行时设置
- Slurm 沙箱、分区、账户及 QoS 策略
数据科学家通过开启基于研究的会话来选择特定研究,从该会话提交的任务将继承研究上下文。任务不能随意选择本地数据集路径或提供密钥值。FLARE 服务器在任务到达站点前验证研究成员资格,而站点运营人员控制从该研究到本地资源的映射。
以下精简的 Kubernetes 示例将一项病理学研究映射到站点自有的数据卷和数据库凭证。配置中包含对 Secrets 的引用,而非其具体值。
format_version: 2

studies:
  pathology:
    container:
      image: registry.example.com/pathology-trainer:1.0
    datasets:
      slides:
        source: pathology-data-pvc
        mode: ro
    secret_env:
      DB_USER: {source: pathology-db, key: username}
      DB_PASSWORD: {source: pathology-db, key: password}
当病理学作用域会话提交的任务到达该站点时,Kubernetes launcher 会匹配 studies.pathology 条目。Launcher 以该 study 的镜像作为本地默认值,并将 pathology-data-pvc 卷以只读方式挂载到任务容器内的 /data/pathology/slides。挂载路径由 study 和 dataset 名称推导为 /data/<study>/<dataset>。
secret_env 条目在 pod 规格中转换为 Kubernetes secretKeyRef 引用。启动 pod 时,Kubernetes 注入 pathology-db Secret 中的 username 和 password 值。这样既将凭证保留在站点秘密存储中,又为 study worker 提供了所需的环境。
Study 适用于共享同一 FLARE 服务器和公钥基础设施(PKI)、但需要在实验之间进行逻辑隔离的组织。如果组织需要独立的 PKI、独立的基础设施管理员,或希望隔离故障影响范围,则应使用独立的 FLARE 部署。
整合异构联邦
在上文图 1 所示的联邦中,一项病理学研究连接了两家医院和这所大学,使用 GPU worker 以及各站点批准的镜像和数据集。另一项结局研究只包含两家医院,使用 CPU worker 来分析结构化临床数据。
两个研究共享联邦的持久化服务。研究成员资格决定哪些站点参与,而每个站点的研究配置则为其 worker 提供数据集、镜像、secret 和调度设置。研究者从相应的研究会话提交作业,本地 launcher 会应用这些设置。
提交作业
FLARE 2.9 在作业的 `meta.json` 中的 `resource_spec` 字段支持可移植的 GPU、CPU 和主机内存配置。可移植的键包括 `num_of_gpus`、`num_of_cpus` 和 `memory`。CPU 值代表可调度的整数 CPU 单元,内存则以 Mi、Gi 或 Ti 为单位,使用正整数表示。 `@default` 条目将单一资源配置文件应用于所有目标站点,包括服务器。具名客户端或服务器条目只需提供与默认值不同的参数。在这个示例中,两家医院继承 1 个 GPU、4 个 CPU 单元和 64 GiB 内存。大学站点覆盖了 GPU 数量,而服务器将 GPU 数量覆盖为 0。两者均继承相同的 CPU 和内存要求。
{
  "resource_spec": {
    "@default": {
      "num_of_gpus": 1,
      "num_of_cpus": 4,
      "memory": "64Gi"
    },
    "server": {"num_of_gpus": 0},
    "university": {"num_of_gpus": 8}
  }
}
各启动器会将解析后的值转换为原生设置。Docker 将 4 个 CPU 单元转换为 `nano_cpus=4000000000`,将 64 GiB 转换为以字节为值的 `mem_limit`,并应用 GPU 设备请求。Kubernetes 设置匹配的 CPU 和内存请求与限制,并添加 GPU 请求。Slurm 输出 `--cpus-per-task=4`、`--mem=65536M` 以及相应的 GPU `--gres` 值。
数据科学家打开一个作用域限定的研究会话,只需向 FLARE 服务器提交一次作业,服务器便会将其部署到该研究的所有参与者站点。在每个站点,配置好的启动器应用该站点的本地运行时默认设置并创建工作进程。FLARE 协调整个联邦学习工作流并报告作业状态,而 Docker、Kubernetes 和 Slurm 则负责管理本地资源。
`launcher_spec` 用于处理特定后端的拓扑和策略,例如 Slurm 节点布局或特定于运行时的镜像。研究运行时配置为每个站点提供经过批准的本地默认设置,涵盖镜像、数据集、密钥和执行策略。
功能优势
联邦学习基础设施无需在所有参与者中保持一致。FLARE 将持久化的联邦服务与动态启动的作业工作进程分离,使每个站点可以选择使用 Docker、Kubernetes 或 Slurm。研究通过作用域限定的成员资格以及由站点自行管理的数据、密钥、镜像和调度策略映射来实现定制化。这些能力让同一个联邦学习项目能够跨越本地系统和云端,而无需强制所有机构使用同一平台。各参与方可以在任务执行时按需分配 GPU 及其他资源,继续沿用现有的运维管控体系,并在独立治理的数据上运行多项研究。异构基础设施由此成为联邦架构的组成部分,而非扩展的障碍。
如需入门,请访问 NVIDIA FLARE 文档 和 NVIDIA FLARE GitHub 代码仓库。