
NVIDIA Groq 3 LPX 确定性执行如何驱动 Vera Rubin 平台上高能效的高交互推理
Groq 3 LPX 的确定性执行模型让 LPU 编译器能够制定一份精确的执行计划:每份数据何时移动到哪个计算单元、每个操作具体在哪个时钟周期执行,都能精确到拍。这一模型可扩展到机架中的全部 256 颗 LPU 芯片,从而实现长上下文下的超高速交互,并支撑起一系列借助这种确定性实现的功耗管理技术。
LPU 编译器生成工作负载的执行计划后,就能预测该计划中每个时钟周期的电流消耗。这进而催生了两种互补的技术:
- Preemptive Power(PEP,预判式供电):在功耗需求变化到来之前,提前让供电系统做好准备
- Clock Period Synthesis(CPS,时钟周期合成):调控功耗需求上升和下降的陡峭程度
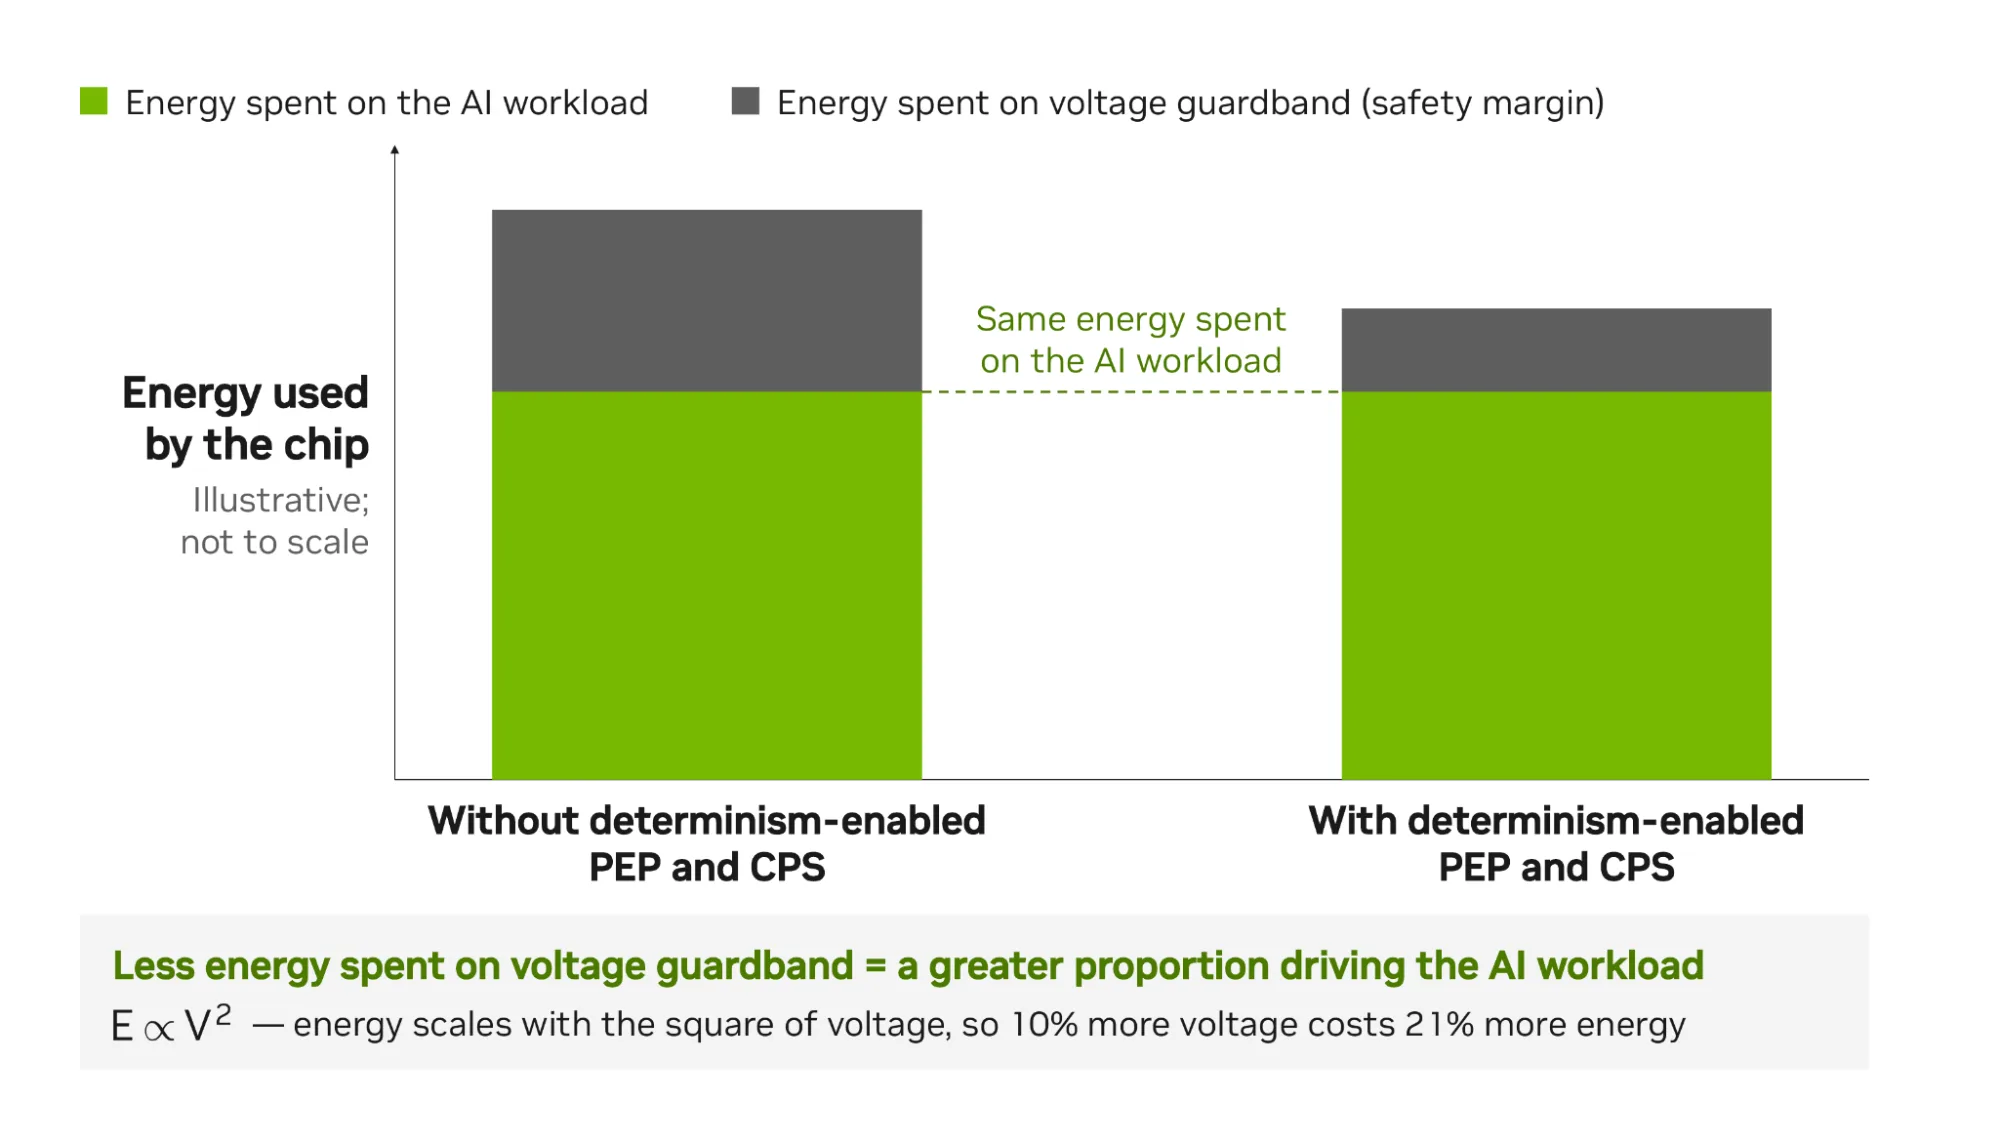
PEP 和 CPS 协同工作,可以缩小所有芯片都必须持续预留的“电压保护带”(即电气安全余量)——这部分功耗并不直接用于 AI 工作负载。缩小电压保护带,意味着宝贵的功率预算中能有更大比例真正花在工作负载上。
如何在需要时精确为 AI 工作负载供电,面临哪些挑战?
运行 AI 工作负载时,芯片会执行一系列指令,从简单的数据重排到复杂且耗能的矩阵乘法不等。几乎所有芯片都包含硬件特性,允许在工作负载运行期间,随着资源可用而在多种操作之间动态切换。这种灵活性意味着高计算强度的操作可能在任意时刻被调度执行。因此,向芯片供电的系统必须按此设计。
支撑 AI 工作负载的矩阵乘法和向量乘法涉及短时间内大量晶体管切换,从而在纳秒尺度上增加芯片的电流需求。芯片会从最近的可用电源——即紧邻芯片的去耦电容(或称去耦电容)——汲取额外电流。这些电容放电会导致芯片电压下降。
芯片所在电路板确实配备了电压调节器,其核心职责是将芯片供电电压稳定在设定目标上。但由于电感的存在,它无法即时响应电流的剧烈上升。不过,调节器输出的电流最终会跟上芯片的实际需求,使电压得以恢复。
这些短暂的电压跌落,归根结底是由 AI 工作负载引起的电流需求急剧变化所导致的,业内称之为“电压降”(voltage droop)。其幅度取决于电流变化量以及 di/dt(电流变化率)。在其他条件相同的情况下,di/dt 越大,电压降越明显;反之,若相同的电流绝对变化量发生在更长的时间跨度内,di/dt 会较低,电压降也随之减小。通常情况下,这些电压降不会造成问题。然而,所有芯片都有一个最低工作电压(Vmin),一旦低于此阈值,芯片将停止正常运作并产生错误结果。
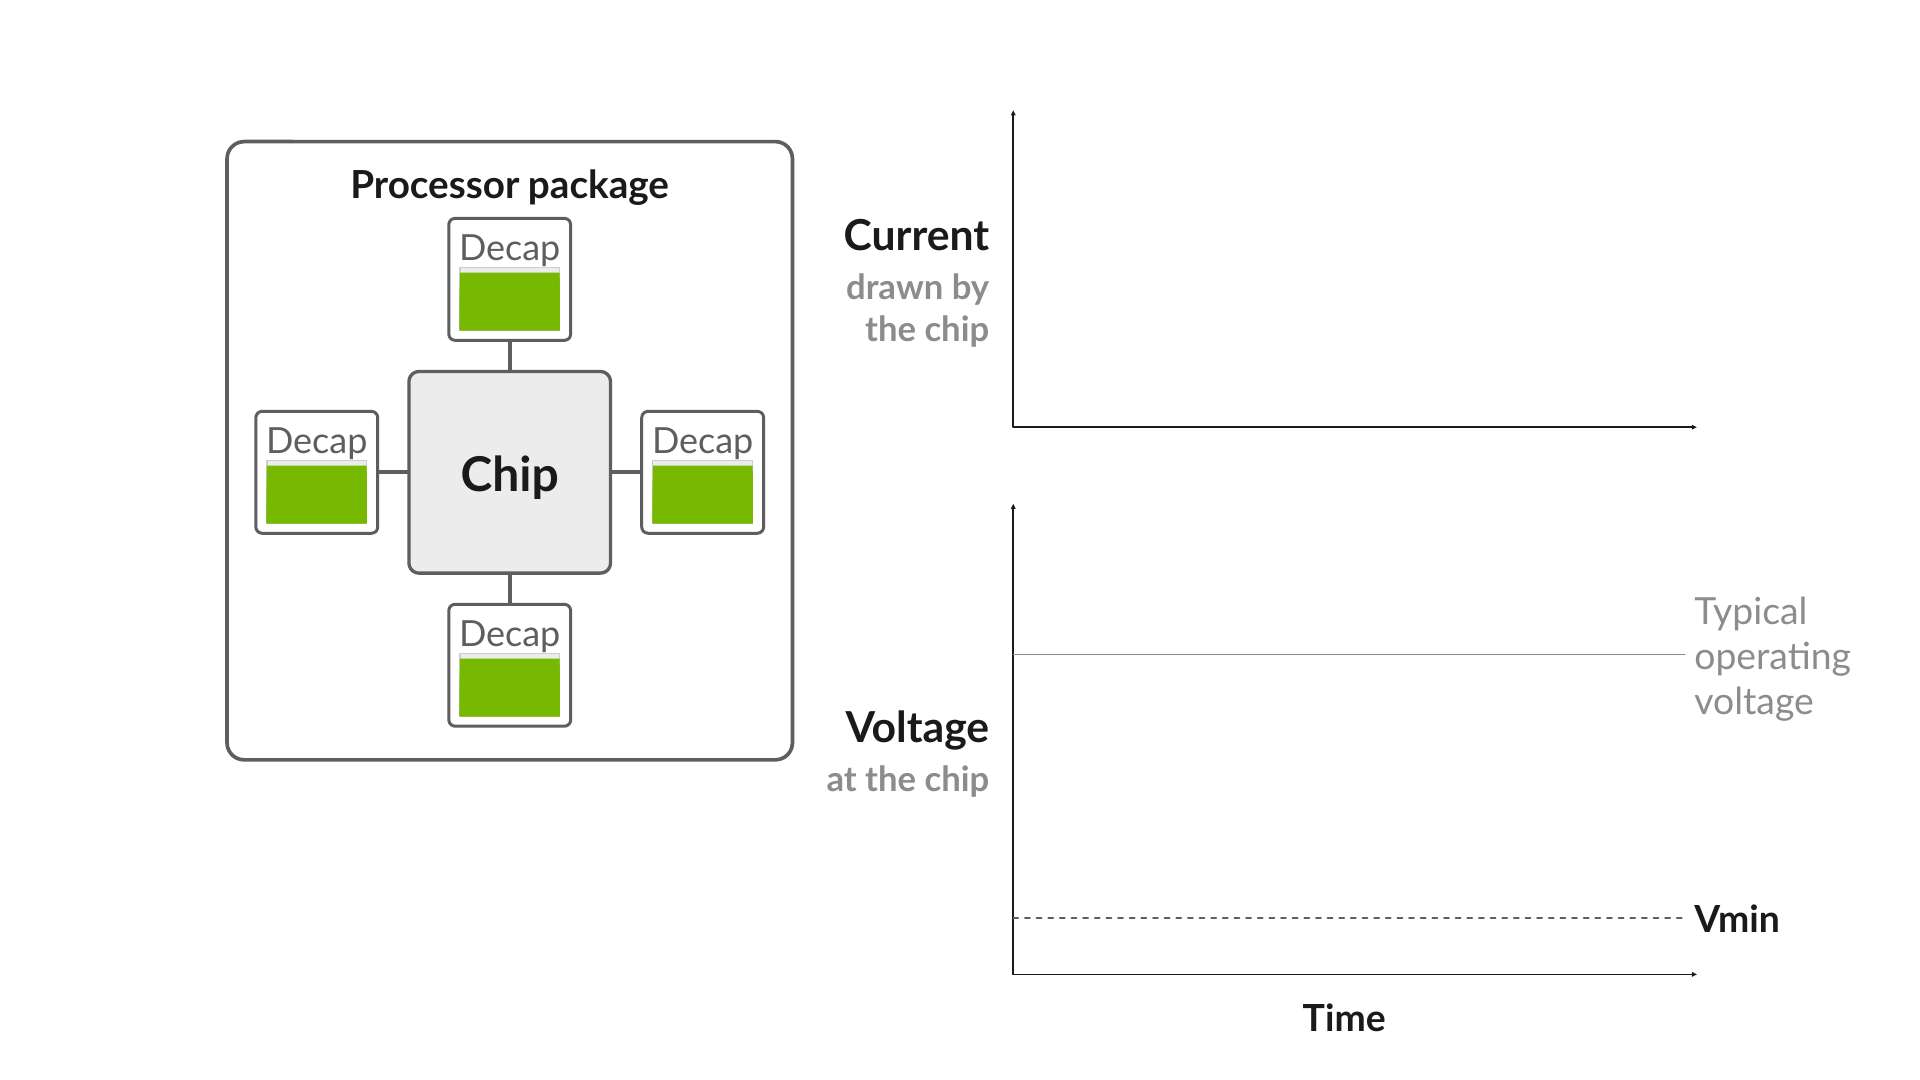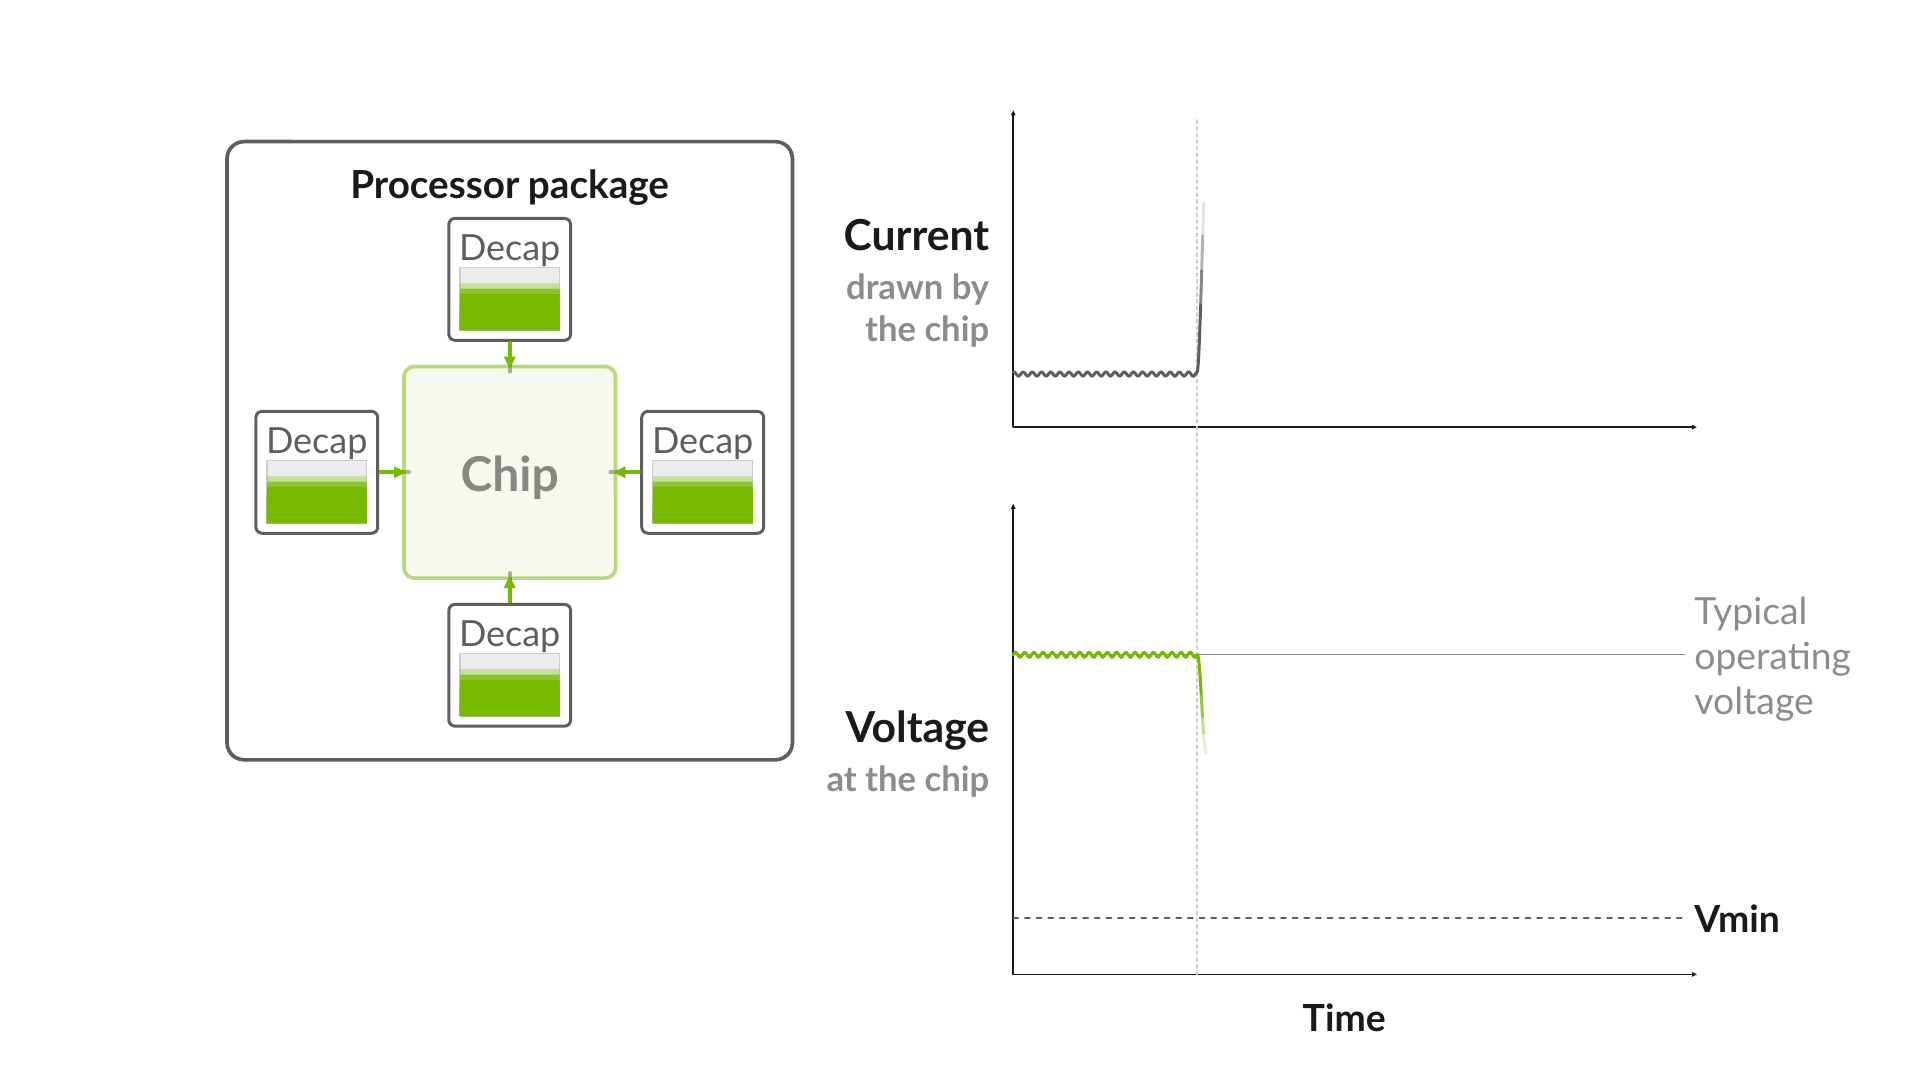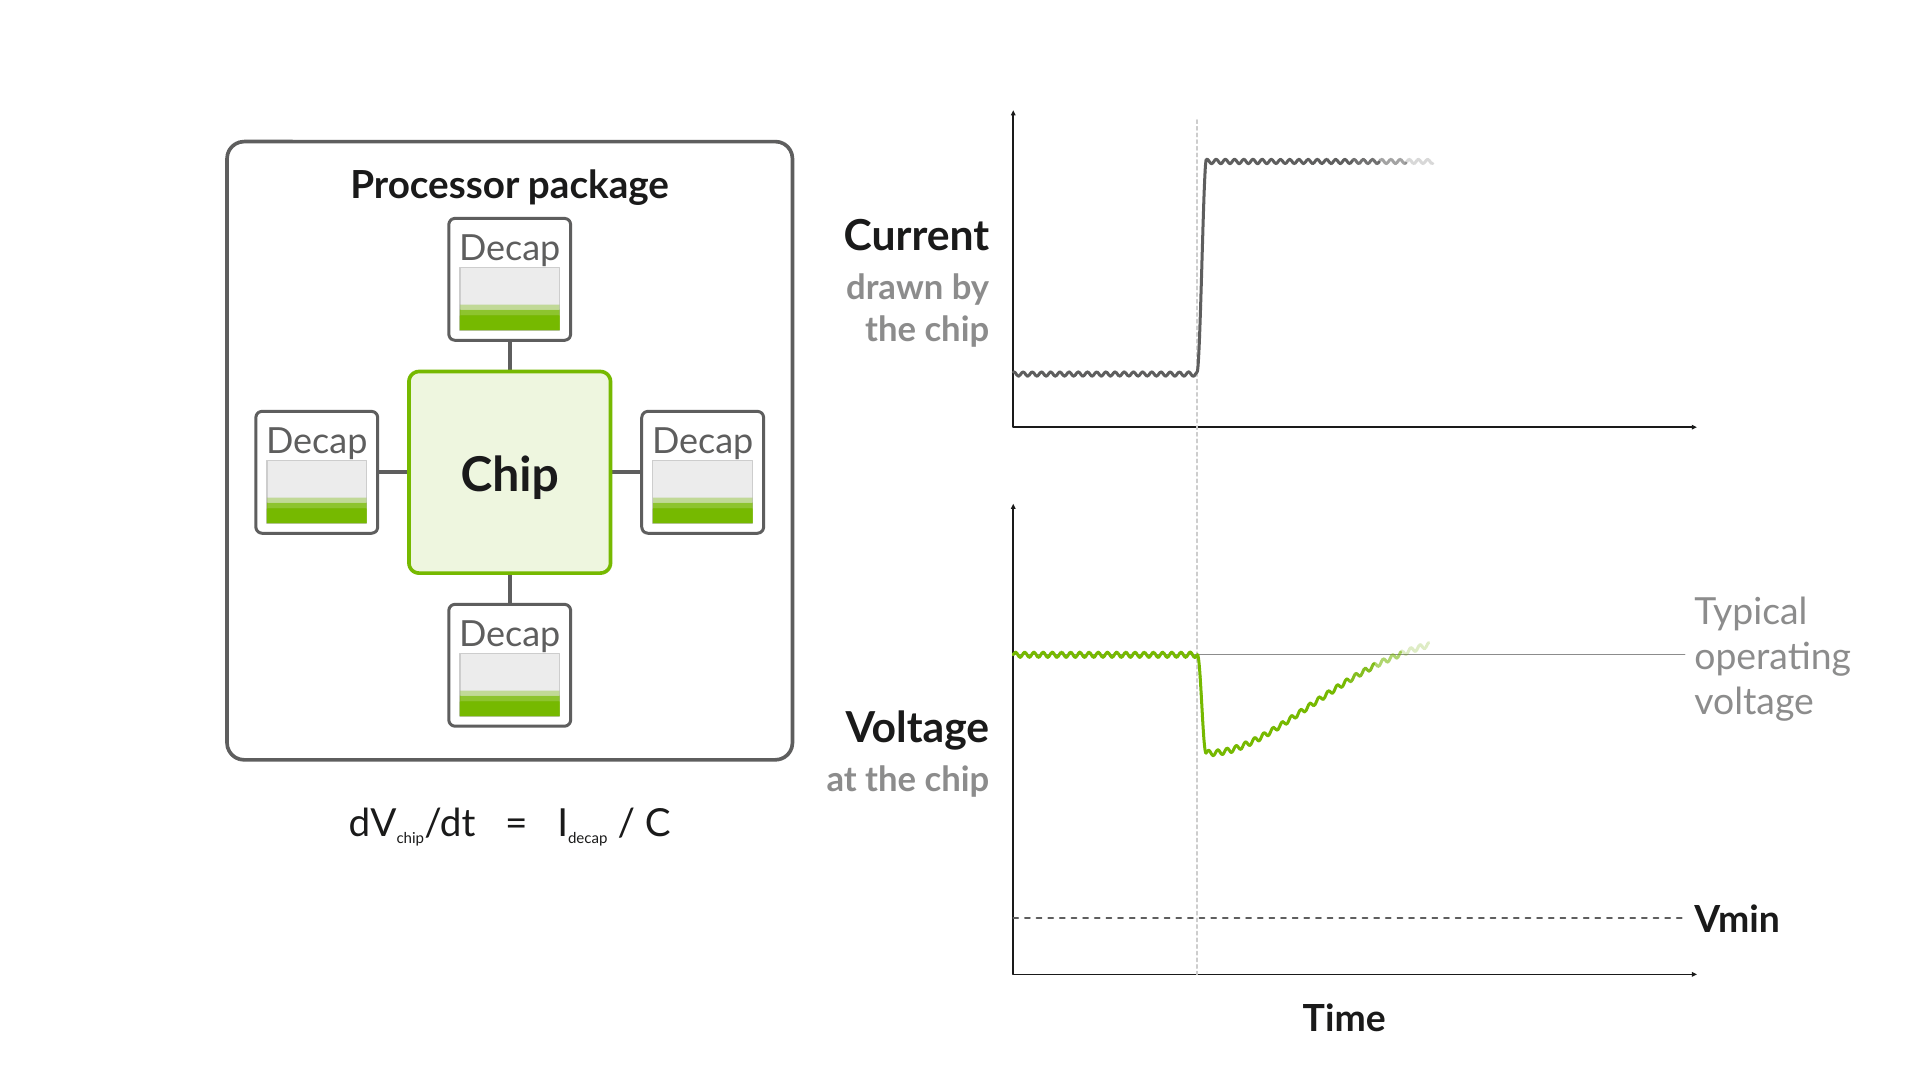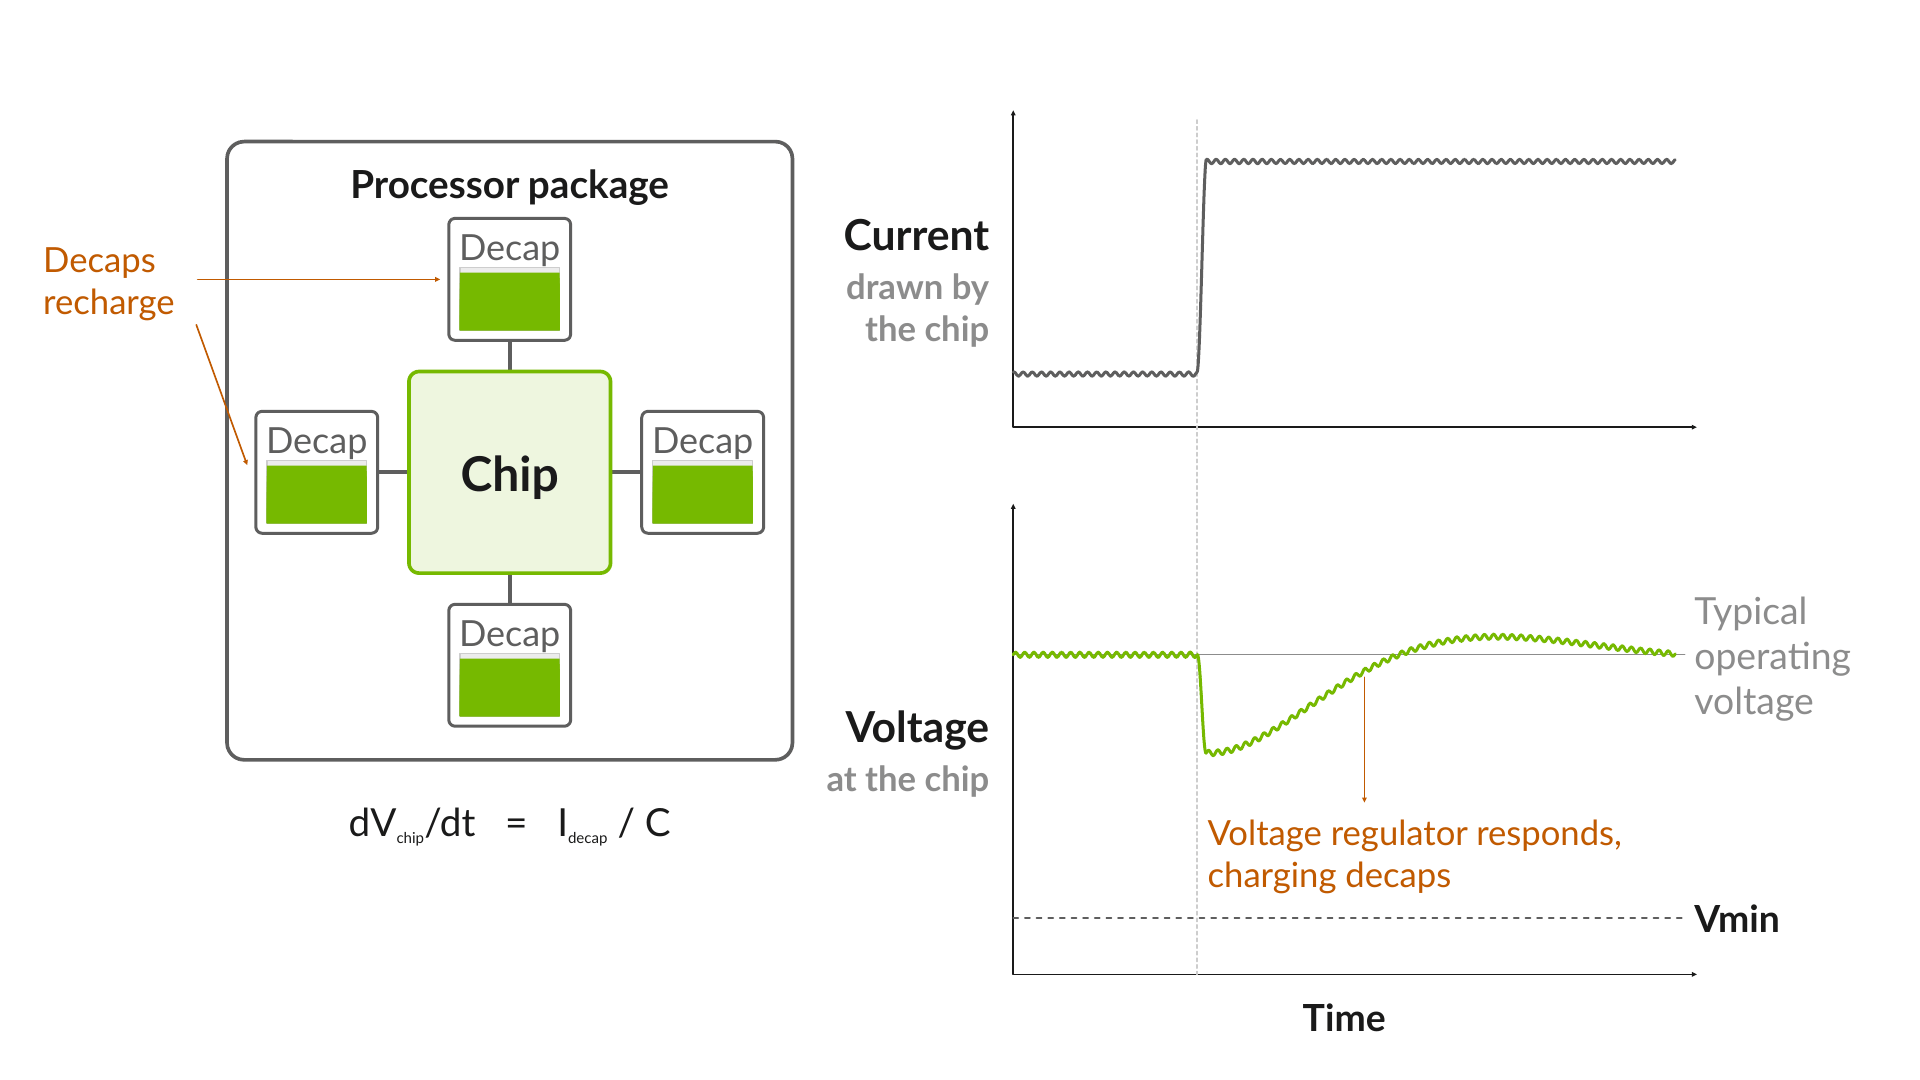
为降低出现这种最坏情况的概率,芯片通常会设置电压保护裕量(voltage guardband),即在瞬态及最恶劣条件下,依然能提供足够的供电电压余量,确保芯片获得所需的最低电压。大多数时候,为维持这一保护裕量而消耗的功率实际上是过剩的。此外,功耗与电压的平方成正比,因此电压高出 10% 意味着持续多消耗 21% 的功率。
NVIDIA Groq 3 LPX 的周期精确调度如何让当前算力需求变得可预测?
Groq 3 LPX 的确定性执行模型可以在 AI 负载开始运行之前,就为其制定好完整的执行计划,涵盖计算操作和数据搬运。单个 LPU 加速器包含的硬件模块种类不多,每种都能以可预测的高速度执行最常见操作:
- MXM 负责矩阵乘法
- VXM 负责向量运算
- SXM 负责转置和形状变换
单个加速器还配备了让这些计算单元精确同步到时钟周期的硬件。内存方面,每颗芯片都采用无层级的片上 SRAM bank。在 LPX 系统层面,各 LPU 之间直接互联,不经过任何中间环节,数据传输时间因此更可预测。
确定性把这一切硬件能力串联起来:无论是单次计算、内存读取还是芯片间通信,每次运行所需的时钟周期数都完全一致。编译器可以利用这一点,提前规划数据在各个计算单元之间的搬运时机,让数据在需要的时间和地点准时到位。这份计算与数据搬运计划还让编译器能够提前化解常见的资源冲突,比如两个硬件单元同时写同一个内存 bank 的情况。
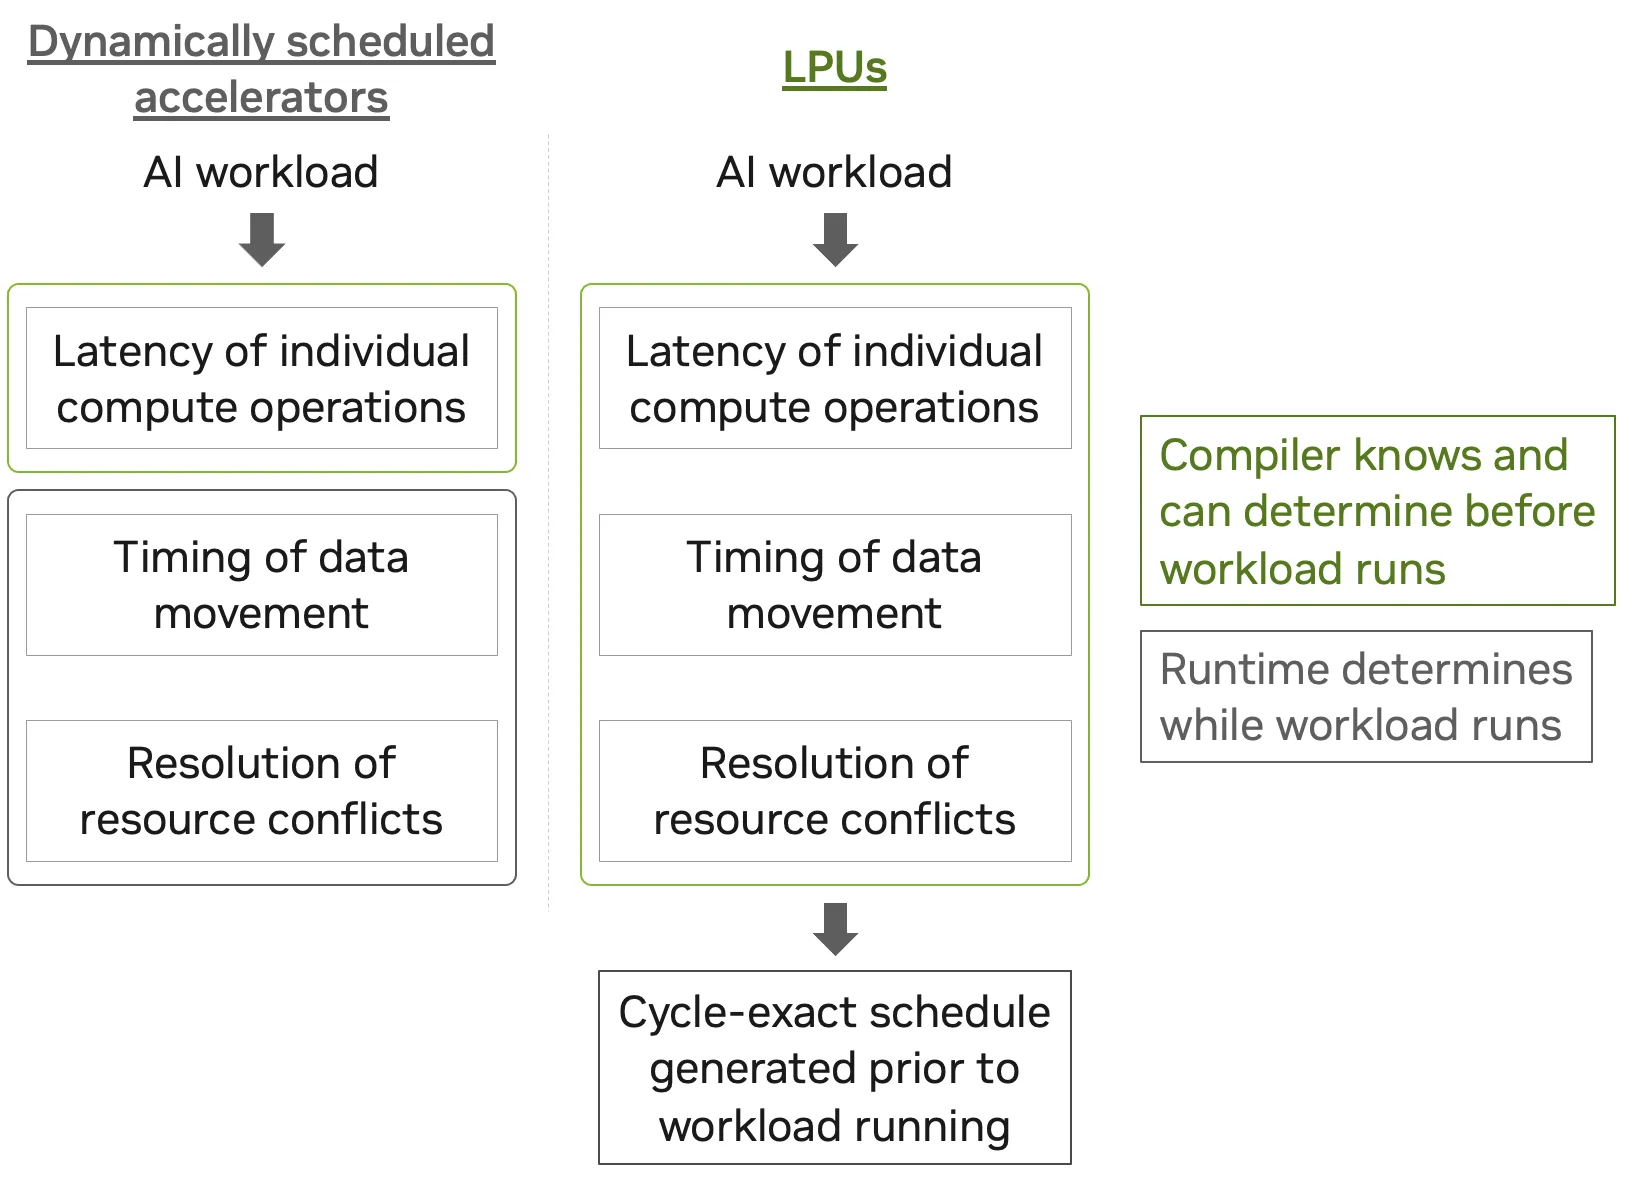
这种逐周期精确的调度方案,使得计算负载随时间变化的电流需求成为可能。编译器可在时钟周期层面预估系统电流消耗。
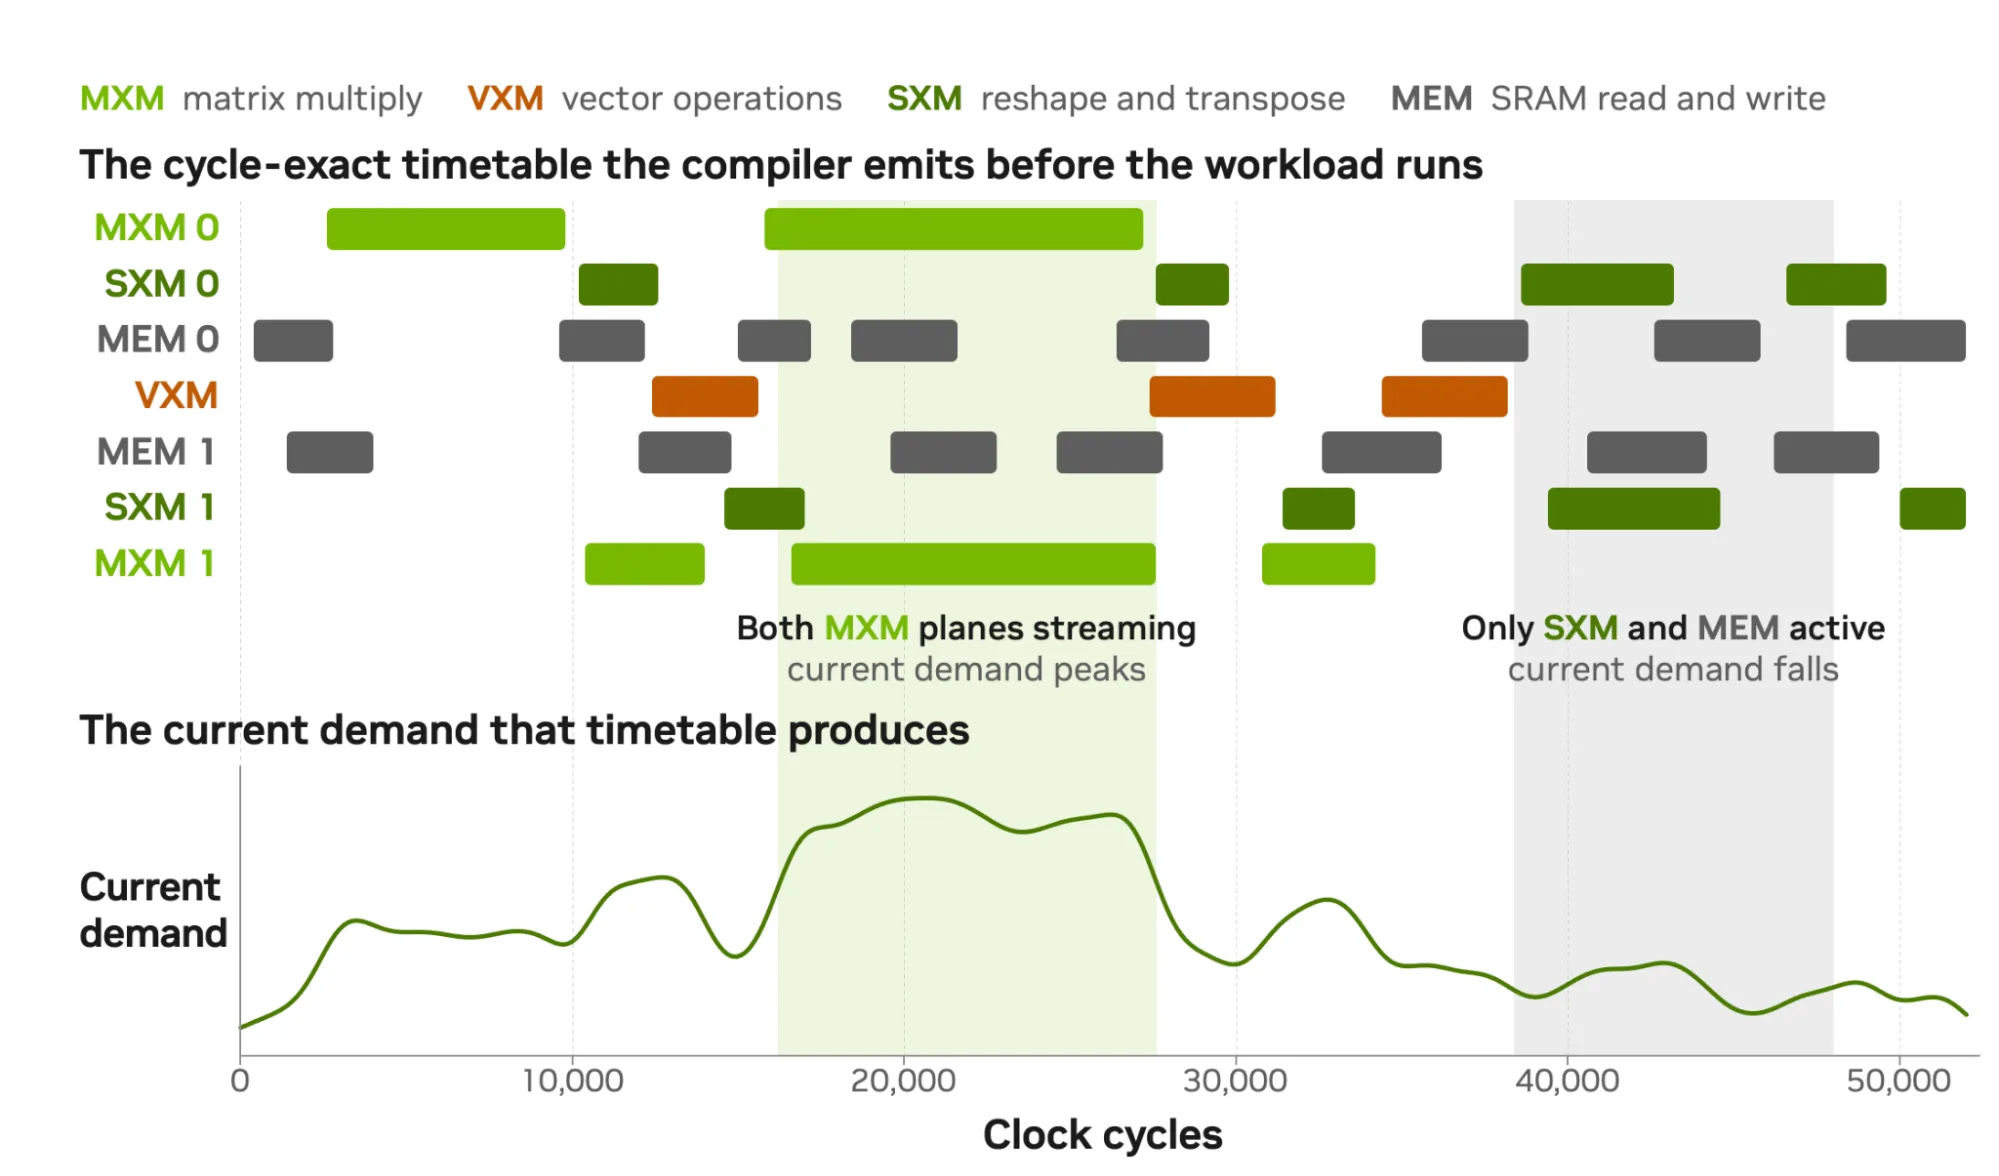
执行模型如何实现主动电压和时钟控制?
周期精确的调度及其产生的电流需求曲线,使 Groq 3 LPX 能够减小电压跌落(voltage droop),并以更小的电压余量(guardband)运行。由于编译器能精确到时钟周期地预判电流需求何时上升、何时下降,它可提前对供电系统进行准备,并借助互补的 PEP 和 CPS 技术来平滑最剧烈的电流需求波动。
- PEP 是芯片向供电网络(PDN,即为 LPU 提供电力物理电子系统)下发指令以改变输出电压的机制。因为编译器清楚电流会在哪些周期出现尖峰,它足够提前调度这些指令,使得在电流需求真正到来之前,供给电压已经处于调整状态。这样,去耦电容需要补偿的缺口更小,电流快速上升时芯片的电压下跌也更平缓。
- CPS 允许编译器将工作负载中的单个时钟周期缩短或延长。之所以能做到逐周期调度,得益于 Groq 3 LPX 的伪同步时钟系统:该系统保持芯片间时钟同步,同时保持片内各计算单元同步。与 PEP 相比,CPS 能对电流最剧烈的变化实施更细粒度的控制。具体来说,电流尖峰最高的那些周期可以被拉长,从而降低 di/dt(电流随时间变化率)。
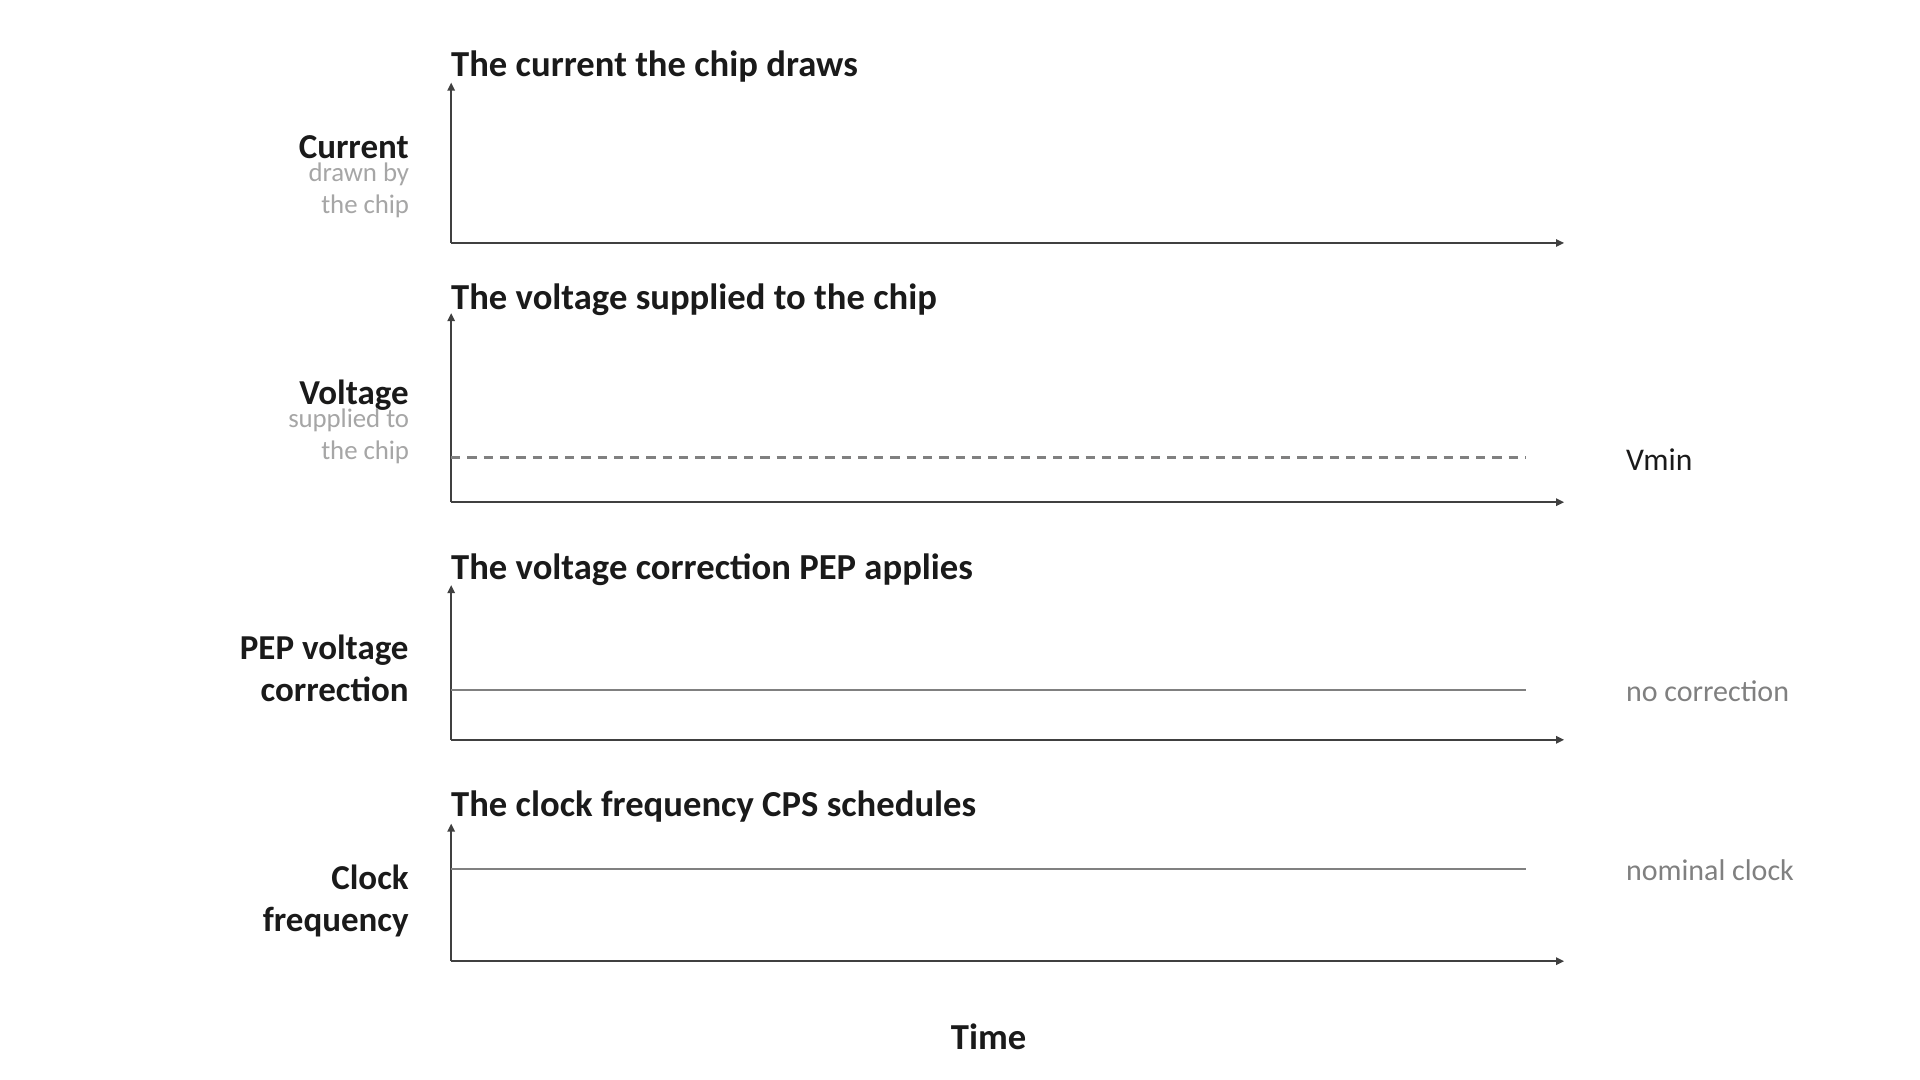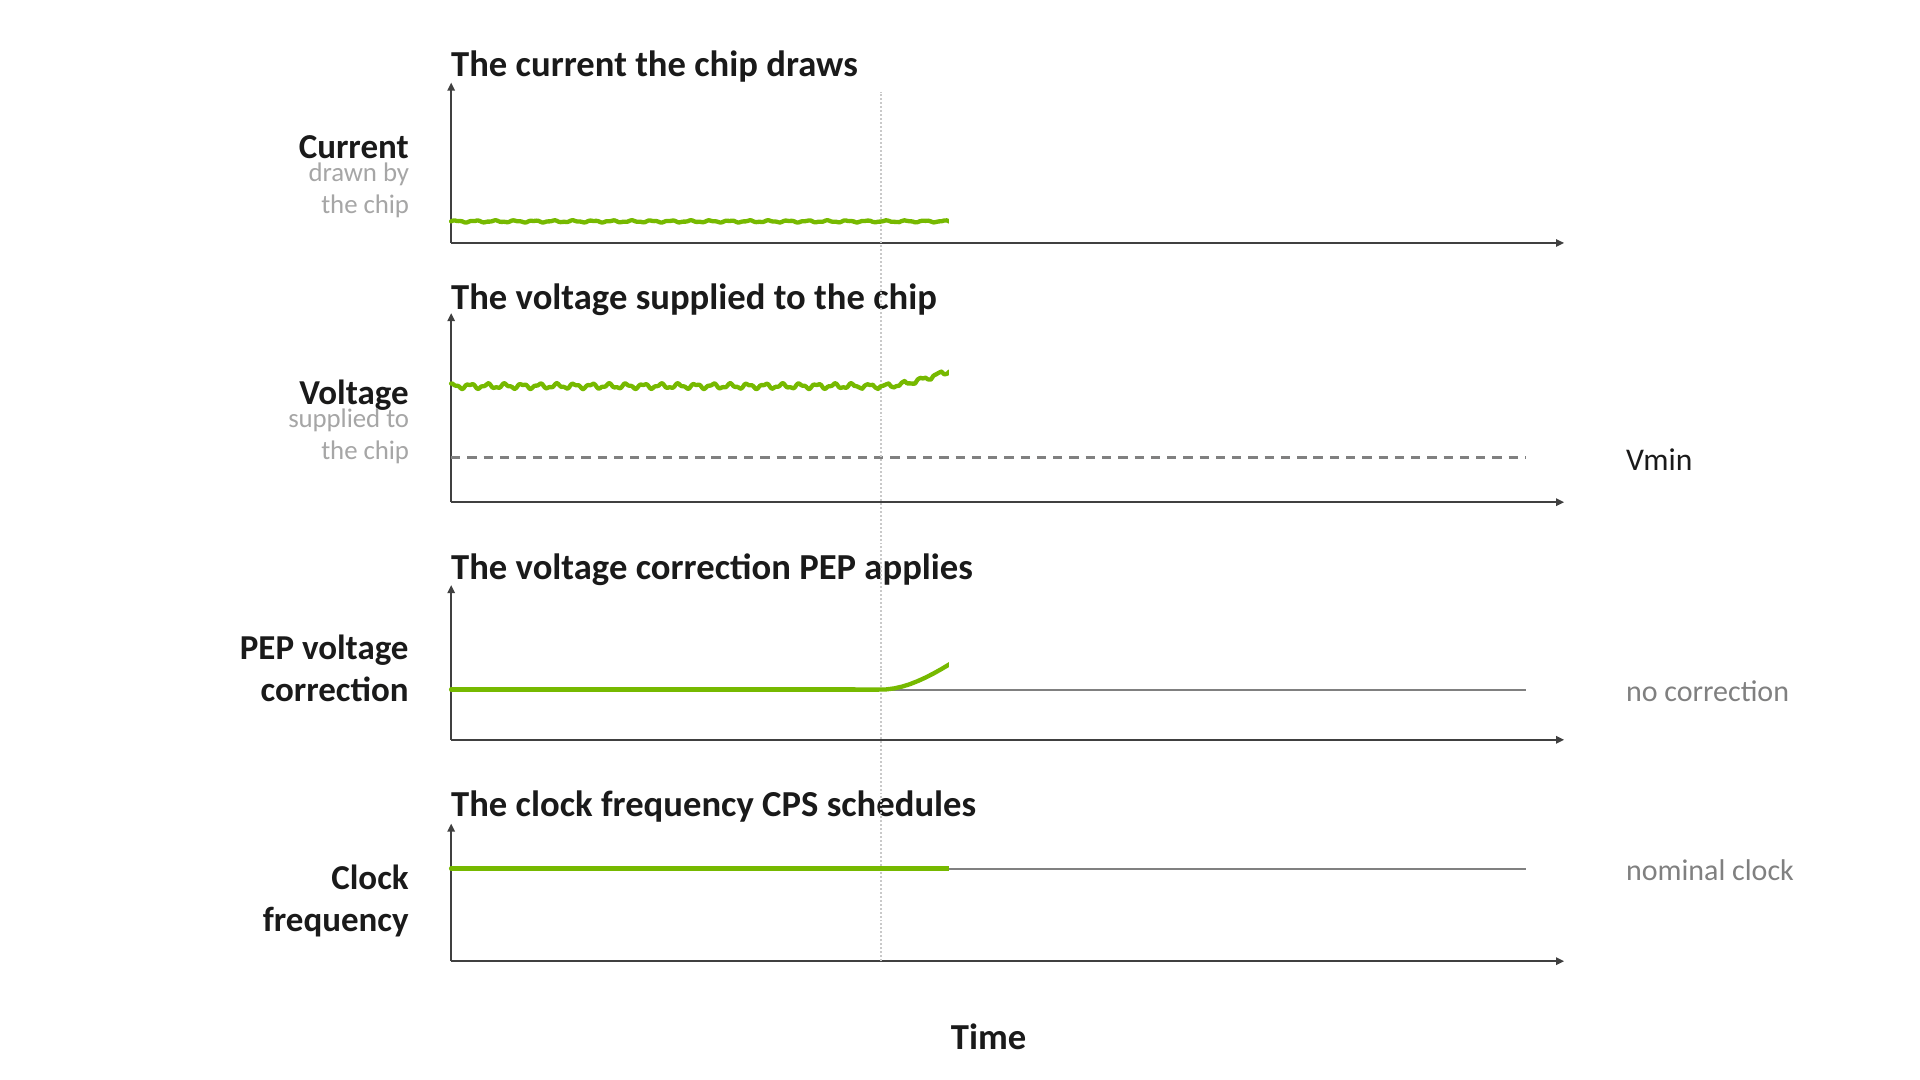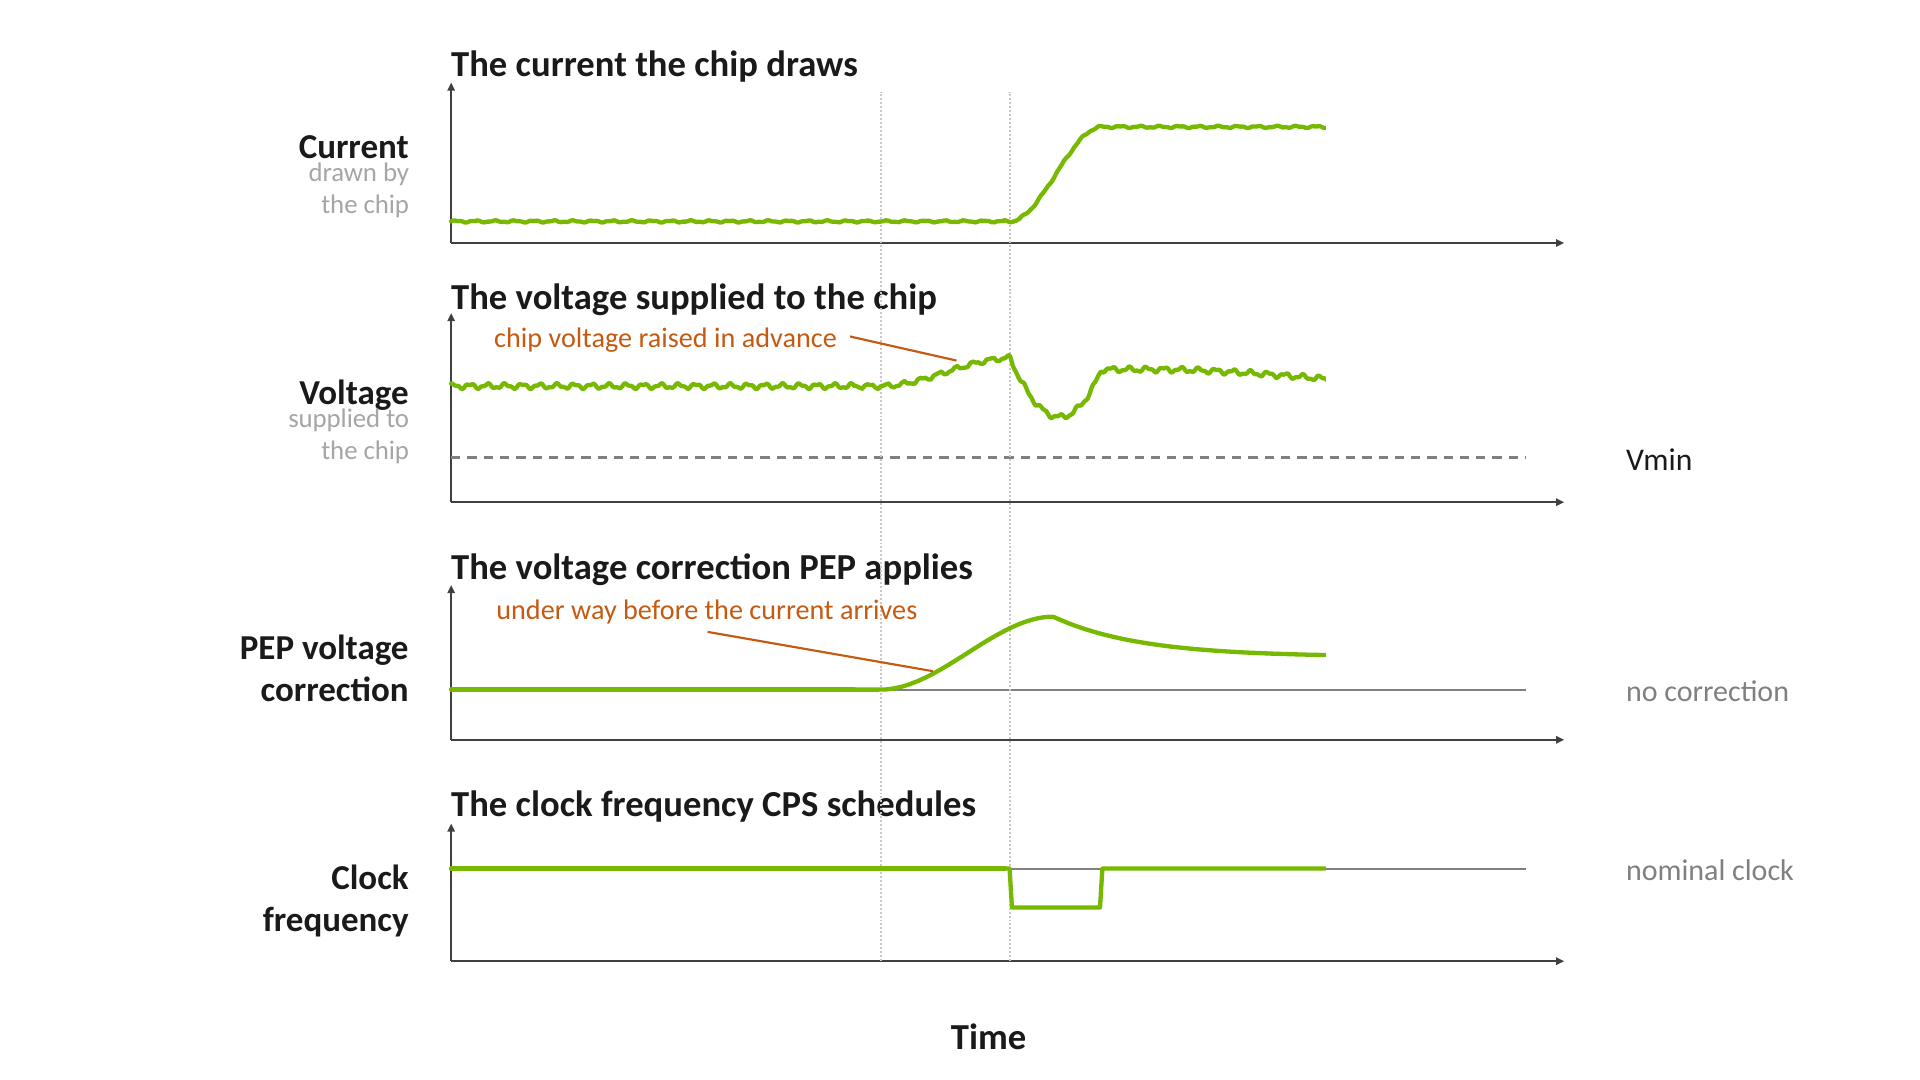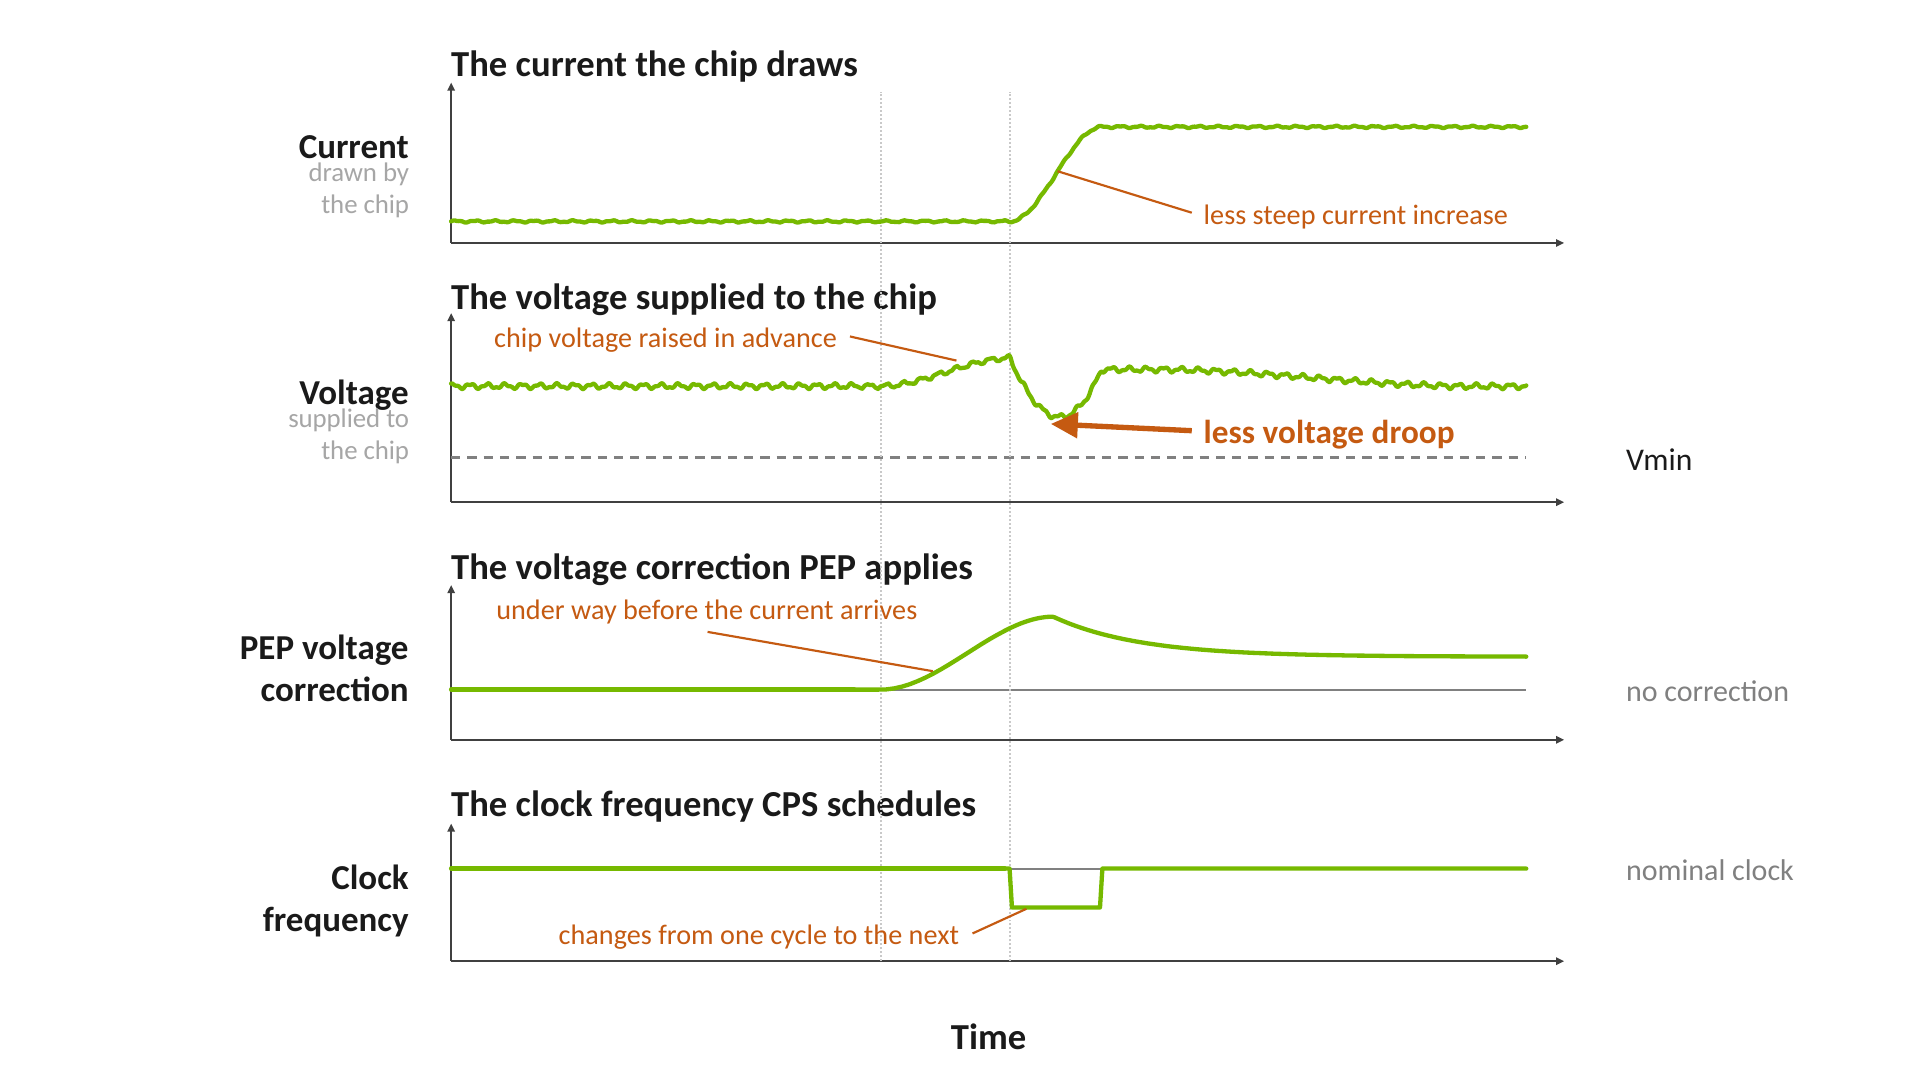
PEP 和 CPS 相结合,让编译器能够调度电信号甚至时钟周期的长度,从而减少电压跌落。在 Groq 3 LPX 系统上的内部测试表明,这种方式可将电压跌落降低 60% 以上。据估算,电气系统为 AI 工作负载持续提供的基准电压可以降低高个位数百分比。由于功耗与电压的平方成正比,这将带来更高百分比的功耗下降——而且完全不影响工作负载。
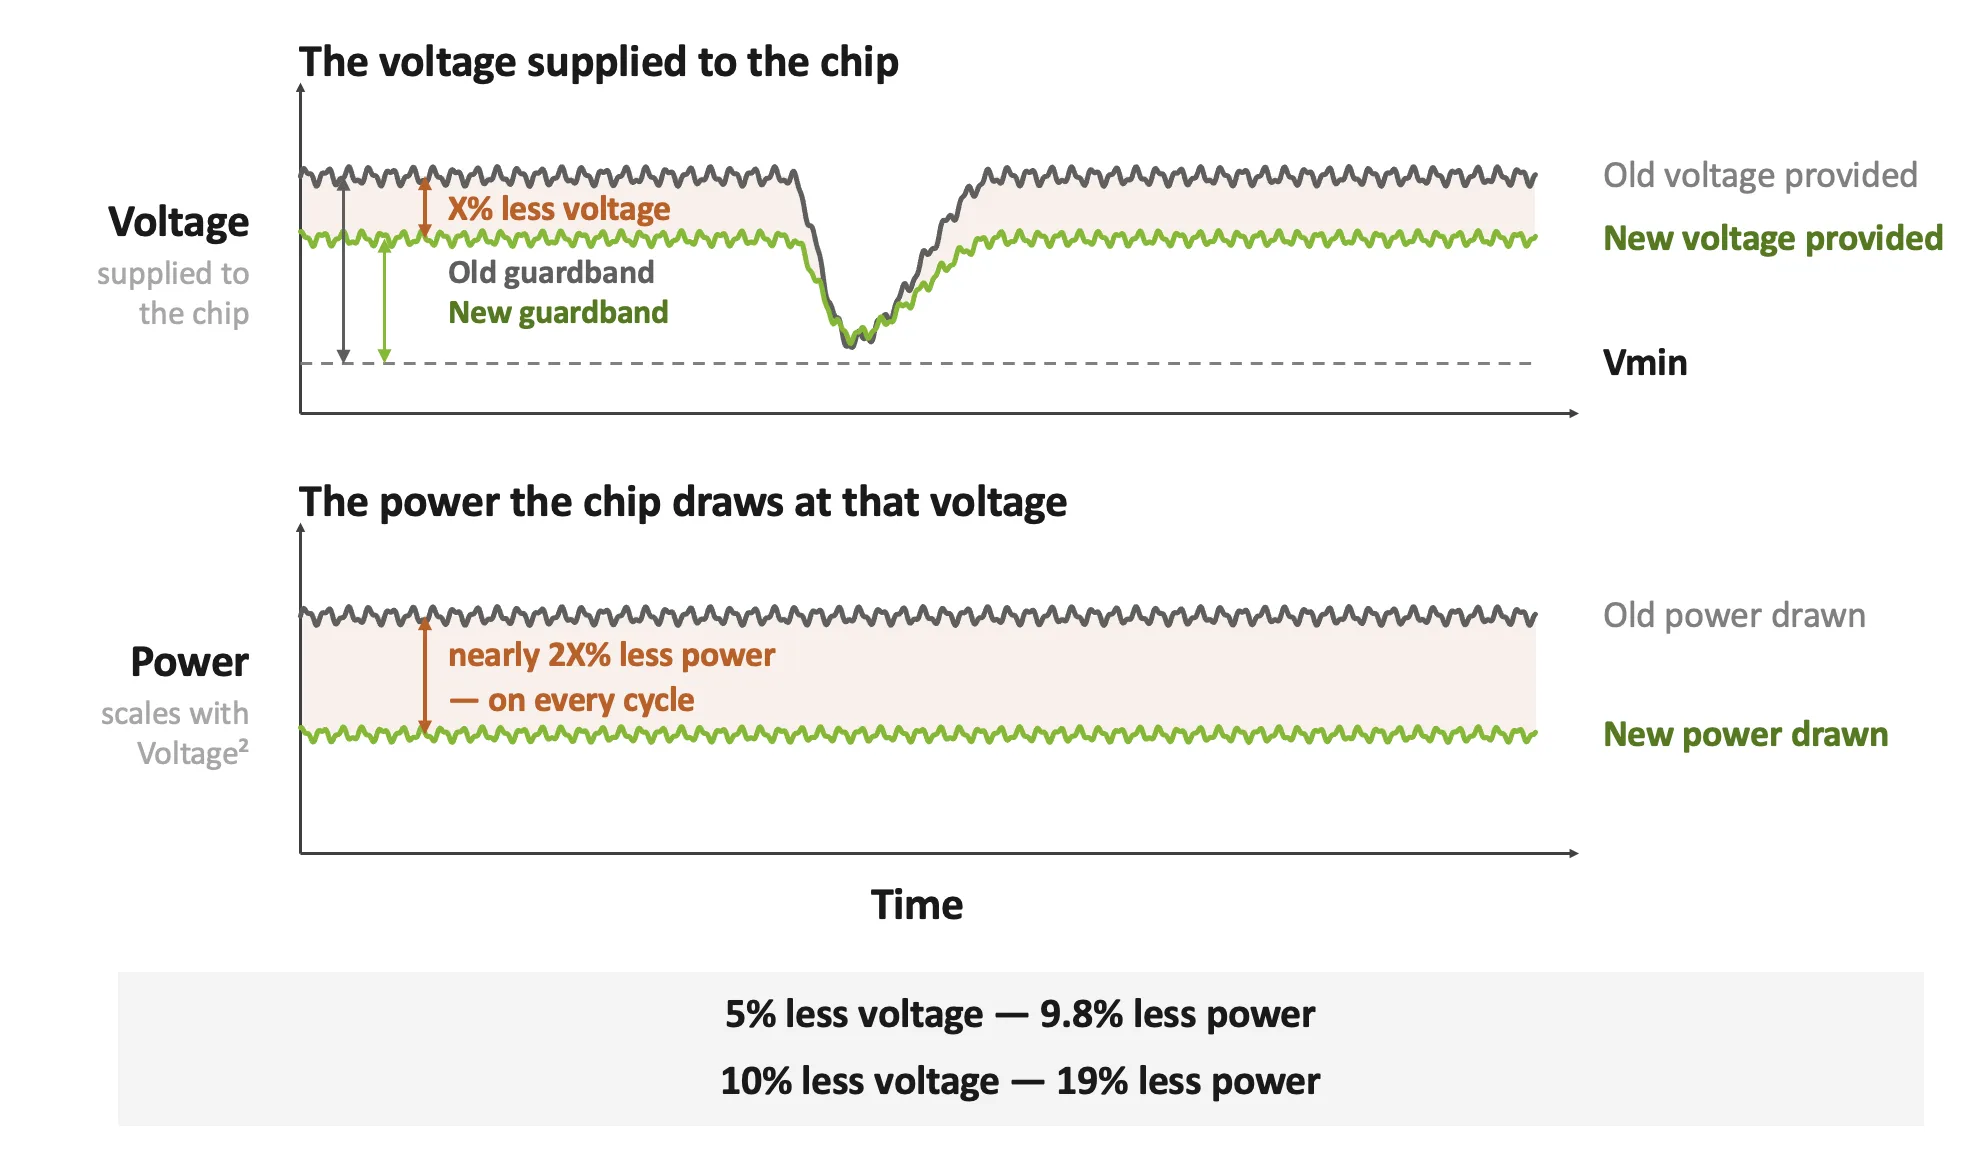
在高交互场景下提升每瓦性能
与同规格的非确定性系统相比,Groq 3 LPX 确定性执行可将运行相同工作负载所需的功耗降低低个位到双位数的百分比。在功耗受限的 AI 工厂中,降低这部分开销可为 token 生成保留更多固定的电力预算。
Groq 3 LPX 将在 2026 年下半年把这些由确定性机制驱动的功耗控制功能带入 NVIDIA Vera Rubin 平台。它们在工厂层面与 NVIDIA DSX MaxLPS 以及 Vera Rubin NVL72 机架内的智能功耗平滑功能形成互补。这三者分别作用于平台的不同的层级,但目标一致:从每一兆瓦电力中榨取更多有用的 AI 推理输出。
在平台层面,将 Groq 3 LPX 与 Vera Rubin NVL72 搭配使用,在长上下文、高交互性场景下处理 2T+ 参数模型时,相比上一代 NVIDIA GB200 NVL72,每兆瓦吞吐量最高提升 35 倍。对于 AI 工厂而言,这意味着在相同功耗预算下,能在该严苛工况下服务更多的 token。
致谢
本工作得以完成,得益于 Aravind Vellora Vayalapra、Santosh Raghavan、Kibibi Moseley、Ashraf Essea、Graham Steele、Suhas Somnath、Sarah McKenney、Farshad Ghodsian 和 Eduardo Alvarez 的专业支持与工程贡献。