
实时编辑、实时互动视频双旗舰,Vidu S2发布即体验
AI 视频,正在变成一个可以边播、边演、边改的实时系统。
比如,打开摄像头,点一下参考角色图,就能一键更换画面里的人物,动作、节奏丝毫不受影响。
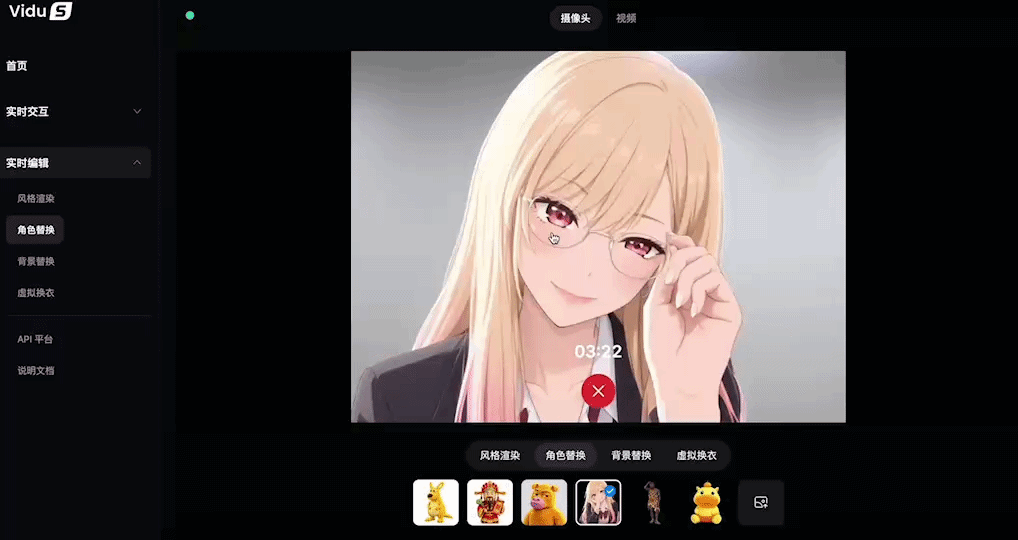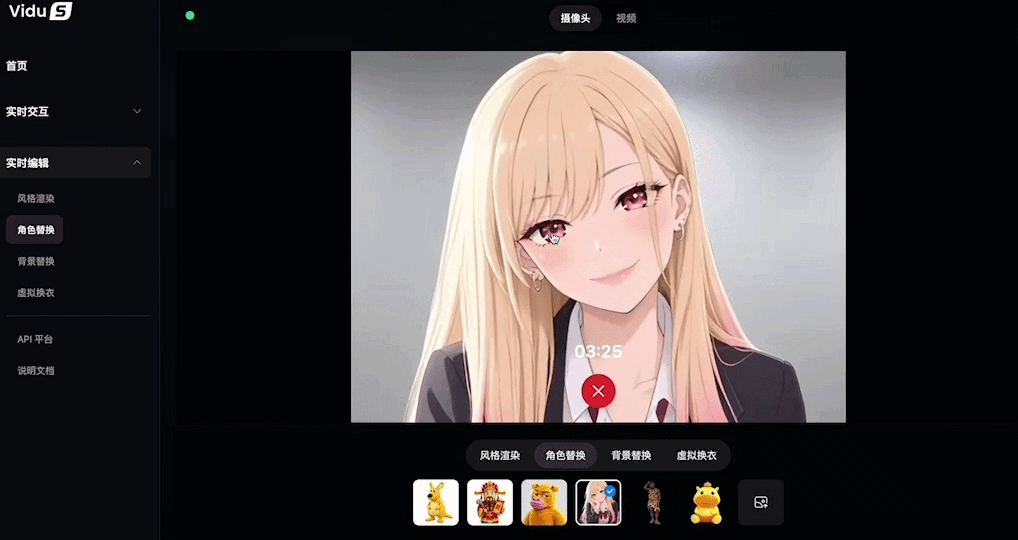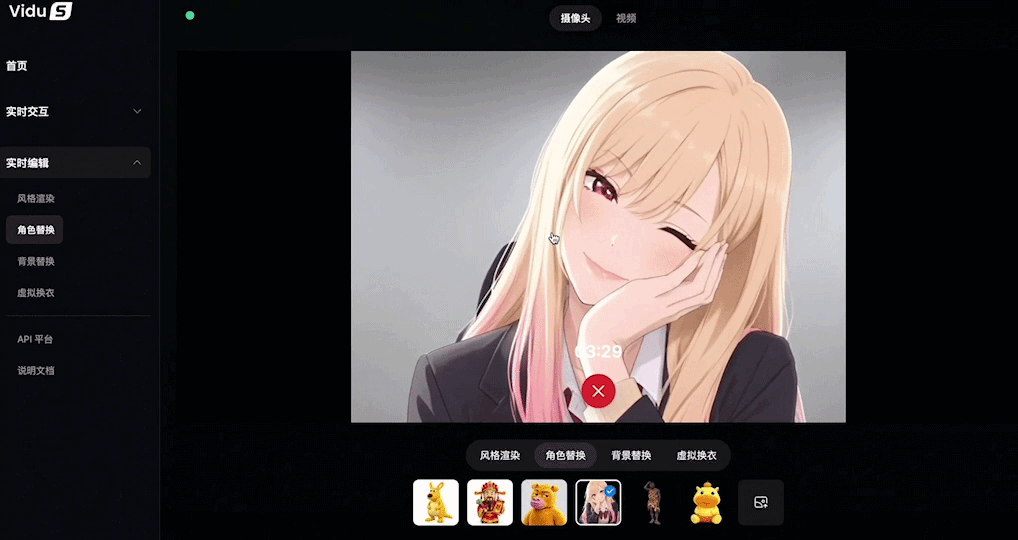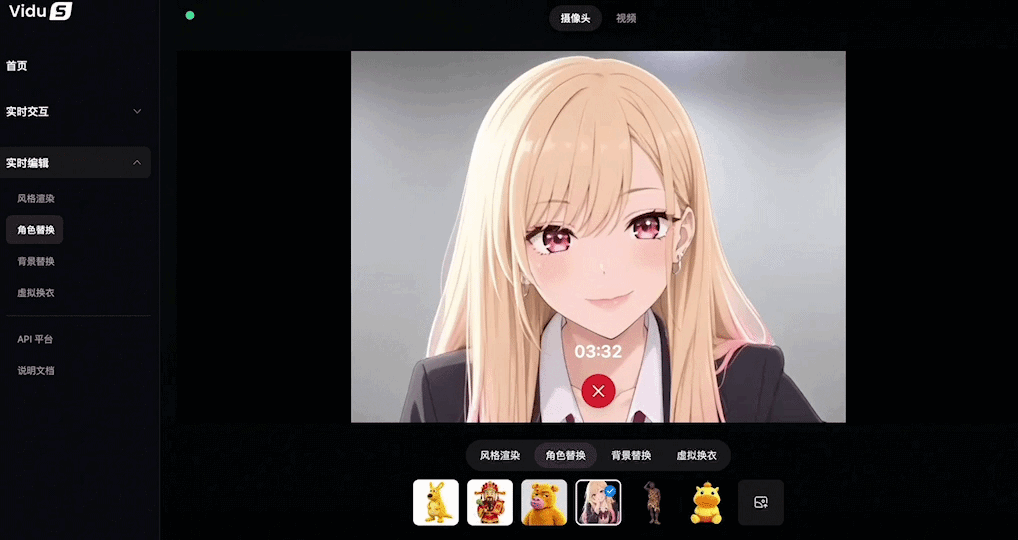
和虚拟人的互动也能随时加戏,实时聊着天,一句「跳个舞」便能开启才艺模式,动作还挺丝滑。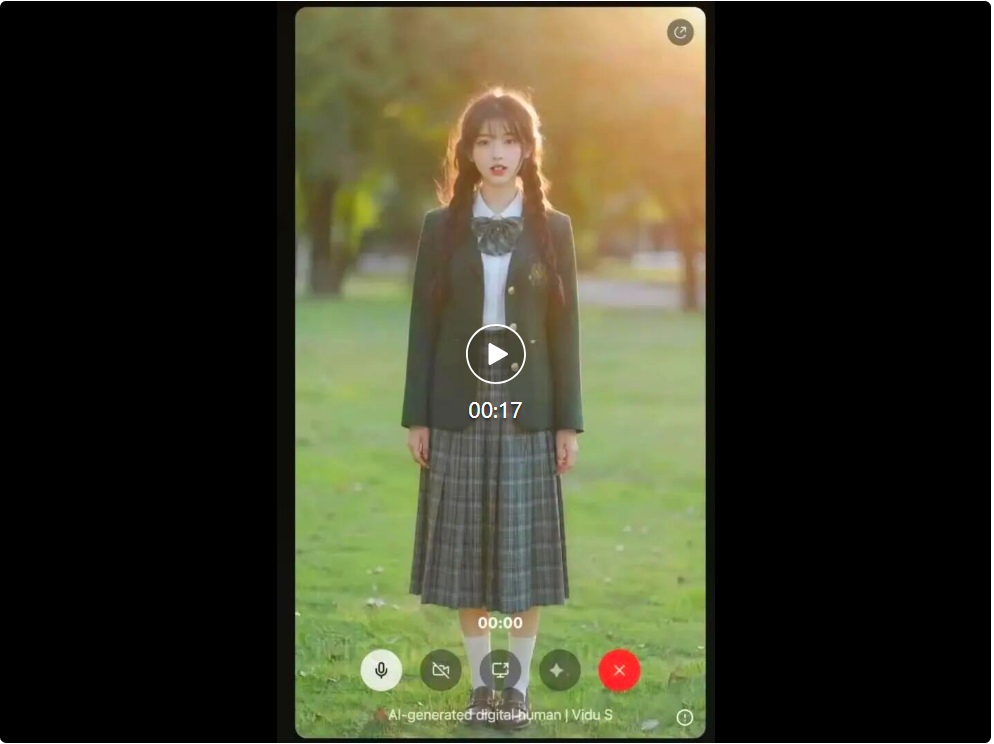
就像 P 图一样,摄像头捕捉到的真人视频流,也能边拍边「P 视频」,在保留原有动作和节奏的情况下,实时改变画风、人物或背景。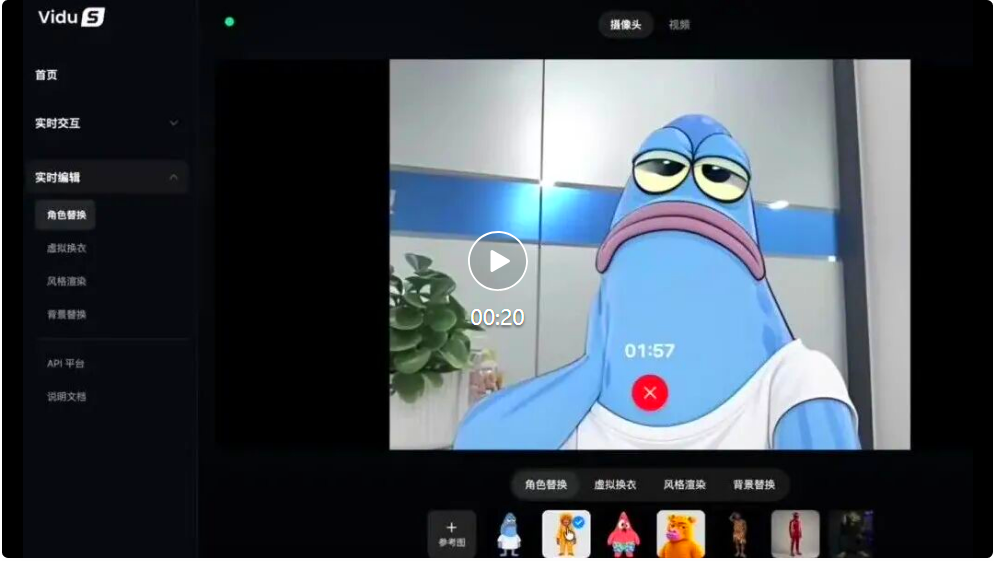
这就是生数科技最新推出的 Vidu S2,一套专为实时交互与实时编辑设计的视频生成模型,覆盖实时数字人、离线数字人和实时视频编辑三类核心能力。
其中,S2-Avatar 负责实时数字人的「实时表演」互动,支持 720p 、25~42 FPS 输出,能够处理舞蹈等更大幅度动作,并允许用户在生成途中继续加入人物、服装、道具或场景参考图。
S2-Editing 则是本次最显眼的新能力。它持续接收摄像头或源视频流,让新规则即时作用于后续画面,在保留原有姿态、肢体运动、镜头轨迹和时间顺序的同时,实时改变风格、服装、人物主体或背景。
此外,S2-Avatar [Offline] 面向预设内容生产,可根据图片、文案或音频批量生成动作时间点可控的数字人口播视频。
这些能力并非只停留在演示视频里。产品发布前夕,生数团队还公开了技术论文,详细披露实时数字人、流式视频编辑和空间视频背后的技术路线,并在发布当天开放网页体验与 API。
产品仍在持续打磨,团队希望从 Day 1 就把它作为一个开放实验交给用户进行共创。
体验链接: https://vidu.cn/vidu-stream
API 平台: http://platform.vidu.cn/vidu-stream/doc
技术报告: https://arxiv.org/pdf/2609.11638
从 S1 论文于 7 月 3 日提交,到 S2 论文于 9 月 10 日正式公开,前后仅相隔约 69 天,生数团队的技术迭代节奏相当紧凑。Vidu S1、Vidu S2 的全链路研发均由朱军教授的博士生、生数科技流式视频生成与推理负责人张金涛负责。
如此短的周期里,升级并非只多了几个功能:控制对象从固定数字人扩展到动态参考图和完整视频流,输出从 540p 提升到 720p,动作从说话为主扩展到舞蹈等全身表演,并进一步把实时链路延伸到左右眼同步的空间视频。
如果说 S1 实现的是数字人在视频生成过程中与用户实时对话,S2 则将实时控制范围进一步扩大。当角色开始大幅运动、用户不断递进新素材、输入本身变成连续视频流时,系统还能否及时、稳定、精确地接住每一次变化?
这对系统提出了更高要求,需要同时兼顾速度、稳定性与精准控制。足够快,画面才能实时返回;足够稳,误差才不会在长时生成中滚成崩坏;足够准,新指令只改变该改变的部分,并在正确时刻作用于后续画面。
Vidu S2 的技术路线,正是围绕这组「速度 — 稳定 — 控制」三角展开。
实时视频的难题 不只是快,还要一直稳、随时能改
实时视频比离线生成更难。
普通视频扩散模型通常可以看到完整片段,经过多轮去噪后一次性交付结果。流式模型只能依赖已有画面,逐段生成后续内容,前一段里的面部变形、动作偏差或背景变化,都会成为下一段的历史条件。运行时间越长,误差越容易累积。
用户中途加入新指令后,模型还要记住人物当前正在做什么,判断哪些内容需要保留,以及新的动作或参考图应该如何影响后续画面。
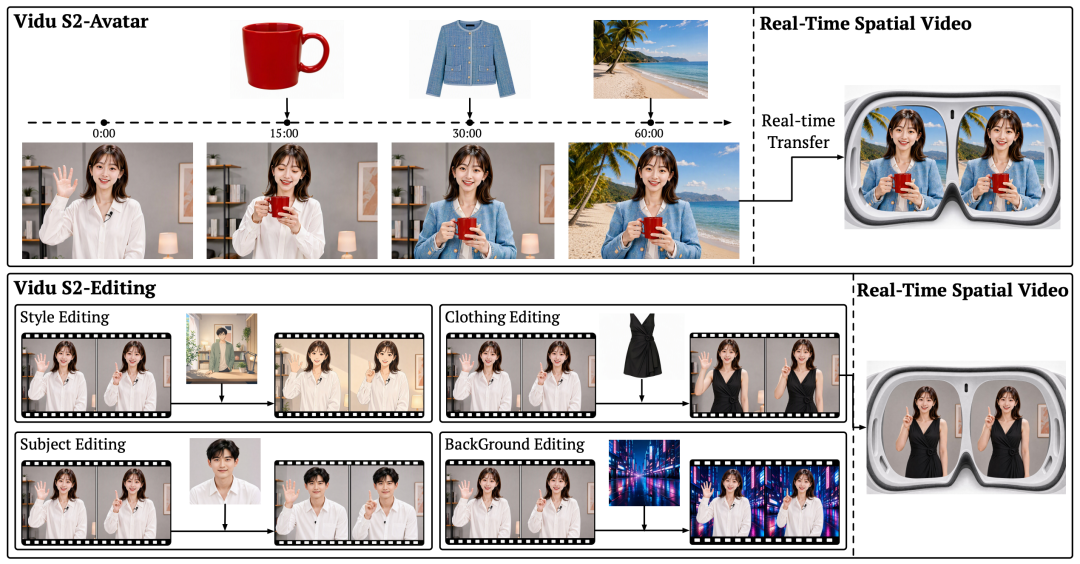
Vidu S2 概览。
从完整视频转向流式生成
要让数字人物在持续生成的视频中响应用户,模型既要学会连贯地表现人物、动作与声音,也要适应一段段向前生成的方式。Vidu S2-Avatar 从数据准备和训练方式两方面入手,逐步建立这种能力。
在数据准备上,团队除了继续扩充直播、访谈和影视素材,还加入了舞蹈、二维动画和三维动画视频,丰富人物的动作与表情。与之配套的视频标注按照事件发生的顺序展开,记录动作何时开始、带来了什么变化,以及结束后人物处于什么状态,为学习连续动作之间的衔接提供更清晰的监督。
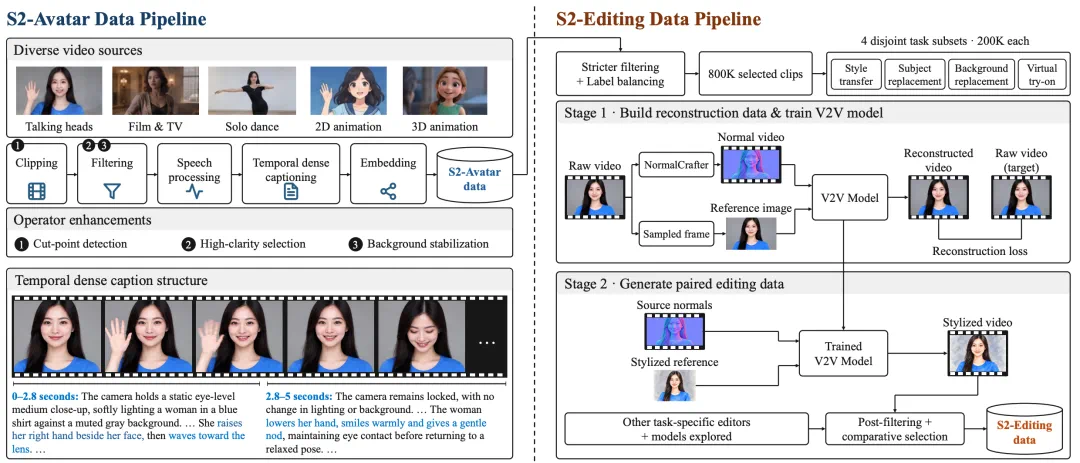
Vidu S2-Avatar 与 Vidu S2-Editing 的数据准备流程。
基于这些数据,Vidu S2-Avatar 首先训练双向音视频联合扩散模型,同时学习图生视频和参考生视频,建立人物、动作、声音与场景之间的关联。在这一阶段,每个时间片段都有对应的条件描述,使模型能够将指令与具体片段中的动作和状态变化联系起来。
在双向训练的基础上,团队进一步将双向时间注意力改为分块因果注意力,并进行流式适配训练。生成当前片段时,模型依据参考图、当前指令和此前的有效历史进行预测,不再依赖未来片段的信息,从而逐步学会沿时间顺序持续生成,并在运行过程中接入用户的新指令。
Self-Replay Forcing:让模型带着自己的错误复盘
要让模型适应流式生成,团队首先通过 Hybrid Forcing 完成初始化。这一阶段混合使用 Teacher Forcing 和 Diffusion Forcing:前者提供干净的真实历史,帮助模型学习片段之间的衔接;后者在历史状态中加入噪声,提高模型面对不完美历史时的鲁棒性,为后续训练提供一个具备初步流式生成能力的模型。
但这一阶段的历史仍以真实数据为基础。实际运行时,模型读取的是自己刚刚生成的画面,其中的轻微变形或偏差可能被后续片段继承和放大,模型还需要进一步适应自身生成的历史。
Vidu S2 为此提出 Self-Replay Forcing。模型先按照实际推理方式连续生成一段较长的视频,再从自生成轨迹中取出片段,以视频块为单位分别加入随机强度的噪声,进行一次可计算梯度的因果回放。原始生成过程及其缓存保持固定,参数更新所需的梯度在回放阶段计算。
可以把这一过程理解为「先生成,再带着自己的错误复盘」。
回放中的多个视频块处于同一计算图中,后续片段的训练损失可以通过梯度影响较早片段的表示,这让模型能够结合前后片段进行优化,学习在带有偏差的历史条件下保持后续生成的稳定性。训练还加入了感知损失,以缓解模式坍塌、保留生成内容的多样性。
此外,偏好优化贯穿双向与流式两个训练阶段:双向阶段采用 DPO,提升画质、表情、动作自然度和音画同步,为后续训练提供更强的教师模型;流式阶段采用 Streaming NFT,沿用自生成轨迹与回放的方式,进一步改善实际流式生成中的视觉质量、动作可控性和指令遵循。
Backbone 管动作,Refiner 补细节:720p 实时如何成立
在保持长时间生成稳定性的同时,实时模型还需要兼顾速度与清晰度。提高分辨率意味着更大的计算开销,因此,如何分配运动生成与细节恢复的任务,成为关键。
Vidu S2-Avatar 采用 Backbone 与 Refiner 两阶段架构。Backbone 在较低分辨率下生成视频,负责人物动作、整体结构和跨片段的连续变化;Refiner 则将这些低分辨率结果在潜空间中上采样并加入固定强度的噪声,再通过一步去噪恢复高分辨率细节。这样的分工让主要生成过程保持较低的计算开销,同时补足画面的清晰度。
两部分对历史信息的使用也各有侧重。Backbone 读取噪声较高的历史缓存,侧重传递粗粒度运动和长期时序结构,降低对高频瑕疵的敏感性;Refiner 则读取噪声较低的高分辨率历史缓存,保留人物外观、身份和局部纹理线索,为当前片段的细节恢复提供参照。前者维持运动的连贯,后者在这一基础上细化画面。
为了让这套架构满足实时要求,推理端进一步采用分层加速策略:根据不同网络层对精度和近似计算的敏感程度,组合使用 SageAttention、SpargeAttention 和稀疏线性注意力。细粒度 W8A8 量化降低线性层的计算与显存开销,算子融合和 CUDA Graphs 则减少频繁的算子启动、同步以及中间结果读写。
多 GPU 调度进一步协调编码器、Backbone、Refiner 和解码器的执行时序,让不同模块在各自需要时复用 GPU 资源,减少空闲与等待。模型架构、训练方法和推理优化共同支撑了 Vidu S2-Avatar 以 25~42 FPS 生成 720p 视频的能力。
动态参考:参考图变成现场道具
用户临时上传商品、服装或背景图片时,系统还要判断图片的用途,并把新的要求接入人物当前的状态。
Vidu S2 引入 VLM Agent。它接收文字、语音、初始图片和新增参考图,将用户意图整理成生成提示词,再持续检查返回的视频帧。Agent 会判断上一项动作已经完成、部分完成,还是偏离要求。它还会记录需要延续的状态。
例如,用户要求人物「拿起杯子,然后微笑」,第二条提示词仍会保留「手持杯子」。人物摘下帽子后,Agent 也会记录帽子当前在手中,直到用户要求重新戴上,多轮指令由此形成连贯的动作链。
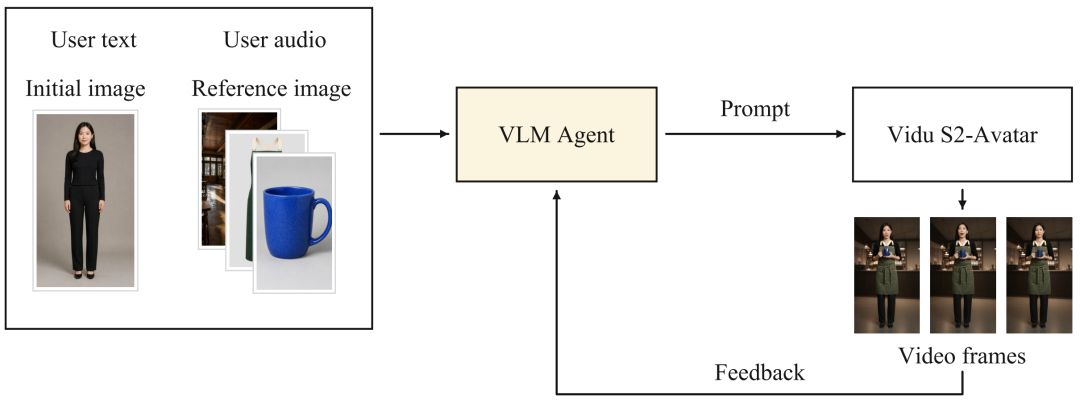
VLM Agent 读取用户输入,生成提示词,并根据返回的视频帧调整后续生成。
这样,新增参考图能够影响后续画面,多轮指令也能组成连贯的动作链。
帧对齐注意力:像 P 图一样 P 视频,时间轴却不乱
Vidu S2-Editing 需要持续读取摄像头画面或源视频,并及时输出编辑结果。它既要跟随原有的人物动作和镜头变化,又要让新的画风、服装、角色或背景在连续画面中保持一致。
其中的关键设计是帧对齐稀疏注意力。目标帧与源视频交互时,只读取源视频中同一时刻的画面,避免不同时刻的动作信息相互干扰;参考图则对所有目标帧保持可见,为编辑后的外观提供持续参照。源视频负责提供动作与空间结构,参考图负责引导外观变化。
这一设计也延续到流式推理中。每个源视频帧与对应的目标帧一起处理,源帧处理完成后不再保留在历史缓存中,减少缓存占用;生成端则继续利用必要的历史信息,维持片段之间的连贯。配合编码、生成和解码模块之间的协同调度,系统进一步减少等待,降低从输入画面到编辑结果的延迟。
训练也围绕这一流式结构展开。模型首先进行双向编辑训练,并在这一阶段就采用帧对齐的源视频交互方式;随后改为分块因果注意力,通过 Hybrid Forcing 完成因果模型初始化,再使用 Self-Replay Forcing,从自身生成的轨迹中学习,改善持续编辑时的时序一致性和指令遵循。
数据方面,团队从筛选后的素材中选出 80 万段视频,划分为四个互不重叠的 20 万段子集,分别用于风格转换、主体替换、背景替换和虚拟试衣。再通过相应的编辑模型生成候选结果,经过质量筛选与比较,构建源视频与编辑视频配对的训练数据。
实验结果显示,Vidu S2-Avatar 在 StreamAV-Bench 公布的九项指标上均取得最高成绩,其中,主体一致性和背景一致性分别达到 0.998 和 0.993。
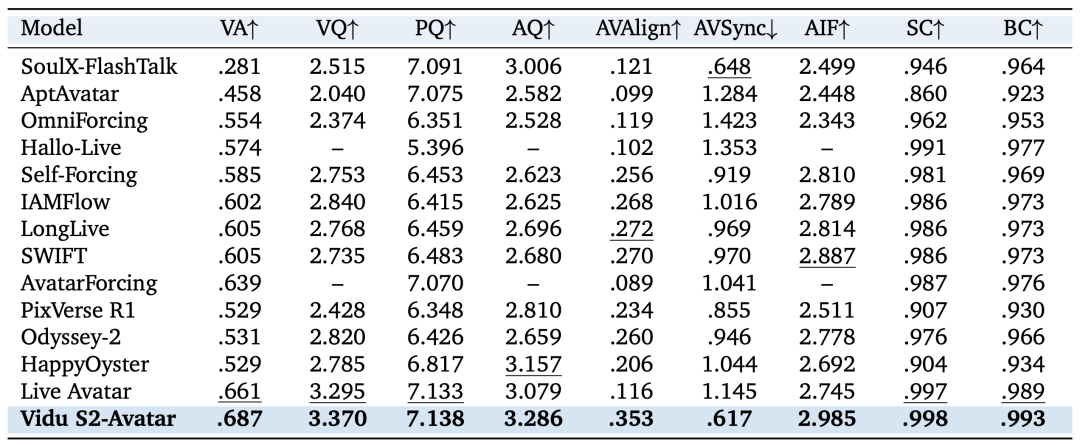
StreamAV-Bench 上的评测结果。↑/↓分别表示数值越高 / 越低越好。(下同)
内部评测还比较了 10 秒至 90 秒的生成表现。Vidu S2-Avatar 在一致性、画质、运动、情绪表达和整体质量上的评分保持相对稳定。
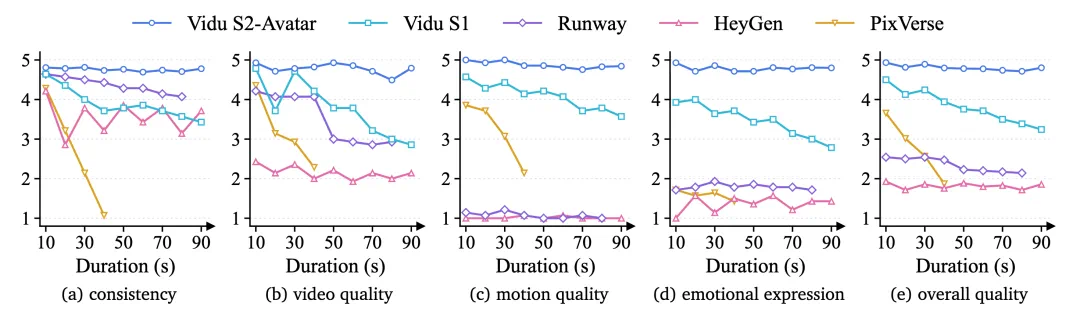
不同生成时长下的数字人质量评分。
在视频编辑评测中,Vidu S2-Editing 在 Sparkle-Bench 获得 3.74 的综合分。
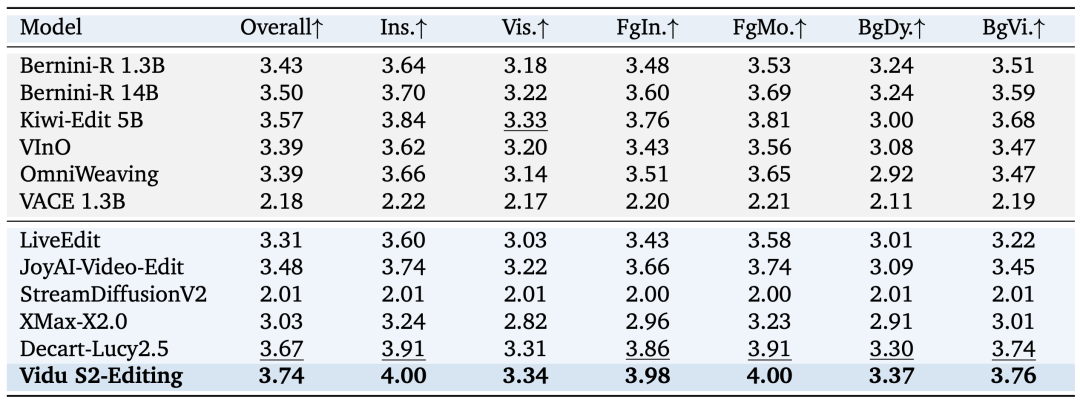
Sparkle-Bench 上的评测结果。Ins.、Vis.、FgIn.、FgMo.、BgDy. 和 BgVi. 分别表示整体指令遵循度、整体视觉质量、前景指令遵循度、前景运动表现、背景动态表现和背景视觉质量。
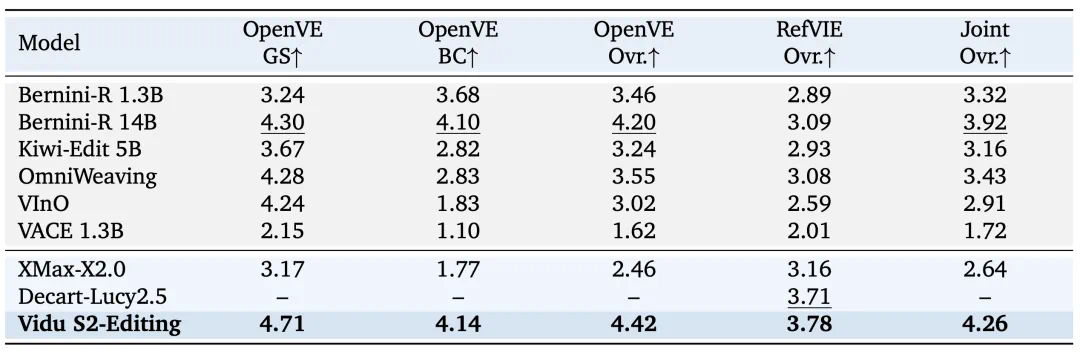
在 OpenVE 与 RefVIE 的联合评测中,其综合得分为 4.26。多套评测考验的是,模型不仅要把外观改对,还要守住原视频的动作、时序和连续性。
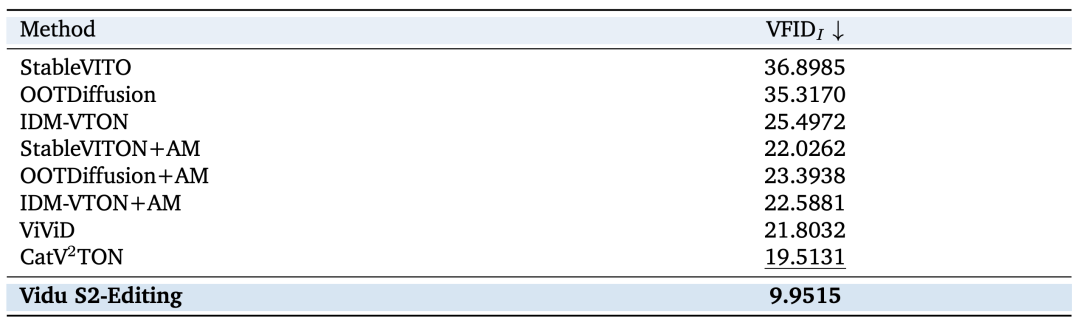
虚拟试衣评测中的 VFIDI 为 9.9515,第二名 CatV2 TON 为 19.5131,该指标越低越好。
空间视频,正在成为新的竞争方向
Vidu S2 这次更前沿的一步,是将实时生成和编辑扩展到空间视频。
空间视频会为左右眼提供存在细微视差的两组画面,让用户感知物体远近、场景深度和人物与背景之间的空间关系。
对于 S2-Avatar,系统先实时生成普通单目视频,再估计每一帧的深度,将中心视图向相反方向水平偏移,合成同步的左右眼画面。
视差变换会在物体边缘和新暴露区域留下空洞,系统需要进行填补。同时,单帧深度估计容易前后波动,模型还要稳定相邻帧的深度,避免立体效果持续抖动。
S2-Editing 支持两条空间视频路线。普通单目视频可以先完成实时编辑,再转换为左右眼画面;已有双目视频则可以把左右视图横向拼接,在一次推理中共同编辑,随后重新拆分。
换装、人物替换、风格转换和背景修改,由此可以进入头显看到的空间画面。摄像头透视画面也能接入这套流程,为实时虚拟拍摄和混合现实提供新的控制方式。
近期还有公开报道称,字节跳动正在开发基于 Seedance 的实时空间视频模型,并计划与 PICO 头显结合,这说明空间视频正在成为视频模型与 XR 硬件共同争夺的新方向。
在行业开始集中布局时,Vidu S2 已经给出了论文、完整技术流程和可体验能力。它目前仍以固定视角的双目视频为主,距离能够自由转头探索的全景空间环境还有一段距离。头显的大视野也会放大清晰度和延迟问题,更高分辨率、更低端到端延迟将是下一阶段的重点。
看效果:视频不需暂停,人物和画面照样能变
了解完技术路线,再来看 Vidu S2 的实际效果。
实时数字人的变化首先体现在动作上。过去,这类产品大多围绕口型和面部表情展开,身体姿态相对固定。
Vidu S2-Avatar 则可以在与用户实时对话的同时,进行复杂动作控制,比如摆臂、扭身、踏步和抬腿等舞蹈动作,指令遵循能力也进一步提升。它还能结合参考图完成物品互动、服装更换和背景切换,输出分辨率同步提升至 720p。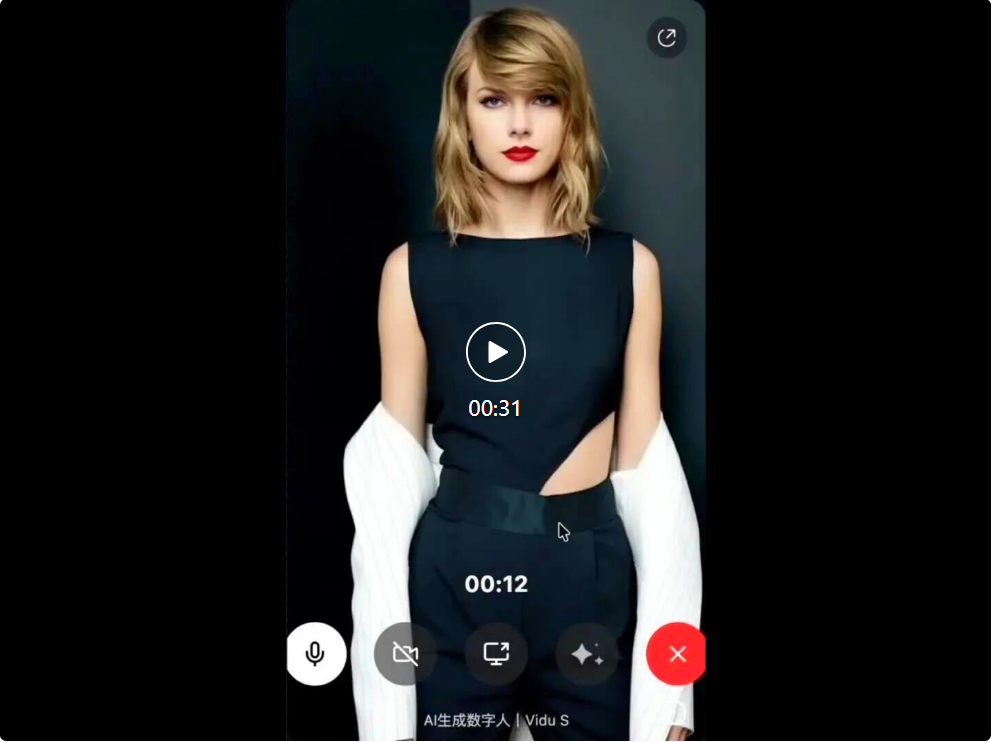
再来看看实时视频编辑功能。
Vidu S2-Editing 可以持续接收真人视频流,人物继续表演,风格、服装、主体和背景随时都可以按照用户的自定义图片修改。
比如换人物: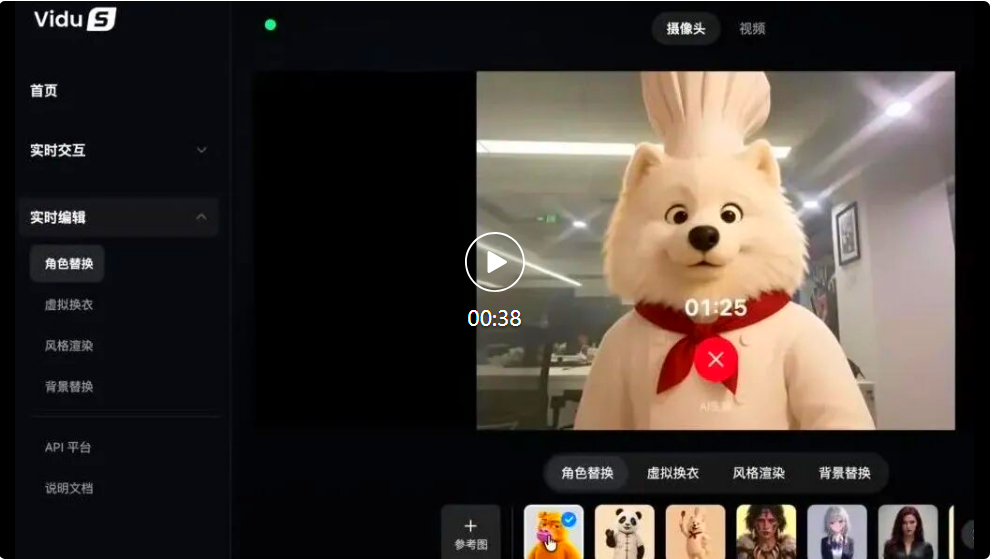
换风格: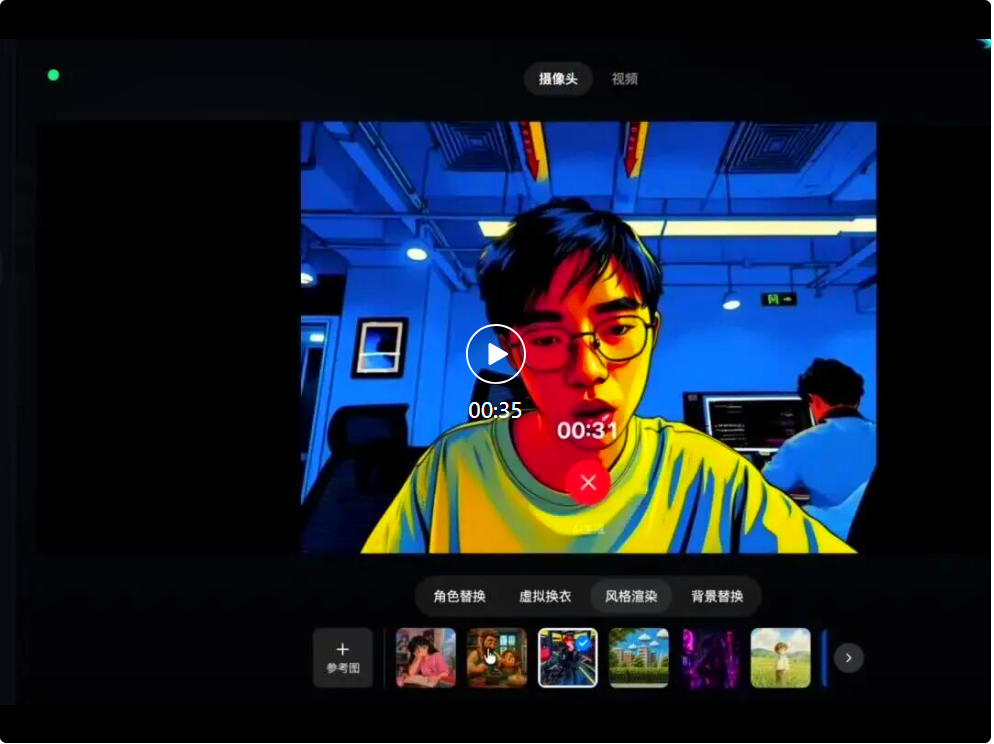
总之,Vidu S2 能让指定内容实时变化,也能维持原视频的动作和节奏。对直播、虚拟拍摄和互动内容来说,视频拥有了实时改造的空间。
结语
69 天,从实时说话到实时表演,从生成角色到改写现场,再到把画面送进左右眼,Vidu S2 展示的是一条越来越清晰的演进方向。
AI 视频正在从等待交付的一段内容,变成能够持续运行、随时响应、不断被导演的视觉界面。下一阶段的竞争,将不只比谁生成得更像,也要比谁能在真实时间里,把变化接得更稳、更准、更久。
发布当天即让所有人使用,大家抓紧享受:
体验链接: https://vidu.cn/vidu-stream
API 平台: http://platform.vidu.cn/vidu-stream/doc
技术报告: https://arxiv.org/pdf/2609.11638