
Hacker News 3小时前 · 2026-09-15 21:05:14 · 2 阅读
把国旗压缩到 11 个比特
我最近看到一个“Physics for the Birds”频道有趣的 YouTube 视频。正片讲的是矩阵,但他用旗帜来解释了一些矩阵运算: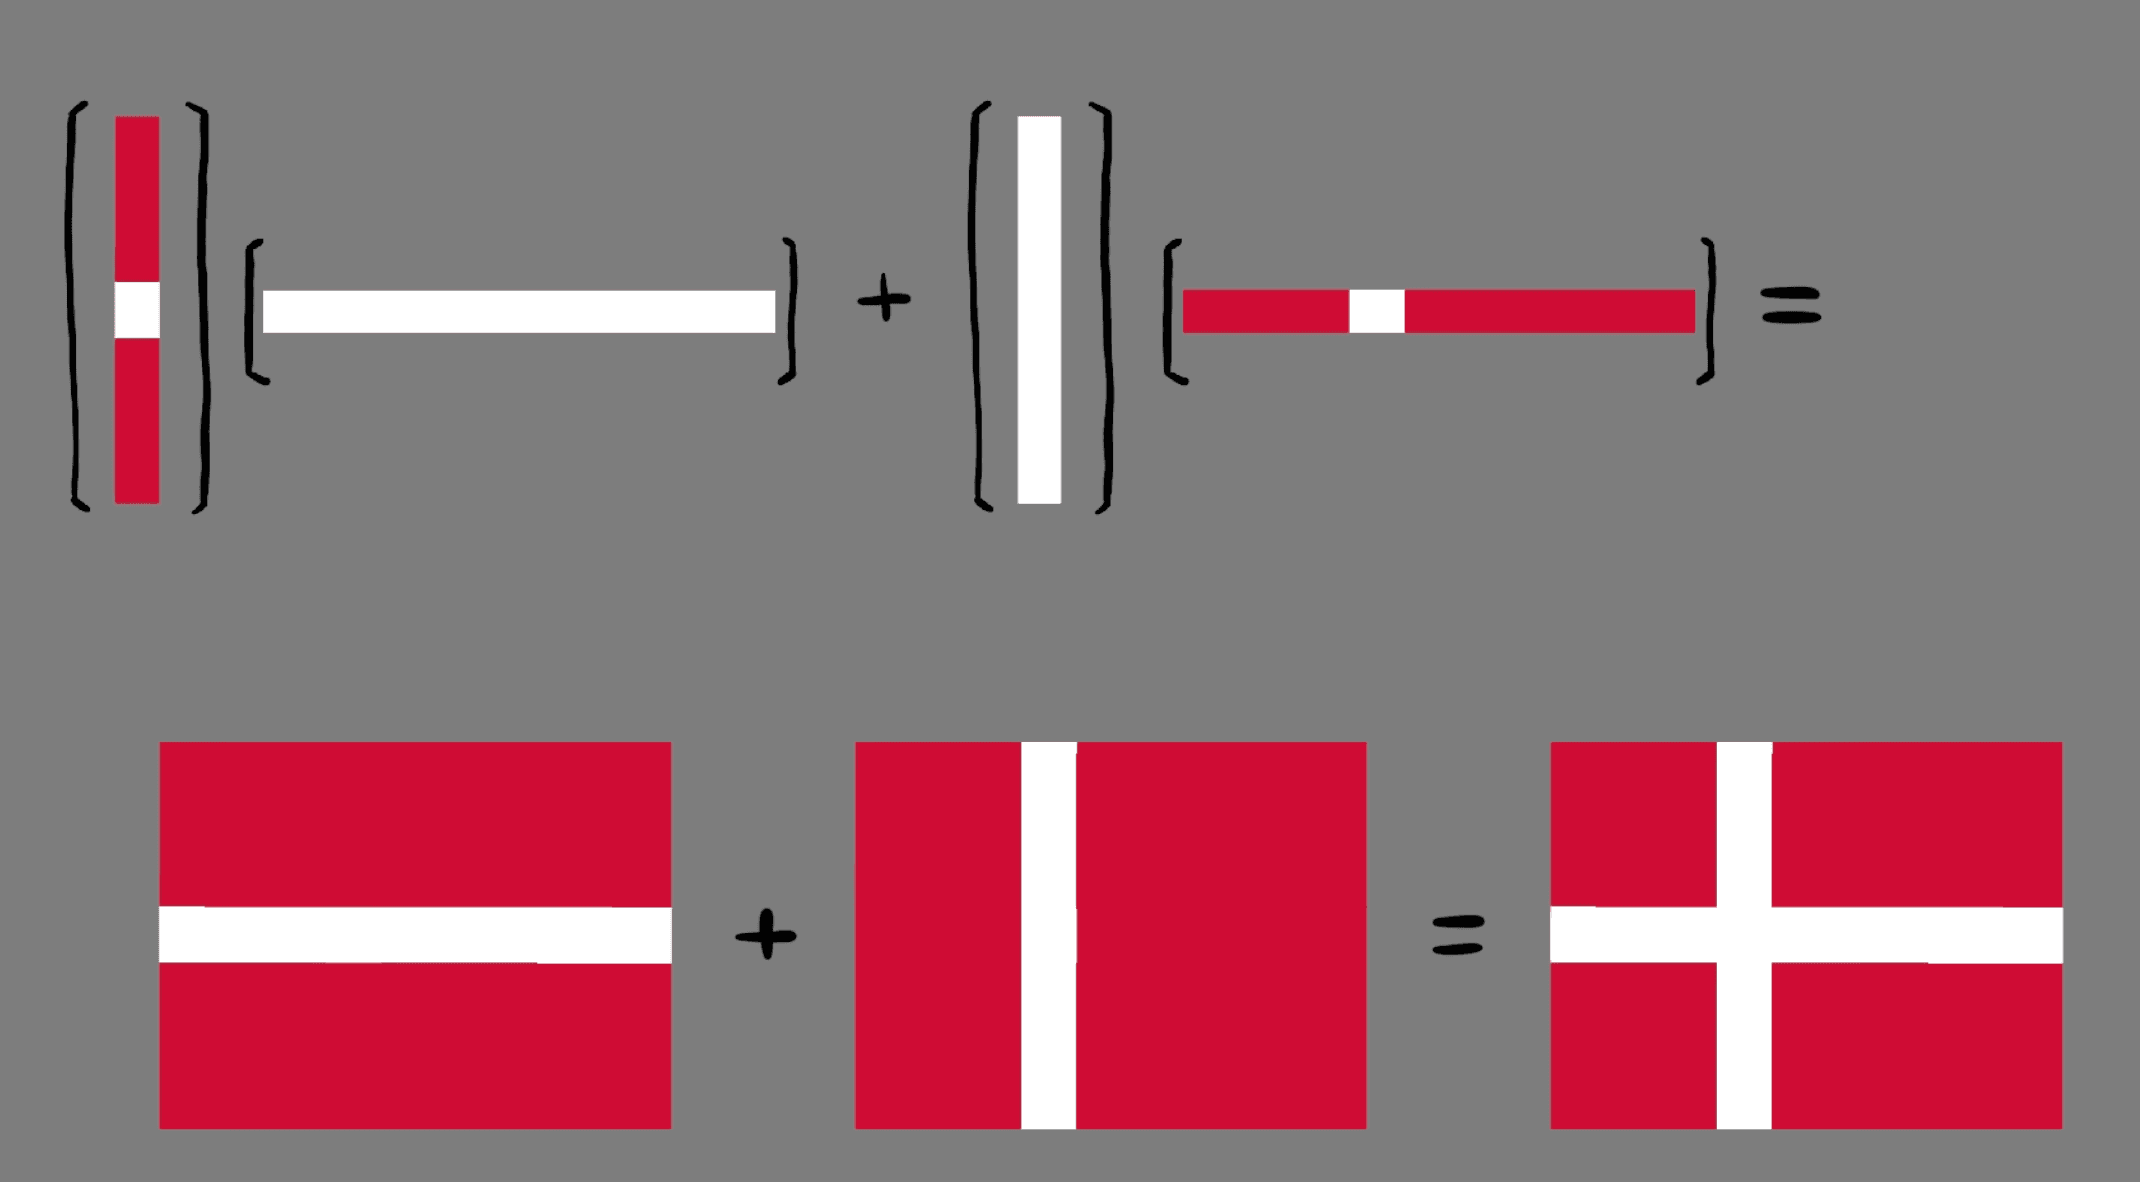
截图来自该视频
需求定义
首先,我为自己的编码设定了如下验收标准:- 解码后的旗帜必须“辨识度足够高”
- 细节不必完全精确。只要有人看一眼就能说出“啊,是这面旗”,那么小的偏差或误差都可以接受
- 这包括物体的具体位置以及形状细节
- 也涵盖精确色值。我知道法国对他们新版国旗蓝色调有多么自豪,但在这种编码里,我们可以把各种蓝色归并为某个“标准蓝”
- 仅限国家旗帜
- 不涉及州旗、市旗或其他纹章学设计
- 不含🇳🇵尼泊尔国旗
- 抱歉尼泊尔,我挺喜欢你那种非矩形旗帜的,但它会让方案变得复杂
- 简单旗帜应只需极少位;复杂旗帜可以允许占用更多位——因此编码长度不固定
- 不含国徽/纹章
- 像 🇦🇩 安道尔这样的国旗自带头徽图案,渲染它基本只能用专门的位图或矢量图。那就等于要在这么小的格式里塞进 SVG 之类的东西,不行
什么才算一面国旗?
首先,我需要搞清楚常见的国旗都由哪些元素组成。Worldometers 的全球国旗列表在这方面帮了大忙。第一个感受是:好家伙,国旗的变化比我预想的多得多。当然有 🇫🇷 法国、🇮🇹 意大利、🇩🇪 德国这类简单的条纹旗。也有 🇧🇮 布隆迪、🇧🇦 波黑这种带星星和分区的复杂设计。🇲🇰 北马其顿和 🇸🇨 塞舌尔用的是放射状条纹。🇨🇿 捷克、🇧🇸 巴哈马等则在左侧加了自定义三角形,还有更多其他样式。那么大多数国旗有什么共同点?据我观察:- 条纹
- 条纹,到处是条纹:🇫🇷 横向、🇩🇪 纵向、🇵🇱 2 条、🇦🇲 3 条、🇺🇸 13 条、🇨🇴 不等宽条纹、🇨🇬 斜条纹
- 常见图形
- 🇻🇳 星星、🇩🇿 新月、🇯🇵 圆形
- 大小和位置各不相同——🇻🇳 一颗或 🇺🇸 一堆
- 左侧色块三角形
- 出奇地常见,颜色各异——但形状大体一致 🇰🇲🇧🇸🇨🇿
- 左上角色块
- 左上角往往有一块自定义矩形 🇺🇸🇬🇷
- Union Jack
- 🇬🇧🇦🇺🇳🇿🇹🇻
- 还有北欧国家
- 它们显然是一大类…… 🇳🇴🇸🇪🇩🇰🇫🇮
拆解国旗
依我看,这个协议应该定义以下元素:- 宽高比
- 各国国旗的宽高比各不相同,但有明显规律:约 45% 的国旗是 2:3,约 28% 是 1:2,约 9% 是 3:5——其余则是一长尾的其他格式
- 调色板
- 如前所述,我们只关注大致色调,不还原精确的色值,也就是关注蓝、绿、黄这类颜色分组
- 分布情况也类似:红色多得惊人,其次是白色、蓝色、黄/金色、绿色、黑色和橙色——然后是其他颜色的长尾
- 图层
- 我认为用少量“图层”来定义旗帜的实际内容,比分别硬编码所有常见元素更合理。每个图层可独立配置自己的选项列表。
- 其原理应类似于 Photoshop 或其他设计软件:例如制作 🇺🇸 美国国旗时,先添加条纹图层,再叠加蓝色矩形图层,最后添加星形图层。
- 最通用的图层是“条纹”图层,支持配置条纹数量与颜色、方向、均匀或间隔分布以及重复图案等选项。
- 其他图层包括用于定义星星、新月等元素位置与旋转角度的“形状”图层,以及用于为特定矩形区域着色的“带状”和“区域”图层。
- 宽高比(最常见:2:3、1:2、3:5)
- 长尾部分可用自定义宽高比
- 调色板大小(最常见:3、2、4、5)
- 长尾部分用自定义的“数量 - 7”表示,因为树最多只到 7
- 颜色(最常见:红、白、蓝)
- 自定义颜色可以用紧凑的 10 位 RGB 近似表示(RRR GGGG BBB)
- 图层层数
- 图层类型(条纹、形状、区域、十字、带状、内置图案)
- 一些更专门的子树
- 比如星星的角数、形状的摆放位置等
- 2:3 的宽高比(1 比特)→
0 - 最常见宽高比
- 调色板包含 2 种颜色(2 比特)→
10 - 这是它唯一多花一个比特的地方,因为树中最常见的是 3 色
- 然后定义这 2 种颜色:红(2 比特)→
00,白(2 比特)→01 - 树中最靠顶部的两种颜色
- 1 个图层(1 比特)→
0 - 树顶
- 条纹图层(1 比特)→
0,“调色板均分”模式(即给调色板里每种颜色分配一条等宽条纹,1 比特)→0,水平条纹(1 比特)→0 - 全都是各自 Huffman 树的顶部节点
- → 组合起来:
0 10 00 01 0 0 0 0,base64 编码后为“QgA=” - 🇪🇸 西班牙、🇬🇶 赤道几内亚、🇦🇩 安道尔、🇧🇿 伯利兹、🇧🇳 文莱、🇰🇭 柬埔寨、🇨🇷 哥斯达黎加、🇭🇷 克罗地亚、🇩🇴 多米尼加共和国、🇪🇨 厄瓜多尔、🇸🇻 萨尔瓦多、🇫🇯 斐济、🇭🇹 海地、🇲🇽 墨西哥、🇲🇩 摩尔多瓦、🇲🇪 黑山、🇳🇮 尼加拉瓜、🇴🇲 阿曼、🇵🇾 巴拉圭、🇵🇹 葡萄牙、🇸🇲 圣马力诺、🇷🇸 塞尔维亚、🇸🇰 斯洛伐克、🇸🇮 斯洛文尼亚、🇻🇪 委内瑞拉
- 包含国徽、印章或国家标志(25 面)
- 🇦🇴 安哥拉、🇧🇧 巴哈马、🇸🇿 斯威士兰、🇬🇹 危地马拉、🇰🇪 肯尼亚、🇱🇸 莱索托、🇱🇮 列支敦士登、🇲🇹 马耳他、🇲🇿 莫桑比克、🇹🇯 塔吉克斯坦、🇻🇦 梵蒂冈
- 包含具象图案,如武器、工具、王冠、盾牌或帽子(11 面)
- 🇦🇱 阿尔巴尼亚、🇧🇹 不丹、🇩🇲 多米尼克、🇪🇬 埃及、🇰🇮 基里巴斯、🇵🇬 巴布亚新几内亚、🇱🇰 斯里兰卡、🇺🇬 乌干达、🇿🇲 赞比亚、🇿🇼 津巴布韦
- 包含动物图案,多为鹰和其他鸟类(10 面)
- 🇨🇦 加拿大、🇨🇾 塞浦路斯、🇪🇷 厄立特里亚、🇬🇩 格林纳达、🇱🇧 黎巴嫩
- 包含植物图案,如树叶、树枝或肉豆蔻(5 面)
- 🇦🇬 安提瓜和巴布达、🇧🇷 巴西、🇳🇵 尼泊尔、🇿🇦 南非、🇻🇺 瓦努阿图
- 包含图层模型无法表达的几何结构,如 Y 形、V 形区域、地球仪或非矩形轮廓(5 面)
- 🇦🇫 阿富汗、🇮🇷 伊朗、🇮🇶 伊拉克、🇸🇦 沙特阿拉伯
- 包含阿拉伯文字或书法(4 面)
- 添加一些自定义的文本图层应该能解决这个问题
- 🇮🇳 印度、🇰🇬 吉尔吉斯斯坦、🇲🇳 蒙古、🇰🇷 韩国
- 包含宗教或文化符号,如阿育法轮、图杜克、苏永布或太极(4 面)
- 🇧🇾 白俄罗斯、🇰🇿 哈萨克斯坦、🇹🇲 土库曼斯坦
- 装饰性的旗杆侧图案
将其转换为比特位
就像大多数事物一样,国旗的许多特征也符合齐普夫定律——无论是纵横比、颜色,还是条纹、星星等元素。为了让常见元素占用更短的编码空间,我决定将几乎所有内容单独编码到一棵Huffman 树中,为高频情况分配较短的二进制码。
为了容纳长尾分布而又不让树变得过于庞大,我决定舍弃那些只出现在单一国旗中的值,改为在树的最后一个叶子节点设置一个“自定义”值,随后跟随一个固定长度的自由值选项。例如,这使得🇸🇻萨尔瓦多能够保留其 189:335 的纵横比,而不必将该比例直接存入树中。
以下是一个完整的国旗纵横比 Huffman 树示例:
graph TD
    %% 内部节点
    root((Root))
    n1(( ))
    n11(( ))
    n110(( ))
    n1101(( ))
    n11011(( ))
    n111(( ))
    n1110(( ))
    n11100(( ))
    n111001(( ))
    n11101(( ))
    n111010(( ))
    n111011(( ))
    n1111(( ))
    n11110(( ))
    n111100(( ))
    n111101(( ))
    n11111(( ))
    n111110(( ))
    n1111100(( ))
    n1111101(( ))
    n111111(( ))
    n1111110(( ))
    n1111111(( ))
    n11111111(( ))

    %% 叶子节点(纵横比)
    L_2_3[2:3]
    L_1_2[1:2]
    L_3_5[3:5]
    L_5_8[5:8]
    L_10_19[10:19]
    L_3_4[3:4]
    L_4_7[4:7]
    L_1_1[1:1]
    L_7_10[7:10]
    L_8_11[8:11]
    L_11_18[11:18]
    L_11_20[11:20]
    L_11_28[11:28]
    L_18_25[18:25]
    L_1_phi[1:φ]
    L_4_5[4:5]
    L_6_7[6:7]
    L_10_17[10:17]
    L_13_15[13:15]
    L_15_22[15:22]
    L_16_25[16:25]
    L_189_335[189:335]
    L_28_37[28:37]
    L_5_7[5:7]
    L_7_11[7:11]
    L_CUSTOM[CUSTOM]

    %% 左侧分支(0...)
    root -- 0 --> L_2_3
    root -- 1 --> n1

    n1 -- 0 --> L_1_2
    n1 -- 1 --> n11

    %% 110... 分支
    n11 -- 0 --> n110
    n110 -- 0 --> L_3_5
    n110 -- 1 --> n1101
    n1101 -- 0 --> L_5_8
    n1101 -- 1 --> n11011
    n11011 -- 0 --> L_10_19
    n11011 -- 1 --> L_3_4

    %% 111... 分支
    n11 -- 1 --> n111
    n111 -- 0 --> n1110

    %% 1110... 子分支
    n1110 -- 0 --> n11100
    n11100 -- 0 --> L_4_7
    n11100 -- 1 --> n111001
    n111001 -- 0 --> L_1_1
    n111001 -- 1 --> L_7_10

    n1110 -- 1 --> n11101
    n11101 -- 0 --> n111010
    n111010 -- 0 --> L_8_11
    n111010 -- 1 --> L_11_18
    n111011 -- 0 --> L_11_20
    n111011 -- 1 --> L_11_28
    n11101 -- 1 --> n111011

    %% 1111... 分支
    n111 -- 1 --> n1111
    n1111 -- 0 --> n11110

    %% 11110... 子分支
    n11110 -- 0 --> n111100
    n111100 -- 0 --> L_18_25
    n111100 -- 1 --> L_1_phi
    n1111001(( ))
    n11110 -- 1 --> n111101
    n111101 -- 0 --> L_4_5
    n111101 -- 1 --> L_6_7

    %% 11111... 分支
    n1111 -- 1 --> n11111
    n11111 -- 0 --> n111110

    %% 111110... 子分支
    n111110 -- 0 --> n1111100
    n1111100 -- 0 --> L_10_17
    n1111100 -- 1 --> L_13_15
    n111110 -- 1 --> n1111101
    n1111101 -- 0 --> L_15_22
    n1111101 -- 1 --> L_16_25

    %% 111111... 最深层分支
    n11111 -- 1 --> n111111
    n111111 -- 0 --> n1111110
    n1111110 -- 0 --> L_189_335
    n1111110 -- 1 --> L_28_37

    n111111 -- 1 --> n1111111
    n1111111 -- 0 --> L_5_7
    n1111111 -- 1 --> n11111111
    n11111111 -- 0 --> L_7_11
    n11111111 -- 1 --> L_CUSTOM

    %% 样式优化以提升可读性
    classDef leaf fill:#e1f5fe,stroke:#0288d1,stroke-width:2px;
    classDef internal fill:#eceff1,stroke:#607d8b,stroke-width:1px;

    class L_2_3,L_1_2,L_3_5,L_5_8,L_10_19,L_3_4,L_4_7,L_1_1,L_7_10,L_8_11,L_11_18,L_11_20,L_11_28,L_18_25,L_1_phi,L_4_5,L_6_7,L_10_17,L_13_15,L_15_22,L_16_25,L_189_335,L_28_37,L_5_7,L_7_11,L_CUSTOM leaf;
    class root,n1,n11,n110,n1101,n11011,n111,n1110,n11100,n111001,n11101,n111010,n111011,n1111,n11110,n111100,n111101,n11111,n111110,n1111100,n1111101,n111111,n1111110,n1111111,n11111111 internal;
#gHR1Y$?-+]m.0xS3F!0{.UH{uDppW5u2^+s|6~(p@GwHH<N:?57K99\(s)~!G4`! 。我觉得这面国旗勉强才能塞进我们的格式:它的两侧边缘呈锯齿状,我用 11 个独立的矩形图层来编码。
英国米字旗 🇬🇧
可以说我在这儿稍微“取巧”了一下。英国国旗(Union Jack)虽然很常见,但用图层构建起来太复杂,所以我干脆把它作为一个内置形状直接写进了协议里。这样,旗标就不用去“搭建”它,只要指定“在左下角放一个英国国旗图层”就能完成放置。编码
我最初用 Base64 把位数据转换成可保存的文本。基于每个 ASCII 字节携带 6 个有效位,平均一个旗标定义需要 14 个字符,中位数是 12 个。最短的旗标代码是“QgA=”,代表印度尼西亚国旗。
不过,我决定改用 Base94,它使用从“!”到“~”的所有可见单字节 ASCII 字符,试图进一步提高编码效率。
我还考虑过基于 Emoji 的编码,但由于每个 Emoji 字符都需要超过 1 字节来存储,即使字符数量减少,总位数可能反而更多。(而且我也不想冒把某国国旗编码成“💩🤮👎”之类的风险……)
这样一来,旗标的平均长度降到了 12 个字符,中位数为 9 个。印尼国旗依然保持着最短编码:“<F”。渲染
我用 ChatGPT Codex 把这个格式转成了两步系统:一个编码器/解码器和一个 SVG 渲染器。 解码器首先将二进制数据块转换为可读格式。以我们前面拆解过的 🇮🇩 印尼国旗为例,它看起来是这样的:{
"aspectRatio": {
"kind": "rational",
"height": "2",
"width": "3"
},
"palette": [
{
"r": 210,
"g": 16,
"b": 52
},
{
"r": 255,
"g": 255,
"b": 255
}
],
"layers": [
{
"kind": "stripes",
"direction": "horizontal",
"stripes": [
{
"color": 0
},
{
"color": 1
}
]
}
]
}<svg xmlns="http://www.w3.org/2000/svg" viewBox="0 0 1.5 1">
<rect x="0" y="0" width="1.5" height="0.5" fill="#d21034"/>
<rect x="0" y="0.5" width="1.5" height="0.5" fill="#fff"/>
</svg>底层代码写得挺优雅,针对编码二进制部分和图层分别设计了独立的类和接口。但即便是经过 tsc 编译,编解码器也有 27kB,渲染器也有 12.5kB——在刚刚优化完源格式每一比特之后,这似乎有点超标。于是我又回到 Codex,让我造一个替代的“迷你解码器”:把解码和渲染合并成一步,扔掉那套漂亮的接口/类体系,把所有东西都简化为一些原生的小函数。
这样一来,最终变成了一个 470 行的 TypeScript 文件,编译后大小 5.29 kB(gzip 压缩后 2.66 kB)。
未被覆盖的旗帜
使用这种(相对原始的)格式,我成功编码了 128 面旗帜,但成效参差不齐。还有 67 面旗帜没能搞定,主要原因包括:
随机旗帜!
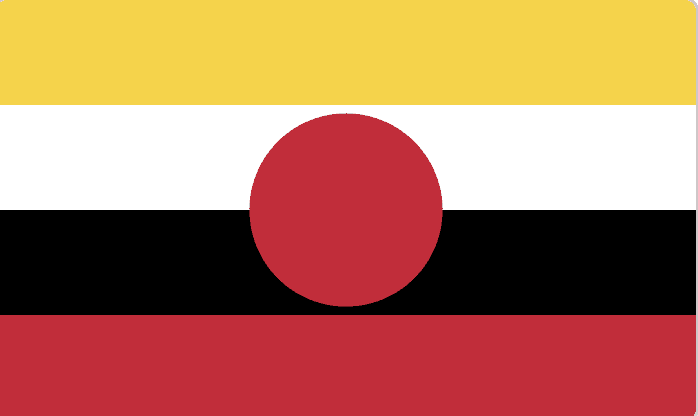
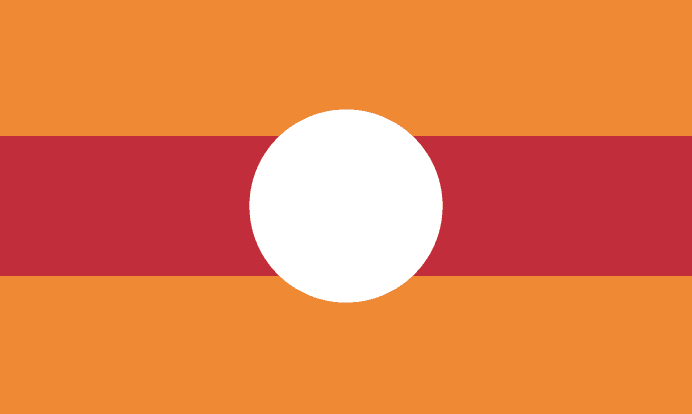
现在,我已经为 Flag 的可能形态构建了一套半结构化的语言体系,于是决定引入随机生成器,从现有的各个 Huffman 树中随机抽取元素来填充新的 Flag。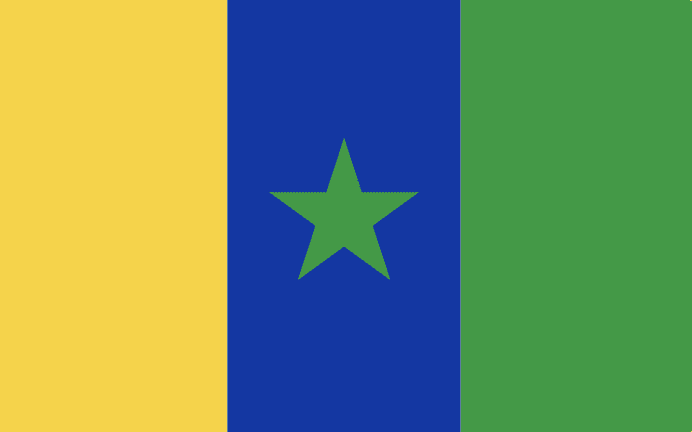

总而言之
我相信别人还能找到更多省位数的方法,或者完全不同的数据压缩和排布思路。不过整个过程确实挺有意思:从一份完整的旗帜列表出发,找出公共元素,再琢磨怎么把尽可能多的信息塞进有限的比特里。最终能把本科学的 Huffman Coding 用上、写点位级代码,也让整个过程更有趣了。最终带旗帜列表的页面在 https://vantezzen.github.io/miniflags/,源代码在这里。别期待那里的代码有多干净——说实话,最后基本是凭我格式方案的灵感随手写的。格式的所有细节文档在这里。编辑:看起来这篇文章在 HN 上有点小火了。 我看到很多合理且有价值的批评: “未能给大约 35% 的世界人口(约 30 亿人)所在地区的旗帜编码。”确实如此!我主要关注的是旗帜的几何结构,这样能很干净地转成 SVG,并清晰地分层。但也许我不该把它叫作“通用”的旗帜编码方案…… 我还看到了一些关于徽章(coat of arms)编码方式的巧妙建议——以后我可能会试着用它们来扩展解码器。 也谢谢提醒大家左上角那个“东西”叫“Canton”。
原始来源: Hacker News