
用记忆化(Memoization)将 eBPF CPU 开销降低约 90%
我和弟弟在设计这款 eBPF 安全 Agent 时,从一开始就花了大量精力让它尽可能快,但最近我们发现,利用记忆化(Memoization)可以进一步大幅提速。
前几周,我对 eBPF 代码做了性能分析,发现保护机制中最耗时的部分其实不是执行策略(允许/拒绝),而是确定针对特定文件打开操作该应用哪条策略。
我们的策略基于路径,因此 eBPF 代码利用了一个在文件打开时触发的 LSM 钩子。随后,系统会重建路径,遍历父级 dentry(目录项),并检查该文件或任意祖先目录是否匹配某条策略。虽然这套流程能正常工作,但性能并不理想。对于已经访问过的文件(例如数据库反复访问相同文件路径的情况),系统不得不重复执行大量工作。
于是,我们为每个 inode 缓存了其适用的策略。这一改动将内核 CPU 开销降低了约 90%。
此外,我们最近开源了代码仓库,本博文中提到的所有内容均可在 https://github.com/bomfather/agent 找到。
问题所在
引入缓存之前,每次文件打开操作都要遍历整条路径。流程大致如下:
- 获取文件路径。
- 通过 dentry 向上遍历文件路径。
- 在每一层级检查是否存在适用于该路径的策略。
- 综合各层结果得出最终策略,据此决定是允许还是拒绝访问。
这套流程虽然可行,但如果同一文件被多次打开,或同一子树下的多个文件被访问,系统就不得不对每个文件重复上述步骤。
举个具体的例子:在 Postgres 中,如果我们希望 Postgres 只能访问 /var/lib/postgres,可以配置如下策略:
policies:
  - executable: "filepath = /usr/lib/postgresql/16/bin/postgres"
    can_access_dirs:
      - "/var/lib/postgres:read"
接着,Postgres 会从 var/lib/postgres/data/base/123、var/lib/postgres/data/base/234 和 var/lib/postgres/data/base/345 获取文件。对于这几次文件访问,我们不得不每次都遍历完整的 dentry 路径,效率极低。
在本博文的后续部分,我将把这种低效的路径遍历称为“慢路径”。
缓存里存了什么?
我们的解决方案是引入缓存。但必须确保缓存本身开销足够低,且复用缓存项是安全的。
我们本来想用 dentry,但 dentry 是指针,而指针没法存进 eBPF map。如果非要用 dentry,可以把 dentry 的内容存到一个 struct 里,再拿这个 struct 当 map 的 key,但这个 struct 会相当庞大。
所以我们改用基于 inode 的缓存。缓存 key 包含三个字段:mount namespace ID、mount ID 和 inode 号。
不能只拿 inode 做缓存,因为 inode 号只在某个 mount 树内唯一(如果一条策略覆盖多个 mount 树,inode 就可能冲突)。mount ID 用来标识我们是从哪个挂载树观察到这个文件的,mount namespace ID 则防止在不同 namespace 里误用缓存条目。
缓存的 value 有两部分:一个 access_index 和一个缓存状态。为了节省空间,我们把策略存成位掩码(bitmask),access_index 就是路径策略所在的位偏移(https://nathannaveen.dev/posts/optimizing-ebpf-policies-for-speed-and-space/)。
于是,我们的缓存连同 key 和 value 大致长这样:
#define INODE_POLICY_CACHE_NO_POLICY 0
#define INODE_POLICY_CACHE_ACCESS_INDEX 1
#define INODE_POLICY_CACHE_GLOBAL_READ_ONLY 2
#define INODE_POLICY_CACHE_ACCESS_INDEX_AND_GLOBAL_RO 3

struct inode_cache_key {
    u64 mntns_id;
    u64 mount_id;
    u64 inode;
};

struct inode_policy_cache_value {
    u32 access_index;
    u8 state;
};

struct {
    __uint(type, BPF_MAP_TYPE_LRU_HASH);
    __uint(max_entries, 10000);
    __type(key, struct inode_cache_key);
    __type(value, struct inode_policy_cache_value);
} bomfather_inode_policy_cache SEC(".maps");
有了缓存之后,整个流程是这样的:
- 构建缓存 key。
- 在 LRU 哈希表里查找这个 key。
- 如果命中,直接根据缓存结果决定是否允许打开文件。
- 如果未命中,走慢路径,并把结果存入缓存。

性能变化
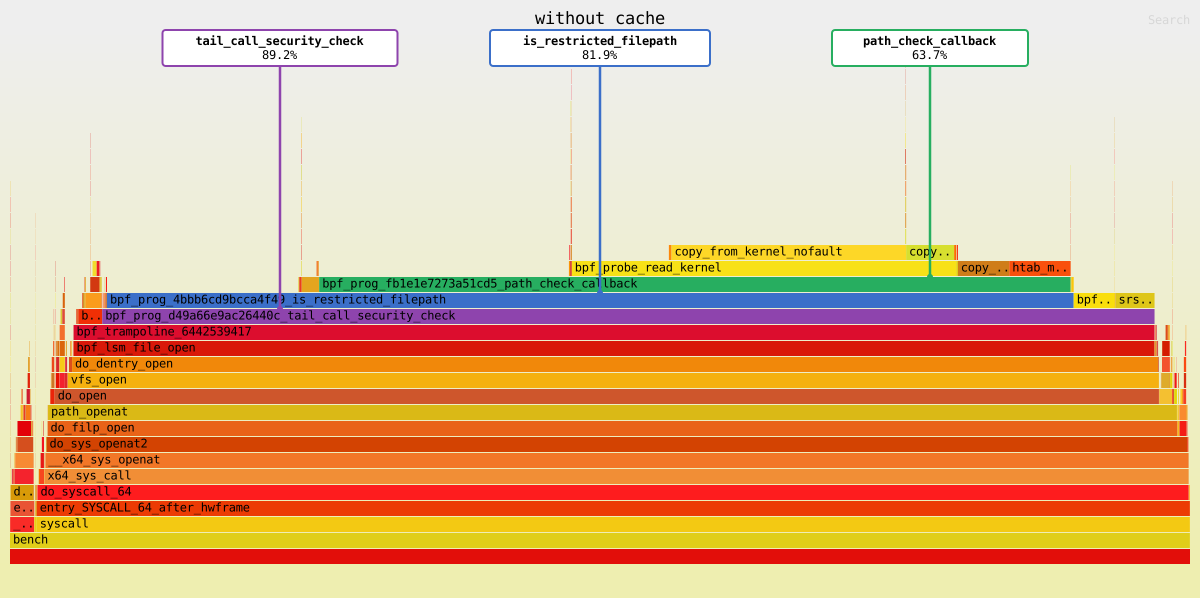
基准测试中,我们打开同一文件 20 万次以分析性能;缓存将内核周期从 280 亿降至 30.3 亿。没有缓存时,tail_call_security_check、is_restricted_filepath 和 path_check_callback 分别占用栈空间的 89.2%、81.9% 和 63.7%。
在下方的火焰图中,开启缓存后,路径遍历的开销在首次查询后几乎完全消失。例如,is_restricted_filepath 和 path_check_callback 各自缩减至约 0.02%,小到在图表上基本不可见。
优化前(无缓存):
优化后(有缓存):
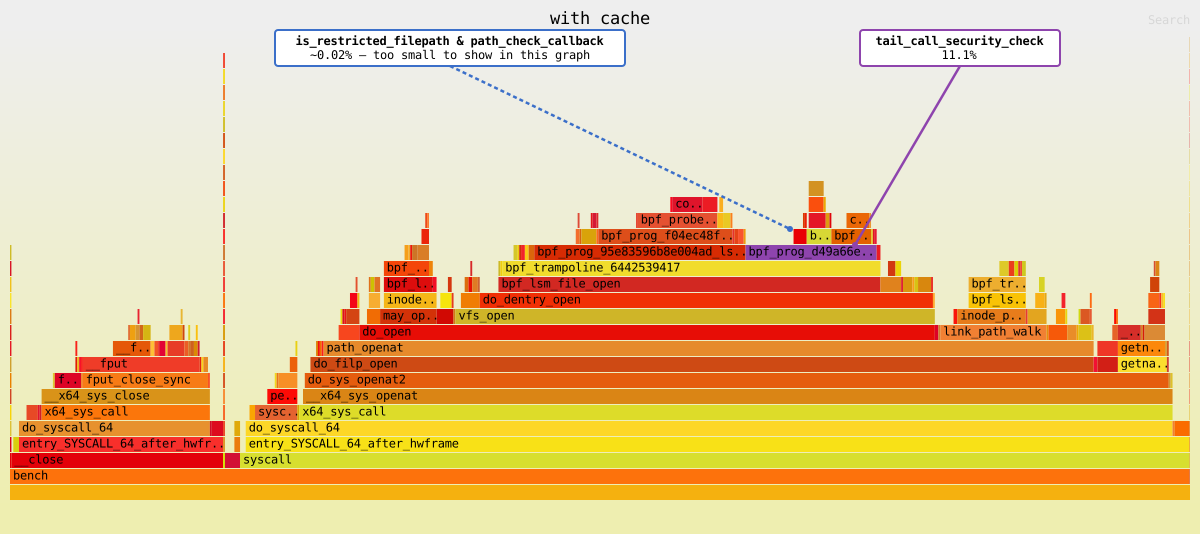
使用 perf 的 cycles:k 事件对内核 CPU 进行性能剖析,以衡量文件打开过程中的内核侧 CPU 开销。
边缘情况
针对这个缓存,我们必须考虑的一个因素是多个路径可能共享同一个 inode。硬链接是最典型的例子:通过硬链接,两个不同的路径可以指向同一个 inode。这是个严重问题,因为结果的准确性比缓存性能更重要。
我们的方案更偏向于一种变通措施,而非根本解决方案。inode 包含链接计数(i_nlink),指示有多少路径指向该 inode;我们可以读取此值,若大于 1,则不使用该缓存条目,回退到慢速路径。
if (BPF_CORE_READ_INTO(&nlink, inode, i_nlink)) {
    return false;
}

if (nlink != 1) {
    inode_cache_stats_inc(INODE_CACHE_STATS_SKIPS_NLINK);
    return false;
}
这是一种权衡,因为牺牲了部分缓存覆盖率,但我认为问题不大,因为缓存的准确性才是首要考量。
结语
最终,这个项目非常有意思,因为为了落地这套缓存,我必须反复试验多种不同的设计思路。
我很高兴缓存完全是内部实现的,这样一来用户无需修改策略,代理就能提速!