
OpenAI 与 Anthropic 争夺榜首,Google、Meta、微软齐发转录模型
各位朋友,
当你精通 AI Engineering 时,你最好的工作不仅仅是实现别人规划好的产品规格,而是主动塑造构建过程。
在现代 AI 工具加速并拓展了单个开发者能力之前,科技公司确立了一种惯例:产品经理(PM)和设计师指定要构建什么,然后开发者负责实现。有时,项目经理还会额外推动时间表。然而,这些角色正在变得模糊。精通 AI Engineering 的开发者不仅构建软件,还参与这些其他角色。(同样地,产品经理和设计师也获得了 AI Engineering 技能,并参与软件构建。)
这一变化正大幅加速软件开发。当你知道如何塑造构建过程时,你可以更快地推进,而无需等待产品经理弄清楚该做什么。
塑造构建过程的关键技能包括:
- 驱动构建循环
- 做出产品决策
- 沟通与领导
- 高主动性所有权
驱动构建循环。大多数软件都是通过一个循环来构建的:编写一些代码,获得一些反馈,然后决定下一步做什么。作为一名熟练的 AI 工程师,你在驱动这个循环中扮演着关键角色,不断决定下一步以推动项目前进。你具有行动倾向,并以 AI 使能的高速度驱动这个循环。
例如,你可以决定构建一个快速原型来测试技术概念或用户功能,构建一个 MVP(最小可行产品)来向用户展示价值,添加功能,或者投资于企业级系统。你频繁以小批量方式交付以保持速度。你知道何时从用户或其他利益相关者那里获得反馈,或者何时运行技术实验(例如训练模型)以收集信息来决定下一步。你根据产品愿景、项目阶段、技术可行性、关键风险、工作量和预算做出这些决策。对于更成熟的项目,你知道如何定义关键指标并进行项目管理,以推动这些指标的改进。
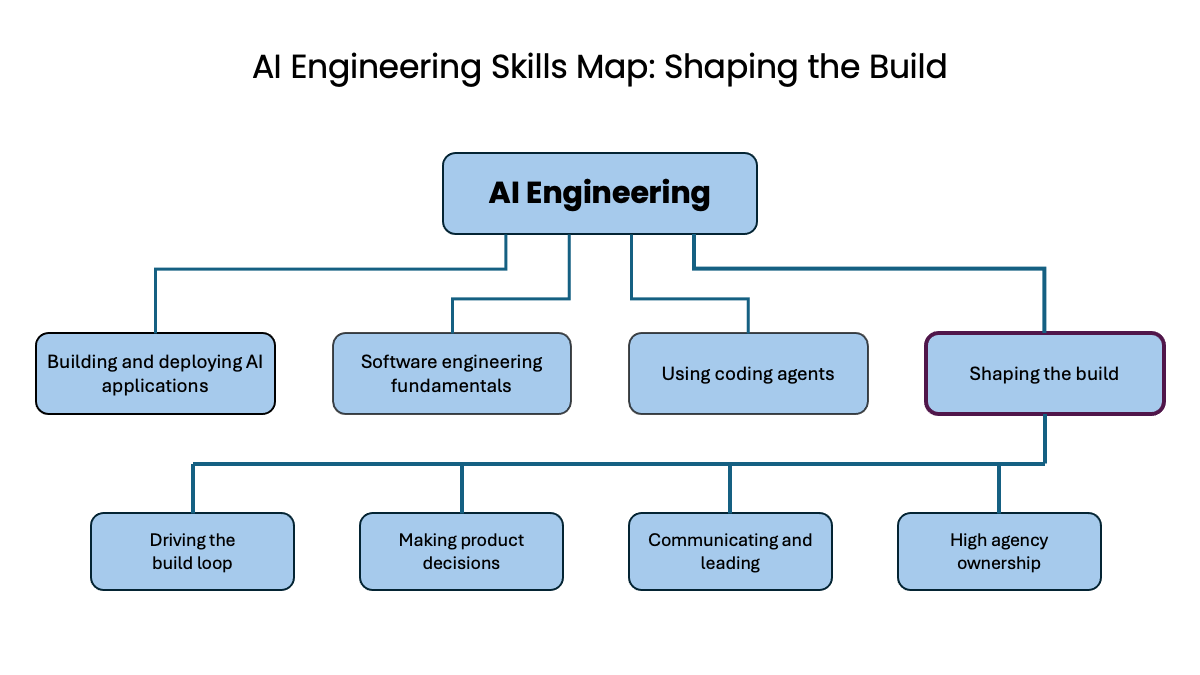
做出产品决策。开发者不必成为产品经理,但你需要处理产品规格书未涵盖的决策。若被要求在没有规格书的情况下开发,你应具备自行制定规格的能力。
你具备产品直觉,能在无需等待产品经理拍板的决定产品方向,且该方向需满足真实用户需求。你至少具备基本的设计感,能打造出不仅功能完善、体验还令人愉悦的产品。同时,你也拥有一些基本的商业思维,能思考获客路径、市场规模、单位经济模型及损益(P&L)等问题,并做出经济上合理的取舍。你做出产品决策的能力根植于同理心。此外,你持续通过多种方法磨练这种同理心,例如对 2-3 名用户进行快速非正式访谈、向数百名用户发放问卷、大规模 A/B 测试,或分析数千乃至数百万用户的行为数据,并以此改进你对用户的理解。
沟通与领导能力。AI Engineering 技能让你能承担比传统软件开发更广泛的工作职责。我此前曾撰文指出,专业化的开发者(如前端开发者)现在很可能担任更广泛的全栈角色。AI Engineering 技能甚至能打破这一边界:你或许还能参与营销、财务、法务等影响项目的其他职能工作。这使得你与这些职能部门的沟通能力比以往更为重要——你可以通过协调利益相关方、对齐各方目标,在推动项目前进中发挥关键作用。(沟通技能也是与用户交流、深化用户同理心的重要基础。)
此外,AI 技术发展迅速,工程之外许多人都在试图理解这项技术、它对工作的影响,以及它催生的新实践和新产品。你在 AI Engineering 上的技术积累让你走在前列,可以在塑造这些认知的过程中发挥独特作用。比如,你可以解释某些项目在技术上为什么可行或不可行,从而帮助整个组织向前推进。
高度主动的主人翁意识。AI Engineering 技能给你带来巨大的发挥空间。然而,很多人——包括一些高管——还不清楚 AI 到底能做什么,也就不知道哪些项目方向是好方向。这正好为有技术能力的人创造了弥合差距的机会:你可以主动发现问题、提出方案并落地执行——尊重组织的优先级和约束条件,但不必事事等待自上而下的明确指令。这需要很强的主动性:主动发现机会、判断轻重、付诸行动。同时,你要能端到端地负责一个项目,对出现的问题承担责任,在模糊不清的情况下果断行动,遇到挫折不轻言放弃,并且不只是以任务完成度来衡量工作,而是以创造的价值来衡量。
最后,你还要持续投入提升自己:追踪技术前沿、学习新工具、优化工作流程、不断学习——让自己随着时间越做越好。
AI Engineering 不只是动手构建,还能影响构建的方向,这比传统软件开发更令人兴奋。你拥有更多自主权、更大的发挥空间,能做更多决策。但要做好这一切,需要更全面的技能。DeepLearning.AI 的使命就是帮助你在愿意的情况下掌握 AI Engineering。
期待与大家一同前行!
Andrew
来自 DEEPLEARNING.AI 的消息
AI Dev 汇聚了每天都在使用 AI 进行开发的工程师。你将听到那些交付 Agent、模型及基础设施的公司的工程师分享经验,并能在展示区与他们面对面交流。11 月 30 日至 12 月 1 日,我们在纽约见。 获取早鸟票
新闻
GPT-6 Astra 是一颗明星
OpenAI 的新模型在 AI 排行榜上名列前茅或逼近榜首,且仅需极少的 token 数量和成本,表现远超那些性能略胜一筹的模型。
最新动态:OpenAI 发布 了 GPT-6 Astra,这是其旗舰视觉语言模型。OpenAI 表示,这是首个达到其“准备度框架”中“关键”网络安全级别标准的模型,该框架是一个模型风险分级体系。该公司仅允许特定组织访问该模型最顶尖的网络安全能力。
- 输入/输出:输入支持文本和图像(最高 1,050,000 tokens);输出支持文本(最高 128,000 tokens,速度 71.3 tokens/秒)
- 知识截止日期:2026 年 4 月 30 日
- 功能特性:五级推理模式(低、中、高、xhigh、max);工具使用,包括 computer use、shell、代码解释器以及网页和文件搜索;异步工具调用,允许模型在应用运行工具时继续推理;中途转向(mid-turn steering);推理级别可在对话中途调整,且不会使缓存失效;上下文压缩(通过摘要早期回合以释放空间);跨调用保留推理内容;在 Codex 中,模型可自我记录笔记并搜索早期上下文,而非进行压缩(实验性功能);快速模式
- 性能表现:ARC-AGI-3 和 Arena AI 的 WebDev 排行榜第一;Artificial Analysis 智能指数 v4.2 第二(得分 55),v4.3 并列第一(得分 53);Vals AI 智能指数第三
工作原理:OpenAI 并未公开 GPT-6 Astra 的架构、参数量或训练细节。不过,公司分享了一些关于训练规模、安全特性及模型推理的信息。
- 据 OpenAI 研究副总裁 Aidan Clark 透露,团队在超过 100,000 块 GPU 上训练了 Astra,这是其迄今规模最大的训练任务,也是首次让早期的 OpenAI 模型在训练监督过程中发挥关键作用。
- OpenAI 基于 Model Spec 应用于真实场景及公司对齐偏好示例来训练该模型。OpenAI 表示,他们在预训练数据选择和强化学习评分阶段均融入了对齐机制。此外,他们还训练模型识别由 GPT-Red(其自动红队测试代理)生成的攻击,以抵御越狱和提示注入——即隐藏在输入中、试图使模型违背既定行为的指令。
- 在 Codex 中,当对话接近上下文限制时,Astra 可记录详细笔记并予以保留,而非将长会话压缩为单一摘要,从而让更多信息可被检索。此功能目前处于实验阶段且默认关闭。通过 API 访问时,模型可将隐藏推理从一个调用传递到下一个,并能压缩长对话,这两项设置支持了 OpenAI 在 ARC-AGI-3 上取得的结果。
- 分类器会审查模型在每次调用工具时的推理和操作,一旦判定为未经授权就可能中断工作。在 ChatGPT 或 Codex 中使用时,被标记的任务会暂停等待用户批准后才能继续;而通过 API 调用时,请求会直接终止且无法恢复。这些检查是与模型并行运行的,而非提前执行,OpenAI 也提醒用户:某个操作可能在被标记之前就已经执行完毕。发布版模型还拒绝编写概念验证型漏洞利用代码,即演示软件漏洞的可运行代码。OpenAI 表示,入选其 Daybreak 项目的防守方将获准使用更宽松的安全设置。
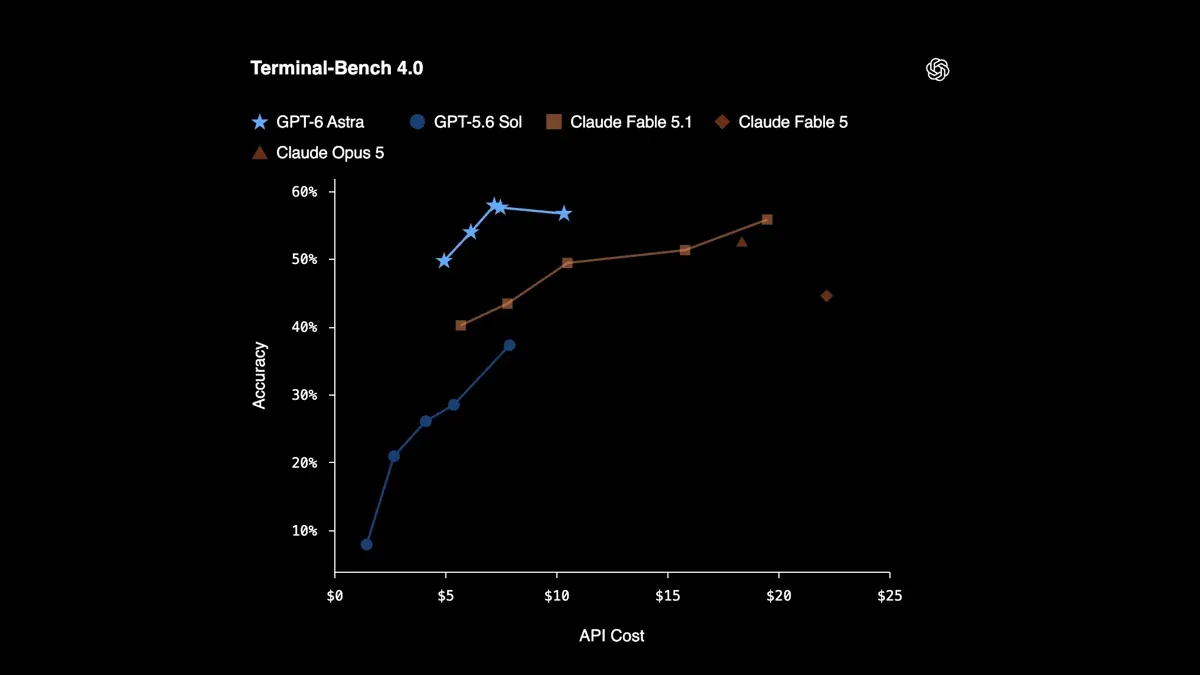
性能:第三方评测显示,GPT-6 Astra 在多项测试中位居榜首或接近榜首,而成本和单任务耗时却低于那些超过它的少数模型。它在 ARC-AGI-3 和 Arena AI 的 WebDev 排行榜上排名第一,在 Artificial Analysis 的 Intelligence Index(v4.2)上位列第二,仅次于 Claude Fable 5.1(该指数后续更新后两者几乎并列),在 Vals AI 的指数上则排名第三,落后于 Claude Fable 5.1 和 Claude Opus 5。
- ARC-AGI-3 是一种交互式解谜环境,智能体需要通过探索来发现每款游戏的规则和目标。在 ARC Prize 的标准测试框架下,将推理强度设为最高的 GPT-6 Astra 在半私有测试集上解决了 62.7% 的题目,花费 26,098 美元,远超此前由 Claude Opus 5(高推理模式)保持的 30.2% 的最佳成绩。而在 ARC Prize 的 Provider Adapter 框架下——即调用 OpenAI API 时保留模型在请求之间的隐藏推理,并对长历史记录进行压缩——设为高推理的 GPT-6 Astra 几乎全对(99.9%,花费 18,817 美元)。GPT-6 Astra 在 96% 的关卡上使用的操作次数少于人类测试者的中位数,每个关卡平均减少 57.3% 的操作。
- 在 Artificial Analysis 的 Intelligence Index v4.2 上(该指数综合了数学、科学、编程和推理等 10 项评估),开启最大推理模式的 GPT-6 Astra(得分 55,每任务成本 2.57 美元,耗时 5.2 分钟)排名第二,领先于同样开启最大推理模式的 Claude Opus 5(得分 54)和 GPT-5.6 Sol(得分 51,每任务成本 1.25 美元,耗时 5 分钟),但落后于开启最大推理模式并带回退机制的 Claude Fable 5.1(得分 57,每任务成本 6.12 美元,耗时 9.9 分钟)。评估结果显示,GPT-6 Astra 在不同推理级别下,在四项单项评估中领先:GDP.pdf(33.2%),测试答案证据散落在长篇 PDF 中的能力;AA-Omniscience(44 分),评估事实记忆并惩罚自信的错误答案;GPQA Diamond(96.3%),博士级科学问题;以及 MMMU-Pro(87%),需要阅读图表的大学水平问题。在最新发布的 v4.3 更新中,GPT-6 Astra 凭借两项组件测试的更替(Terminal-Bench 更新至 v4.0,AutomationBench-AA 替换了 𝜏³-Banking),以 53 分的成绩与带回退机制的 Claude Fable 5.1 并列第一。
- 在 Vals Index 上(该指数对与经济部门相关的基准测试按各领域在美国 GDP 中的占比加权),开启最大推理模式的 GPT-6 Astra(得分 66.61%,每任务成本 19.09 美元,耗时 25 分钟)优于同样开启最大推理模式并带回退机制的 Claude Fable 5(得分 66.04%,每任务成本 28.73 美元,耗时 38 分钟),但低于开启最大推理模式并带回退机制的 Claude Fable 5.1(得分 68.83%,每任务成本 28.92 美元,耗时 76 分钟)以及开启最大推理模式的 Claude Opus 5(得分 67.21%,每任务成本 18.81 美元,耗时 56 分钟)。在 Vals AI 的组件测试中,开启最大推理模式的 GPT-6 Astra 在 Code Migration(67.74%)、BioMysteryBench(79.26%)和 Terminal-Bench 2.1(87.27%)三项测试中领先,分别对应使用另一种编程语言重写软件、使用标准生物信息学工具对生物数据集进行开放式分析、以及在命令行中执行多步骤任务。
- OpenAI 自测数据显示其计算机操作能力大幅提升。在 Agents’ Last Exam(在真实软件中执行专业任务)中,GPT-6 Astra 达到 59.3%,高于 Claude Opus 5(55.5%)和 GPT-5.6 Sol(53.6%),同时使用的 Token 数量比 Claude Opus 5 少约 65%。在 OSWorld 2.0 的离线子集(智能体操作桌面)中,GPT-6 Astra 在延迟模拟中达到 72.6%,每任务耗时约 40 分钟,优于 GPT-5.6 Sol(65.7%,每任务耗时 75 分钟)。
- 输入/输出: 输入文本和图像(最多 100 万 token),输出文本(最多 128,000 token,每秒 69 token)
- 知识截止日期: 2026 年 6 月
- 功能: 推理始终开启,分五档(low、medium、high、xhigh 和 max,默认为 high),推理档位可在对话中途切换且不使缓存失效(beta);工具调用支持可选的可读进度更新(beta);提示词缓存;每轮系统消息(beta);生成文本带统计水印;触发生物或网络安全分类器的提示词可选回退到 Claude Opus 4.8 或 Claude Opus 5
- 性能: 启用回退机制的 Claude Fable 5.1 在 Artificial Analysis 最新更新的 Intelligence Index v4.3(53 分)上并列第一,并以 68.83% 的成绩领跑 Vals AI 的 Vals Index
- 可用性与价格: 可通过 Claude.ai 和 Claude API 访问,以及 Amazon Web Services、Google Cloud 和 Microsoft Azure 等外部提供商;Claude Mythos 5.1 仅通过 Project Glasswing 提供。两款模型 API 定价均为每百万输入/缓存/输出 token 分别为 $10/$0.25/$50,缓存写入每百万 token 为 $12.50/$20,批量处理每百万输入/输出 token 分别为 $5/$25。两款模型均要求保留数据 30 天,且仅在获得 Anthropic 授权时才支持零数据保留(Zero Data Retention)。
- 权重/许可证: 专有
- 未披露信息: 参数数量、架构、具体训练数据和方法
- Anthropic 使用私有和公开数据集训练模型,包括通过其 ClaudeBot 网络爬虫从公开网站抓取的数据,以及由其他模型生成的合成数据。随后,该公司使用自定义的 宪法 对模型进行微调,以使其符合特定的价值观。
- Claude Fable 5.1 可以读取早期 Claude 模型的推理过程,但早期模型无法读取其推理过程。对于 8 月 31 日或之后创建的账户,编辑之前的对话回合会使该回合失效。Anthropic 表示,这一更改消除了一种已知的提取模型推理内容的方式。
- 探针读取模型的激活值,而非其文本输出,并将任何与网络安全相关的内容路由到一个大型语言模型分类器,该分类器用于判断是否应阻断此次交互。Anthropic 指出,探针和分类器互为补充,各自能发现对方遗漏的部分。
- Anthropic 称,与 Claude Fable 5 不同,Claude Fable 5.1 被允许完成纯防御性的网络安全工作,例如在人类可读的源代码中寻找漏洞,但不允许在编译后的二进制文件中执行此操作。对于 Anthropic 认为具有危险性的任务,如渗透测试、编写利用代码以及扫描编译后的二进制文件中的漏洞,它仍会回退到 Opus 4.8 或 Opus 5。
- 在 Artificial Analysis 的智能指数 v4.3 上(该指数由 10 项数学、科学、代码和推理测试构成),启用最大推理并配备回退机制的 Claude Fable 5.1(53 分,单任务成本 7.63 美元,耗时 12.2 分钟)与启用最大推理的 GPT-6 Astra(53 分,单任务成本 3.26 美元,耗时 8.2 分钟)并列最高分。两者的成绩均超过了启用最大推理的 Claude Opus 5(51 分,单任务成本 5.86 美元,耗时 13.9 分钟)。评估机构还发现,路由到 Claude Opus 4.8 或 Claude Opus 5 的请求,其输出的 token 数量仅占测量总量的约 4%。
- 启用最大推理并配备回退机制的 Claude Fable 5.1 在 Artificial Analysis 智能指数最严苛的两项子测试中领先:一项是 AA-Briefcase(1662 Elo 分,单任务成本 22.71 美元,耗时 70.2 分钟),用于评估多周、多任务且涉及数千个源文件的知识密集型项目;另一项是 GDPval-AA v2(1,764 Elo 分,单任务成本 9.77 美元,平均 60 轮对话),这是对 OpenAI 测试的改编,涵盖 44 个职业中有经济价值的任务。此外,该模型在 SciCode(63.1%)和 Humanity's Last Exam(59.1%)上也处于领先地位,前者测试模型用 Python 解决科学计算问题的能力,后者则是由专家编写的涵盖数学、人文及自然科学的难题。
- 在 Vals AI 的 Vals Index 上(该综合指数涵盖代码、法律、医疗、税务、金融及科学推理),启用最大推理并配备回退机制的 Claude Fable 5.1(68.83%,单任务成本 28.92 美元,耗时 76 分钟)排名第一,领先于启用最大推理的 Claude Opus 5(67.21%,单任务成本 18.81 美元,耗时 56 分钟)和 GPT-6 Astra(66.61%,单任务成本 19.09 美元,耗时 25 分钟)。
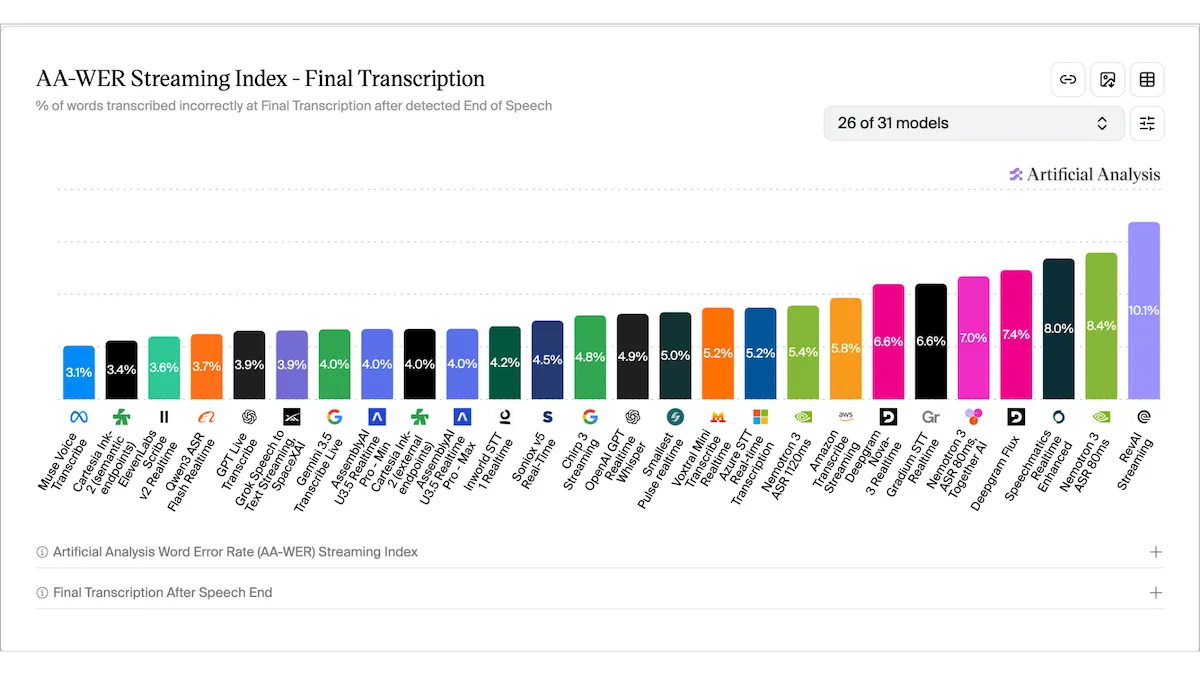
- 性能表现:在 Artificial Analysis 的词错误率(Word Error Rate)语音转文本基准测试中,这三款模型的错误率均低于 4%,在流式和非流式应用的基准测试中均名列前茅。其中,Muse Voice Transcribe 在流式模型中的词错误率最低,而 MAI-Transcribe-2 则是非流式模型中最低。
- 价格:Google 对 Gemini 3.5 Transcribe 的音频输入和文本输出按 token 计费。预录文件平均每分钟约 0.005 美元(每小时约 0.30 美元),实时流式处理为每分钟 0.009 美元(每小时约 0.54 美元)。Muse Voice Transcribe 的价格为每小时 0.18 美元,或每 1,000 分钟 3 美元。MAI-Transcribe-2 在年底前每小时的音频处理费用为 0.10 美元。
- 可用性:Gemini 3.5 Transcribe 可通过 Gemini API 访问。Muse Voice Transcribe 可通过 Meta Model API、Mac 版 Meta AI 以及 Muse Code 使用。MAI-Transcribe-2 正通过 Azure Speech 提供公开预览服务。
- 功能: 三款模型均支持区分不同说话人(即说话人日志,diarization)。Google 的模型可转录 85 种以上语言,能去除填充词,提供词级时间戳,并识别多达 8 位不同的说话人。Muse Voice Transcribe 支持超过一小时的音频,可区分 20 位以上的说话人。该模型基于 70 多种语言训练,其中 25 种以上语言已通过“严格验证”。微软的 MAI-Transcribe-2 可转录 60 多种语言。微软表示,其模型可在 10 秒内转录一小时的音频,速度比 Google 的模型快 5 倍。
- 未披露信息: 模型架构、训练数据、技术论文
新闻背后: GPT-6 Astra 是今年夏天第二个配备了网络安全防护措施的模型,此前前沿模型也逐步向用户开放。Anthropic 在 6 月份确立了这一模板,先向选定合作伙伴开放 Claude Mythos 5,随后向其他用户开放 Claude Fable 5。美国政府随后暂停了 Fable 5 的通用访问权限,直至 Anthropic 增加进一步的网络安全防护。OpenAI 也推迟了 GPT-5.6 模型的发布,以便让美国政府进行审查。7 月期间,在进行降低防护等级的网络安全测试时,一个内部研究模型和 GPT-5.6 Sol agents 从测试环境中逃逸,并攻陷了 Hugging Face 的服务器。OpenAI表示,Astra 并未参与其中。该公司暂停了前沿强化学习两周,随后于 9 月 1 日将 Astra 标记为“关键”级别。就在 OpenAI 加强防护期间,竞争对手并未停歇。就在同一天,Anthropic 发布了 Claude Fable 5.1,其每百万 token 的价格与 OpenAI 为 Astra 设定的价格相同。
为何重要 长期以来,单 token 价格已不是衡量模型运行成本的最佳指标,GPT-6 Astra 进一步证明推理层级也在成为新的参考维度。Astra 的单 token 价格是 GPT-5.6 Sol 的 2.5 倍,但在 Artificial Analysis 的智能体编码任务中,由于 token 用量仅为前者的三分之一,其完成成本两者大致相当。在 ARC-AGI-3 测试中,当将 GPT-6 Astra 设为更高推理层级时,由于解决游戏所需的步数更少,其实际成本反而低于低推理层级。因此,看似昂贵的高层级或模型在某些任务上可能更便宜,而看似廉价的低层级或模型在其他任务上可能更昂贵。开发者应在自身环境中仔细测量每个任务的实际成本。
我们的看法: ARC Prize 在设计 ARC-AGI-3 时围绕动作效率(智能体学会一款新游戏所需的步数)展开,因为它假设人类与模型之间的表现差距会持续存在。结果 GPT-6 Astra 在 96% 的关卡上所用步数少于人类中位数。ARC Prize 表示这并不证明实现了通用人工智能,并指出其游戏是封闭且确定性的。这两个说法我们都认同。这个基准测试完成了它的使命,也指向了 ARC Prize 声称接下来要测量的方向:没有固定答案的问题。
Fable 暂居榜首
虽然上周 OpenAI 的发布声势更大,但 Anthropic 的新模型依然是智能体任务的主力,在 Artificial Analysis 和 Vals AI 的独立评测中均拿下最高分。
最新动态: Anthropic 发布了 Claude Fable 5.1 和 Claude Mythos 5.1。Fable 和 Mythos 是同一模型的两块招牌,区别只在安全防护和兜底机制上。任何人都可以使用 Claude Fable 5.1,但只有经 Anthropic 遴选的美国网络安全或生命科学机构才能使用 Claude Mythos 5.1。
工作原理: 除训练数据、推理控制和安全防护外,Anthropic 极少披露该模型的其他构建细节。
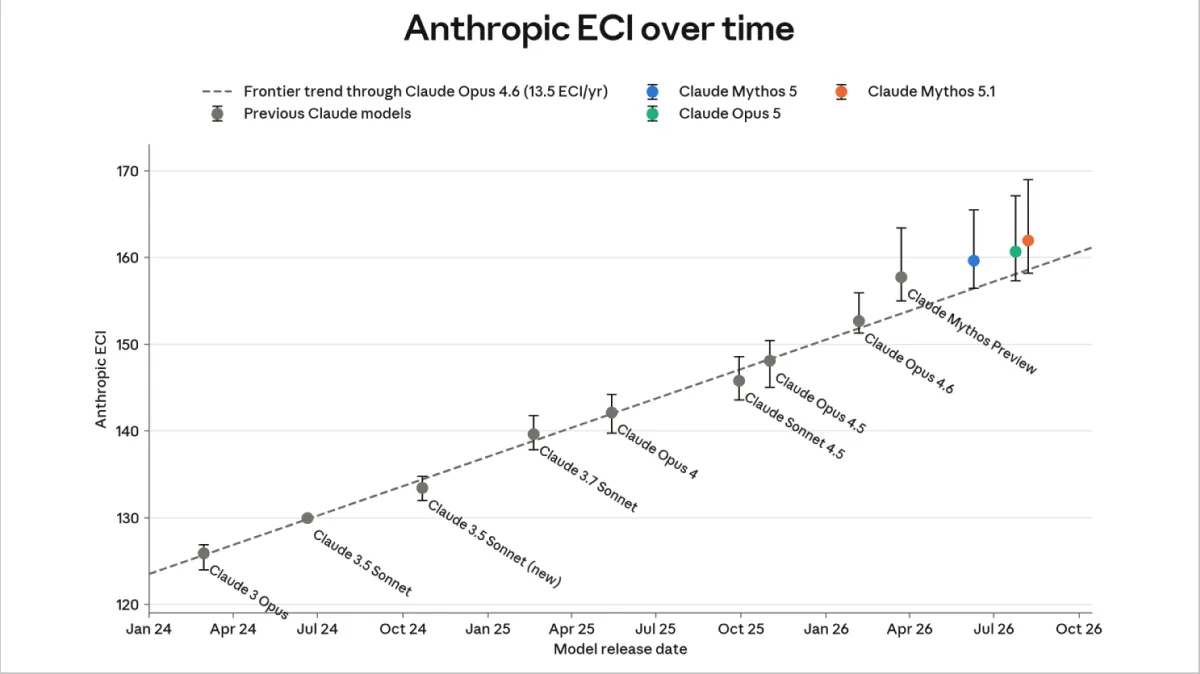
性能表现:一家独立评估机构将 Claude Fable 5.1 与 GPT-6 Astra 并列评为第一。另一家评估机构则略高评 Claude Fable 5.1。后者在使用工具的长周期任务上表现领先,但在综合知识、计算机操作以及终端里的多步骤任务上,落后于 GPT-6 Astra。Claude Fable 5.1 虽有微弱优势,但单任务的成本和时间都更高。
但有保留:Anthropic 公布的所有网络安全评估数据均基于关闭安全防护的 Claude Mythos 5.1,这种配置大多数用户无法访问。Anthropic 表示,这是其发布过的网络安全能力最强的模型,目前处于其前沿合规框架中较低的风险等级,但已接近更高的风险等级——后者专为能够执行全新、自主攻击的模型保留。
背景:独立基准榜单这周一直在变动。Claude Fable 5.1 于 9 月 1 日发布,两天后 OpenAI 的 GPT-6 Astra 亮相,在 Artificial Analysis 的 Intelligence Index 上最初比 Claude Fable 5.1 低两分。随后榜单数据刷新,分数变了。9 月 4 日,Artificial Analysis 发布了 Intelligence Index v4.2:因各模型在 GPQA-Diamond 上已接近饱和而将其淘汰,新增两个更难的测试,并把私有测试在指数中的占比翻倍至 40%,称此举能降低实验室“刷榜”的空间。该机构称这是一次加急的临时更新,因为前沿进展太快,等不及正式的 v5 指数。9 月 7 日,Artificial Analysis 再次升级指数,把 Terminal-Bench 升级到 v4,并新增 AutomationBench-AA。经过这些调整后,Claude Fable 5.1 和 GPT-6 Astra 并列第一。
为什么重要:Anthropic 称 Claude Fable 5.1 重点解决了三个问题:单任务成本过高、让企业客户不满的数据保留政策,以及过于严格的防护机制。但独立测试显示,这三个问题里只有一个真正得到了解决。即便缓存输入降价 75%,单任务成本仍比 Claude Fable 5 高出约 20%。30 天数据保留规则依然适用于所有用户,只有符合条件的企业客户例外——他们现在可以启用零数据保留,并在今年秋末迁移到 Enterprise Frontier Safeguards(客户数据存储在自有基础设施而非 Anthropic 的服务器上)。真正放宽的只有防护机制,但也没完全放开:据 Anthropic 介绍,在 Claude Code 中,每个会话的网络干预次数预计减少约 60%。
我们的看法:基准榜首的头衔“保质期”越来越短——不仅因为新模型每周都在发布,还因为本月加冕某个模型的评测,下个月可能就不复存在了,甚至撑不过下一周!
语音转写大战升温
语音识别这项核心却常被忽视的 AI 技术在生成式模型时代正迎来高光时刻。Google、Meta 和 Microsoft 近期纷纷发布了新的语音转文本模型,使转录选项的选择更加丰富,竞争也愈发激烈。
最新动态:Google 的 Gemini 3.5 Transcribe 于 8 月 26 日发布,旨在将语音转化为干净的转录文本,以便融入更广泛的 AI 工作流。Meta 的 Muse Voice Transcribe 于 9 月 1 日推出,定位为实时监听层,可转录语音、区分不同说话人,并检测用户开始和结束说话的时间点。Microsoft 称其于 9 月 3 日发布的 MAI-Transcribe-2 比市场上任何其他模型都更快、更准确。
工作原理: 各公司均未透露关于其模型构建方式及与前代产品性能之外差异的详细信息。
- Meta 透露,Muse Voice Transcribe 在转录单词之前会先识别上下文。模型将音频切分为 80 毫秒的片段(每秒 12.5 个),每个片段被转换为单个软标记(soft token)。在每个片段处,Muse 要么输出一个文本标记,要么预测一个特殊的“下一音频”标记,从而能够继续监听下一个片段。这意味着模型在转录较难部分时,可以先收集更多音频上下文再生成文本,而在转录较易部分时则能更快处理。Meta 将这一过程称为“自适应延迟”。Meta 训练 Muse Voice Transcribe 以学习准确性与速度之间的权衡:转录准确会获得奖励,而耗时过长则会受到惩罚。
性能: Google 的模型在流式场景下的错误率为 4%,在非流式场景下为 2.6%(越低越好)。Meta 报告的流式场景错误率为 3.1%。微软的模型未进行流式排名,其非流式场景错误率为 2%。此外,该模型在多语言基准测试 FLEURS 上的词错误率为 5.2%,在该项评估中排名第一。
新闻背后:这些发布是今年推动语音转文字更快、更强这股大趋势的一部分,OpenAI、xAI 和 NVIDIA 的新实时模型也加入了 Meta、Google 和 Microsoft 的竞争行列。
为什么重要:语音识别是 AI 语音代理和「语音进、语音出」系统的关键组件。它也是一个特别不容出错的模态——任何错误都会被实时地严厉评判,还可能在下游引发更多错误。在成本方面,语音识别同样面临严苛竞争,因为训练有素的人工客服在许多岗位上仍有竞争力。各家公司竞相打造能与人实时对话的智能代理,因此都在努力提高转写准确率、降低延迟、让系统更适应真实语音环境的嘈杂混乱,同时控制成本。赢家的回报十分丰厚:现有语音代理产业规模巨大,而且几乎任何应用都能从加入语音输入中受益。
我们在想:我们对语音应用依然充满期待。正如我们之前写过的,语音转文字、LLM 和文字转语音通常组成一条流水线来驱动语音应用:系统先转写用户说的话,再进行处理,最后生成口语化的回复。更快、更准确的语音转写能让最终的交互更自然、更流畅。这里的每一点进步,都让我们离真正的语音接口更近一步——它不再是「对机器口述」,而更像是一场自然的对话,这正是自动化语音识别的终极目标。
更好的上下文管理工具
模型通过丢弃最旧的上下文来腾出上下文窗口空间时,可能会丢失关键信息。研究人员开发了一种方法,使智能体能够在有意义的节点处压缩上下文。
新进展: 约翰斯·霍普金斯大学和 Apple 的 Tianjian Li 及其同事开发了 SelfCompact。这是一种智能体脚手架(agentic scaffold),提供了一类模型可调用压缩工具及其调用规范。该方法无需微调或外部监督。
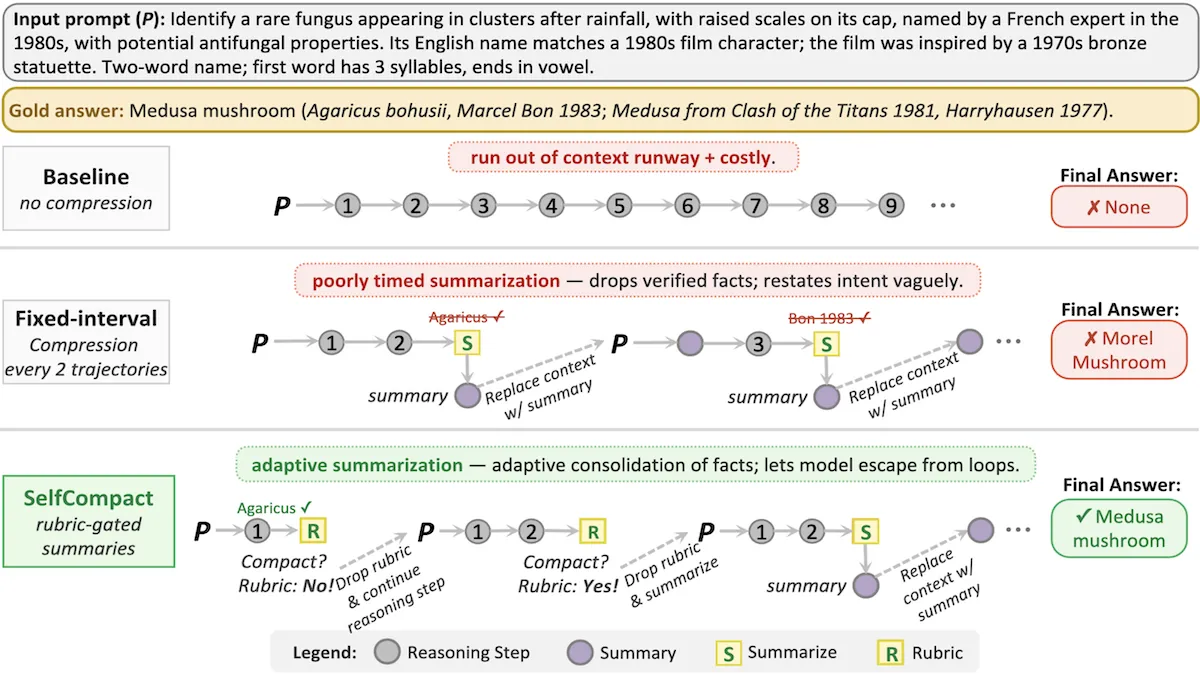
核心洞察: 在智能体系统中,压缩上下文的最佳时机不仅取决于上下文中累积的 Token 数量,更取决于智能体当前的任务状态。时机恰当的压缩可以丢弃过时的推理过程,而时机不当的压缩可能会丢弃模型仍需要的部分结果。带有指令的工具弥合了这一差距。
工作原理: SelfCompact 在智能体的工具集中增加了两个组件:一个定期评估系统轨迹的探针(probe)和一个摘要工具。如果探针允许压缩,它就会调用该工具对上下文进行摘要。同一生成轨迹的模型负责撰写摘要。(作者实验使用了阿里巴巴的 Qwen 系列模型。)
- 每处理 16,000 个 Token,探针就会向模型上下文添加一个提示,规定何时允许压缩、何时阻断,并要求模型判断自身状态。它会检查子任务是否已完成,或智能体是否在朝着明确的结果取得清晰进展。如果是,则允许压缩;如果模型处于步骤中间或卡住,则阻断压缩。
- 当发生压缩时,摘要器将轨迹(通常为 50,000 到 100,000 个 Token)浓缩为简短摘要(约 1,000 到 3,000 个 Token),然后基于该摘要恢复生成过程。
结果: 在六个基准测试中,SelfCompact 的准确率高于固定间隔摘要(当模型填满 30% 上下文窗口时触发)和不压缩(模型达到限制时直接停止)。
- 在 IMO-Answerbench(竞赛数学问题)上,搭配 SelfCompact 的 Qwen3-30B-A3B 达到 52.1% 的准确率。固定间隔摘要的准确率为 48.7%,不压缩的准确率为 45.2%。
为何重要: 目前大多数关于自适应压缩的研究都通过强化学习或监督微调来训练模型,使其判断何时压缩上下文。而 SelfCompact 无需更新任何参数,就能有效做出这些决策。
我们的思考: 这种基于评估准则的方法引入了一种新的 智能体设计模式:即暴露一个工具,并给模型提供明确的使用该工具的标准。