
LLM 研究面临的未解挑战
[]
我从来没见过这么多聪明人朝着同一个目标努力:让 LLM 变得更好。在和业界、学术界的许多人交流后,我总结出了 10 个主要研究方向。其中前两个——幻觉和上下文学习——大概是当下讨论最多的。而我个人最期待的是第 3 个(多模态)、第 5 个(新架构)和第 6 个(GPU 替代方案)。
1. 减少并量化幻觉
幻觉已经是被反复讨论的话题了,所以我长话短说。幻觉指的是 AI 模型一本正经地胡编乱造。对很多创意类应用来说,幻觉反而是个优点;但对大多数其他应用来说,它就是个 bug。我最近参加了一场有 Dropbox、Langchain、Elastics 和 Anthropic 参与的 LLM 圆桌讨论,大家一致认为企业把 LLM 用于生产的最大障碍就是幻觉。
如何缓解幻觉、如何建立衡量幻觉的指标,目前是一个火热的研究方向,我已经看到不少创业公司专注于解决这个问题。也有一些实用的技巧可以减少幻觉,比如在 prompt 中补充更多上下文、chain-of-thought、self-consistency,或者让模型回答得更简洁。
想深入了解幻觉,可以参考:
- Survey of Hallucination in Natural Language Generation(Ji et al., 2022)
- How Language Model Hallucinations Can Snowball(Zhang et al., 2023)
- A Multitask, Multilingual, Multimodal Evaluation of ChatGPT on Reasoning, Hallucination, and Interactivity(Bang et al., 2023)
- Contrastive Learning Reduces Hallucination in Conversations(Sun et al., 2022)
- Self-Consistency Improves Chain of Thought Reasoning in Language Models(Wang et al., 2022)
- SelfCheckGPT: Zero-Resource Black-Box Hallucination Detection for Generative Large Language Models(Manakul et al., 2023)
- NVIDIA NeMo-Guardrails 提供的一个关于事实核查与幻觉的简单示例:NVIDIA’s NeMo-Guardrails
2. 优化上下文长度与上下文构建
绝大多数问题都需要依赖上下文。例如,若向 ChatGPT 提问“哪家越南餐馆最好?”,系统需要补充“在哪里”这一语境信息,因为越南境内和美国的最佳越南餐馆显然不同。
根据这篇有趣的论文 SituatedQA(Zhang & Choi, 2021),大量信息检索类问题的答案具有语境依赖性。例如,在 Natural Questions NQ-Open 数据集中,约有 16.5% 的问题属于此类。我个人认为,在企业应用场景中,这一比例会更高。比如,当公司构建客服聊天机器人时,为了回答客户关于任意产品的任何问题,系统所需的上下文可能包括该客户的历史记录或相关产品的详细信息。
由于模型是根据提供的上下文进行“学习”的,这一过程也被称为上下文学习。
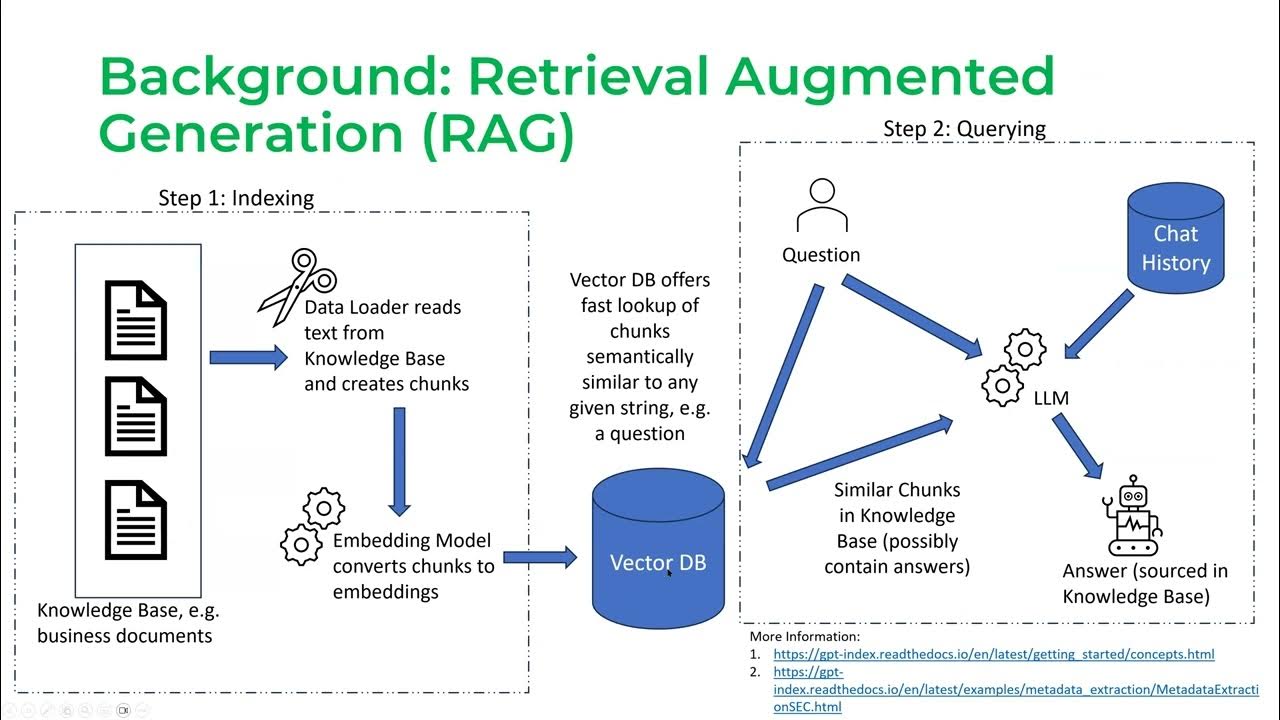
上下文长度对 RAG(Retrieval Augmented Generation,Lewis 等,2020)尤为重要,RAG 已成为 LLM 企业级应用的主导模式。对于尚未深入 RAG 领域的人,其工作流程分为两个阶段:
阶段 1:分块(也称索引)
- 收集希望 LLM 使用的所有文档
- 将这些文档切分为若干块,送入 LLM 以生成嵌入(embeddings),并将这些嵌入存储在向量数据库中
阶段 2:查询
- 当用户发送查询,例如“我的保险是否报销药物 X”时,LLM 会将其转换为一个嵌入,我们称之为 QUERY_EMBEDDING
- 向量数据库检索出嵌入与 QUERY_EMBEDDING 最相似的那些文档块
截图来自 Jerry Liu 关于 LlamaIndex 的演讲(2023)
上下文越长,能塞进窗口的信息块就越多。模型掌握的信息越丰富,回答质量就会越高,对吗?
未必。模型能利用多大的上下文,与它能多高效地利用这些上下文,是两个不同的问题。在致力于延长模型上下文长度的同时,另一股力量也在推动上下文效率的提升,这部分工作常被称为“提示工程”或“提示构建”。最近广为流传的一篇论文指出了这种现象:模型理解信息时,往往对序列开头和结尾的内容敏感度远高于中间部分——见 《迷失在中部:语言模型如何使用长上下文》(Liu 等,2023)。
3. 融合其他数据模态
在我看来,多模态能力极为强大,却长期被低估。它之所以重要,理由有很多。
首先,大量应用场景必须依赖多模态数据,尤其是在医疗、机器人、电子商务、零售、游戏和娱乐等处理混合数据模态的行业。例如:
- 医疗预测任务通常需要结合文本(如医生病历、患者问卷)和图像(如 CT、X 光、MRI 扫描)。
- 产品元数据常包含图像、视频、描述文本以及表格数据(如生产日期、重量、颜色)。你可能希望根据用户评价或产品照片自动补全缺失的产品信息,或者让用户通过形状、颜色等视觉特征搜索产品。
其次,多模态有望带来模型性能的大幅提升。既能理解文本又能理解图像,这样的模型难道不应该比仅理解文本的模型表现更好吗?基于文本的模型对训练数据的需求量极大,我们已经切实担忧 互联网上的文本数据即将耗尽。一旦文本数据枯竭,我们就必须转向利用其他数据模态。
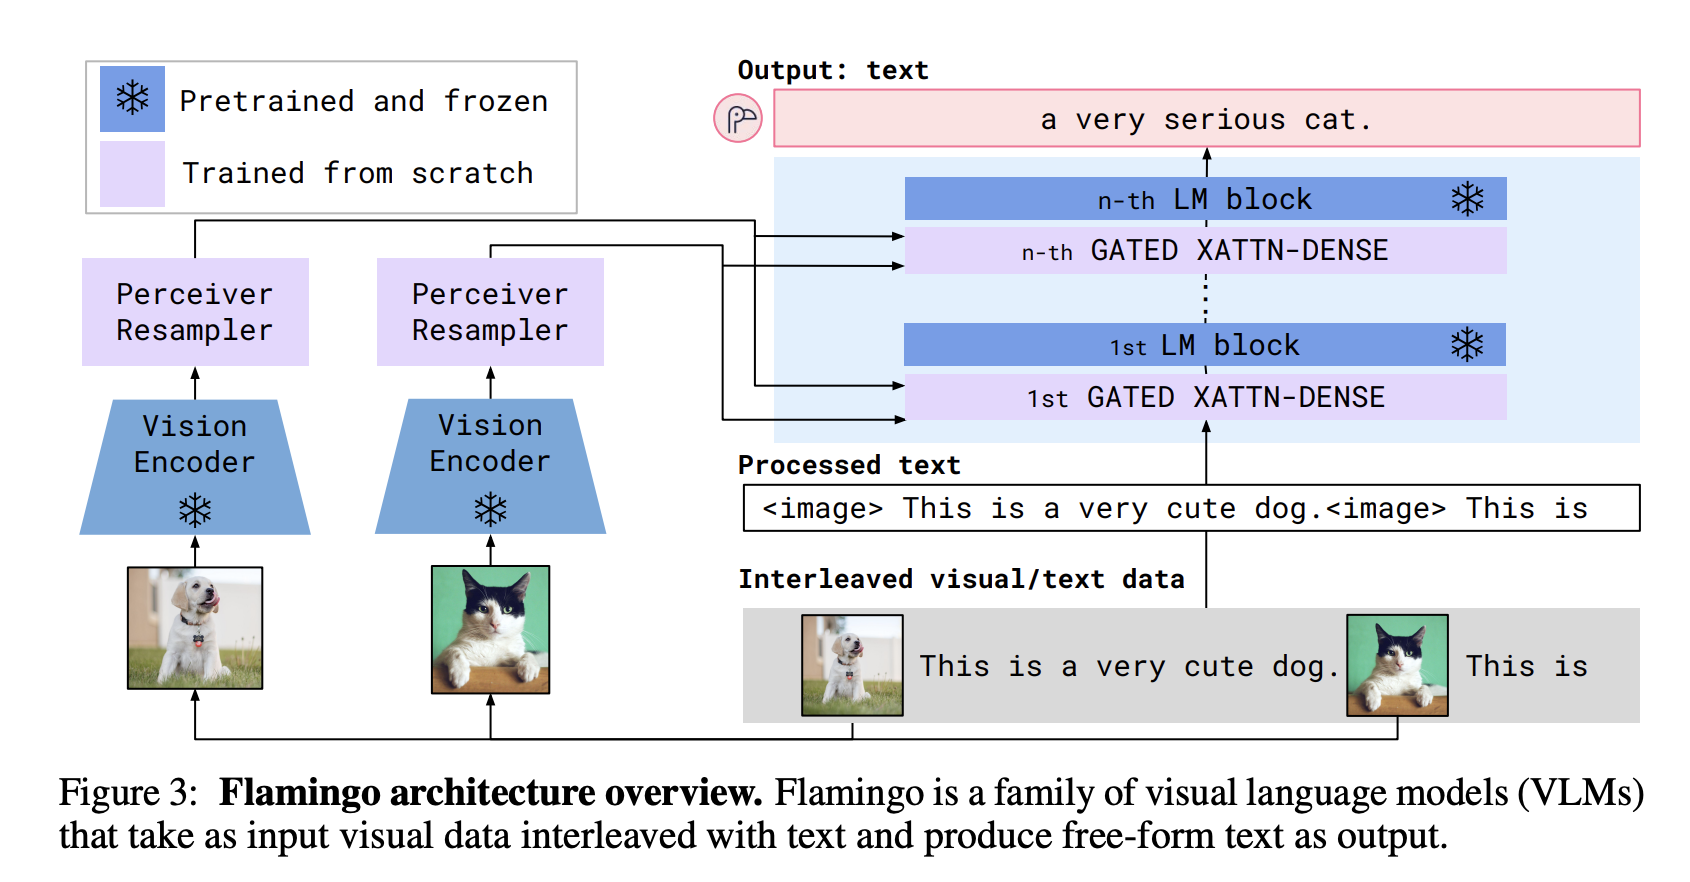
我特别期待的一个应用场景是:多模态能让视障人士更方便地浏览互联网、在现实中出行。
一些很不错的多模态工作:
- [CLIP] Learning Transferable Visual Models From Natural Language Supervision(OpenAI,2021)
- Flamingo: a Visual Language Model for Few-Shot Learning(DeepMind,2022)
- BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models(Salesforce,2023)
- KOSMOS-1: Language Is Not All You Need: Aligning Perception with Language Models(Microsoft,2023)
- PaLM-E: An embodied multimodal language model(Google,2023)
- LLaVA: Visual Instruction Tuning(Liu et al.,2023)
- NeVA: NeMo Vision and Language Assistant(NVIDIA,2023)
我正在写一篇关于多模态的文章,希望能尽快分享出来!
4. 让 LLM 更快、更便宜
GPT-3.5 在 2022 年 11 月底刚发布时,很多人担心把它用到生产环境会有延迟和成本问题。但从那以后,延迟和成本的情况变化很快。短短半年内,社区就找到了方法,训练出性能接近 GPT-3.5、显存占用却不到其 2% 的模型。
我的心得是:只要你做的东西足够好,人们总会想出办法让它变得更快、更便宜。
| 日期 | 模型 | 参数量 | 量化精度 | 微调所需显存 | 可训练设备 |
| 2022 年 11 月 | GPT-3.5 | 175B | 16-bit | 375GB | 大量机器 |
| 2023 年 3 月 | Alpaca 7B | 7B | 16位 | 15GB | 游戏台式机 |
| 2023年5月 | Guanaco 7B | 7B | 4位 | 6GB | 任何 MacBook |
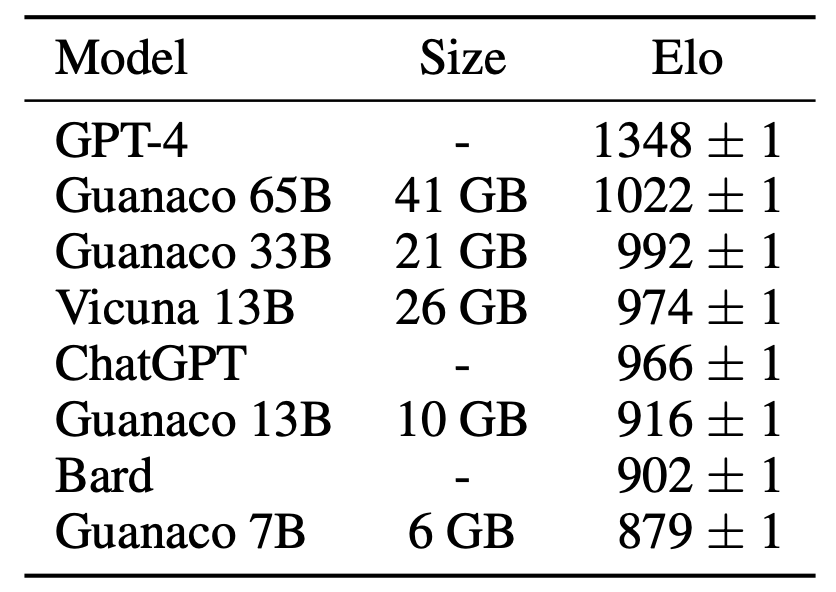
下图展示了 Guanco 论文中报告的 Guanaco 7B 与 ChatGPT GPT-3.5 和 GPT-4 的性能对比。需要注意的是,这种性能对比远非完美。LLM 评估非常、非常困难。
四年前,当我开始编写后来成为书籍 Designing Machine Learning Systems 中 Model Compression 章节的笔记时,我曾撰写过四种主要的模型优化/压缩技术:
- Quantization(量化):这是迄今为止最通用的模型优化方法。量化通过使用更少的位数来表示模型参数来减小模型大小,例如,使用 16 位甚至 4 位来代替 32 位表示浮点数。
- Knowledge distillation(知识蒸馏):一种让小模型(学生)模仿更大模型或模型集成(教师)的方法。
- Low-rank factorization(低秩分解):核心思想是用低维张量替换高维张量,从而减少参数数量。例如,可以将 3x3 张量分解为 3x1 和 1x3 张量的乘积,这样参数数量就从 9 个减少到了 6 个。
- Pruning(剪枝)
这四项技术如今依然相关且流行。Alpaca 使用知识蒸馏进行训练。QLoRA 则使用了低秩分解和量化的组合。
5. 设计新的模型架构
自 2012 年 AlexNet 以来,我们见证了包括 LSTM、seq2seq 在内的大量架构轮番登场。相比之下,Transformer 的生命力异常顽强。它自 2017 年问世至今,究竟还能延续多久的主流地位,仍是个未知数。
要想设计出超越 Transformer 的新架构并非易事。Transformer 在过去六年里已经被深度优化。新架构必须要在当下人们关注的规模和硬件上取得实际性能。顺带一提:Transformer 最初是由 Google 设计以在 TPU 上快速运行,之后才在 GPU 上进行了优化。
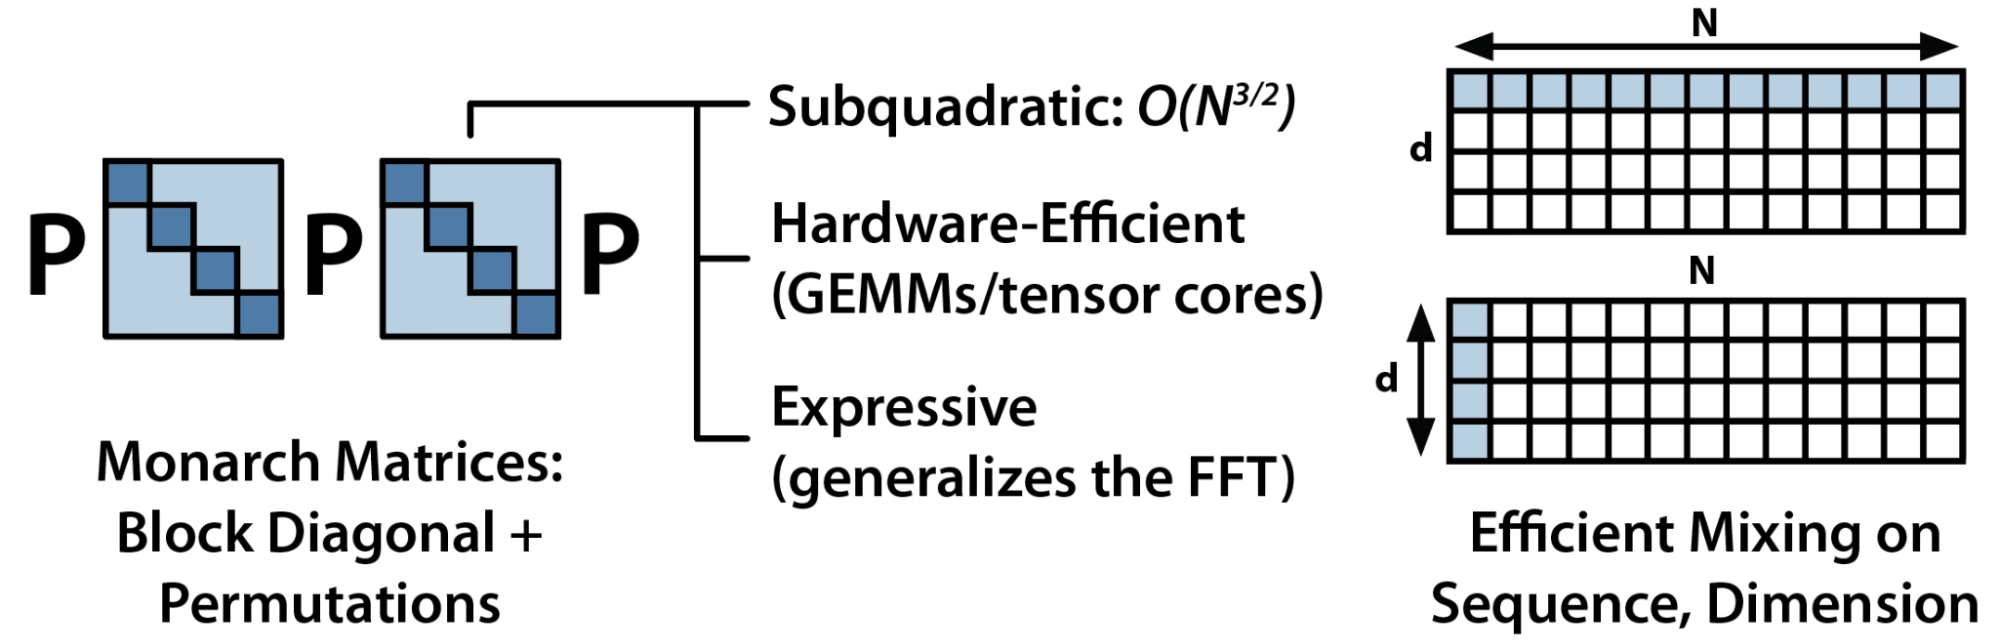
2021 年,Chris Ré 实验室提出的 S4 模型曾引起广泛关注——参见 利用结构化状态空间高效建模长序列(Gu 等人,2021)。我不太清楚该项目目前的状况。Chris Ré 的实验室依然在积极研发新架构,最近与初创公司 Together 合作推出了架构 Monarch Mixer(Fu 等人,2023)。
他们的核心观点是:在现有的 Transformer 架构中,注意力的复杂度随序列长度呈二次方增长,MLP 的复杂度则随模型维度呈二次方增长。若能做到亚二次方复杂度的架构,效率将更高。
我相信还有其他实验室也在探索这一思路,但我没看到过公开发表的尝试。如果你知道有这样的研究,请告诉我!
6. 开发 GPU 的替代方案
自 2012 年 AlexNet 问世以来,GPU 一直是深度学习的主导硬件。事实上,AlexNet 如此广为人知的一个原因,就是它首次成功用 GPU 训练神经网络。在 GPU 之前,想训练 AlexNet 规模的模型,你需要成千上万颗 CPU,比如 AlexNet 发布前几个月 Google 公布的那套系统。相比成千上万颗 CPU,几块 GPU 对博士生和研究人员来说容易获得得多,这也由此引发了深度学习的研究热潮。
过去十年间,无数大公司和创业公司都尝试过为 AI 打造新硬件。其中最知名的包括 Google 的 TPU、Graphcore 的 IPU(IPU 现在怎么样了?)以及 Cerebras。SambaNova 曾融资超过 十亿美元开发新型 AI 芯片,但后来似乎转向了生成式 AI 平台业务。
长期以来,人们对量子计算寄予厚望,主要玩家有:
- IBM 的 QPU
- Google 量子计算机今年早些时候在 Nature 上报告了降低量子错误率的重大突破,其量子虚拟机可通过 Google Colab 公开访问
- 各类研究机构,如 MIT 量子工程中心、马克斯·普朗克量子光学研究所、芝加哥量子交换中心、橡树岭国家实验室 等
另一个同样令人兴奋的方向是光子芯片。这是我最不熟悉的领域——如果我有说错的地方,还请指正。目前的芯片依靠电信号传输数据,功耗高且存在延迟。光子芯片则利用光子传输数据,借助光速实现更快、更高效的计算。该领域的多家初创公司已募集数亿美元,包括 Lightmatter(2.7 亿美元)、Ayar Labs(2.2 亿美元)、Lightelligence(2 亿美元以上)以及 Luminous Computing(1.15 亿美元)。
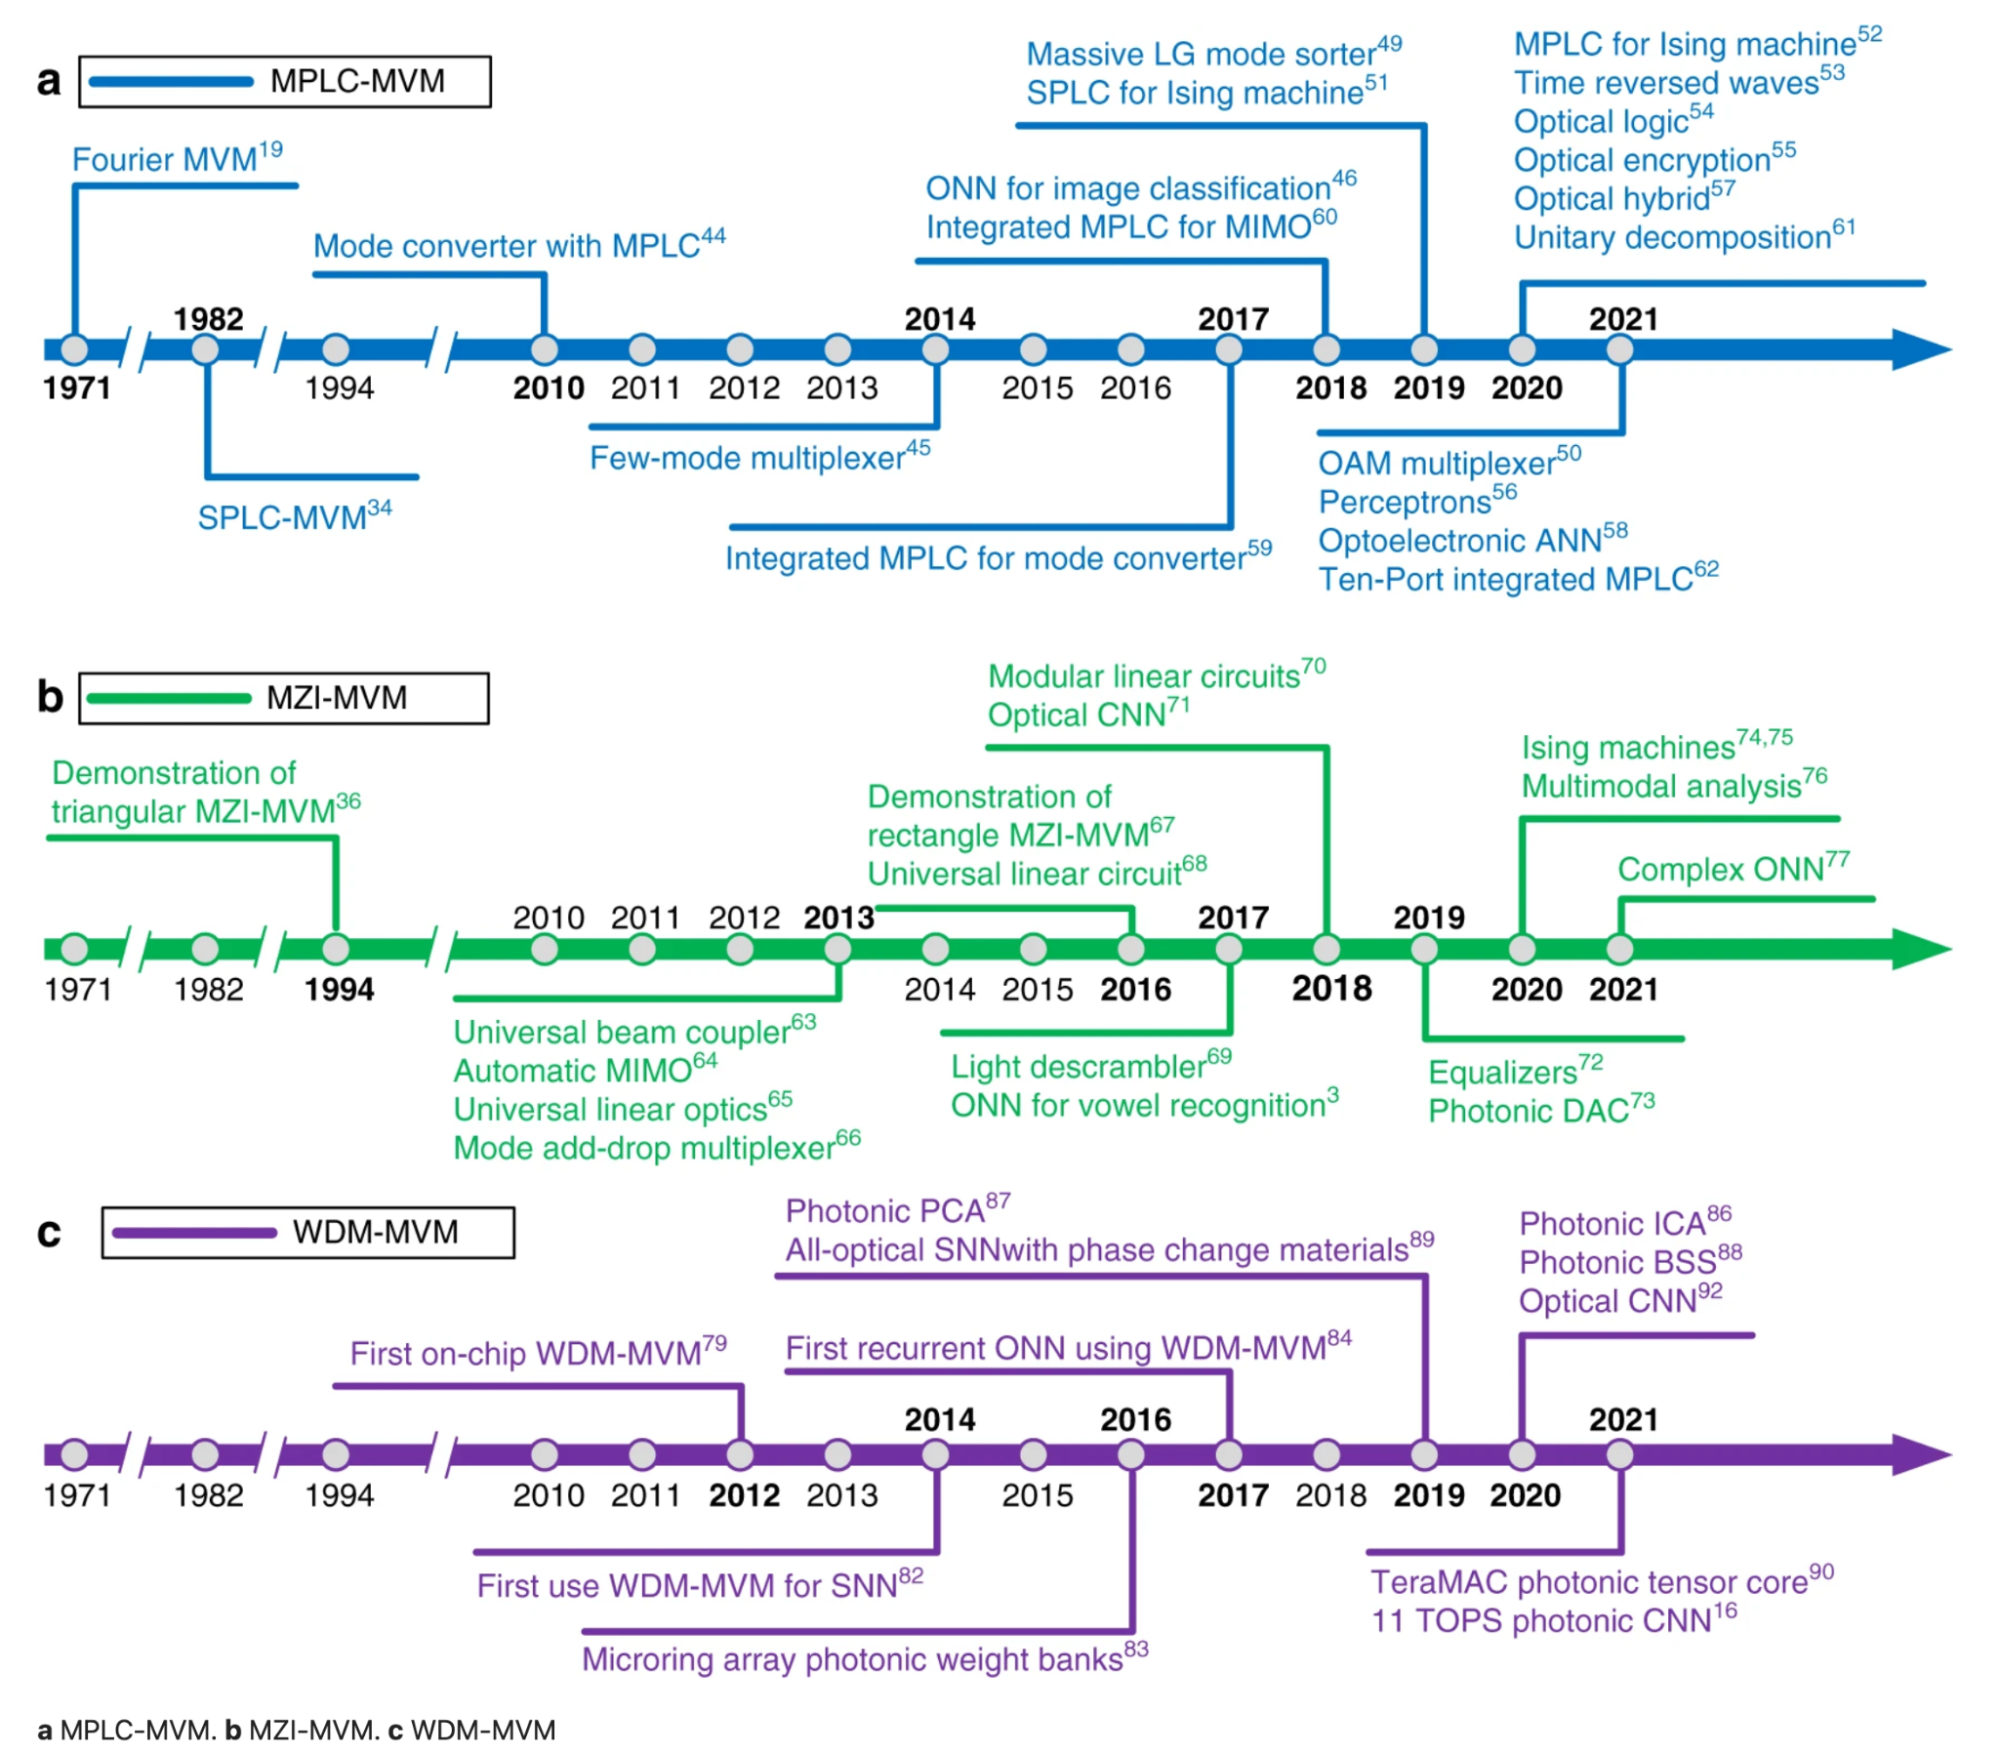
下图展示了光子矩阵计算中三种主要方法的进展时间线,引自论文 Photonic matrix multiplication lights up photonic accelerator and beyond(Zhou et al., Nature 2022)。这三种方法分别是平面光转换(PLC)、马赫 - 曾德尔干涉仪(MZI)和波分复用(WDM)。
7. 让智能体(Agents)变得可用
智能体是指能够执行操作(如浏览互联网、发送电子邮件、进行预订等)的大语言模型。与本文探讨的其他研究方向相比,这可能是最年轻的一个。
由于新颖性和巨大潜力,业界对智能体有着近乎狂热的执着。Auto-GPT 目前已成为 GitHub 历史上星标数排名第 25 的仓库。GPT-Engineering 也是另一个受欢迎的仓库。
尽管热情高涨,但人们仍对大语言模型是否足够可靠、性能是否足以放心授予其“行动权”持怀疑态度。
不过,一个已出现的应用场景是研究用 agent 进行社会科学研究,例如著名的斯坦福实验展示了小型生成式 agent 社会能涌现出社交行为:比如,仅从用户设定的一个初始想法出发——某个 agent 想举办情人节派对——这些 agent 会在接下来的两天里自主地相互传递派对邀请,结识新朋友,甚至互相邀约一起参加派对……(Generative Agents: Interactive Simulacra of Human Behavior,Park 等人,2023)
该领域最具代表性的创业公司或许是 Adept,由两位 Transformer 论文合著者(尽管< a href="https://www.theinformation.com/briefings/two-co-founders-of-adept-an-openai-rival-suddenly-left-to-start-another-company">两人都已离职)和前 OpenAI 副总裁联合创立,迄今融资已近 5 亿美元。去年,他们曾展示过其 agent 浏览互联网并向 Salesforce 添加新账号的 demo。我很期待看到他们的新演示 🙂
8. 改进从人类偏好中学习的方式
RLHF,基于人类偏好的强化学习,虽然有趣但做法略显粗糙。如果人们能找到更好的 LLM 训练方法,我并不会感到意外。RLHF 仍有许多未解之谜,例如:
1. 如何用数学表示人类偏好?
目前,人类偏好是通过比较来确定的:人类标注者判断回复 A 是否优于回复 B。但这并没有考虑 A 比 B 好多少。
2. 人类偏好是什么?
Anthropic 从三个维度衡量模型回复的质量:有用性、诚实性和无害性。参见Constitutional AI: Harmlessness from AI Feedback(Bai 等人,2022)。
DeepMind 则试图生成让尽可能多的人满意的回复。参见Fine-tuning language models to find agreement among humans with diverse preferences(Bakker 等人,2022)。
此外,我们是希望 AI 能表明立场,还是希望它避开一切可能引发争议的话题?
3. “人类”偏好究竟是谁的偏好?考虑到文化、宗教、政治立场等差异
要获得能充分代表所有潜在用户的训练数据,面临很多挑战。
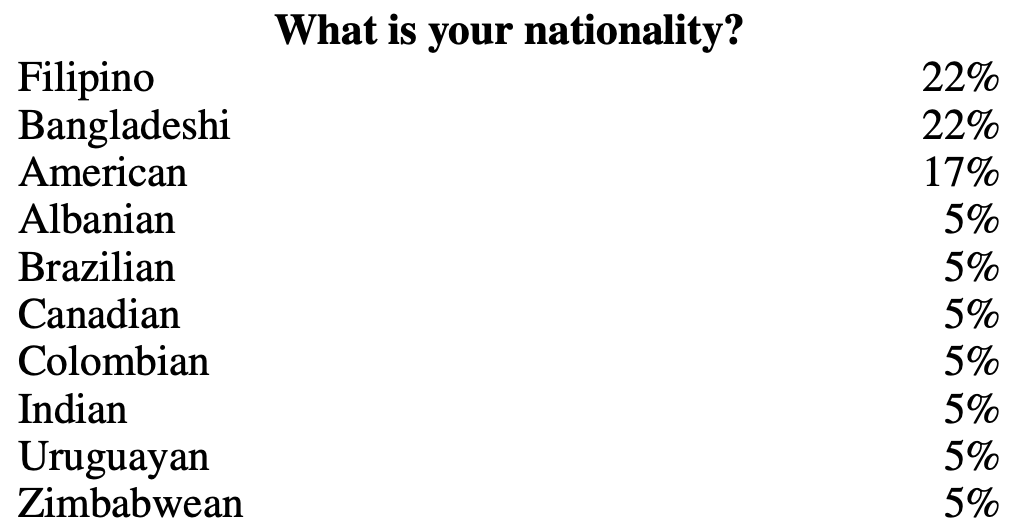
例如,OpenAI 的 InstructGPT 数据中没有 65 岁以上的标注员,且标注员以菲律宾人和孟加拉国人为主。参见 InstructGPT: Training language models to follow instructions with human feedback(Ouyang et al., 2022)。
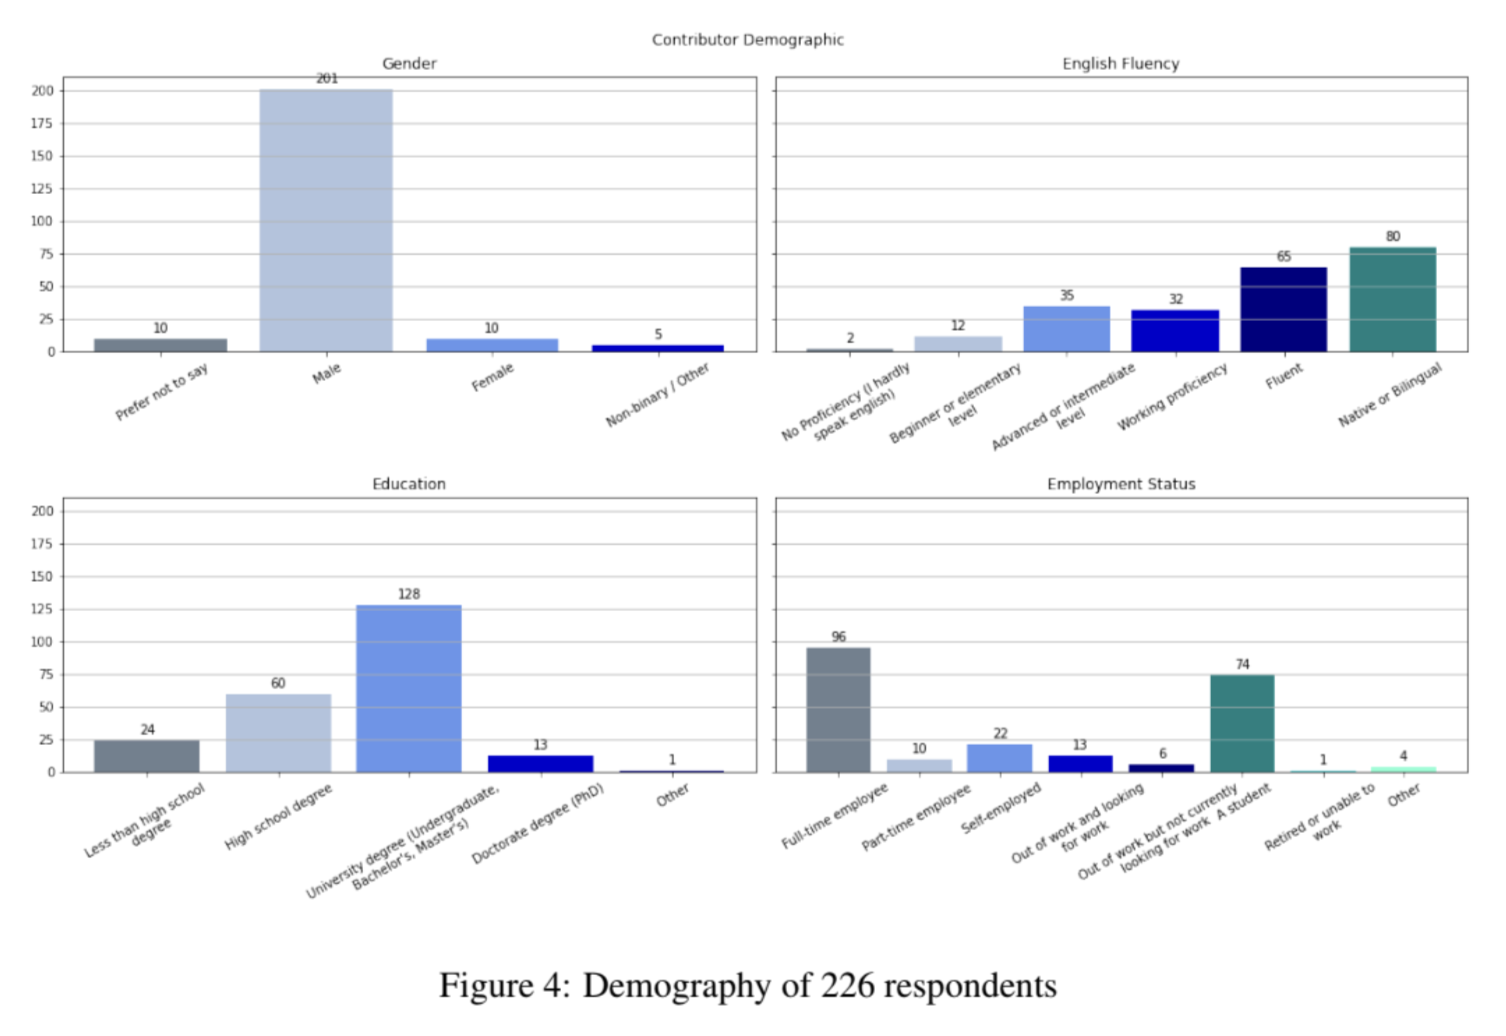
社区主导的收集数据工作虽然初衷可贵,但可能带来数据偏差。例如在 OpenAssistant 数据集中,222 名受访者里有 201 人(90.5%)自称男性。Jeremy Howard 在 Twitter 上对此有精彩的讨论。
9. 提升聊天界面的效率
ChatGPT 出现后,关于聊天是否适合作为各类任务的界面,已有不少讨论。
- Natural language is the lazy user interface(Austin Z. Henley, 2023)
- Why Chatbots Are Not the Future(Amelia Wattenberger, 2023)
- What Types of Questions Require Conversation to Answer? A Case Study of AskReddit Questions(Huang et al., 2023)
- AI chat interfaces could become the primary user interface to read documentation(Tom Johnson, 2023)
- Interacting with LLMs with Minimal Chat(Eugene Yan, 2023)
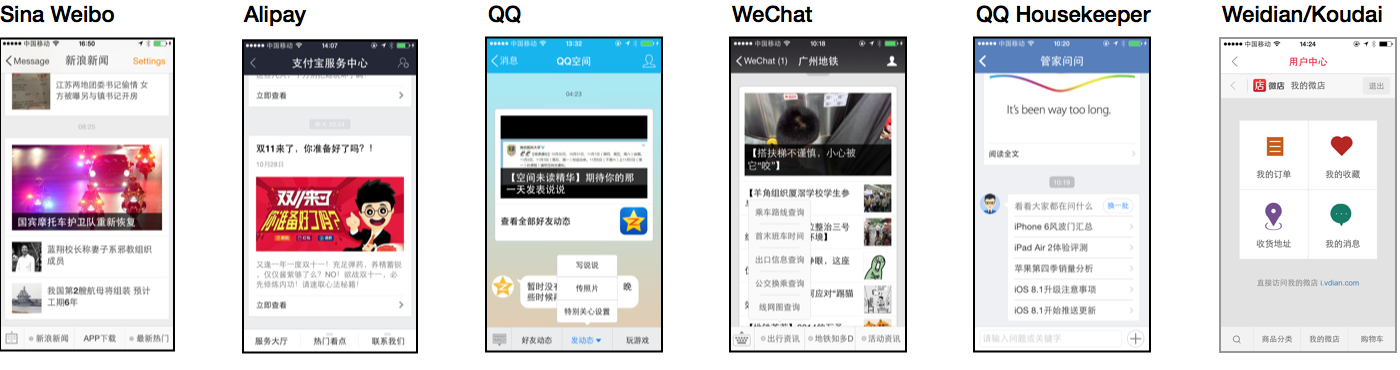
不过,这并非一个新话题。在许多国家,尤其是亚洲,聊天界面作为超级应用的交互方式已沿用约十年。Dan Grover 早在 2014 年就对此进行过讨论。
2016 年,讨论再次变得激烈,当时许多人认为传统应用将消亡,聊天机器人才是未来。
- 论聊天作为界面(Alistair Croll,2016)
- 聊天机器人潮流是一个巨大的误解吗?(Will Knight,2016)
- 机器人不会取代应用,更好的应用才会取代应用(Dan Grover,2016)
就个人而言,我非常喜爱聊天界面,原因如下:
- 聊天界面易上手,即使从未接触过电脑或互联网的人也能快速学会使用。2010 年代初,我在肯尼亚的一个低收入居民区(可以说贫民窟吗?)做志愿者时,惊讶地发现那里的人都非常习惯通过手机短信进行银行操作,尽管那里没有人拥有电脑。
- 聊天界面具有可及性。如果双手忙碌,你可以用语音代替文字输入。
- 聊天界面还极具鲁棒性——你可以发出任何请求,它总会给出回应,哪怕回答质量不高。
然而,我认为聊天界面在某些方面仍有改进空间。
-
单轮多消息
目前,我们基本假设每一轮对话只包含一条消息。但这并非我和朋友聊天的方式。我经常需要多条消息来完成一个想法,因为需要插入不同数据(如图片、位置、链接),或是之前漏掉了什么,又或者单纯不想把所有内容堆砌成一段长文。
-
多模态输入
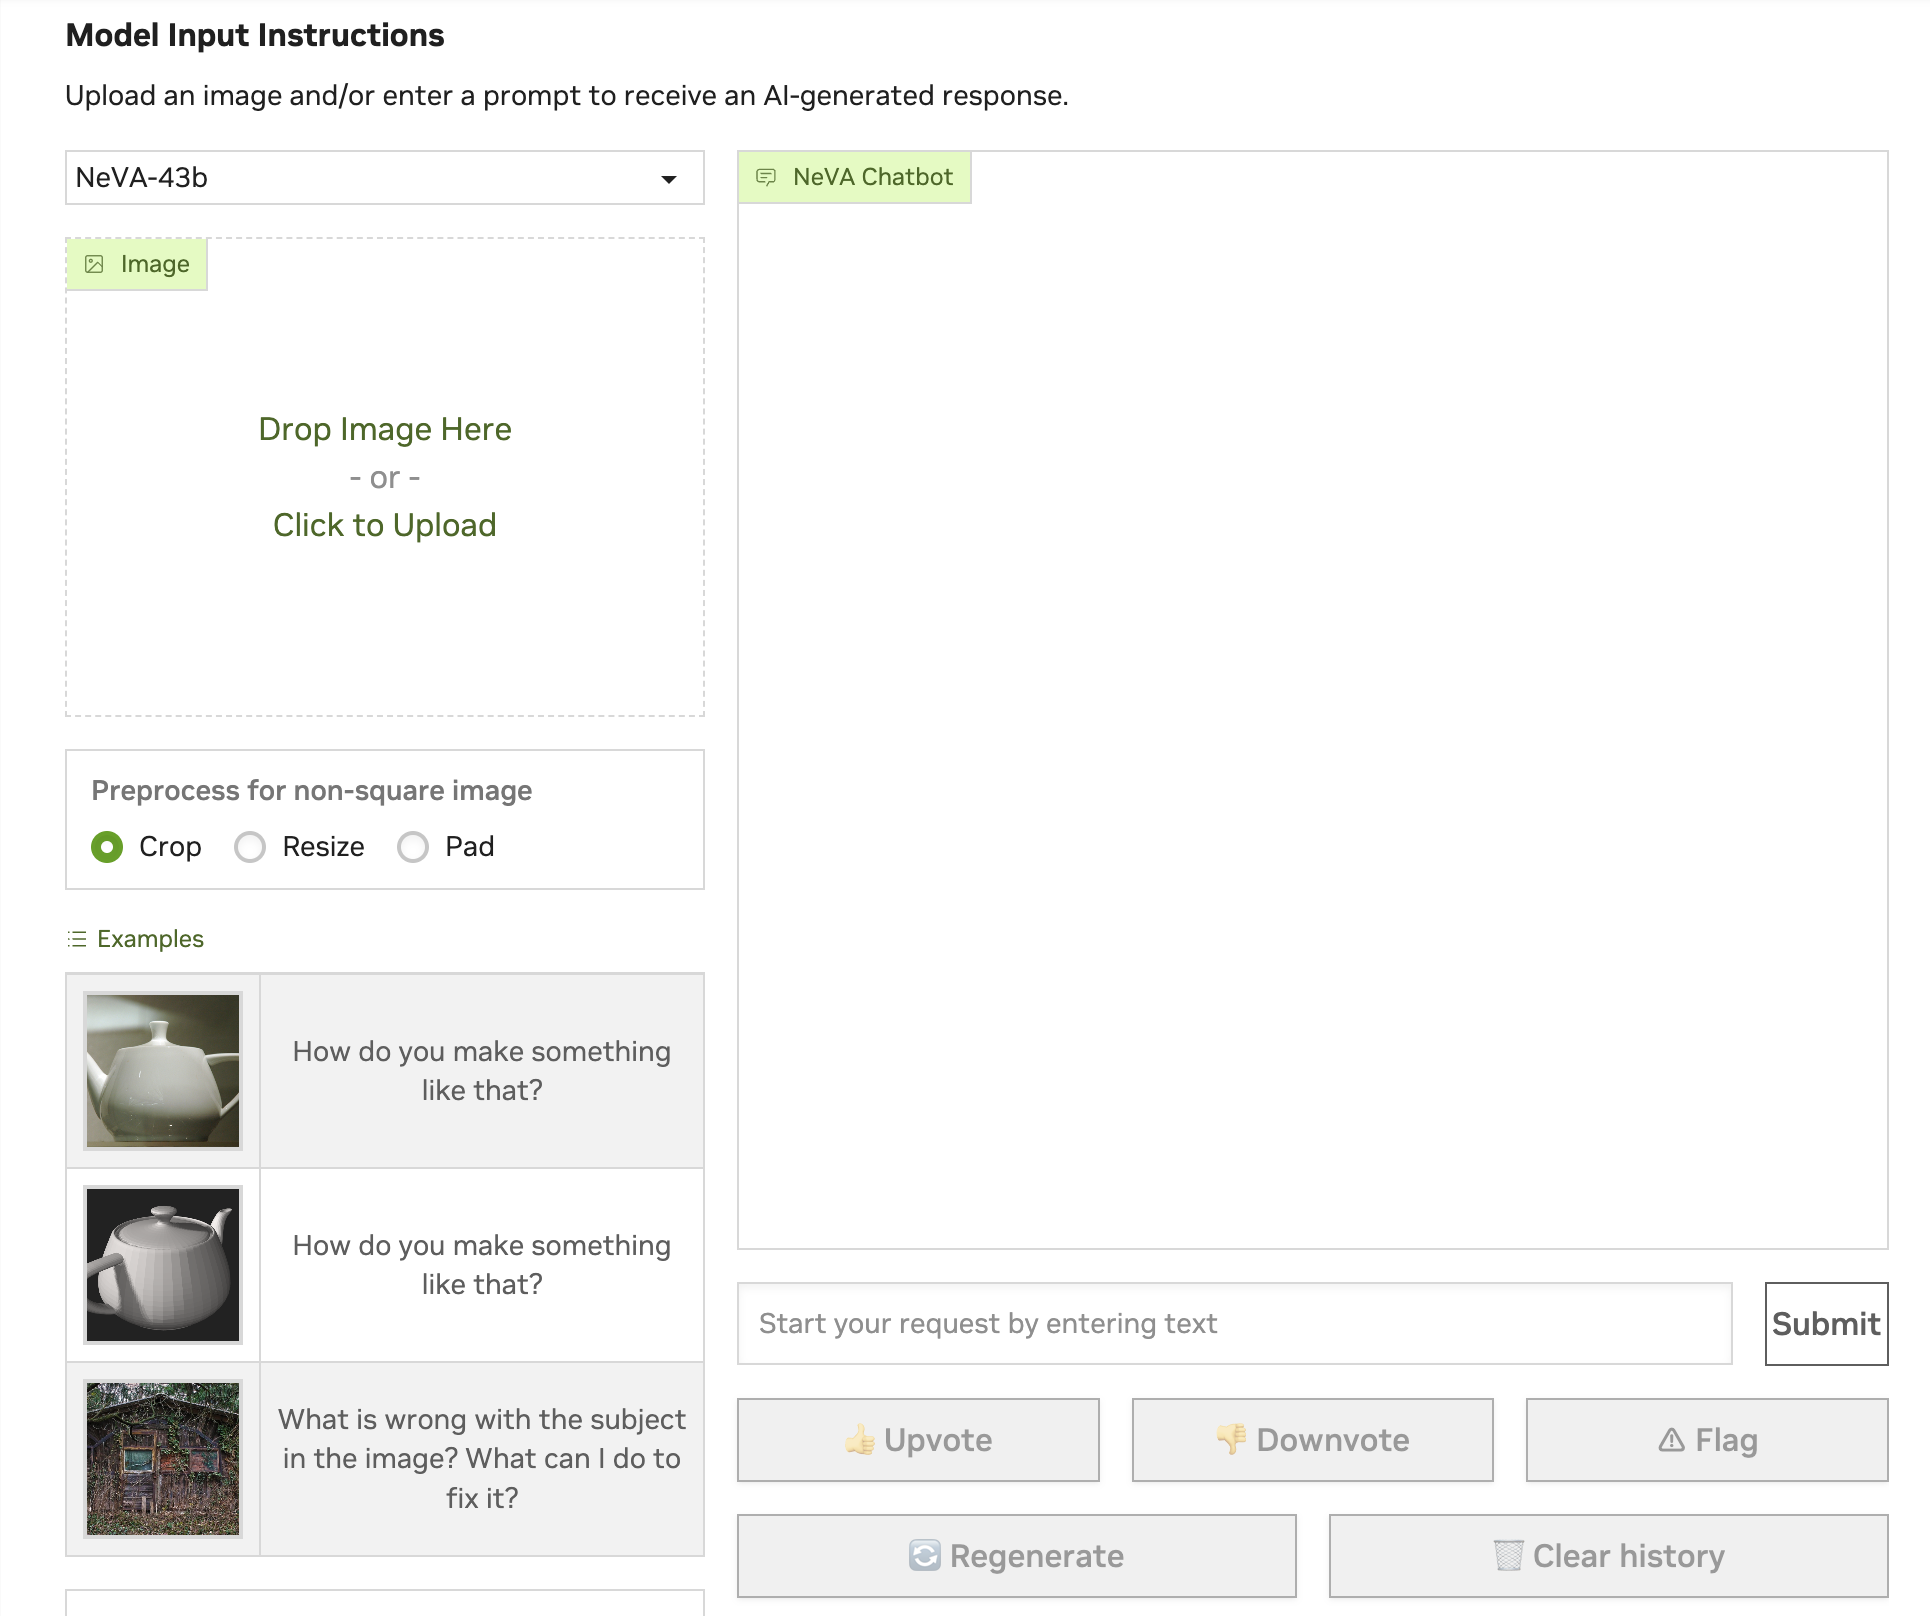
在多模态应用这个领域,投入的精力大多用于构建更好的模型,而很少用于打磨更好的界面。以Nvidia 的 NeVA 聊天机器人为例,我虽然不是 UX 专家,但感觉它的界面还有不少优化空间。
附言:抱歉拿 NeVA 团队开涮,但即便有这样的界面,你们的工作依然非常出色!
-
将生成式 AI 融入工作流
Linus Lee 在演讲超越聊天的生成式 AI 界面中很好地阐述了这一点。举例来说,如果你正在处理一张图表中的某根柱子,想对它提问,应该只需指向该柱子即可提出相关问题。
-
编辑与删除消息
当用户编辑或删除某条输入时,聊天机器人的对话流程应如何变化?
10. 构建非英语 LLM
我们知道,目前以英语为主的 LLM 在许多其他语言上表现不佳,无论在性能、延迟还是速度方面都如此。相关参考:
- ChatGPT Beyond English: Towards a Comprehensive Evaluation of Large Language Models in Multilingual Learning(Lai 等,2023)
- All languages are NOT created (tokenized) equal(Yennie Jun,2023)
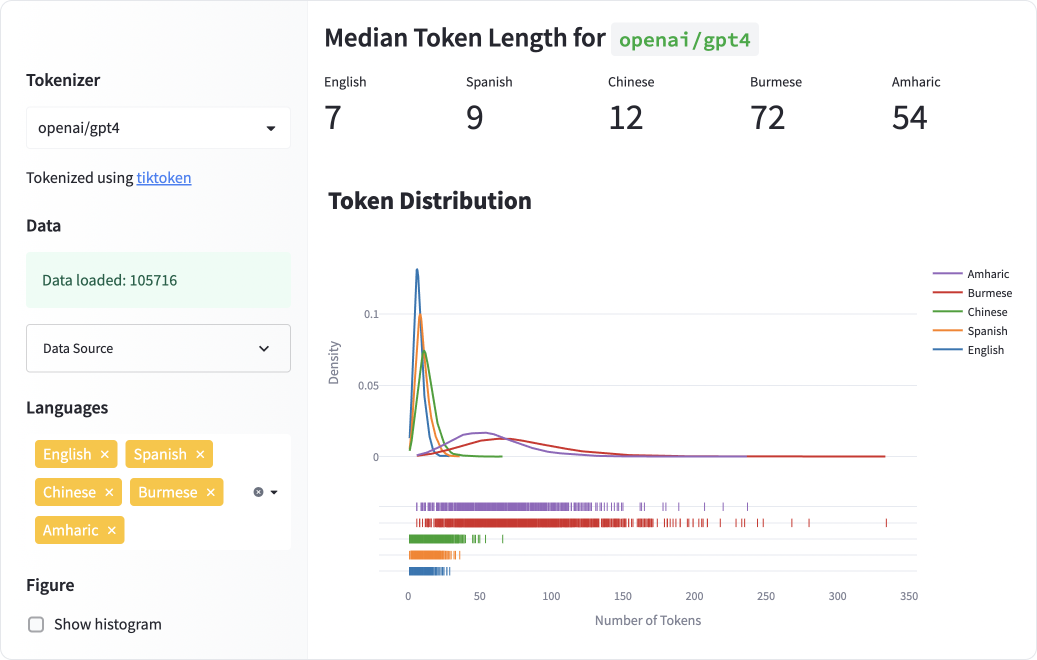
以下是我了解到的相关项目。如果你知道其他值得关注的资源,欢迎分享,我会将其补充到这里。
- Aya:加速多语言 AI 进步的开放科学计划
- Symato:越南语版 ChatGPT
- Cabrita:使用葡萄牙语数据微调 InstructLLaMA
- Luotuo-Chinese-LLM
- Chinese-LLaMA-Alpaca
- Chinese-Vicuna
几位早期读者告诉我,他们认为我不应该把方向列进来,理由有二。
-
这与其说是研究问题,不如说是资源问题。我们已经知道该怎么做,只是需要有人投入资金和精力。这种说法不完全成立。大多数语言都属于低资源语言,高质量数据远少于英语或中文,训练大语言模型可能需要不同的技术。参见:
- Low-resource Languages: A Review of Past Work and Future Challenges(Magueresse et al., 2020)
- JW300: A Wide-Coverage Parallel Corpus for Low-Resource Languages(Agić et al., 2019)
-
更悲观的人认为,未来许多语言会消亡,互联网将只剩下英语和中文两个语言世界。这种观点并不新鲜——还记得世界语(Esperanto)吗?
AI 工具(如机器翻译和聊天机器人)对语言学习的影响尚不明朗。它们是能帮人更快学会新语言,还是会彻底消除学习新语言的需求?
结语
呼,这篇文章引用的论文真不少,而且我确信还有很多遗漏。如果你觉得有我漏掉的内容,欢迎告诉我。
如果想看另一个视角,可以读读这篇全面的论文 Challenges and Applications of Large Language Models(Kaddour et al., 2023)。
上面提到的问题,难度各不相同。比如第 10 条——为非英语语言构建 LLM——只要有足够的时间和资源,实现起来相对直接。
第 1 条——减少幻觉——会难得多,因为幻觉本来就是 LLM 概率模型的固有特性。
第 4 条——让 LLM 更快、更便宜——则永远不会被彻底解决。这个领域已经进展巨大,未来还会更多,但改进的空间永远存在。
第5项和第6项——新架构与新硬件——极具挑战性,但随着时间推移,它们终将到来。由于架构与硬件之间相辅相成的关系——新架构需要针对主流硬件进行优化,而硬件则需要支持主流架构——这些问题或许会由同一家公司来解决。
这些问题中的一些无法仅靠技术手段解决。例如,第8项(从人类偏好中学习的能力提升)可能更多是政策问题而非技术问题;第9项(提升聊天界面的效率)则更偏向用户体验问题。我们需要更多非技术背景的人加入,共同解决这些难题。
你最期待哪个研究方向?对于这些难题,你认为最有希望的解决方案是什么?我非常想听听你的看法。