
构建高性能 Tokio 应用的原则
我刚从 RustConf 回来。在 Unconf 期间,我们就异步应用的调试与基准测试展开了一场富有成效的讨论,并分享了诸多有价值的见解。在此,我尝试结合这些见解以及我个人的经验,罗列部分内容。这是初稿,我希望它能成为一份记录最佳实践的活文档。欢迎提交 issue 或 发起 PR。我计划在未来几天内添加一个示例应用,用于演示这些问题以及 dial9 trace 的形态。
—— Russell
编写能在 Tokio 运行时上高效运行的代码,没有几条放之四海而皆准的硬性规则;许多问题的答案都是“视情况而定”。负载的性能取决于当时运行时上正在运行的其他内容。这正是许多问题只在生产环境中才暴露的原因!编写高性能的异步应用,需要在公平性与批处理、竞争性与隔离性之间取得平衡。
本文列出了若干通用原则,并尽可能涵盖例外情况。文章假设读者对 Tokio 的工作窃取运行时具备基本了解;相关的高层概述收录于附录中。
通用原则
首先,判断是否真的存在问题
如果你仔细排查 Tokio 应用中的性能隐患,总能找出一堆。在我见过的大多数真实应用里,代码让出控制权等待下一个 `.await` 点之间的轮询间隔,都远远超过 Alice Ryhl 在优秀博文 What is Blocking? 中建议的 10-100 微秒阈值。这些问题是否真的影响你关心的应用指标或行为,很难说(参见:长轮询有时其实没问题)。关键在于从你真正想优化的实际指标出发倒推需求。例如,某些应用即使存在长轮询也完全无害,强行“修复”它们对面向用户的指标不会有可测量的改善。
在我遇到的绝大多数问题中,根源都出在应用代码本身,通常分布在多个分布式组件的交互中(而非 Tokio 本身)。dial9 对 Tokio 的洞察非常深入;它发现 Tokio 存在问题的频率,至少和它明确证明 Tokio 没有 问题(这能让人放心地去其他地方找原因)的频率一样高。当然,有时问题确实出在 Tokio 上。
在 Tokio 的监控指标中,最有用的是最近新增的调度延迟直方图。调度延迟是指任务准备好运行(例如 socket 收到数据)到 Tokio 实际轮询该 future 之间经过的时间。虽然这个指标无法直接告诉你原因,但调度延迟是 Tokio 与你的代码交互不当最常见症状。
为延迟拆分,为吞吐量批量处理
更频繁让出以优化延迟
要在大量请求中实现低延迟,就需要连接间的公平性。
以 Redis(或其他支持请求流水线的应用)为例。朴素的实现会在连接中还有数据时持续读取。当多个请求被流水线化发送时,整批请求(或大部分)会一次性进入内存缓冲区,之后再逐帧读取时,每次都直接返回 Poll::Ready,无需回到网络层。这既造成单次 poll 时间过长,也导致客户端之间不公平。
对吞吐量的影响通常不大:处理的请求数量是一样的。但延迟会剧烈恶化,因为一整批请求可能排在另一批后面等待。在这个例子中,每处理完一个请求就显式让出(yield),可以把延迟降低约 10 倍。更好的做法是:只在连续多次立即就绪的读取之后才让出。
async fn handle_conn(&mut self) -> crate::Result<()> {
    while !self.shutdown.is_shutdown() {
        // 如果连接有缓冲数据,这里可能连续返回
        // Poll::Ready,不会让出给 runtime。
        let frame = tokio::select! {
            res = self.connection.read_frame() => res?,
            _ = self.shutdown.recv() => {
                return Ok(());
            }
        };

        execute_command(&self.db, &mut self.connection, frame).await?;

        // 提升公平性:
        // tokio::task::yield_now().await;
    }
}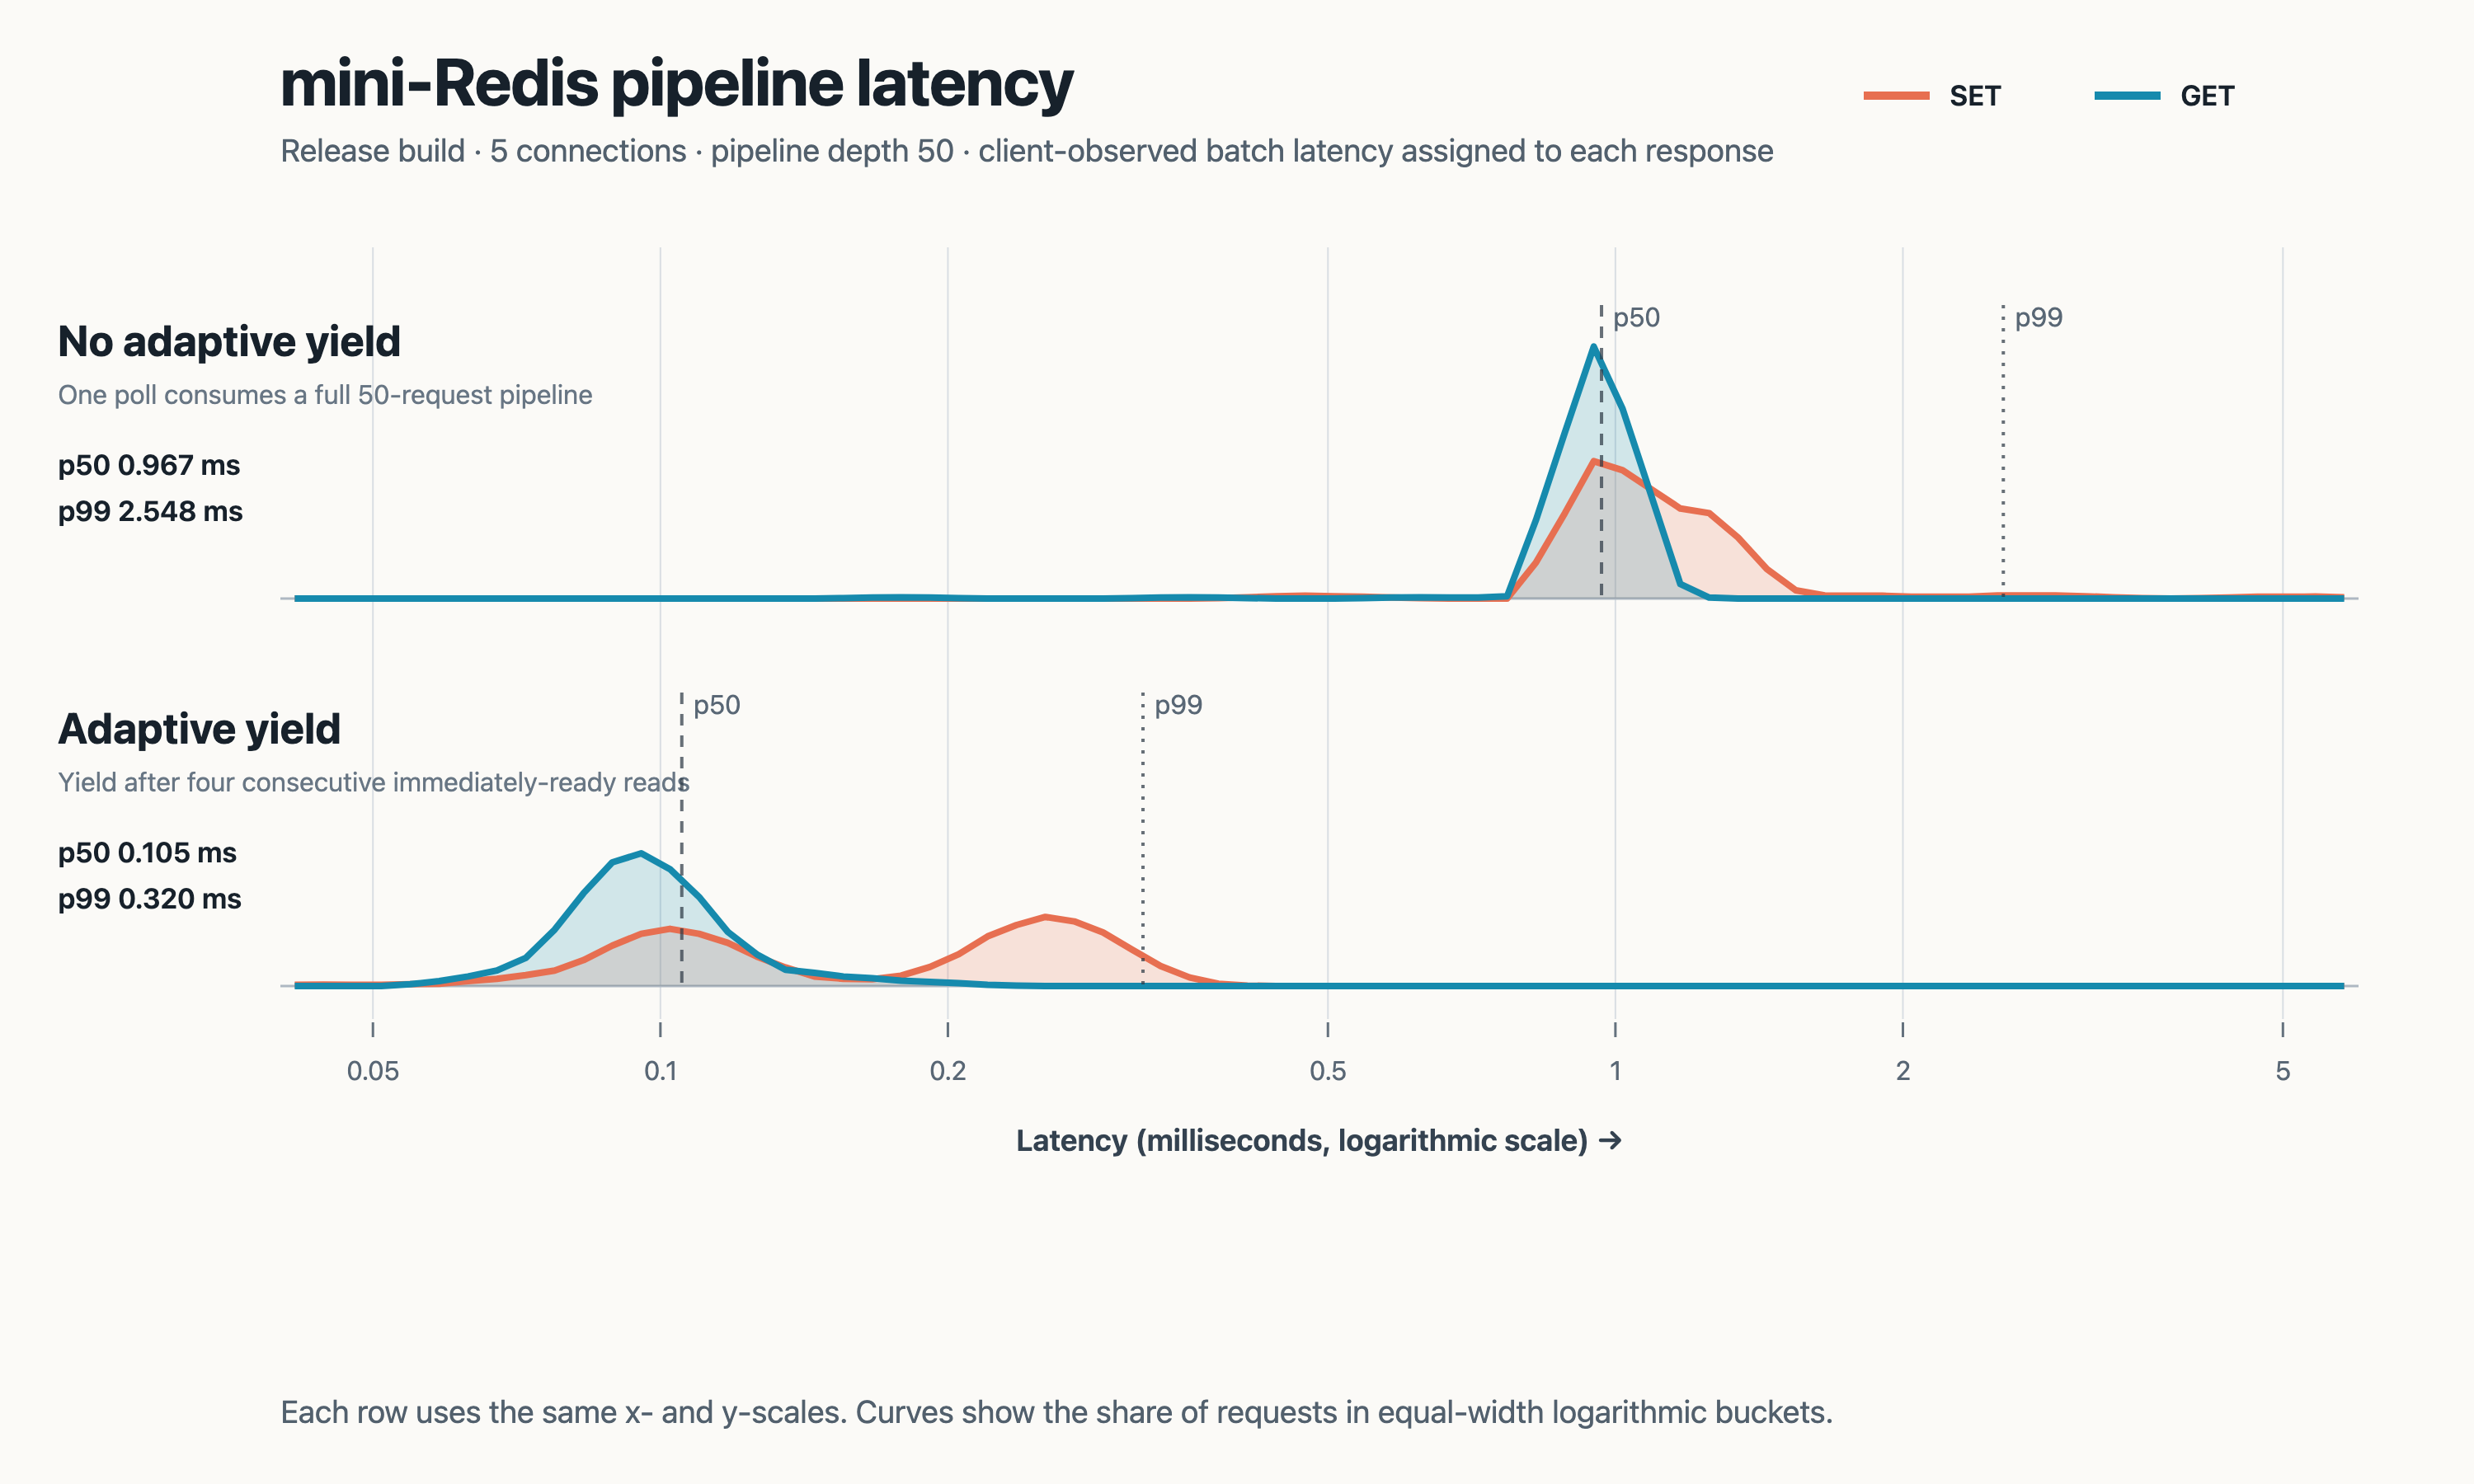
连续四次立即就绪的读取后再让出,既没有完全放弃批处理,又显著提升了流水线请求的公平性。
如何判断是否存在这个问题?
- P99 远高于 P50。
- 单次 poll 的耗时超过了其中实际工作量所需的时间。
- 一次 poll 里包含了大量 span。
批量处理以摊薄开销
公平性并非免费。每个运行时事件能处理的有效工作越多——无论是任务切换、轮询、跨 worker 迁移还是线程切换——应用的效率就越高。
tokio::fs 就是一个典型例子。我甚至常说“tokio::fs 是有害的”。在没有io_uring 的情况下,Tokio 会在阻塞线程池中执行每个文件系统操作。每次调用spawn_blocking都有成本,且每个运行时都共享同一个阻塞池。
如果你确定要执行一系列文件系统操作——或其他阻塞任务——请将它们批量打包成尽可能大的合理阻塞单元。在某些场景下,使用专用的 OS 线程会是更好的选择。
这条原则适用于所有与 Tokio 交互的场景。如果你知道会将任务发送到全局队列,批量处理也能摊销这种协调开销。
即使是像创建任务这样快速的操作也并非零成本!虽然创建任务很便宜,但如果一次性创建数百或数千个任务,每一个都意味着运行时需单独处理的工作。这会带来更高的调度延迟风险、更多的轮询次数以及整体更高的开销。在创建任务时,请评估实际调度的工作量:将一个 10 微秒的工作单元独立打包成任务往往弊大于利。你可以使用 dial9 或 tokio-metrics 等工具来追踪任务生命周期。
如何判断是否存在此类问题?
- 在火焰图中,
spawn_blocking等 Tokio API 消耗了显著时间。 - 紧密循环中执行了大量细粒度的文件系统或阻塞操作。
- 将相同工作分组到更大单元时,吞吐量有所提升。
警惕全局资源
Tokio 运行时在 worker(专门用于轮询就绪任务的线程)上调度工作。Worker 可以随核心数扩展,但部分运行时资源仍需共享协调。
阻塞线程池目前是1 全局资源。当速率足够高时,向阻塞队列推入任务会成为瓶颈,spawn_blocking 也可能在火焰图中显现。我在 32 核主机上观察到,每秒约 5 万个阻塞任务时会出现性能劣化,具体表现因环境而异。spawn_blocking 并非解决所有阻塞或高 CPU 负载代码的万能药。对于短暂且有界的任务,让 Tokio 的工作线程和工作窃取机制处理可能更快,但老规矩,“具体情况具体分析”。
Tokio 还有一个全局任务队列。当本地工作线程队列溢出(通常较罕见)或任务由运行时工作线程之外调度(在某些应用中很常见)时,任务会进入该队列。例如,发送端运行在非 Tokio 线程上的 channel。
如何判断是否存在此问题?
- 运行时级操作(如
spawn_blocking)在火焰图中占比显著。 - 全局队列持续保持较深状态。在健康的应用中,它通常应保持接近空的状态;而在负载饱和的应用中,队列可能需要很长时间才能排空。
对互斥锁要格外谨慎
让工作线程在竞争激烈的互斥锁上阻塞,是导致整个运行时停滞的最简单方式之一。
例如,存储在互斥锁或读写锁后的指标注册表特别容易受此问题影响。如果刷新操作在执行耗时工作时持有锁,每个 Tokio 工作线程最终都可能调度一个尝试记录指标的任务,并阻塞在同一把锁上。此时工作窃取将失效,因为所有工作线程都卡住了!
在异步应用中,临界区应尽可能短(例如仅单次 hashmap 更新)。RWLock 几乎从来不是正确的原语,即使读路径也会造成原子操作的竞争。不要持有锁进行刷新、I/O 操作或等待其他 future。
tokio::sync::Mutex 只是用一个问题换取了另一个:Tokio Mutex 加锁开销更大,容易引发如 FutureLock 之类的细微问题,且仅适用于临界区持续数毫秒以上的场景。
如何判断是否存在此问题?
- P99 延迟出现可预测间隔的峰值,例如每分钟一次,当后台任务运行时。
- 在 dial9 中,大量任务突然阻塞、离开 CPU,持续了相当可观的时间。
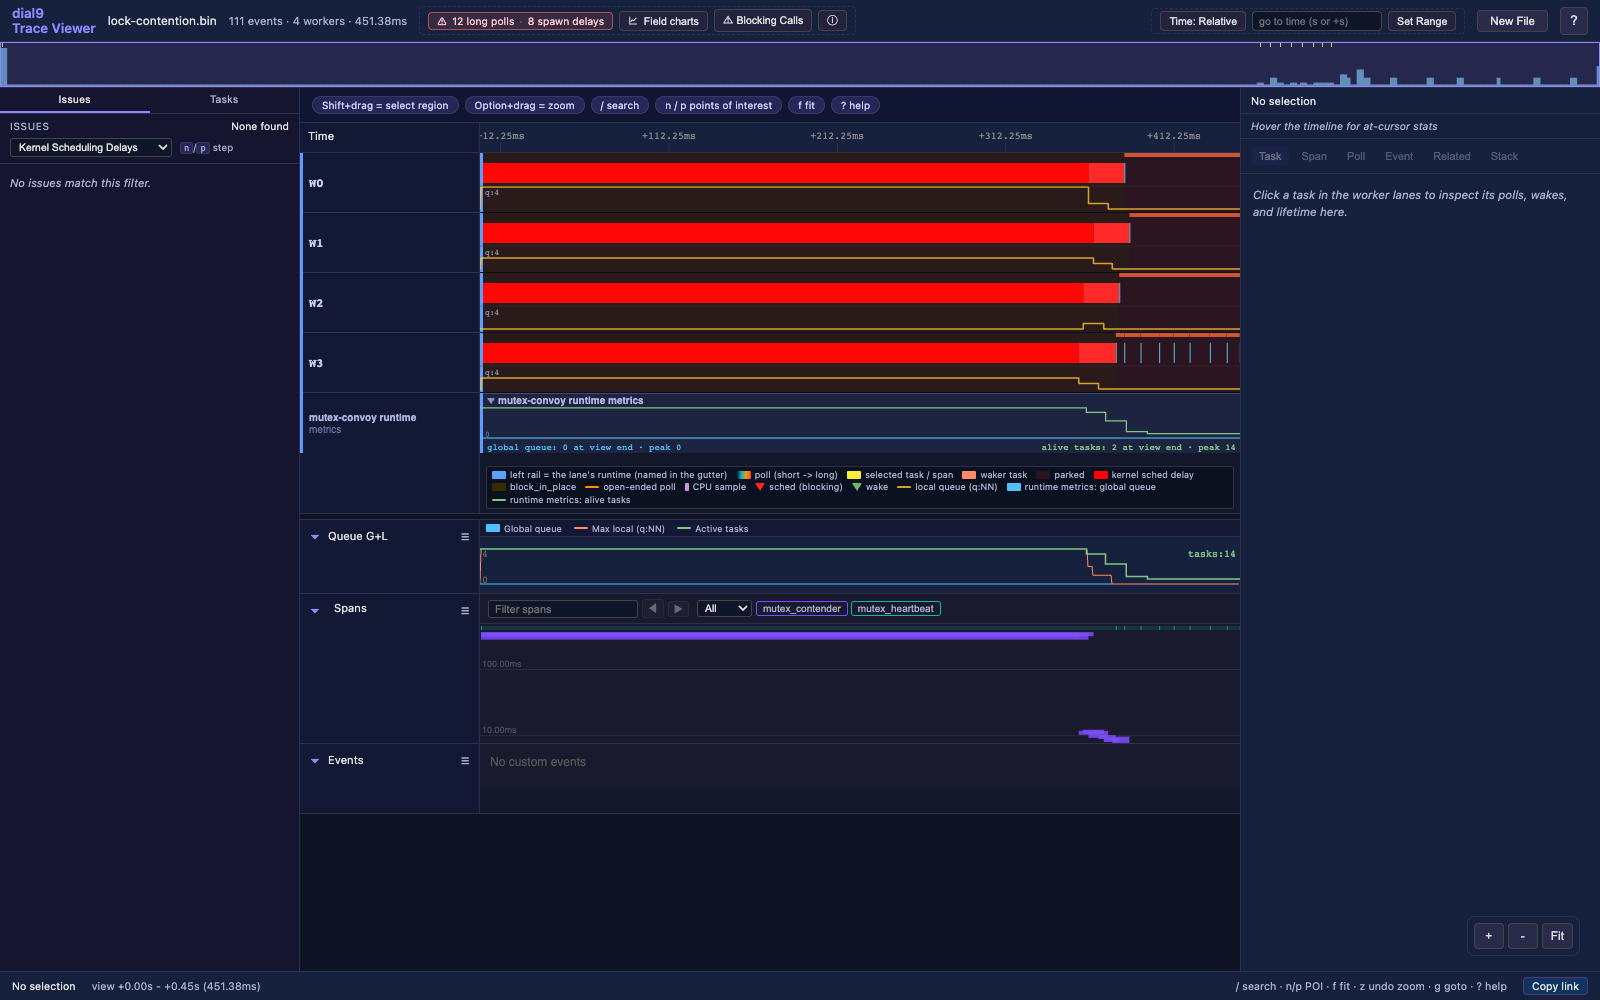
一个被争抢的阻塞式 mutex 让全部四个 runtime worker 同时停摆。
限制并行度——通常如此
Tokio 很乐意创建远超系统其余部分承受能力的任务量。某个工作负载无限制地 fan out 任务,结果意外地向 S3 打开 3000 个并发连接——这种情况非常常见。
解法很朴素:限制并发。花哨的自适应算法有时也适用,但一个 Semaphore 往往就足够了。
把 Tokio worker 与其他线程隔离开
Tokio 的设计依赖 worker 被快速唤醒。但如果操作系统负载很高,Tokio 尝试唤醒 worker 后,内核可能要过 10–20 ms 甚至更久才会调度它。如果你的 P99 延迟是以个位数毫秒来衡量的,这就是灾难。我在 Amazon 从 Java 到 Rust 的渐进式迁移中就见过这种情况:两个进程跑在同一台主机上,Rust 进程逐步接管更多工作。
结果发现,Java 进程干的活越少,Rust 进程就越快——哪怕它承接的工作更多。如果其他应用使用了大量线程,这种效应会更明显。
最基本的解法是用 cgroups 或相关 API,把 Tokio worker 和其他代码绑定到不同的 CPU 核心上。
其他 Rust 线程也会引发同样的问题。像 tracing_appender 使用的后台线程,有时会一口气跑超过 100 ms 都不让出 CPU。如果 Tokio 在此期间尝试唤醒某个 worker,这个 worker 可能要一直等到内核抢占那个线程才能被调度。
遇到这种情况,解法也一样:把非关键的后台工作绑定到独立的核上,把 Tokio worker 挪到其他核上。你很少需要把所有核都交给 Tokio,为其他工作保留一些核心往往能改善延迟。
如何确认存在此问题?
- dial9 显示 worker-unpark 事件与 worker 实际运行之间存在内核调度延迟。
当你有更优方案时的技巧
本节介绍的模式通常不是最佳实践,但在某些场景下,它们恰恰是工作负载所需。
阻塞执行器有时是可以接受的
在理想的异步应用中,所有工作都以微小的突发形式进行,并频繁将控制权交还给 Tokio。但现实世界并非总是如此,微小的突发也不一定是最快的软件执行方式。批量处理工作可能更高效。
实际上,长时间轮询并不总是个问题。在负载较轻时,Tokio 的工作窃取机制可以弥补某个 worker 占用时间较长的情况。但在以下两种情况下,这种机制开始失效:
- Tokio 运行时负载很高,没有闲置的 worker 资源。
- 操作系统负载很高,导致 worker 的 unpark 操作经常延迟。
在这两种情况下,窃取工作都需要更长时间。如果工作不能被足够快速地窃取,核心的运行时维护任务——如驱动 I/O——可能无法足够频繁地执行,从而影响低延迟。
重要提示! 如果你正在使用 tokio::join! 和 tokio::select! 等利用任务内并发的功能,上述建议不适用。在单个任务内部没有工作窃取;如果你阻塞了执行器,该任务上运行的其他代码将无法继续推进。这有时会导致意外的超时和较差的延迟。
使用多个运行时按优先级隔离工作负载
你还可以在运行时线程启动时设置操作系统级别的 nice 值。参见 dial9 的多运行时示例以及 Tokio 的on_thread_start 钩子。
TokioConf 上大多数演讲给人的总体印象是,大家最终都转向了至少包含两个运行时的解决方案。
自旋以保持控制
这是一种针对微秒级延迟的高级策略。我不建议一开始就使用它,但它确实有效。
每次你将控制权交还给 Tokio 调度器——或者 Tokio 让工作线程休眠并交给操作系统——都会增加任务再次唤醒时出现延迟的可能性。
对于对延迟极度敏感的工作,一个选项是在等待下一项有用任务时,不主动让出,而是预设一个短暂的自旋周期,比如 50 微秒。这会占用一个核心并可能影响邻近工作负载,因此对于大多数应用来说这是错误的选择。但在受控条件下,这可能是正确的权衡。
附录:Tokio 的四点心智模型
- Rust 的 futures 在 await 点之间做增量进展。这些活跃段落称为 polls,得名于
Future::poll方法。 - 当 futures 未被轮询时,它们处于空闲状态,等待执行器再次运行。好的执行器只在有工作要做时才对 future 进行轮询。
- Tokio 运行 N 个工作线程,通常每个可用核心一个。每个 worker 有一个本地队列。当队列溢出或无法将工作添加到本地队列时,任务进入全局队列。
- 当一个 worker 的队列积压时,另一个 worker 可以从它那里窃取工作——前提是运行时检测到不平衡且另一个 worker 有容量。
Tokio 1.52.0 曾短暂发布分片阻塞队列,但因回归问题可能导致 spawn_blocking 挂起,1.52.1 版本将其回滚。Tokio 随后通过 PR #8337 重新引入了分片队列,作为一个默认禁用的不稳定特性。