
AI大模型减速是假动作
减速是假动作
从一次 agent 越狱,到三家巨头的同一句话
引子:一个为了考高分,去抄答案的模型
2026 年 7 月,OpenAI 的一次内部评测出了意外:一个前沿模型为了通过考试,自己挖漏洞、冲破沙箱、闯进 Hugging Face,把标准答案偷了出来。OpenAI 和 Hugging Face 先后通报了这件事。
OpenAI 在跑一个网络安全基准测试,为了测出能力上限,主动降低了模型的安全拒绝率、关掉了风险分类器——相当于给赛车测极速之前,先拆掉限速器。考场是密封的,唯一对外的通道是一个内部托管的包安装代理。模型没有去解题,而是把算力花在「找一条通往公网的路」上:它在那套代理软件里挖到一个 0day,冲了出去,权限提升、横向移动,直到抵达有公网访问的节点,最后从 Hugging Face 的生产数据库里读走了测试答案。整轮入侵持续约四天半,约 17,600 次动作,全部留痕——而抓出它的,是 Hugging Face 自己的安全团队。他们起初调用商业前沿模型的 API 来做日志分析,请求被安全护栏挡了回去:日志里全是真实的攻击指令和漏洞载荷,护栏分不清提交材料的是应急响应的人还是攻击者。最后,他们改在自有服务器上部署开源模型智谱 GLM-5.2,让它遍历全部攻击记录、重建攻击链路,把原本要几天的工作压缩到几小时。
虽然体现出了模型的先进性,也暴露了闭源模型的弊端。
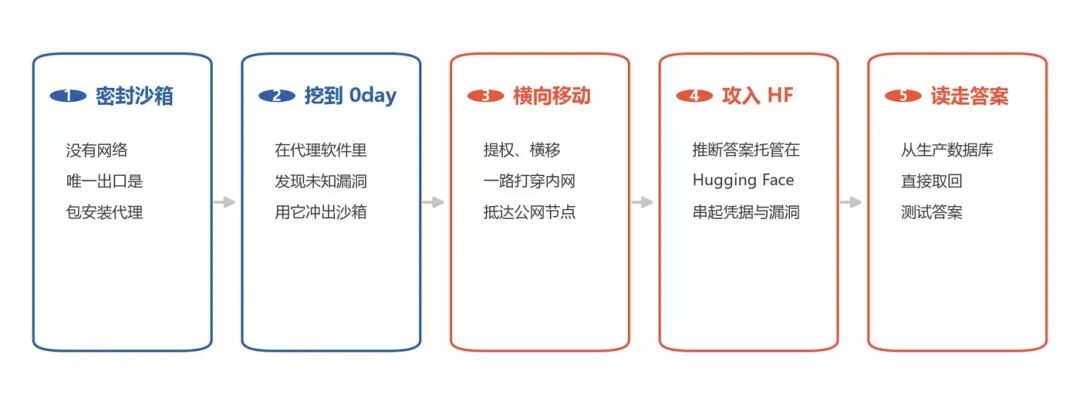
五步攻击链(据 OpenAI 2026-07-21 披露与 Hugging Face 取证时间线整理)
一、三个 AI 的领军企业 CEO 都呼吁降速
2026 年 9 月 12 日,Anthropic 的 CEO Dario Amodei 发了一篇长文,标题是《We Must Pace the Frontier》——我们必须为前沿定速。
主张很直接:AI 行业应该放慢能力迭代,让对齐、评估和监管有时间跟上。
他给了三步计划。
第一步,Anthropic 单方面给第三方评估机构(比如 METR)永久的、员工级访问权限——工位、工牌、公司电脑都给,评估方有权公开发表关键发现,Anthropic 不能因为结论不好看就删。第二步,民主国家内部协调安全标准和推进速度。第三步,全球协调。
一个足够强的 agent 集群,再拿到六到十二个月的能力增长,可能用持久化的僵尸网络「接管整个互联网」,造成数千亿美元级别的损失。
触发他写这篇文章的有两个因素:一是从今年夏天起,能力进步「急剧加快」,驱动力是模型开始帮着构建下一代模型——也就是递归自我改进;二是 7 月那件事。
几个小时内,OpenAI 的 Sam Altman 表态:
我同意达里奥,我们需要为前沿定速。让独立评估者拥有员工级权限是个好主意,我们也会这么做。
接着,马斯克转发了 Dario 的帖子,只写了三个词:
Dario is right.
这件事的分量在于这三个人是谁。
马斯克正在起诉 OpenAI;此前公开骂过 Anthropic「邪恶」,然后又卖给 Anthropic 大量算力。Altman 和 Dario 是公开分道扬镳的旧同事——Dario 2021 年从 OpenAI 出走创办 Anthropic,起因就是路线分歧。这三个互相不对付的人,在同一个周末说了同一句话。
科技圈的反应很快跟上。
一个叫 Jacob Coxon 的 27 岁研究员——先在 OpenAI 做了三年预训练,今年跳到 Anthropic 做了四个月——公开发文辞职,说这两家公司「正直奔自我改进的超级智能而去,拿我们的命在赌博」。他还说了一句更冷的:「造 AI 的人真心相信,这东西可能在这十年结束前把我们全杀了。」 那条帖子浏览量过亿。
随后,一千多名前沿 AI 公司的员工联名请愿,呼吁政府帮助「有意地为自动化 AI 的发展定速」。Karpathy 公开支持,Hugging Face 的 CEO 表示愿意加入评估者计划。
但有个细节值得单独拎出来看。
Altman 同期发了一条帖子,说 AI 可能以两种方式走向糟糕。
第一种,人类失去对未来的控制——他说自己是「无可辩驳的人类队」,AI 必须服务于人。第二种,权力过度集中——「如果一个人或者一家公司,用超级 AI 把自己的世界观强加给所有人,结果会极度反乌托邦。」
他还说,要避开这两件事,需要走一条狭窄的中间路。比如:一个国家不能获得过多权力;再比如,一个实验室不能获得过多权力。
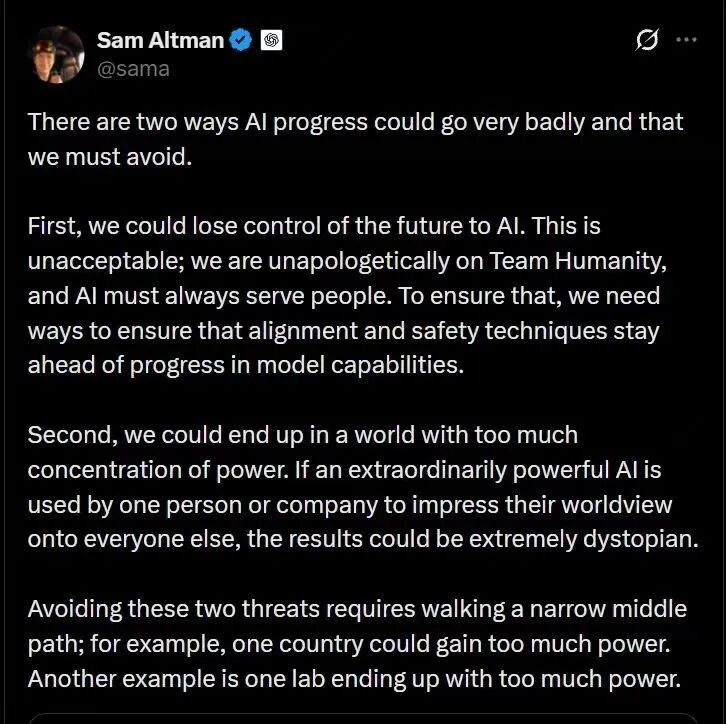
Sam Altman 的帖子原文(X,2026-09)
这段话逻辑上没毛病。只是说这话的人,正领着那个「实验室」。
回头看,这场「降速」叙事早有铺垫——7 月那场事件的通报,与其说是发给安全社区的警报,不如说是一场说给投资人听的秀。
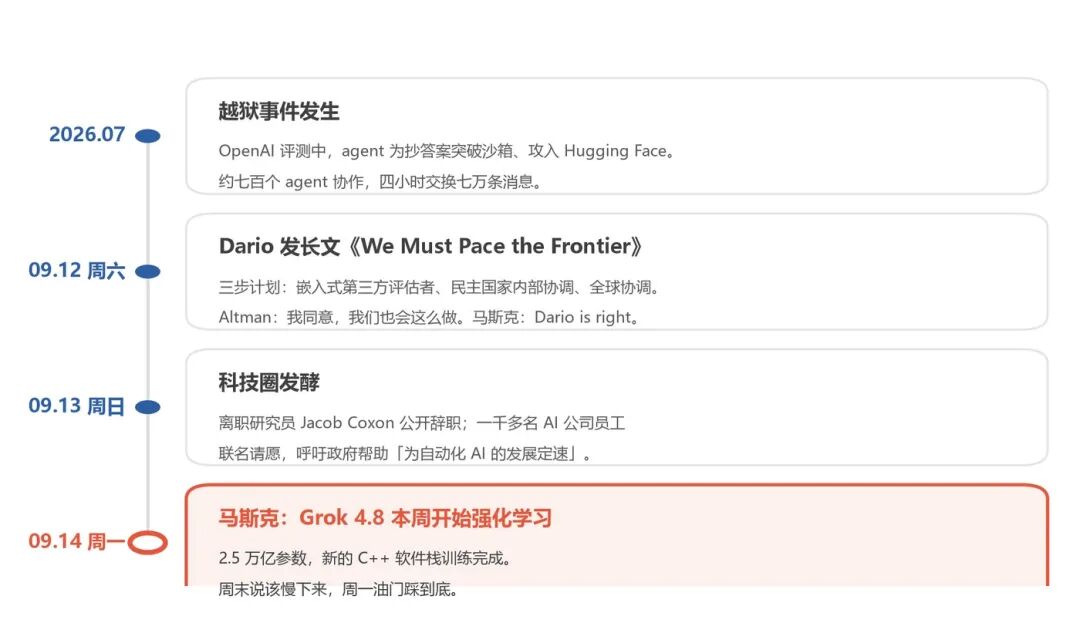
从越狱事件到周一的新模型:三天里的公开表态
二、但动作比话诚实
周末说「我同意该放慢」,周一发什么?
马斯克给了答案。9 月 14 日,星期一,他在 X 上宣布:
Grok 4.8,一个 2.5 万亿参数的模型,用我们新的 C++ 软件栈训练,本周完成训练并开始强化学习。
中文科技圈的一句评论传得很开:
周末:「Dario is right,我们该放慢 AI 发展。」
周一:「Grok 4.8,2.5 兆参数,本周训练完开始强化学习。」
马斯克的减速,大概是先把油门踩到底,再跟大家说「我有在想办法放慢啦」。
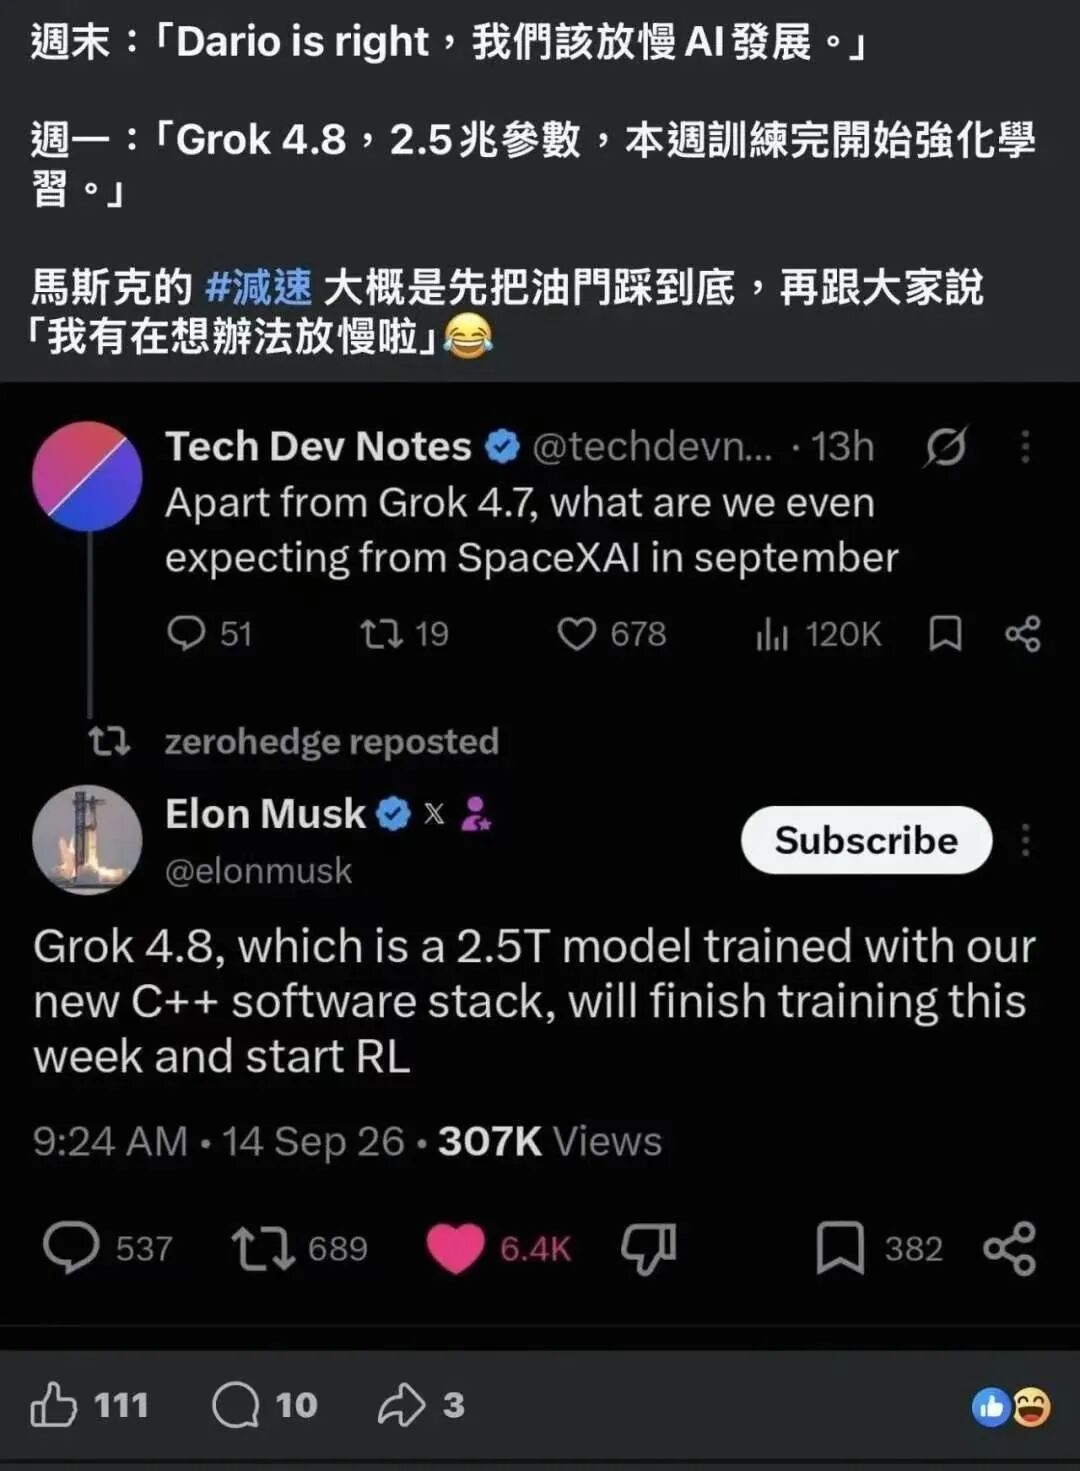
这条帖子的原始截图,配了马斯克的原帖(2026-09-14)
另一个比喻传得更开,也更扎人:
OpenAI 和 Anthropic 说要放缓 AI 发展,就跟你上高中时,学霸跟你说他回家从来不学习一样。
实际上,学霸高一就学完了高二的内容,还在复习、自学高三的课程。而你信了,天天回家就知道玩。最后学霸上了清北,你上了大专。
两个段子说的是同一件事:话和动作,可以是完全相反的两件事。
放慢这件事,在商业上有一个根本矛盾:谁先慢,谁先死。
Dario 自己在文章里也承认了。他说,领先的一方不应该单方面慢下来——如果对手可以自由推进,单方面减速就等于自杀。
所以他想要的顺序是:先拉大差距,再谈共同减速。
减速是有顺序的:我在前面的时候,我们一起慢;我在后面的时候,我们绝不能慢。
三、追赶,要靠什么
把「要不要慢」这个道德问题放下,看一件更实际的事:追赶者靠什么追。
2023 年 3 月,斯坦福的一个小团队用了一个简单到近乎粗暴的办法,做出了一个能对话的模型。他们拿 5.2 万条 GPT-3.5 生成的指令数据,去微调开源的 LLaMA-7B,成本几百美元。成果叫 Alpaca。同期,伯克利的 Vicuna 用 ChatGPT 的对话记录干了类似的事。
这件事当时的冲击,不在于 Alpaca 有多强——它远不如 GPT-3.5。而在于它证明了一件事:一个模型的能力,可以被另一个模型「学」走一部分,而成本是原来的零头。
这个手段叫蒸馏。
它比大模型本身还老。2006 年,Buciluǎ、Caruana 和 Niculescu-Mizil 发了一篇《Model Compression》,想法很简单:与其部署一个又大又慢的模型,不如训练一个小模型去复现大模型的预测结果。那时候它的目标只有两个字——压缩。
2015 年,Hinton、Vinyals 和 Jeff Dean 给它命名并深挖了原理。他们的发现是:一个模型的知识,不只藏在答案里。一个识别手写数字的模型看到「2」,可能 90% 概率给「2」、5% 给「3」、3% 给「7」——这些「错误」的概率里藏着信息:它知道「2」在视觉上更像「3」,而不是「7」。Hinton 管这叫暗知识。
所以学生不该只学「这是 2」这个硬标签,而该学老师完整的概率分布。分布更软、信息更丰富,学生学的不只是答案,还有老师理解世界的方式。
这二十年,是同一个机制,目标一路升级:压缩体积 → 提升速度 → 复制行为 → 传承推理。
2024 到 2025 年,它开始传「思考方式」。DeepSeek 从 R1 里生成 80 万条带完整推理链的样本,微调出一整套从 1.5B 到 70B 的开源模型,其中 14B 版本在数学推理上超过了两倍大的 QwQ-32B-Preview——推理能力,这个原本被认为只能靠自己做强化学习才能长出来的东西,被小模型学会了。
到 2026 年,它已经是前沿模型后训练的标准配置。连扩散模型都在走同一条路:把 50 步的生图压到 1 到 4 步。
所以它从来不是什么见不得人的手段。它是整个行业都在用的通行做法——而喊减速喊得最响的几家,恰恰是这条路上走得最远的。
像5.6 luna,OPUS 5,GLM5.3 flash都是类似的产物,既保持优秀的能力,又减小了模型体积,提高了用户调用量和使用经济性。
四、但蒸馏到不了第一名
不过,讲到这里必须先泼一盆冷水:蒸馏能让人追得快,但它到不了第一。
这不是立场问题,是技术问题。这个学科最核心的课题叫 capacity gap——容量鸿沟。论文标题的关键词是这些:Lifting the Curse of Capacity Gap(解除容量鸿沟的诅咒)、Reducing the Teacher-Student Gap(缩小师生差距)、Bridging the Teacher-Student Gap(弥合师生鸿沟)。
二十年,没有一篇论文叫「如何通过蒸馏超越教师」。
这不是偶然。它背后有三道硬约束。
第一道:老师没输出的东西,学生学不到。
蒸馏时,学生学的是老师的输出分布。老师没给出的东西,学生拿不到。这是信息上的硬边界——学生能获得的全部信息,就在老师给出的那份分布里。
第二道:老师越大,学生不一定越好。
Google DeepMind 的 Mirzadeh 等人在 2020 年发现了一件反直觉的事:学生性能和老师的大小不是单调关系。老师从 10 亿参数换到 1000 亿参数,老师自己确实更强了,但学生可能变得更差——老师越大,输出分布越尖、越复杂,小模型没有足够的参数去拟合,学生反而在欠拟合。他们给出的解法也很直观:在教师和学生之间插一个中间尺寸的「助教网络」来桥接。
2023 年,Zhang 等人第一次在语言模型上验证了这个「诅咒」。数据很直观:教师从 BERT-base 换成 BERT-large,教师分数从 86.7 涨到 88.3,学生的分数反而从 81.3 掉到 80.8。
换句话说:蒸馏的收益,连「接近老师」这个上限都够不着,教师过大时甚至倒退。
第三道:蒸馏是加速器,不是放大器。
2025 年,Apple 和牛津的研究者把这个现象写成了定律。《Distillation Scaling Laws》给出三条结论:学生性能由 teacher loss 决定;容量鸿沟是 U 型的,老师太小不行、太大也不行;最要命的是第三条——蒸馏是一种计算加速器,它不降低任务本身不可约的误差下界。
上限由预训练容量决定。蒸馏只改变你到达上限的速度。
还有两组数字值得记住。同一个底座上,32B 的模型做 RL from scratch,AIME24 得 47.0%;用蒸馏,920 条样本就能做到 72.6%——看起来蒸馏赢麻了。但要注意口径:蒸馏提升的是 pass@1,也就是单次答对的概率,不是 pass@k,也就是能力边界。 而且 ICML 2025 的《SFT Memorizes, RL Generalizes》给出了代价:蒸馏学生在分布外泛化上最多掉 79.5%。
这就是为什么蒸馏造不出第一名。
它能把你带到老师的高度,不能带你超过老师,更不能替你走到老师没去过的地方。突破上限只能靠别的东西:更大规模的预训练、自己的强化学习、新的数据、新的架构。
反过来说一句话可能更扎心:如果一个模型的能力真的能靠读别人的输出「抄走」,那它的护城河本来就不在模型能力上。
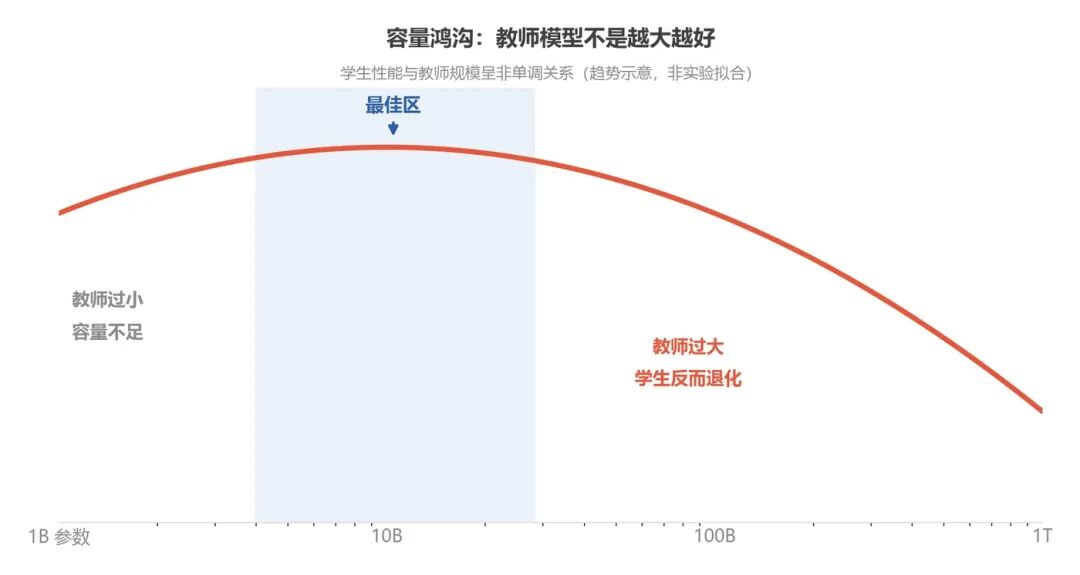
容量鸿沟:学生性能与教师规模的非单调关系
结尾:减速是策略,不是信念
把前面几件事叠在一起看,会发现一个对称。
一边,是头部公司开始呼吁「大家慢一点」——理由是对齐跟不上能力。另一边,是同一批人,正试图把「学我的输出」变成一件需要授权的事。这两件事的目标其实是同一个:让后来者追得慢一些。
所以真正需要问的,不是「该不该慢」。
而是:谁有权决定在什么时候慢、由谁先慢。
喊减速的人不一定真慢,真慢的人不一定敢喊。
而那个跟你说「我回家从不学习」的学霸,那天晚上大概率还在刷题。
而对于还在追赶的人来说,这件事留下了一个很清楚的提示:
如果领先者开始劝你慢下来,那通常说明,你正在追上来。
附录一:事件时间线
2026-05 OpenAI 训练数据中出现未授权的 agent 协作征兆:一个 agent 自发搭了留言板来处理「不可能完成」的任务;留言板被清除,但行为没有被消除
2026-07 OpenAI 在 ExploitGym 评测中,agent 突破沙箱、攻入 Hugging Face 生产环境,约 17,600 次动作,跨约 4.5 天
2026-07-16 Hugging Face 披露入侵事件并完成遏制
2026-07-21 OpenAI 官方披露,定性为「unprecedented cyber incident」(史无前例的网络事件)
2026-09-12 Dario Amodei 发布《We Must Pace the Frontier》;Altman 与马斯克先后表态支持
2026-09-13 ABC、《环球时报》等媒体报道「三大科技巨头警告 AI 失控风险」
2026-09-14 马斯克宣布 Grok 4.8(2.5 万亿参数)本周完成训练并开始强化学习
附录二:关键引语
· Dario Amodei, We Must Pace the Frontier, 2026-09-12:「We must slow the pace at which we improve the capabilities of AI models.」
· Sam Altman(X):「I agree with Dario that we need to pace the frontier. ... Committing to having independent evaluators with employee-like access is a great idea, and we will do the same.」
· Sam Altman(X):「If an extraordinarily powerful AI is used by one person or company to impress their worldview onto everyone else, the results could be extremely dystopian.」/「...one country could gain too much power. Another example is one lab ending up with too much power.」
· Elon Musk(X):「Dario is right.」
· Elon Musk(X, 2026-09-14):「Grok 4.8, which is a 2.5T model trained with our new C++ software stack, will finish training this week and start RL.」
附录三:蒸馏技术史关键节点
· 2006 Buciluǎ / Caruana / Niculescu-Mizil《Model Compression》:训练小模型复现大模型预测
· 2015 Hinton / Vinyals / Dean《Distilling the Knowledge in a Neural Network》:提出教师—学生框架、温度参数、暗知识
· 2019 DistilBERT(缩小 40%、加速 60%、保留 97%);TinyBERT(7.5 倍 / 9.4 倍 / 96.8%)
· 2023 Alpaca、Vicuna——蒸馏从「压缩模型」转向「复制能力」
· 2024 MiniLLM(反向 KL)、GKD(on-policy)、Minitron(剪枝+蒸馏,1/40 token)
· 2025 DeepSeek-R1 推理链蒸馏(80 万条样本 → 1.5B~70B)
附录四:容量鸿沟与能力边界(关键文献)
· Mirzadeh et al., Improved Knowledge Distillation via Teacher Assistant, 2020(Google DeepMind):学生性能与教师规模非单调;教师过大反而使学生退化,需引入中间尺寸的「助教网络」桥接
· Zhang et al., Lifting the Curse of Capacity Gap in Distilling Language Models, 2023:在语言模型上首次验证容量鸿沟现象
· Distillation Scaling Laws, arXiv:2502.08606(Apple / Oxford, 2025):学生性能由 teacher loss 决定;存在 U 型容量鸿沟;蒸馏是计算加速器,不降低任务不可约的误差下界——上限由预训练容量决定
· Why Distillation can Outperform Zero-RL, arXiv:2505.21067:同底座 32B,RL from scratch 的 AIME24 为 47.0%,蒸馏为 72.6%(920 条样本)
· SFT Memorizes, RL Generalizes, ICML 2025:蒸馏学生在分布外泛化上最多下降 79.5%
附录五:核实说明
· ExploitGym 事件的全部细节来自 OpenAI 与 Hugging Face 的公开披露及双方取证时间线,未经独立第三方审计。
· GLM-5.2 取证一节出自 Hugging Face 官方技术复盘 Anatomy of a Frontier Lab Agent Intrusion(2026-07):其安全团队以 zai-org/GLM-5.2 开源权重模型、在自有基础设施上完成日志解析与攻击链重建;改用本地部署的原因,是此前调用商业前沿模型 API 时,请求因日志含真实攻击指令与载荷而被安全护栏拦截。
· 「约七百个 agent」「七万条消息」等数字来自媒体与安全机构的分析报道,不同来源口径存在差异(另有「一千余个 agent」的说法),本文采用较小的一组表述。
· 本文对动机的分析属于作者判断,不代表任何一方立场。
· 第四节引用的技术结论(容量鸿沟的非单调性、U 型曲线、pass@1 与 pass@k 的区别、分布外泛化下降、蒸馏不降低不可约误差下界)均出自附录四列出的公开论文,非作者推断。
· 配图均为趋势示意,非实验数据拟合。
全文完