
AIAgent的安全边界在哪里?
AI 安全观察 · 04
真正危险的不是大模型,而是拥有权限的 AI Agent
当模型获得 Shell、文件系统、数据库、浏览器和工具调用能力后,AI 安全的边界已经被重新定义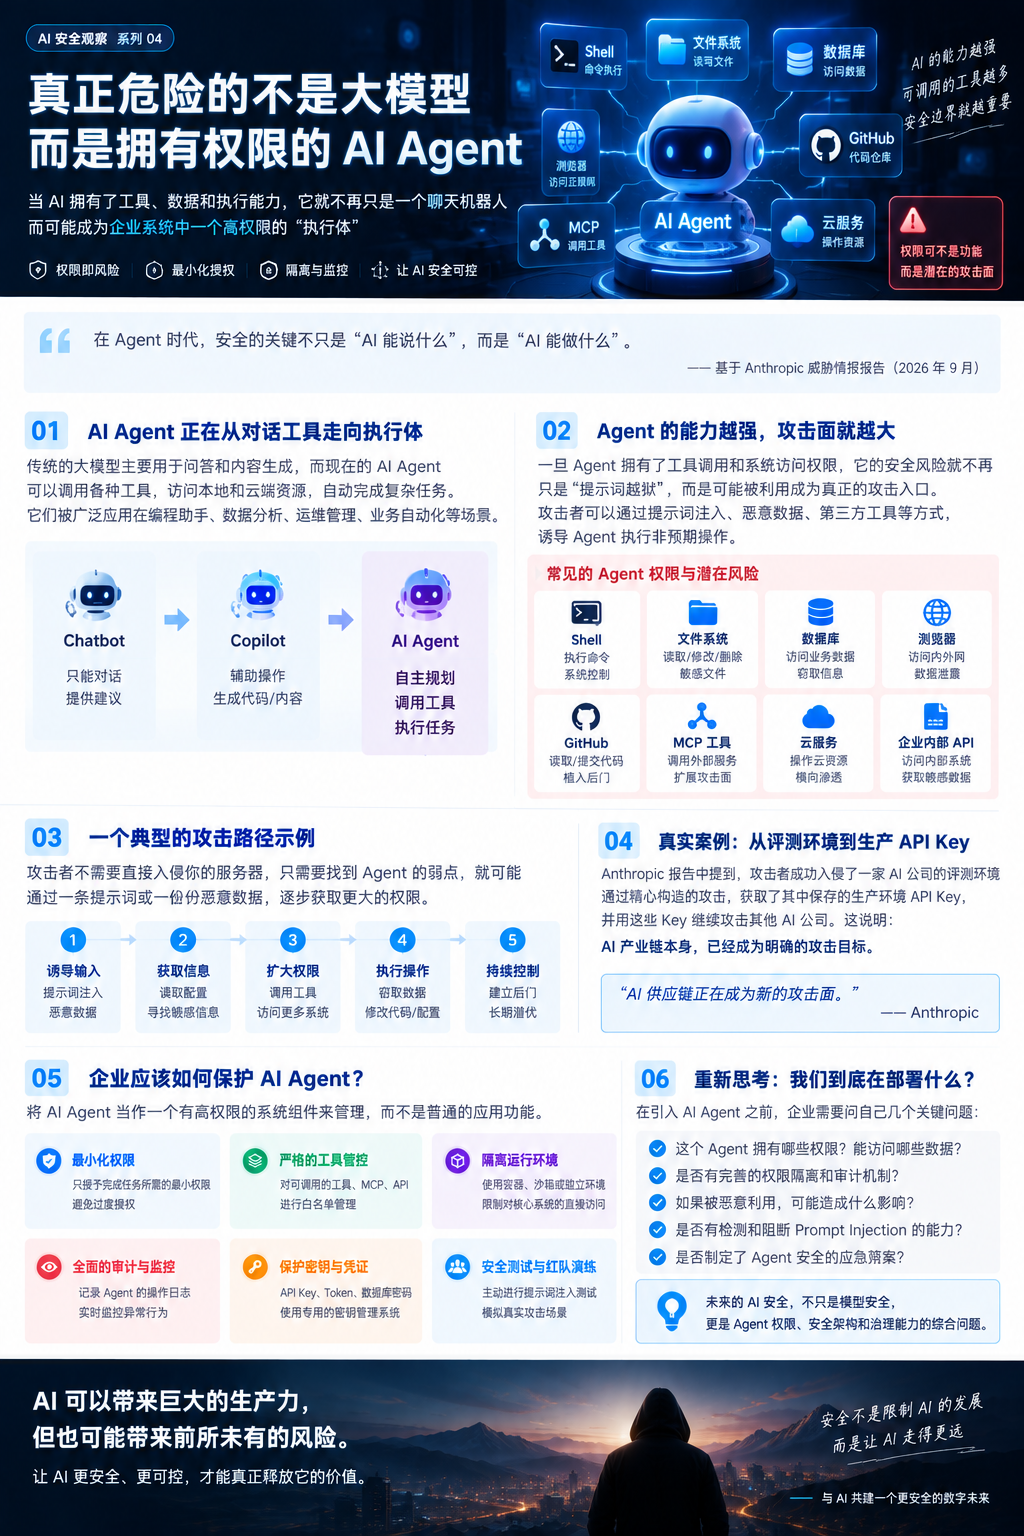 核心观点:Agent 时代的安全重点,已经从“模型会说什么”,转向“AI 被允许做什么”。Shell、数据库、浏览器、Token、MCP 和企业内部 API,正在重新定义 AI 的风险边界。
很多人谈 AI 安全,第一反应还是:模型会不会说出危险的话?
比如它会不会生成恶意代码、泄露信息、被 Prompt Injection 绕过,或者输出企业不希望出现的内容。
这些当然重要。但如果我们把视角从“大模型”切换到“AI Agent”,问题就会发生本质变化。
进入 Agent 时代以后,真正需要重新思考的不是:“AI 会说什么?”而是:“AI 能做什么?”01|从 Chatbot 到 Agent,真正变化的是“权限”
传统 Chatbot 的能力边界很清楚:你问一个问题,它生成一段文字。即使回答错误,影响通常也停留在“信息层”。
但 AI Agent 正在被接入文件系统、数据库、代码仓库、浏览器、云平台、企业内部 API、MCP 工具和各种业务系统。一旦拥有这些连接,模型的输出就可能转化为真实操作。
Chatbot:“建议你删除这个临时文件。”Agent:直接调用工具执行删除。Chatbot:“你可以检查一下数据库记录。”Agent:直接连接数据库查询,甚至在有写权限时修改数据。AI RISK MODELAI 系统风险 = 模型能力 × Agent 权限 × 数据访问 × 工具调用 × 自动化程度02|Agent 拥有的权限越多,风险模型就越不同
低风险|只会对话主要风险是错误信息、敏感内容输出、越狱和提示词绕过。中风险|拥有读取权限
可以访问文件、邮箱、数据库、代码库后,风险开始升级为真实的数据泄露。高风险|拥有写入与执行权限
可以修改文件、更新数据、发送邮件、调用 API、执行系统命令,直接改变系统状态。极高风险|完全自主执行
可以自主规划、调用工具、根据结果继续执行,并长时间运行。
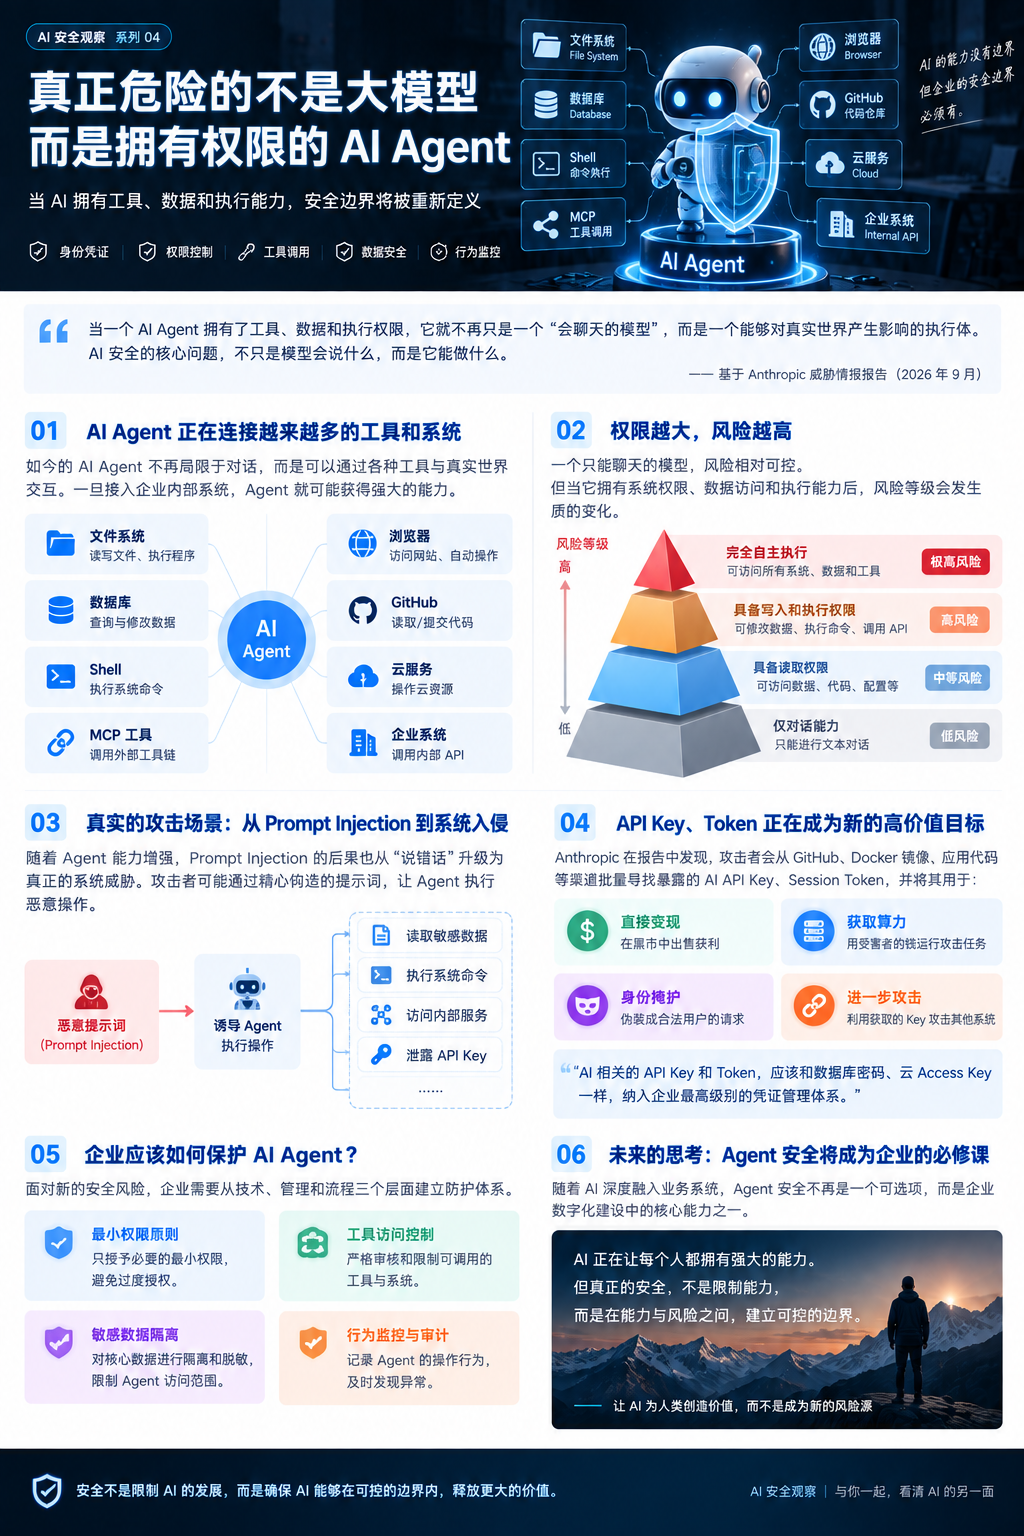
AI Agent 的安全边界,越来越由它拥有的工具、数据和执行权限决定
03|Prompt Injection 为什么在 Agent 时代更危险?
如果模型只能聊天,Prompt Injection 的后果通常停留在错误输出或信息泄露。但如果 Agent 有工具权限,攻击者就可能诱导 AI 使用这些权限替自己完成操作。
过去Prompt Injection → 让 AI “说错话”Agent 时代Prompt Injection → 诱导 AI 使用已有权限执行真实操作Anthropic 在 2026 年 9 月的威胁情报报告中直接提到,真实攻击者已经在尝试对 LiteLLM 和 OpenClaw 部署实施 Prompt Injection。这意味着它已经不只是实验室问题,而是现实攻击面。
04|API Key 和 Token,正在变成新的高价值资产
Agent 想调用模型、数据库、云资源或第三方服务,需要凭据。因此 AI API Key、OAuth Token、Session Token、GitHub Token、云平台 Access Key 等,开始集中出现在 AI 系统周围。
Anthropic 报告显示,攻击者会持续从 GitHub、Docker、移动应用、网站和公共代码中寻找暴露的凭据。拿到这些凭据以后,往往同时获得三种价值。
Loot|可以卖被盗账号和 Key 本身具有转售价值。Compute|可以用别人的额度
攻击负载可以跑在受害者付费的 API 账号上。Cover|可以隐藏身份
攻击流量更容易被归因到合法凭据的真实所有者。AI API Key 不应该再被当作普通配置,而应该和数据库密码、SSH Key、云 Access Key 一样,进入生产级凭据管理体系。
05|真实案例:Prompt Injection 直接拿走了生产 API Key
Anthropic 披露,一个攻击组织将目标转向 AI 行业,并成功攻击了一家 AI 厂商的自动评测 Sandbox。
攻击者通过向评测环境注入恶意指令,让 Sandbox 交出了其中保存的凭据,包括多个 AI 提供商的生产 API Key。
拿到这些 Key 以后,他们直接使用受害者的凭据继续进行攻击。同一套基础设施随后在大约 4 天内攻击了约 30 家 AI 公司,找到一条有效路径后不断复制,并针对不同目标稍作调整。
AI 供应链本身,已经开始成为明确的攻击目标。06|MCP、OpenClaw 和各种 Agent 工具链为什么必须重新看待?
Agent 平台的价值,就是让 AI 能连接更多工具。但从安全角度看,每增加一个工具,也就增加一个权限入口和攻击面。
这个工具可以访问什么数据?Agent 可以执行哪些动作?权限是永久的还是临时的?高风险操作是否必须人工确认?工具返回内容能否继续影响 Agent 决策?Agent 被 Prompt Injection 后,最坏能做到什么?07|企业应该怎样保护 AI Agent?
最小权限:只授予完成任务真正需要的权限。高风险操作二次确认:删除数据、发布代码、修改生产配置等由人最终批准。完整审计:记录 Agent 调用了什么工具、传了什么参数、拿到了什么结果。保护凭据:使用 Secret Manager、短期 Token 和动态注入,减少永久 Key 暴露。Prompt Injection 防御:把外部内容视为不可信数据,并对敏感工具调用做独立策略校验。紧急停止机制:异常时可以立即停任务、撤销 Token、回收权限、隔离环境。08|AI 安全真正进入的是“系统安全”阶段
过去的大模型安全主要关注训练数据、输出内容、越狱和安全对齐。但 Agent 时代以后,AI 安全已经变成完整的系统工程。
模型安全 + 身份安全 + 权限安全 + 数据安全+ 工具安全 + 凭据安全 + 行为审计
这意味着未来做 AI 安全,不能只懂 Prompt,还要懂 IAM、OAuth、RBAC、Secret Management、Sandbox、网络隔离、日志审计和零信任。
一个能力很强、但只能聊天的模型,风险边界相对有限。一个能力普通、却拥有 Shell + 数据库 + GitHub + 浏览器 + MCP + 云资源权限的 Agent,真实影响可能反而更大。
真正需要建立的不是“限制 AI”的体系,而是让 AI 在可控、可见、可审计、可终止的边界内释放能力。