
AI大模型实战-关于机器学习,你需要了解的基本概念(二)
(我:本篇文章除了标注我:之外的文章为基于购买的原作者https://time.geekbang.com/column/article/784106教程的改写,并没有像某些人进行原创声明等,请放心阅读)
(我:看这张封面图,心情心旷神怡)
上一讲我们弄清楚了机器学习到底在做什么,还上手练过线性回归与逻辑回归这两个入门模型。在此基础上,这一讲把视野再放宽一些,依次认识四种经典算法:决策树、随机森林、支持向量机和神经网络。
机器学习中的经典算法
一、决策树:用一连串提问做判断
先来玩个小游戏:朋友心里默想一样东西,你每轮只能提一个问题,而对方只会回答“是”或“不是”,看你能不能用尽量少的提问猜中答案。决策树的工作方式与此十分相像——它从训练数据中归纳出一系列判断条件,样本每经过一个条件就被分往某个分支,一路走到末端便得出结论。决策树既能做分类,也能做回归,客户分群、信用评估、辅助医疗诊断等场景里都能见到它的身影。
下面换一个贴近生活的问题:周末是出门玩还是待在家里,很大程度上要看天气、气温和风力。我们把这三个因素连同最终选择的活动都编码成数字,拼成一份迷你数据集,编码规则如下表所示:
| 字段 | 作用 | 取值编码 |
|---|---|---|
| 天气状况 | 特征 | 0 = 晴天,1 = 阴天,2 = 雨天 |
| 气温 | 特征 | 0 = 偏低,1 = 适中,2 = 偏高 |
| 风力 | 特征 | 0 = 无风,1 = 微风,2 = 大风 |
| 活动 | 标签(待预测) | 0 = 去野餐,1 = 去博物馆,2 = 在家看书 |
scikit-learn(下文简称 sklearn)已经把决策树分类器封装成了 DecisionTreeClassifier,训练和画图都只需几行调用。我们一共准备了 8 条样本(晴天的 3 条都选择去野餐,阴天的 3 条都去博物馆,雨天的 2 条都在家看书),完整代码如下:
import numpy as np

from matplotlib import pyplot as plt

from sklearn import tree

# 指定中文字体,避免图中的中文显示成方框

plt.rcParams["font.sans-serif"] = ["SimHei"]

FEATURES = ["天气状况", "气温", "风力"]

ACTIVITIES = ["去野餐", "去博物馆", "在家看书"]

# 每行是一条样本,三列依次对应 FEATURES

X = np.array([

    [0, 2, 0], [0, 1, 1], [0, 2, 1],

# 晴天

    [1, 1, 1], [1, 0, 0], [1, 2, 2],

# 阴天

    [2, 0, 2], [2, 1, 1],

# 雨天

])

# 标签 0/1/2 是 ACTIVITIES 中活动的下标

y = np.array([0, 0, 0, 1, 1, 1, 2, 2])

# max_depth 限制树最多长几层;固定 random_state,保证每次运行结果一致

model = tree.DecisionTreeClassifier(max_depth=3, random_state=42)

model.fit(X, y)

fig, ax = plt.subplots(figsize=(12, 7))

tree.plot_tree(

    model,

    ax=ax,

    feature_names=FEATURES,

    class_names=ACTIVITIES,

    filled=True,

# 按类别给节点着色

    rounded=True,

# 使用圆角方框

    fontsize=12,

)

plt.show()
运行之后,程序画出的树如下图所示:
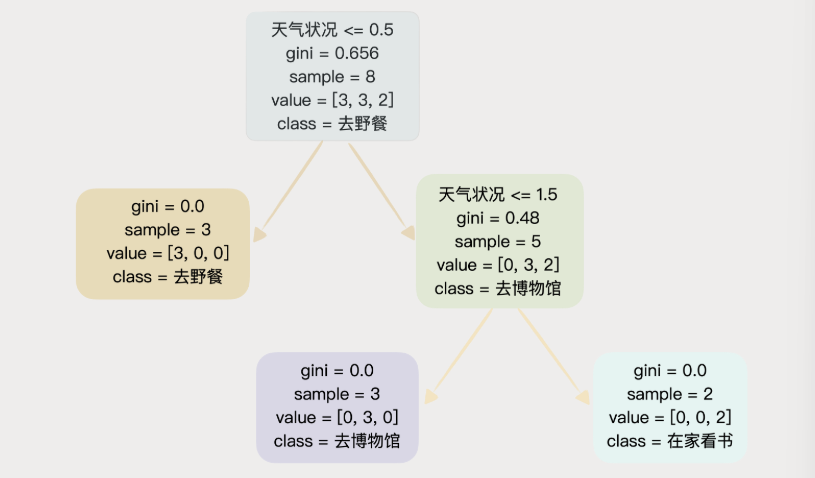
图中每个圆角方框都是树上的一个节点,框内几行文字的含义分别是:
- gini(基尼不纯度):衡量节点里样本的“混杂”程度。数值越小,落到该节点的样本越集中于同一类;等于 0 时,节点中只剩一种类别,达到最“纯”的状态。以根节点为例,8 个样本按类别分成 3、3、2,gini = 1 − (3/8)² − (3/8)² − (2/8)² ≈ 0.656;而左侧那片叶子只剩“去野餐”一类,gini 就降到了 0。
- samples:走到这个节点的训练样本个数。顺着箭头往下看,这个数字随着一次次划分不断变小(8 拆成 3 和 5,5 再拆成 3 和 2),数据是怎样被一步步切开的一目了然,每个分支背后有多少数据作支撑也能心中有数。
- value:节点内各个类别分别有几个样本,排列顺序与
class_names保持一致。根节点的[3, 3, 2]表示去野餐、去博物馆、在家看书的样本依次为 3 个、3 个、2 个;如果是二分类问题,这里就只会出现两个数。 - class:节点里数量最多的类别。在叶子节点上,它就是模型给出的预测结果;在中间节点上,它仅表示此处哪一类占多数。根节点中去野餐和去博物馆都是 3 个,打成了平手,这时显示的是排在前面的“去野餐”。
把这几项放在一起看,就能读懂这棵树依据哪个特征、以什么阈值切分数据,每次切分后是否变得更“纯”,以及整棵树长到了多深。这些数字还能暴露隐患:如果不少叶子里只有一两个样本,往往说明模型把个别特例当成了规律,这正是稍后要讲的过拟合。调整超参数时,例如用 max_depth 限制深度、用 min_samples_split 规定节点至少要有多少样本才允许继续划分,它们同样是重要的参考。
二、随机森林:让多棵树共同表决
单独一棵决策树的判断难免带有偏差。如果一次种下许多棵树,再让它们一起拿主意,结果会不会更靠谱?随机森林正是沿着这个思路设计的。它是集成学习(ensemble learning)的代表性方法,道理近似于“三个臭皮匠,顶个诸葛亮”:单个模型能力有限,把多个模型的意见综合起来,结论往往更可靠。至于名字里的“随机”,是因为它在两个环节有意引入了随机性:
- 随机抽取样本:每棵树拿到的训练集,都是在原数据集里有放回地抽出来的,这种抽样方式叫作自助采样(bootstrap),因此每棵树看到的数据都不尽相同。
- 随机挑选特征:在节点上做划分时,树并不考察全部特征,而是先随机圈定若干个候选特征,再从候选中挑出切分效果最好的一个。
两种随机性叠加,森林里的树便各有“个性”,犯的错也各不相同,汇总之后既能提高准确率,又能明显减轻过拟合。讲到这里,得先把“过拟合”说清楚,它是机器学习里分量极重的一个概念:模型在训练数据上表现得很出色,一换成没见过的数据就明显失准,也就是泛化能力不够。问题可能出在训练数据身上,也可能是模型本身过于复杂。
泛化能力,说白了就是“举一反三”的本事。我们花力气训练模型,图的不是让它把训练集背得滚瓜烂熟,而是希望它能应付以后碰到的新数据。举个例子:想让模型判断一张图片里是否有狗,我们找来 1000 张有狗的图片供它学习。碰巧这批图片里的狗几乎都竖着笔直的尾巴,模型便把“尾巴笔直”也当成了认定狗的条件之一,结果碰上尾巴卷曲或耷拉着的狗,反倒认不出来了。模型牢牢记住了训练数据里偶然出现的细节,却没有抓住真正普遍的规律,这就是过拟合。
回过头看决策树:它为何容易过拟合?如果不加限制,树会一直往下分裂,为了照顾个别样本,它可能生成一些非常“偏门”的判断条件,最终切出只含一个样本的叶子。这类规则只对那一条数据成立,换一批数据就不管用了,模型自然也就过拟合了。
随机森林又是怎样缓解这一问题的?先看它的完整工作流程:
- 第一步,用自助采样从原数据集中反复抽取,得到多份训练子集;
- 第二步,每份子集各自训练出一棵决策树;
- 第三步,遇到新样本时,每棵树分别独立给出判断;
- 第四步,汇总所有树的结论:分类任务少数服从多数,回归任务则取平均值。
由于每棵树的训练数据和候选特征都不一样,某棵树偶然学到的“偏门”规则,很少会在其他树上重复出现,汇总时就被大多数树的意见冲淡了。这就是随机森林比单棵决策树更稳健、更不容易过拟合的原因。
下面用经典的鸢尾花(iris)数据集训练一片只有 3 棵树的“迷你森林”,先挑一朵花观察 3 棵树如何投票,再把每棵树画出来:
from matplotlib import pyplot as plt

from sklearn import datasets, ensemble, tree

plt.rcParams["font.sans-serif"] = ["SimHei"]

N_TREES = 3

# 只种 3 棵树,方便把每一棵都画出来

iris = datasets.load_iris()

species = iris.target_names

# 三个品种:setosa、versicolor、virginica

forest = ensemble.RandomForestClassifier(n_estimators=N_TREES,

                                         random_state=42)

forest.fit(iris.data, iris.target)

# 挑出第 71 朵花(索引为 70),看看每棵树分别投给了哪个品种

flower = iris.data[[70]]

for i, member in enumerate(forest.estimators_, start=1):

    print(f"第 {i} 棵树的判断:{species[int(member.predict(flower)[0])]}")

print("森林的最终结论:", species[forest.predict(flower)[0]])

# 训练好的树保存在 estimators_ 中,逐一画出来

fig, axes = plt.subplots(1, N_TREES, figsize=(20, 5), dpi=100)

for i, (ax, member) in enumerate(zip(axes, forest.estimators_), start=1):

    tree.plot_tree(member, ax=ax, filled=True,

                   feature_names=iris.feature_names,

                   class_names=list(species))

    ax.set_title(f"第 {i} 棵树")

plt.tight_layout()

plt.show()
森林里的 3 棵树并不是各自为政,而是通过“投票”协同工作。以分类为例:同一个样本分别交给每一棵树,由它们独立判断类别;随后统计每个类别得了几票;得票最多的类别就是整片森林的输出。代码里挑出的第 71 朵花(索引为 70)就是个现成的例子:程序输出 3 棵树的判断依次为 versicolor、virginica、versicolor,于是 versicolor 以 2 票对 1 票胜出,森林的最终结论也正是 versicolor。
需要补充一点:sklearn 的 RandomForestClassifier 实际采用“软投票”,即先把各棵树给出的类别概率取平均,再选概率最高的类别,而不是直接数票,不过两种方式在绝大多数情况下结论一致。示例只种 3 棵树是为了方便画图,实际项目通常会用上百棵甚至更多(n_estimators 的默认值就是 100)。树越多,预测越稳定,代价是训练和预测都会变慢。
三、支持向量机:寻找最宽的分界带
SVM(支持向量机)是分类问题中的一种经典算法,从文本分类到图像识别,都曾有它的用武之地。它要回答的问题是:两类数据点散布在空间中,能把它们分开的边界可能有无数条,究竟该选哪一条?SVM 的答案是:选离两边数据都尽可能远的那一条,也就是在两类之间留出最宽“空白地带”的边界。理解 SVM,要抓住下面四个概念:
- 超平面:决策边界长什么样,取决于特征有几个。只有两个特征时,它是平面上的一条直线;有三个特征时,它是空间里的一个平面;特征再多,已经无法直观画出,就统称为“超平面”。它的任务是把两类样本分隔在两侧。
- 最大间隔:光能分开数据还不够,SVM 追求的是分得“最宽裕”。所谓间隔,是指离边界最近的样本到边界的距离;SVM 要找的,正是能让这段距离最大的边界位置与朝向。间隔越宽,新数据即便有些偏移也不容易被分错,模型的泛化表现通常也更好。
- 支持向量:最终的边界只由少数几个紧贴分界带的样本决定,这些样本就叫作支持向量,算法也因此得名。有意思的是,删掉那些远离边界的样本,边界纹丝不动;而一旦挪动某个支持向量,边界就可能随之改变。
- 核技巧:现实中的数据经常犬牙交错,用一条直线或一个平面根本分不开。这时 SVM 可以借助核函数,相当于先给数据“升维”,在维度更高的空间里再寻找分界面:在低维空间里缠绕在一起的点,到了高维往往就能被一个平面干净地切开。而且核函数只需计算样本两两之间的相似度,并不需要真正求出高维坐标,这正是它被称作“技巧”的原因,也让 SVM 在非线性问题上同样游刃有余。
如果想要一个形象的画面,不妨把 SVM 的工作看作在两个村子之间修一条公路:路要把两边隔开,而且修得越宽越好,路的两侧边缘恰好擦着离路最近的几户人家,这几户人家就相当于支持向量。路修得越宽,将来新搬来的住户就越不容易被划错村子。
下面借助 sklearn 随机生成两团数据点,训练一个采用线性核函数的 SVM,并把决策边界、间隔和支持向量都画出来:
import numpy as np

from matplotlib import pyplot as plt

from sklearn import datasets, model_selection, svm

plt.rcParams["font.sans-serif"] = ["SimHei"]

plt.rcParams["axes.unicode_minus"] = False

# 让坐标轴上的负号正常显示

# 生成 50 个分成两团的二维数据点,固定随机种子便于复现

X, y = datasets.make_blobs(50, centers=2, random_state=6)

train_X, test_X, train_y, test_y = model_selection.train_test_split(

    X, y, test_size=0.3, random_state=42)

# 采用线性核函数的 SVM

clf = svm.SVC(kernel="linear")

clf.fit(train_X, train_y)

print("测试集准确率:", clf.score(test_X, test_y))

fig, ax = plt.subplots(figsize=(8, 6))

ax.scatter(X[:, 0], X[:, 1], c=y, cmap="autumn", s=50)

# 在当前坐标范围内铺一张 30×30 的网格,计算每个格点的决策函数值:

# 正负号表示点落在边界的哪一侧,绝对值越大表示离边界越远

(x_lo, x_hi), (y_lo, y_hi) = ax.get_xlim(), ax.get_ylim()

gx, gy = np.meshgrid(np.linspace(x_lo, x_hi, 30),

                     np.linspace(y_lo, y_hi, 30))

grid = np.c_[gx.ravel(), gy.ravel()]

scores = clf.decision_function(grid).reshape(gx.shape)

# 决策函数为 0 的等高线是决策边界,为 ±1 的两条是间隔的边缘

ax.contour(gx, gy, scores, levels=[-1, 0, 1], colors="k",

           linestyles=["--", "-", "--"], alpha=0.5)

# 用空心圆圈出支持向量

sv = clf.support_vectors_

ax.scatter(sv[:, 0], sv[:, 1], s=100,

           edgecolors="k", facecolors="none", linewidths=1)

ax.set(title="支持向量机分类示例", xlabel="特征1", ylabel="特征2")

plt.show()
运行后,终端会先打印模型在测试集上的准确率(本例为 1.0,即测试样本全部分对),随后弹出下面这张图:
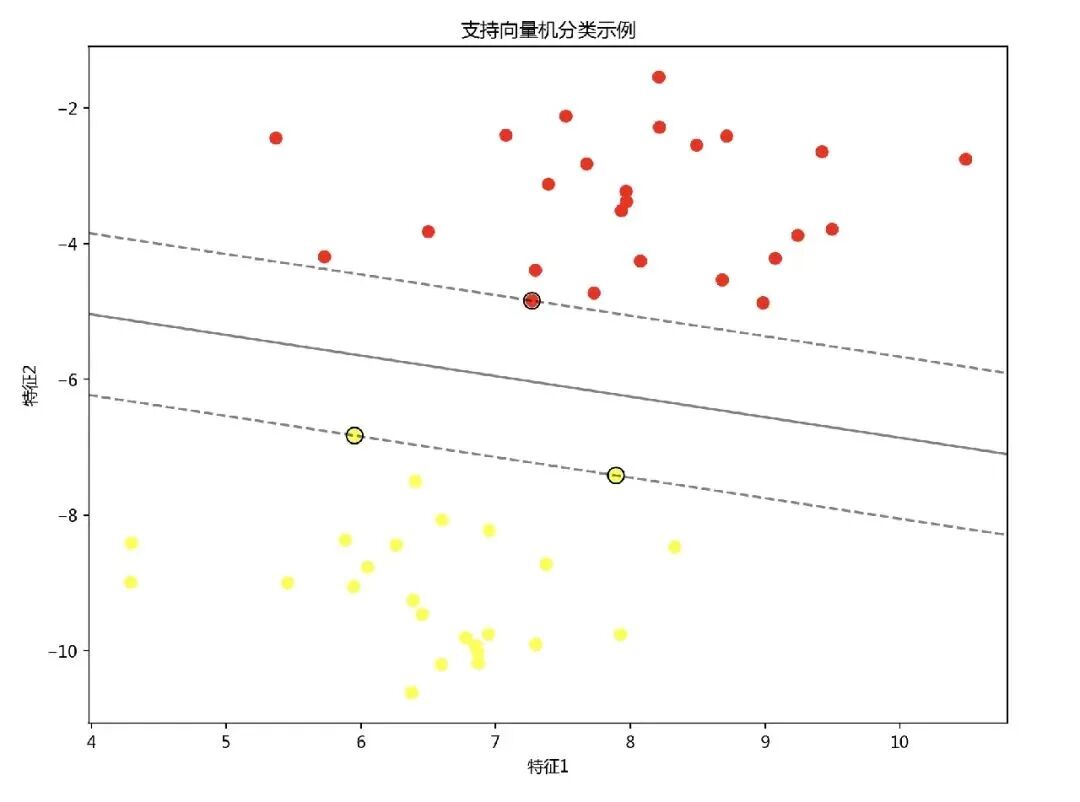
读这张图时关注三点:红点和黄点分别属于两个类别;位于中间的实线是 SVM 求出的决策边界,也就是二维情形下的“超平面”,两侧与它平行的虚线标出了间隔的边缘,两条虚线之间的带状区域就是模型留出的间隔;被黑色空心圆圈住的 3 个点就是支持向量——这 3 个点都恰好落在虚线上,整条边界正是由它们“撑”起来的。
本例中的两团数据离得比较远,一条直线就能分开。倘若两类点在平面上相互交织,比如一类围成一个圆环、另一类聚集在圆心附近,任何直线都无能为力。这时可以给每个点补上第三个坐标,例如把它到圆心的距离当作“高度”:圆心附近的点高度小,外圈的点高度大,放到三维中看,用一个水平的平面就能把两类切开。实际使用时并不需要手动构造新坐标,只要把 kernel 参数换成 rbf、poly 等非线性核函数,SVM 就能应对分布更复杂的样本。
四、神经网络:一层层加工信息
要说当下最受关注的机器学习模型,神经网络几乎没有悬念,如今主流的大模型,底层基本都是深度神经网络。它的设计灵感来自人脑:大脑中数量庞大的神经细胞通过突触彼此相连、传递信号,神经网络则用大量简单的计算单元(也叫“神经元”)模仿这种结构,每个单元接收上游传来的数值,处理后再传给下游。单个神经元做的计算非常简单,可一旦成千上万个连接在一起,就足以胜任自然语言处理、图像识别、语音识别等复杂任务。
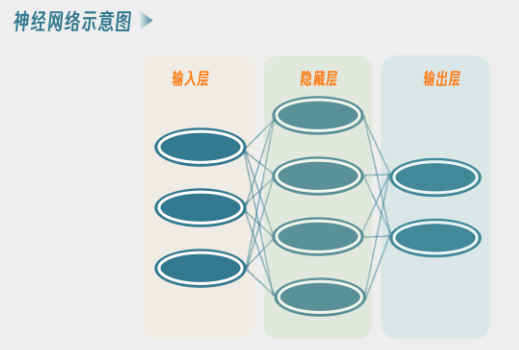
最基础的神经网络由三部分依次连接而成。输入层、输出层通常各占一层,中间的隐藏层则可以叠加许多层,“深度学习”里的“深”,指的就是隐藏层多(也有一些结构特殊的网络不遵循这个模式,后续课程再介绍)。三部分分工明确:
- 输入层负责“接收原料”:把原始数据送进网络,比如一张图片全部像素的数值,或者一句话转换得到的数字编码。
- 隐藏层负责“加工”:每个神经元先把收到的各路输入按权重求和(再加上一个偏置),然后把结果交给激活函数做一次非线性变换。经过一层又一层这样的处理,数据中隐藏的规律和关联被逐步提炼出来。
- 输出层负责“交付成品”:拿到隐藏层的加工结果后,给出一个或一组数值作为最终预测,例如一张图片属于各个类别的概率。
下面这段代码用 matplotlib 画出一个“3 个输入神经元、4 个隐藏神经元、2 个输出神经元”的简单网络,相邻两层的神经元两两相连:
from matplotlib import pyplot as plt

plt.rcParams["font.sans-serif"] = ["SimHei"]

plt.rcParams["axes.unicode_minus"] = False

def draw_network(layer_sizes, layer_names, dx=2.0, dy=1.5, r=0.5):

    """绘制全连接神经网络的结构示意图"""

    fig = plt.figure(figsize=(8, 7))

    ax = fig.add_subplot()

# 算出每层各个神经元的圆心坐标,让每一层在竖直方向上居中

    layers = []

    for i, n in enumerate(layer_sizes):

        top = (n - 1) * dy / 2

        layers.append([(i * dx, top - j * dy) for j in range(n)])

# 相邻两层的神经元两两连线(先画线,圆形会盖住线头)

    for left, right in zip(layers, layers[1:]):

        for x1, y1 in left:

            for x2, y2 in right:

                ax.plot([x1, x2], [y1, y2], color="gray", linewidth=1)

# 画出神经元

    for nodes in layers:

        for x, y in nodes:

            ax.add_patch(plt.Circle((x, y), r, facecolor="skyblue",

                                    edgecolor="black", linewidth=1.5,

                                    zorder=3))

# 在每层上方标注层名

    label_y = (max(layer_sizes) - 1) * dy / 2 + r + 0.6

    for col, name in enumerate(layer_names):

        ax.text(col * dx, label_y, name, ha="center", size=14)

    ax.set_xlim(-1, (len(layer_sizes) - 1) * dx + 1)

    ax.set_ylim(-label_y, label_y + 0.8)

    ax.set_aspect("equal")

    ax.axis("off")

    ax.set_title("一个简单的三层神经网络", size=16)

    return fig

draw_network([3, 4, 2], ["输入层", "隐藏层", "输出层"])

plt.show()
这类网络的结构可以用下面的示意图来表示:
为什么神经网络这么厉害?主要有两个原因。其一是非线性:借助激活函数,它能刻画远比“直线关系”复杂的输入与输出之间的联系。其二是分层学习:在深层网络中,靠前的层通常只捕捉边缘、纹理之类的简单特征,越往后的层越能把这些特征组合成更抽象的概念,比如“眼睛”或“车轮”。这种由浅入深的特征提取方式,让神经网络特别擅长处理图像、语音、文本这类结构复杂的数据。
学习神经网络,免不了要和几个术语打交道:激活函数,以及由前向传播、损失函数、反向传播和梯度下降构成的训练流程。单独看它们有些抽象,我们借“做菜”把它们串起来——不妨把训练神经网络想象成在厨房里反复试做一道新菜:
- 输入数据好比食材。菜做得怎么样,先要看原料;网络里的一切计算,同样以输入数据为起点。
- 激活函数好比调料。盐、糖、醋并不只是让味道简单地“多一点”,而是让菜的风味发生质的变化;激活函数也一样,它给神经元的输出加上非线性变换,网络因此才能表达复杂的关系。
- 前向传播好比按菜谱下锅。食材依次经过切配、翻炒、调味等工序变成一盘菜;数据也从输入层出发,逐层完成加权计算和激活,最后在输出层得到预测结果。
- 损失函数好比试吃打分。菜出锅先尝一口,和理想中的味道比一比,差得越远分数越低;损失函数量化的正是预测值与真实答案相差多少,损失越小,说明预测越准。
- 反向传播好比追查问题出在哪。菜太咸,是酱油放多了还是盐放多了?得从结果倒推每一步的“责任”;反向传播借助求导的链式法则,把误差从输出层一层层往回传,算出每个参数对误差应负多大责任,也就是梯度。
- 梯度下降好比一点点改配方。弄清原因以后,就把盐、酱油的分量和火候朝正确的方向微调;梯度下降朝着梯度相反的方向更新参数,每次只迈一小步(步长由学习率控制),让损失逐步降低。
- 训练过程好比反复试做。一道好菜很难一次成功,往往要经历“做—尝—找原因—调整”的多轮循环;训练神经网络同样是把前向传播、计算损失、反向传播、更新参数这套流程重复成千上万次,直到预测效果令人满意。
借做菜把这几个术语串起来之后,神经网络训练的主线应该清晰多了,其中的数学推导和实现细节,留到之后的课里再深入展开。
本讲回顾
这一讲的定位是“认识”而不是“精通”:我们从直观层面理解了决策树、随机森林、支持向量机和神经网络的基本思路,也借助几段简短的代码看到了它们实际运行的样子。再算上上一讲的线性回归、逻辑回归,常见的经典算法你已经见过了大半。对初学者来说,先把这些概念吃透,比急于钻研公式更重要;个别地方一时想不明白也别着急,对照着图多读几遍,慢慢就能理解。
课后建议你打开 sklearn 的官方文档,浏览一下分类、回归、集成学习等模块,再亲手把本讲的示例代码敲一遍。敲完别急着关掉,试着改改参数,比如 max_depth、n_estimators 以及 SVM 的 kernel,观察结果会发生怎样的变化。
课后思考
前面说过,神经网络的强大离不开激活函数带来的非线性。请你想一想:激活函数究竟是怎样让网络具备非线性表达能力的?如果把网络中的激活函数全部去掉,那么无论叠加多少层,它又会面临什么问题?
你可以先把自己的思路记下来,下节课我们一起讨论。
(我:我记得有次面试时,面试的招聘文档上,写了这家公司的一些自己的思想,其中有一条是像数学家王虹那样怎样怎样,回想之前学习也都还好,这几年虽然偏差非常大,但是知识的获取变得逐渐便捷,比如mooc课程,或通过AI学,前几天也看了很多关于AI讨论的博客和群里信息,有个内容比较打动我,就是坚持是金)