
如何撰写高效的软件设计文档
一份优秀的设计文档能为你节省数年的开发时间。编写设计文档会迫使你提前思考关键决策,避免在错误的实现上浪费时间。这也是协调团队成员及合作方在设计方案上达成一致的最佳途径。
我曾在 Google、Microsoft 以及 我自己的公司 以开发者身份撰写过设计文档。虽然具体细节有所不同,但底层原则始终如一。设计文档阐述了你正在解决的难题,并帮助你的团队成员提供反馈。
下文我将分享我创建高效设计文档的方法,并解释设计文档中应该包含什么,不应该包含什么。
设计文档示例🔗
关于设计文档,大家最常问我的问题是:哪里能找到一份写得好的范例。说实话,我从未见过公开的、我认为高质量的设计文档——我自己写的那些都藏在付钱雇我写它们的公司里。
于是,我按照本文分享的原则从头写了一份设计文档,为的是我正在开发的一个真实的 Web 应用。
这份设计文档是在动手写代码之前完成的,目前我在实现应用的过程中也一直在遵循它的设计。
对个人业余项目来说,这份文档比我平时写的要详尽得多,但如果是一个需要与其他人协作的专业项目,我写出来的设计文档差不多就是这个篇幅和深度。
什么时候该写设计文档?🔗
项目越复杂、风险越高,写设计文档的价值就越大。
不妨问自己这些问题:
- 是否有多人协作来实现这个设计?
- 项目是否需要超过三个月的全职开发?
- 实现是否要在生产环境运行多年?
- 是否涉及跨团队协作?
- 项目的目标和需求是否模糊?
- 是否存在可以在设计阶段规避的灾难性风险(如安全漏洞、法律风险)?
只要上面任何一项的回答是"是",就值得花功夫写一份设计文档。如果有两项以上是"是",那设计文档几乎肯定值得写。
设计文档该投入多少精力?🔗
设计文档可以是一页纸的简单说明,也可以是一份需要五个团队审批签字的 50 页文档。具体写到什么程度,需要你自己权衡。
设计文档该写多长,没有定论,就像代码测试写多少也没有统一标准。该投入多少,取决于团队的目标、风险、截止日期以及文化背景。有时候,不写设计文档反而是最优解。
设计文档该包含什么?🔗
如果试图在设计文档里详尽描述每一个可能的细节,那本质上等于在设计阶段就把实现代码写完了,这就违背了设计文档的初衷。
判断一个决策是否该写进设计文档,有个简单的判断标准:判错的代价有多大?
判错的代价是什么?🔗
并非所有设计决策都同等重要,有些选择比其他选择更难以逆转。
比如,如果你用 C++ 开发一个 Web 应用,结果在写完 20 万行代码后才意识到 Ruby on Rails 才是更好的选择,那就麻烦了。从头重写是行不通的,即便你能用 Rails 写新代码,你依然要同时维护两种差异巨大的语言代码。
其他一些设计决策则微不足道。比如,如果应用要展示 100 篇文章,是一次性全显示,还是每次显示 25 篇并让用户点击“加载更多”?
这根本无所谓。
“加载更多”按钮不属于设计层面的问题。如果选了一个方案,用户反馈显示选错了,花几个小时就能修好。设计文档里没必要把整个思考过程都写出来,更不该在评审环节为此浪费宝贵的讨论时间。
设计文档的组成部分🔗
下面列出设计文档中常见的章节。通常不需要每篇文档都包含所有章节,挑出适合你项目的部分即可。
标题🔗
项目首先需要一个好标题。这是大家在沟通中称呼你项目的方式,所以要短、要有辨识度、还要有感染力。
例如,如果你想在应用服务器和数据库服务器之间添加一层缓存,命名为 **RecencyBank** 就很合适。这个名字朗朗上口,且准确反映了项目的目的。而“飞行银马计划”则是一个糟糕的命名,因为它既冗长又毫无意义。
元数据🔗
元数据虽然枯燥,但对帮助读者理解文档的基本背景很有用:
- 作者是谁?(姓名 + 邮箱地址)
- 文档创建时间?
- 权威 URL 是什么?
- 特别是当你的组织像
http://go/recency-bank这样使用短链接重定向时。
- 特别是当你的组织像
- 谁批准了这份文档?批准时间是?
- 适用于需要队友或合作伙伴签核文档的情况。
元数据
- URL:http://go/recency-bank-design
- 作者:Michael Lynch (michael@refactoringenglish.com)
- 创建日期:2026-06-22
- 状态:已批准
- alan@ 签核于 2026-07-14
- betty@ 签核于 2026-07-15
目标🔗
目标是对项目目的的一句话简述。它应出现在文档的第一页,并使用任何利益相关者都能理解的大白话。
目标
通过在 Trogdor Web 服务器和 Postgres 数据库之间添加缓存层,提升应用性能。
背景🔗
背景部分解释项目的上下文和动机。它应回答以下问题:
- 为什么团队要启动这个项目?
- 这个项目解决了什么问题?
- 之前是否曾尝试过解决该问题?
背景
2023 年 Trogdor Web 应用上线时,页面加载时间通常在 100ms 以内。三年后,页面加载的中位数时间已膨胀至 600ms,导致用户觉得应用运行迟缓。
我们对性能下降进行了调查,发现数据库查询占据了页面加载时间的 80%。随着数据量增长,数据库查询的速度越来越慢。
我们还发现,95% 的数据库查询都集中在相同的 3% 的数据行上。这种访问模式非常适合用内存缓存来优化:缓存可以更快地响应高频数据,同时降低其他查询给数据库带来的压力。
不看背景说明,你的设计文档还能看懂吗?
想象一下,在同事或合作团队阅读文档之前,你会向他们口头交代什么。
注意,有些读者会在没有任何口头说明的情况下直接读文档,所以他们需要了解的背景都应该写在文档第一页。
相关文档🔗
如果这个项目与其他文档有关联,要让读者能方便地找到它们。
可以附上以下链接:
- 项目经理或测试同事为本项目产出的文档(如测试计划、功能规格说明)
- 相关系统的设计文档
- 本项目早期版本的设计文档
相关文档
- 测试计划:http://go/recency-bank-test-plan
- Trogdor 性能报告:http://go/trogdor-perf-2026
目标🔗
目标部分描述这个项目的高层目标。它应该在逻辑上与背景部分衔接,并说明项目完成落地后世界会是什么样子。
不要把目标写成实现细节。目标应该体现项目能给用户、团队或公司带来什么价值。
反面示例:用内部实现细节来定目标- 在基础设施中引入 Kubernetes。
- 减少因部署新版应用导致的服务中断。
目标
- 提升 Trogdor Web 应用的用户感知响应速度。
- 降低数据库服务器负载。
非目标🔗
目标部分界定了项目范围内的内容,非目标部分则说明哪些不在范围内。
是否有读者可能误以为属于本项目范围的目标?如果有,就把它们明确写进非目标部分。
非目标
- 构建通用可复用的缓存系统
- 我们为 Trogdor Web 应用添加的缓存层将进行应用层面的优化,将此缓存复用于其他系统不在讨论范围内。
- 位置感知缓存
- 未来支持地理位置靠近终端用户的缓存以降低延迟可能很有用,但这不属于 v1 的范围。
场景🔗
如果你的目标是“为图表添加‘共享为 URL’按钮”,读者可能无法理解实际效果是怎样的。
场景部分帮助你向读者描绘系统上线后在真实环境中的运作方式。
场景:通过 URL 共享报告
- Bob 在他的 KeyMetrics 仪表板中创建自定义报告。
- Bob 导航到菜单栏并点击“共享 > 作为 URL”。
- Bob 将该 URL 通过电子邮件发送给同事 Charlie。
- Charlie 点击链接,即可看到 Bob 报告的只读副本。
架构图🔗
架构图非常有价值,尽管初看可能并未如此。
作为设计者,你直觉上理解方案各部分的组合方式,脑海中已有架构蓝图。评审者不具备这种心理图景,向他们展示的最快方式就是画图。
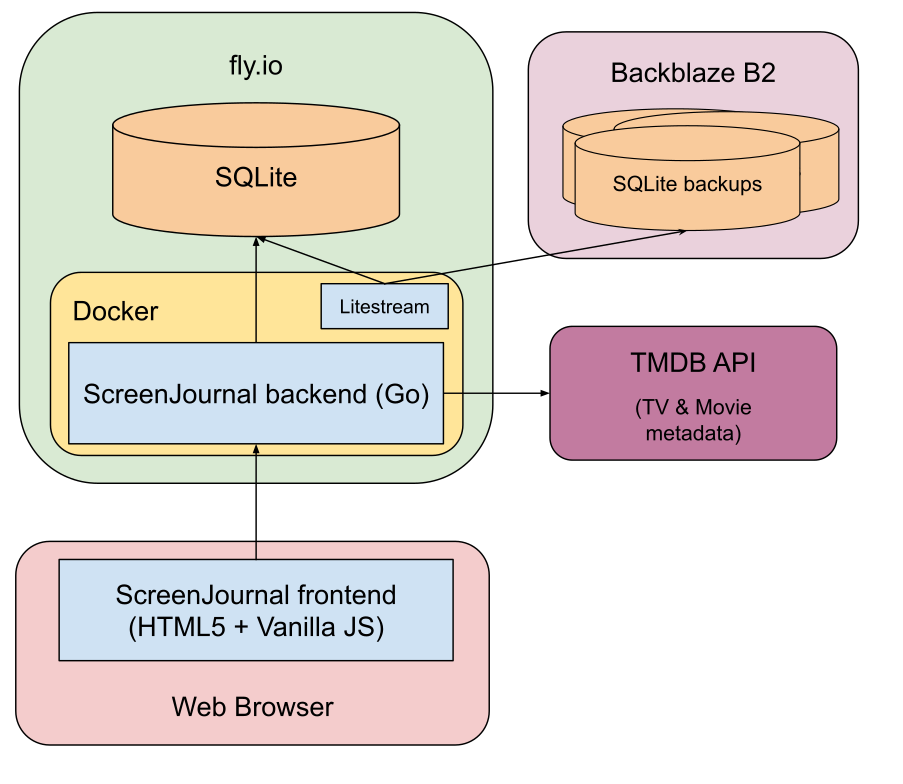
示例:展示简单 Web 应用架构的图。
如果不确定架构图应包含哪些内容,可以参考以下问题:
- 数据如何在系统中流动?
- 系统各组件如何相互协作?
- 系统如何与其依赖项及下游客户端交互?
- 系统定义了哪些通信协议?
选择易于编辑的绘图工具。曾见过开发者在白板上绘制精美图表并拍照用于设计文档。初稿看似完美,但照片无法编辑,后续任何修改都需从头重绘,导致被该图长期束缚。
Excalidraw、draw.io 和 Google Drawings 是常用的图表绘制工具,方便修改迭代。还有 Mermaid、D2 和 Graphviz 等语言支持通过代码生成图表。我曾用 LLM 生成图表代码,体验不错。记得附上源文件或代码链接,方便同事复现图表。
术语表🔗
术语表用于定义读者可能不熟悉的词汇。
认真考虑文档的潜在读者,特别是新入职员工和团队外的相关人员。这些读者能看懂你文中提到的内部工具或系统名称吗?
尽量使用读者熟悉的术语,避免他们查阅术语表。在术语表中定义术语虽然比完全不定义要好,但最佳做法是使用通用术语,或在行内直接定义,以免读者在文档中来回跳转。
术语表
- Apposaurus:团队内部的压力测试工具。我们用 Apposaurus 模拟大量用户访问 Trogdor Web 应用,以验证其在预期负载下的功能稳定性。
- Baba-o-styley:内部代码检查器,用于强制执行公司的代码风格规范。
约束条件🔗
如果预算、客户、基础设施或依赖项对设计有重大限制,请明确说明这些约束,帮助读者理解设计选择的背景。
约束条件
我们的服务器均为 RISC-V 架构,因此所有代码和依赖项必须兼容 RISC-V 架构。
服务级别目标(SLO)🔗
SLO 为系统性能提供可衡量的客观指标。你很可能听说过服务级别协议(SLA)。SLA 本质上就是 SLO 加上未达标时的经济处罚条款。
在公司内部,你一般不会因为同事犯错就扣他们的钱(虽然那样可能挺有意思?)。所以设计文档里定义的是 SLO,而不是 SLA。
你的经理可能会说应用必须“在移动端表现流畅”,但这太模糊了。经理心中的“流畅”可能是延迟 <2ms,你肯定不想等到代码写完才发现双方理解不一致。用具体、客观的指标来描述目标,SLO 就能消除这种歧义。
制定 SLO 时通常要考虑以下几个方面:
- 正常运行时间 / 可用性:系统可用时间占比是多少?
- 延迟:服务完成请求需要多快?
- 规模:系统能承受多大的负载?
服务级目标(Service level objectives)
- Trogdor 面向用户的 HTTP 请求 P50 延迟:<=200ms
- Postgres P50 查询延迟:<= 80ms
监控 / 告警🔗
确定好 SLO(见上文)后,就该考虑如何在生产环境中衡量这些指标了。
验证是否达到 SLO 最简单的方式是手动测试。但随着组织逐步成熟,应该实现监控自动化,以便第一时间发现 SLO 不达标的情况。
在制定监控策略时,问自己这几个问题:
- 服务挂了,你怎么知道?
- 服务性能下降 100 倍,你怎么发现?
- 还有哪些事件应该触发告警?
- 比如:CPU 使用率飙升、认证失败、系统错误
监控
以下事件会触发向值班工程师发起呼叫:
- Trogdor 面向用户的 HTTP 请求 P95 延迟:>= 3s
- Postgres 服务器过去 2 分钟平均 CPU 使用率:>= 90%
时间线🔗
时间线部分把项目拆分成若干里程碑,明确你在什么时候向项目相关方交付成果。
选择能为利益相关者产生实际成果的里程碑。例如,可以先做一个展示假数据的 UI,并尽早向客户展示。如果发现误解了需求,假数据能让你尽早发现,而不是在已经实现完所有填充生产数据的底层逻辑后才发现。
如果你不知道如何估算项目时间线,我强烈推荐 Joel Spolsky 的 《无痛软件排期》。这篇文章虽然已发表 25 年,但依然是我最喜欢的软件估算策略。
时间线
- 里程碑 1(2026-07-01):RecencyBank 在测试环境中上线,使用硬编码的缓存数据子集(不读取 Postgres)。
- 里程碑 2(2026-07-17):RecencyBank 在测试环境中上线,缓存来自 Postgres 的真实数据。
- 里程碑 3(2026-08-03):RecencyBank 在测试环境中上线,并强制执行缓存淘汰和生命周期规则。
- 里程碑 4(2026-08-22):RecencyBank 完全实现并部署到生产环境。
接口🔗
你的项目服务于人或其他软件系统,那么这些交互具体是什么样的?
- 对于图形系统,用户界面是什么?
- 只需简单的草图;不要纠结于精确的 UI 选择。
- 对于软件接口,API 或 CLI 的语义是什么?
- 对于基于文件的接口,文件格式是什么?
接口
Trogdor 的
Server结构体目前直接依赖一个PostgresDBGostruct,如下所示:type Server struct { db PostgresDB }
PostgresDB拥有以下导出方法:GetUser(id UserID) (User, error) ListUsers() ([]User, error) ...我们将创建一个 Go
interface类型,其 API 表面与PostgresDB相同:type Store interface { GetUser(id UserID) (User, error) ListUsers() ([]User, error) }我们将实现一个 RecencyBank 缓存类型,它实现与现有
interface相同的接口,并封装后端的PostgresDB结构体。RecencyBank 会缓存来自 Postgres 的读取请求,当请求涉及状态变更或依赖缓存中不存在的数据时,将其转发给 Postgres。
Server实现的唯一变化是将某个成员的类型替换为新的interface:type Server struct { db store.Store }
依赖与基础设施🔗
依赖部分应回答以下问题:
- 使用什么编程语言?
- 代码运行在何种硬件或服务上?
- 持久化数据存储在哪里?
人们容易忽视这一部分,但关于语言、库和基础设施的决策会显著影响系统的复杂度及长期维护成本。
深入思考哪些依赖在实现后难以更改。不要过于担心那些容易替换的依赖。更改语言或存储后端很困难,但如果你对用于发送邮件的第三方服务不满意,花一个下午就能替换掉。
依赖
- 语言:Go
- 我们已广泛使用 Go,且它适合处理高并发的工作流。
- 第三方包
- bbolt:这是一个广泛使用的键值存储实现,提供了 RecencyBank 所需的多项功能。
安全性🔗
为了构建安全的软件,开发人员必须将安全融入整个软件生命周期,从设计阶段开始。
安全部分应回答以下问题:
- 你考虑了哪些威胁?
- 例如,攻击者尝试所有可能的密码时会发生什么?如果用户上传了感染恶意软件的 PDF 文件呢?
- 该系统的攻击面有多大?
- 即,它在哪些地方处理潜在的恶意数据?
- 信任边界在哪里?
- 数据何时会从权限较低的系统流向权限较高的系统?
- 例如,在 Web 应用中,来自用户浏览器的请求就跨越了信任边界,因为 Web 服务器不应假定浏览器传来的输入是安全的。
即使你认为安全威胁在系统中不太可能发生或无关紧要,把你的分析理由写下来仍然有价值。你的说明可能会提醒评审者发现你遗漏的威胁。
安全性
RecencyBank 不得接受来自公网的直接请求,因为它没有实现任何访问控制。
RecencyBank 将部署在隔离网络中,只接受来自 Trogdor Web 服务器的入站请求,且只能向 Postgres 服务器池发起出站请求。
隐私🔗
隐私部分让你有机会梳理系统处理的敏感数据,以及你会采取哪些保护措施。它应回答以下问题:
- 系统处理哪些敏感数据?
- 数据会保留多久?
- 谁有权访问这些数据?
- 如何保护数据?
- 例如,静态存储和传输过程中是否都会加密?
隐私
RecencyBank 包含与 Postgres 数据库相同的敏感用户数据,因此沿用 Postgres 系统的隐私政策。具体来说,工程师在生产环境中访问 RecencyBank 系统时必须提供对应的 bug 编号,且访问的用户数据必须严格限于排查该 bug 所需的最小范围。
法律合规🔗
如果你的系统运行在金融、医疗等强监管领域,法律部分能帮助你遵守相关法规。
即使在非监管领域,也要考虑系统一旦出问题是否可能触犯法律。说明你将如何避免可能给公司或客户带来风险的法律违规行为。
如果你打算以开源许可证发布代码,需要说明选择了哪种许可证以及原因。
FizzleCorp 合同合规
我们与 FizzleCorp 的合同严格限制了对其专有的 FizzlePerfect™ 用户生物特征数据进行复制的可能性。
幸运的是,法务团队审查了合同措辞,确认缓存层符合现有“存储层”的定义,因此我们无需重新谈判合同,即可在 RecencyBank 内部缓存 FizzlePerfect™ 数据。
日志🔗
在排查 bug、性能问题或安全事件时,日志往往价值巨大。从设计之初就考虑高效的日志记录,能让系统长期维护变得更加轻松。
在考虑日志设计时,请思考以下问题:
- 该服务会记录哪些关键事件?
- 是否有不同的日志级别?
- 例如:信息、警告、错误、严重
- 系统将日志存储在哪里?
- 日志保留多久?
- 谁有权访问这些日志?
- 有哪些敏感数据必须排除在日志之外?
日志
RecencyBank 记录以下事件:
- 初始化时,记录用于初始化 RecencyBank 的参数,以及宿主机上的 RAM 容量和使用情况。
- 将值持久化到内存时失败。
- 使缓存失效的操作失败。
未决问题🔗
在撰写设计文档的过程中,你很可能会遇到以下几种情况之一:
- 设计中存在缺陷,但你不确定如何修复。
- 设计存在缺口,需要收集更多信息才能填补。
- 你在多个解决方案之间难以抉择。
在设计文档中创建一个附录,命名为“未决问题”,用来记录这些尚未解决的问题。
“未决问题”部分中的每个条目都应说明:
- 需要进一步工作的具体问题是什么?
- 解决该问题有哪些可选方案?
- 解决该问题的下一步行动是什么?
关于如何在评审阶段管理这些未决问题,请参阅我的配套文章如何高效处理未决问题。
未决问题:选择缓存的 RAM 大小
我们需要决定为缓存层分配多少 RAM。增加 RAM 可以提升性能,但 RAM 成本高昂,且额外内存带来的收益是递减的。
缓存系统和数据库之间存在一定的最佳内存分配方案,能让我们将基础设施成本降到最低。理论上,我们可以搭建测试环境、运行多次模拟来找到这个最优值,但这会消耗开发时间。
我估算搭建测试环境并运行单次模拟需要 3.0 个开发日。基础设施就绪后,每次额外的模拟大约需要 0.75 个开发日。
建议方案:不进行测试,直接选择 128 GB 内存。这个数值很可能接近最优,而且开发时间比内存更昂贵。
下一步:请技术负责人评估。
已解决问题🔗
当解决一个开放问题时,请总结决策结果,并将其从设计文档的“开放问题”移至“已解决问题”部分。请保留完整的讨论过程以便日后查阅。
已解决问题:选择缓存的内存大小
决策:为缓存层配置 128 GB 内存。如果我们未能达成性能目标且受限于内存,届时可以增加内存。通过测试寻找完美内存尺寸的开发成本,远超增加内存本身带来的额外成本。
我们需要决定…… [此处填写原开放问题的其余内容]
已考虑的备选方案🔗
如果你预见到读者会问“为什么没采用方案 X?”,在“已考虑的备选方案”部分主动回答会很有帮助。这一部分也是解释你否决的选项的地方,特别是那些起初看似诱人或你曾深入研究的选项。
我知道有些开发者会花数小时仔细记录他们否决的每一个设计想法,但我认为这有点过度了。无论是作为读者还是作者,我只需要在备选方案部分看到几行简要说明,介绍强有力的备选方案以及它们为何不可行。
已考虑的备选方案
- Google Cloud Firestore(持久存储)
- 其持久性和可靠性很有吸引力,但我不喜欢平台锁定,且本地测试难度大。
推动设计文档完成评审🔗
设计文档写完之后,下一步就是分享给团队并收集反馈。
下面这一节介绍一些技巧,帮你获得真正有用的设计反馈,推动项目前进,而不是陷入争吵和混乱、原地踏步: