
无 NCCL 异步 GRPO:利用 HF Jobs 实现 LoRA 训练与推理分离
核心摘要
AsyncGRPOTrainer现在支持仅训练 LoRA 适配器,并将其单独同步给 vLLM(TRL v1.14)。- 由于 rank-1 适配器仅有几 MB 大小,它可以通过挂载在每个 Job 中的 Storage Bucket 传输,而无需依赖 NCCL。训练器和 vLLM 副本作为独立的 Hugging Face Jobs 运行在不同的机器上。
- 在副本前部署的一个小型 proxy 负责添加认证头,将每次 rollout 路由到已持有其 KV 前缀的副本,并向所有副本广播适配器加载指令。
- AsyncGRPO 指标揭示了瓶颈所在。通过五次运行,我们将相同配方完成 500 步训练的时间从 3 小时 27 分钟缩短至 53 分钟。
TRL 的 AsyncGRPOTrainer 最近通过 PR #7017 引入了 LoRA 支持,并随 TRL v1.14 版本发布。该异步训练器现在可以训练适配器而非完整模型,且仅将 LoRA 适配器同步给 vLLM。本文介绍了一个基于此构建的实战项目,其中训练与推理不再共享同一台机器。
正如 Thinking Machines 的博客 LoRA Without Regret 所示,LoRA 训练非常适合强化学习(RL)。他们指出,即便在 rank 1 的情况下,LoRA 也能达到全量微调在策略梯度强化学习中的效果。这是因为 advantage 函数每个 episode 仅提供约 $~O(1)$ 比特的信息,从总信息量的角度看,每一步无需学习太多内容。rank-1 适配器具有足够的容量来吸收这些信息。
LoRA 训练还带来系统层面的优势。对于 1.5B 模型,rank-1 适配器仅几 MB,而完整模型约 3 GB。无需在每次更新后向推理工作节点发送完整策略,只需发送适配器即可。vLLM 还可以同时加载多个适配器。旧的 rollout 使用其开始时的策略完成,而新的 rollout 则使用最新策略。
TRL 的 AsyncGRPOTrainer 已经将训练和生成过程分离。训练器和 vLLM 可以运行在不同机器上并以各自的速度工作。在单节点或集群环境中,由于两个进程共享文件系统或可以形成 NCCL 组,这种分离很容易实现。
我们的目标是让 Hugging Face Jobs 也能跑起同样的配置。本质上,一个 HF Job 就是一个跑在单台虚拟机上的容器。这意味着单个 Job 无法(至少目前还不能)拉起多节点架构来同时承载 Trainer 和一堆 vLLM 推理服务器(每个节点最多只能用 8 块 H200)。AsyncGRPOTrainer 本就是为这种大规模场景设计的,因此问题变成了:如果不再要求 Trainer 和推理服务器同机部署,能走到哪一步?
如果用全量参数同步,答案是“走不远”。每次更新都要在机器间传输吉字节级别的数据——这正是 NCCL 在密集集群里的活儿,但 Jobs 没法在节点间通信。既没有共享本地磁盘,更别指望共享 localhost。换成 LoRA 就完全不一样了:同步量只有几兆。至于文件系统层面,HF Jobs 提供了基于 Storage Buckets 的存储卷!这些桶可以在每个 Job 里以 FUSE 文件系统形式挂载,足够充当节点间的共享文件系统。Job 之间甚至不需要任何网络通路。
最终搭出来的架构相当简洁:
- 一个 Trainer Job,跑
AsyncGRPOTrainer+ LoRA(外加 FSDP,后面再讲), - 两个 vLLM Job,各自服务基础模型加 Trainer 最近发布的 adapter,
- 一个 Storage Bucket,在三个 Job 里挂载到同一路径,adapter 就是靠它从 Trainer 流转到推理端,
- 一个代理服务器。为什么需要代理下面会细说,但核心思路是:让代理把每次 rollout 路由到最可能已经持有对应 KV cache 的那个副本,同时把每次 adapter 更新广播给所有 vLLM 副本。
架构:借助 Hugging Face Jobs 与 Storage Buckets 🪣
AsyncGRPOTrainer 里新加的"仅同步 adapter"路径是这样工作的。Trainer 并不把张量直接发给 vLLM。每隔若干步优化器更新,它把 adapter 存到 <output_dir>/.vllm_lora/trl-policy-v{N},用一次原子重命名把目录"发布"出来,然后把路径推给 vLLM 的 /v1/load_lora_adapter 端点。vLLM 从磁盘读入这些文件,rollout worker 随后就能请求 model="trl-policy-v{N}"。
这正是 vLLM 已经支持的运行时适配器加载方式。API 端点接收的是一个路径而非张量,因此要求 trainer 和服务器共享同一个文件系统。在 Slurm 集群上,这个共享空间是网络文件系统;而在 Jobs 上,我们把之前提到的 Storage Bucket 挂载为卷,在每个 Job 中都放到同一路径,效果等同。底层使用的是 hf-mount,它会把 bucket 以 POSIX 文件系统的形式暴露在容器内:
# every Job gets the same bucket at the same absolute path
hf jobs run ... -v hf://buckets/aminediroHF/asyncgrpo-lora-buckets:/lora ...
为此我们完全没有改动 TRL 或 vLLM 的代码。trainer 把适配器写到 /lora/<run>/.vllm_lora/,服务器从同一路径读取,POST 请求里传的路径在每个容器内都直接有效。
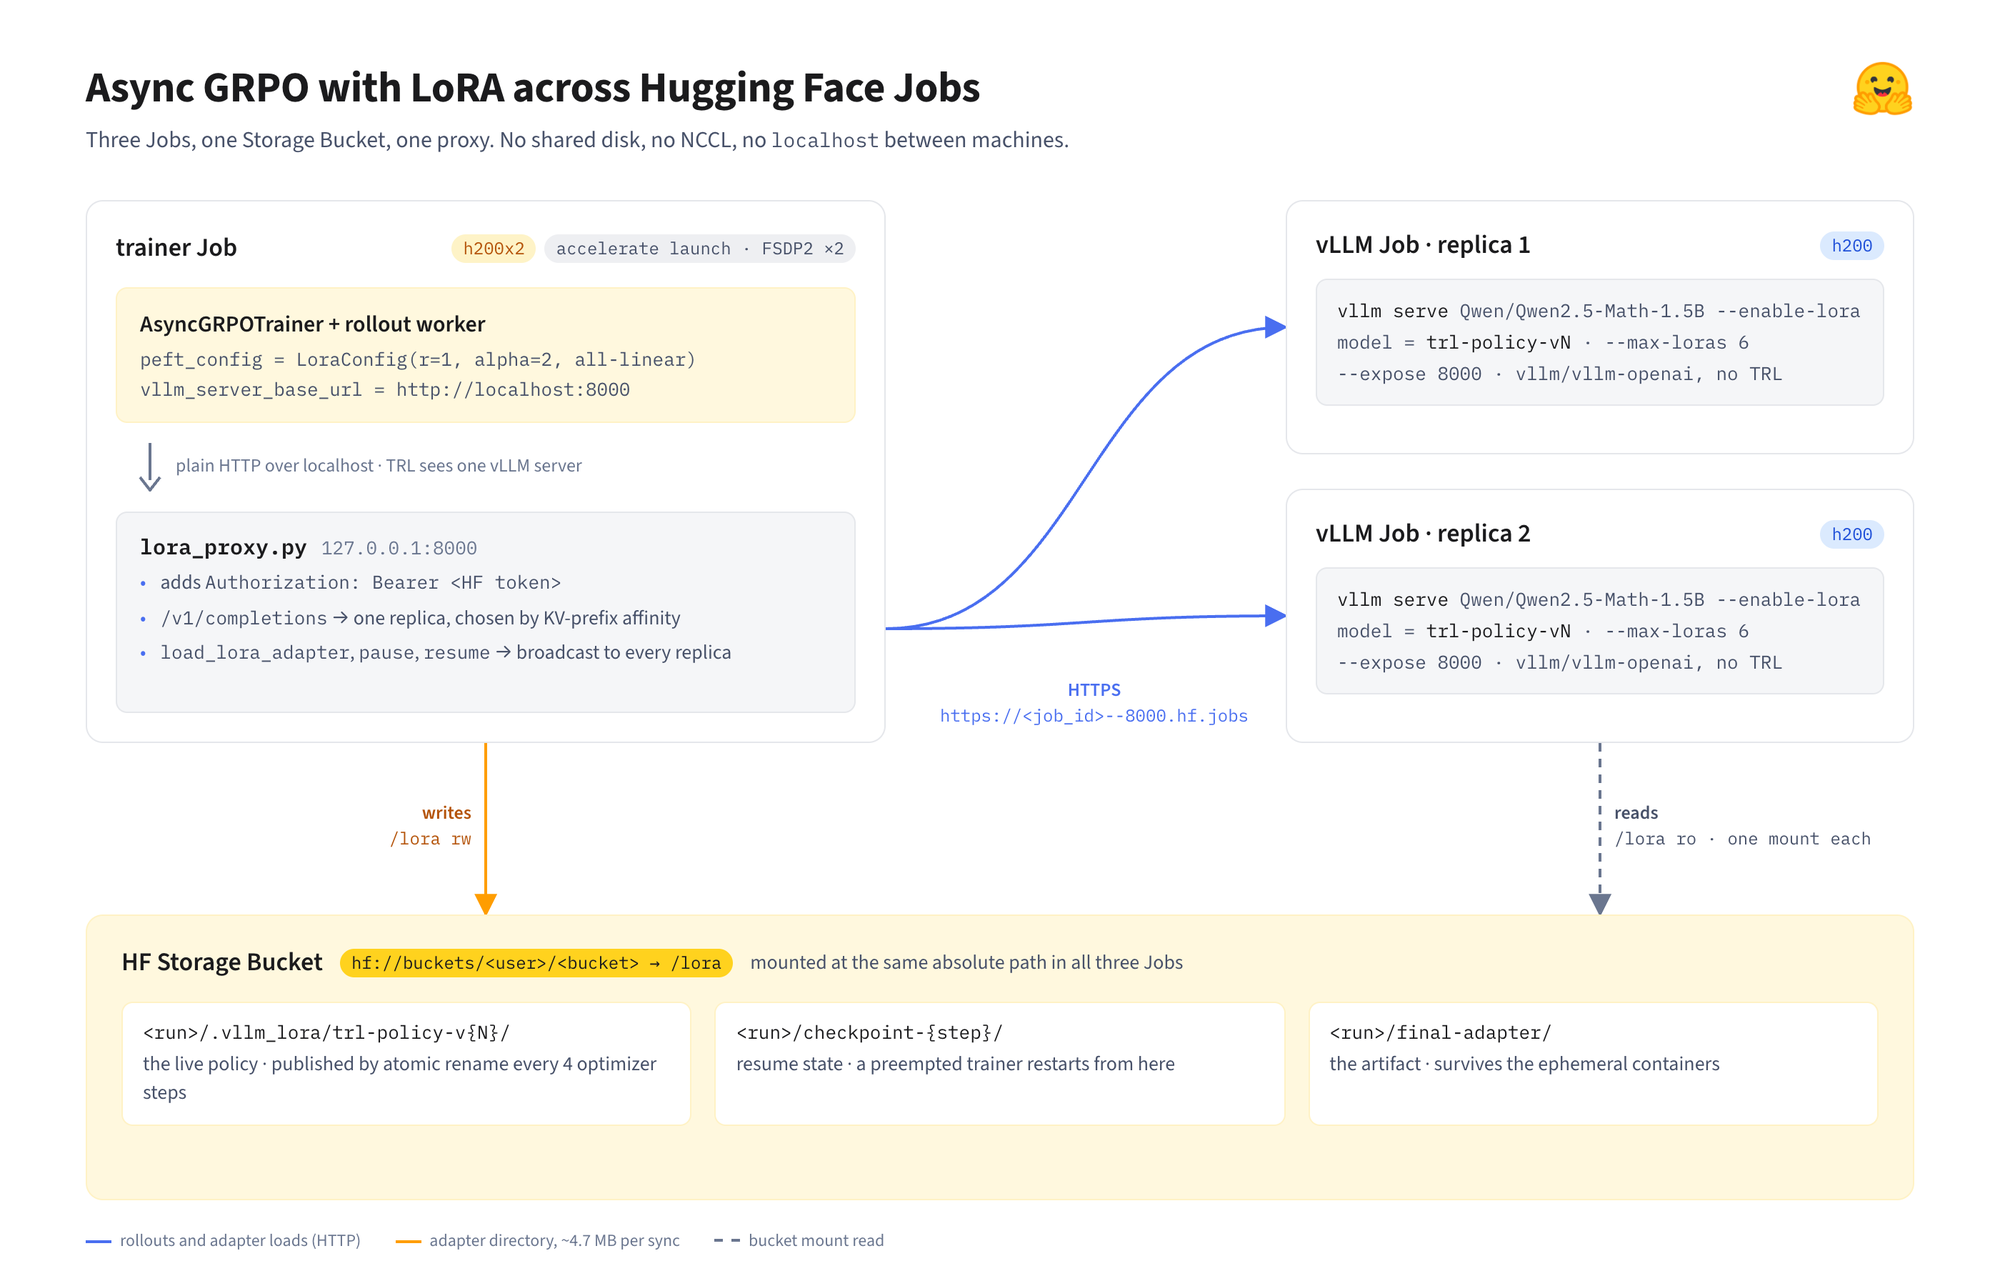
另外,checkpoint 和最终适配器也存放在 bucket 里。HF Job 本身是临时的,但被抢占的 trainer 可以恢复训练,因为最终适配器始终会持久化到 bucket,Job 停止也不会丢失。
三个 Job
vLLM 副本
每个副本使用一块 GPU 和官方的 vllm/vllm-openai 镜像,只需开启 运行时 LoRA 加载并预留足够的适配器槽位即可。
适配器槽位的数量由 max_staleness 决定。在 AsyncGRPOTrainer 中,每次权重同步都会使策略版本增加一。max_staleness 表示采样数据可以落后于当前策略多少个版本,一旦超过该值,训练器就会丢弃这些样本。当 max_staleness=4 时,即使训练器已处于 v7 版本,基于 trl-policy-v3 生成的样本仍可用于训练。在 v3 下启动的 rollout 也必须能在 v3 下完成。因此,vLLM 在任意时刻都需要服务当前策略及其之前的四个版本。这就是为什么训练器会保留 max_staleness + 1 个已注册的适配器版本,并卸载更旧的版本。每次同步时,新版本的加载发生在最旧版本的卸载之前,这在切换过程中需要多占用一个槽位。由此得出 --max-loras 6。如果只配置五个,vLLM 会在每次同步时静默驱逐那些仍有进行中的 rollout 的策略。
# --expose 8000                       可通过 https://<job_id>--8000.hf.jobs 访问
# -v ...:/lora:ro                     只读:服务器仅读取适配器
# VLLM_ALLOW_RUNTIME_LORA_UPDATING=1  启用 /v1/load_lora_adapter
# VLLM_SERVER_DEV_MODE=1              启用 /pause, /resume, /server_info(TRL 需要全部三个端点)
# --max-loras 6                       max_staleness=4 -> 4+2 个适配器槽位
for replica in 1 2; do
hf jobs run --detach --flavor h200 --timeout 8h --secrets HF_TOKEN \
    --expose 8000 \
    -v "hf://buckets/${BUCKET}:/lora:ro" \
    -e VLLM_ALLOW_RUNTIME_LORA_UPDATING=1 \
    -e VLLM_SERVER_DEV_MODE=1 \
    -- vllm/vllm-openai:v0.27.1 \
    vllm serve Qwen/Qwen2.5-Math-1.5B --host 0.0.0.0 --port 8000 \
        --max-model-len 4096 --logprobs-mode processed_logprobs --generation-config vllm \
        --enable-lora --max-lora-rank 1 --max-loras 6
done
我们将 vLLM 锁定在 v0.27.1。vLLM 迭代速度快,上述标志和运行时 LoRA 端点都是该版本所暴露的,因此应将版本号视为配方的一部分。
还有另一种设计思路:训练器只保留最新的 adapter,并始终用同一个名字发布它。我们没有采用这种方式,因为 vLLM 是以 adapter 名字为键来管理前缀缓存的。如果只用一个名字,在权重切换后,基于旧权重计算出的 KV block 依然会命中缓存,导致 prefill 不会重新执行,这样一次 rollout 的前缀可能来自旧策略版本,而 decode 却来自新版本。训练器无法察觉这种不一致,最终只会在指标上表现为 ratio 偏离 1。使用带版本的名字可以杜绝这种情况:每个名字固定对应一套权重,缓存的前缀永远不可能匹配到更新的版本。
数据集选择:Sanity 数据集
我们选择了 sail/Sanity-Test-R1D-1.5B,这是来自 《Defeating the Training-Inference Mismatch via FP16》(Qi 等,2025)的数据集。复现代码位于 sail-sg/Precision-RL。
作者使用 DeepSeek-R1-Distill-Qwen-1.5B 为每道 MATH 题生成了 40 个答案。他们保留了成功率在 20% 到 80% 之间的题目,最终得到 1,460 道题。该数据集非常适合 RL 验证,因为这些题目对该模型而言既非已完全解决,也非毫无希望,意味着模型能获取良好的早期信号进行训练和改进。
作为一个鲁棒的端到端测试,它非常出色:如果某个 vLLM 副本在 adapter 名称下悄悄返回基模型,我们希望能在几十步内从曲线中捕捉到这一现象。此外,这个数据集足够小,两轮内即可完成遍历。
我们还采用了该论文 LoRA 脚本 oat/scripts/lora 中的超参数:基座模型为 Qwen/Qwen2.5-Math-1.5B,LoRA rank 为 1,alpha 为 2,学习率为 4e-5,每个 prompt 生成 8 个样本,每步 128 个 completion,生成 token 上限为 3,000,上下文窗口为 4,096 token。
训练器
训练器使用同一个 vllm/vllm-openai:v0.27.1 镜像,并在其上安装 TRL。我们当时用的是 PR 分支;现在同样的代码已随 TRL v1.14 发布。训练脚本就是一个普通的 AsyncGRPOTrainer 脚本,唯一和 Job 相关的配置只有输出目录和服务器 URL。
from peft import LoraConfig
from trl.experimental.async_grpo import AsyncGRPOConfig, AsyncGRPOTrainer

config = AsyncGRPOConfig(
    output_dir="/lora/sanity-lora-r1",       # 在 bucket 上:adapter、checkpoint 和最终 adapter 都存这里
    vllm_server_base_url="http://localhost:8000",   # 指向 proxy,而不是 vLLM Job;TRL 完全感知不到 Job 的 URL
    max_staleness=4,
    weight_sync_steps=4,                     # 每 4 个 optimizer step 发布一次 adapter
    save_strategy="steps", save_steps=50,    # checkpoint 存到同一个 bucket,被抢占后可以恢复训练
    ...
)
trainer = AsyncGRPOTrainer(
    model="Qwen/Qwen2.5-Math-1.5B",
    args=config,
    peft_config=LoraConfig(r=1, lora_alpha=2, target_modules="all-linear"),  # 普通 LoRA,vLLM 可以直接部署
    ...
)
初始化时,TRL 会调用
/server_info。如果发现其中包含lora_config,就采用仅同步 adapter 的模式。对于 vLLM 无法直接部署的配置,比如 DoRA、modules_to_save,或者 rank 超过--max-lora-rank的情况,会退回到合并权重同步模式并给出警告。日志中应该能看到Adapter-only vLLM sync enabled。
代理(proxy)
接下来是有意思的部分。我们需要在训练器和 vLLM Job 之间放一个 proxy,原因有两个:
暴露出来的 Job 端口要求每个请求都带上
Authorization: Bearer <HF token>请求头。这个请求头由 proxy 统一添加,TRL 无需感知。我们希望多块 GPU 同时做生成。在单个 vLLM 服务器上,通常的做法是设置
--data-parallel-size > 1,但 TRL 在该模式下会拒绝仅同步 adapter,理由很充分:调用/v1/load_lora_adapter时只有应答的那个 DP rank 会加载 adapter,其余 rank 会继续在新的策略名下运行基础模型。而在 Jobs 上这个问题根本不存在,因为每个副本都是独立的机器。所以数据并行只能上移一层,由某个组件把 adapter 的加载分发到所有副本。
因此,我们在 trainer Job 的 `127.0.0.1:8000` 上运行一个轻量级代理,让 TRL 将其当作单台 vLLM 服务器来调用。除了添加请求头之外,这个代理在功能上主要做两件事:
- 它将每个生成请求发送给某一个副本,选择标准是确保该提示词的八个 rollout 都落在已缓存其前缀的副本上(下文会详细解释这一机制)。
- 它将所有状态变更请求(如加载适配器、暂停和恢复)广播给所有副本,以确保策略名称在所有副本上具有相同的含义。
按 KV 前缀路由 rollout
先回顾一下为什么这一点至关重要。生成完整回复的过程分为两个阶段,二者的负载特征截然不同:
- Prefill 阶段一次性处理整个提示词,并计算所有提示词 token 的注意力键和值。
- Decode 阶段则逐 token 生成,每个新 token 都会关注其之前所有 token 的键和值。
这些键和值就是 KV 缓存。由于注意力的因果性,某个 token 的 KV 只依赖于它之前的 token,而与其之后的内容无关。因此,共享相同前缀的两个请求也会共享该前缀的 KV;如果某副本的缓存中已有这些数据,就可以完全跳过该部分的 prefill 计算。当前的核心目标就是找到这个副本,让请求能够落到已见过其前缀的副本上,从而享受缓存带来的加速。
vLLM 以 16 个 token 为一个块来存储其前缀 KV 缓存。受 GRPO 机制影响,rollout worker 会发送 G 个使用相同提示词 的请求(在我们的场景中 G=8)。如果这些请求都到达同一个副本,第一个请求会执行 prefill 计算,后续七个请求直接复用结果。但如果采用轮询路由,其中一半请求会被分配到没有缓存该前缀的副本,那四个请求就得重新执行 prefill 计算,白白浪费宝贵的 GPU 算力。
我们路由器的职责是追踪哪个副本处理过哪些块哈希。有一个关键细节:哈希是链式生成的,因此第 3 块的哈希实际上代表了第 1、2、3 块的整体,而不仅仅是第 3 块。这与因果注意力的机制一致:只有当第 1 和第 2 块也一致时,第 3 块的 KV 才有效。此外,我们还用适配器名称来初始化哈希链,因为 KV 缓存还取决于生成它的适配器:为 policy v3 缓存的前缀,对 policy v4 来说毫无用处!
该视频完整展示了选择副本的整个决策过程。以下步骤以一个真实的 135 个 token 的补全请求为例进行说明(来自 Sanity 数据集的题目):
1. 将提示词切分为块。路由器接收 token ID,将其切分为 16 个 token 的块,方式与 vLLM 相同。它只对完整的块进行哈希计算,因此最后 7 个 token 在此步骤中被忽略。
2. 哈希前缀。每个块都与上一个块的哈希值一起进行哈希计算,起点是适配器的种子值。h3 因此按顺序标识了第 1、2、3 块。两个提示词如果前 k 块相同,那么它们的哈希值在 hk 之前也完全相同。一旦某个块发生变化,其后所有的哈希值也会随之改变。这就是我们用适配器名称作为哈希种子的原因:同一个提示词在 trl-policy-v4 下会从不同的种子开始,因此无法匹配 v3 中的条目。这正是我们期望的结果,因为旧的 KV 块是用不同的权重计算出来的。
3. 比较两个提示词。题目 1 包含 103 个 token。两个提示词都以相同的 23 个 token 的聊天模板开头。它们的第一个块完全一致,但第 2 块已经包含了题目文本。从这一点开始,哈希值就不再相同了。
4. 记录块的归属。路由器会记住每个哈希由哪些副本服务过,以及它后面跟了哪些哈希(后继集合上限设为 2,因为我们只需要知道一个块是只有一种续写还是有多种)。处理几个 prompt 之后,模板块 h1 由两个副本共同拥有,且已有多个后继;h2 到 h8 只属于 A,各自只有一个后继;h2' 到 h6' 只属于 B。
实际运行中,每个 prompt 的开头都是相同的 token。这里指的是 chat template 和 system prompt,对应全部 1,460 道题目的前 23 个 token。在 agent 场景里就是工具描述,在多轮对话场景里就是共享的对话历史。这些块几秒内就会出现在所有副本的缓存里,用它们做匹配根本无法定位某个 prompt 在哪个副本上。
如果一个块被所有副本都服务过,或者它有不止一个后继,就称之为公共块。路由时会忽略公共块,因为它们无法标识特定的 prompt。后面还会详细讲这点!
5. 选择副本。路由器统计每个副本上匹配到的前缀块数量,并去掉公共前缀,剩下的就是该 prompt 特有的块数。然后:
- 如果某个副本拥有特有块,且没有过载——即它领先负载最低的副本不超过 8 个请求——请求就发给它。这称为 affinity 命中。
- 如果某个副本拥有特有块,但领先超过 8 个请求,我们就放弃缓存,把请求发给负载最低的副本。这称为 spill。
- 如果没有任何副本拥有特有块,说明是新 prompt,发给负载最低的副本(相同负载时轮询分配)。这称为 unmatched。
下面用四个请求来演示这条规则。初始状态是副本 A 和 B 各有 3 个在途请求,且只有模板块 h1 被两个副本共同知晓。
- 请求 1,问题 0,rollout 1。 两个副本均匹配到一个 block,即 template,且该 block 为公共部分。因此,没有特定内容匹配任何副本。请求未命中缓存,且两个副本负载均等,round-robin 将其发送至 A。路由器记录
h2至h8由 A 持有。此时 A 有 4 个在途请求。 - 请求 2,问题 0,rollout 2。 相同的 prompt。A 匹配所有 8 个 block,B 仅匹配 template。剔除公共 block 后,A 有 7 个特定 block,B 没有。A 仅比 B 多 1 个请求,远低于 8 的上限,故请求发送至 A。这是一次 affinity 命中:A 的 KV cache 中已存有完整的 prompt。
- 请求 3,问题 1,rollout 1。 新的 prompt。两个副本均仅匹配到 template block,无特定内容匹配。请求未命中缓存,发送至负载最低的副本 B,此时 B 有 3 个在途请求,而 A 有 5 个。路由器记录
h2'至h6'由 B 持有。 - 请求 4,问题 0,rollout 9。 假设此时 A 有 12 个在途请求,而 B 恢复至 3 个。A 仍持有 7 个特定 block,但其领先 B 的请求数已达 9,超过上限。请求溢出至 B。B 对问题 0 执行一次 prefill,路由器同时记录
h2至h8由 B 持有。既然所有副本均已服务过这些 block,问题 0 也变为公共部分,其后续 rollouts 仅依据负载进行分配。
6. 复用 prefill。 请求 2 正是这一切的意义所在。它复用了请求 1 计算出的 prefill:block 1 至 8 已存在于 A 的 KV cache 中,因此 A 直接跳过至 completion 的 decoding 阶段。若该请求被发送至 B,B 将再次对全部 135 个 token 执行 prefill,而 A 的 cache 则闲置。请求 3 说明了为何需要 common 规则。否则,共享的 chat template 会使每个新 prompt 看似均命中缓存。请求 4 则将负载保持在可控范围内。省去一次 prefill 的价值,不应以让某副本严重落后为代价。
def choose(self, upstreams, model, prompt):
    hashes = self.block_hashes(model, prompt)         # 16 个 token 一级的链式 blake2b 哈希,以 `model` 作为种子
    matched = self.matched_prefix(hashes)             # 各副本已服务的头部块数量
    common = self.common_prefix_len(hashes)           # 无法区分 prompt 的公共头部块数量(见下文)
    specific = [max(0, m - common) for m in matched]  # 实际区分各副本的部分
    least = min(u.inflight for u in upstreams)
    best = max(range(self.n), key=lambda i: (specific[i], -upstreams[i].inflight))

    if specific[best] > 0 and upstreams[best].inflight - least <= self.cfg.imbalance:
        pick = best                                   # 亲和性路由:命中该 prompt 且负载未过载的副本
    else:
        candidates = [i for i in range(self.n) if upstreams[i].inflight == least]
        pick = candidates[self.rr % len(candidates)]  # 新请求或溢出:选择负载最轻者,并列时轮询
        self.rr += 1
    ...记录 `pick` 为每个块及其后继块的归属者...
    return upstreams[pick]
那个公共前缀是个麻烦角色。每个请求的开头都是相同的 system prompt 和 chat template,简单的最长前缀匹配会让第一个副本几乎匹配所有新 prompt。我们通过扇出(fan-out)检测来识别共享前缀:一个块如果对应多个不同的后继块,说明它是公共的;而始终指向同一后继的块则属于特定的 prompt。只有公共前缀之后的那些块才算作亲和性。
广播 Adapter
Proxy 还需要向所有副本广播 Adapter 的加载。我们将该操作视为全有或全无。由于每个副本拥有独立的 bucket 挂载,它们不一定在同一时刻看到新的 Adapter。如果返回 No adapter found for <path> 错误,通常意味着某个 bucket 挂载尚未同步完成,此时只需重试该副本。对于其他任何错误,我们会从已接受该 Adapter 的副本中将其卸载,确保同一个策略名称不会只存在于部分副本上。
async def load_one(u):
    while True:
        status, _, out = await send(u, "POST", "/v1/load_lora_adapter", headers, body)
        if status == 200 or "No adapter found" not in out.decode() or time.monotonic() > deadline:
            return u, status, out
        await asyncio.sleep(cfg.lora_retry_s)          # this replica's mount has not seen the directory yet

results = await asyncio.gather(*(load_one(u) for u in ups))
if any(st != 200 for _, st, _ in results):
    await asyncio.gather(*(send(u, "POST", "/v1/unload_lora_adapter", headers, unload) for u, st, _ in results if st == 200))
    return web.Response(status=504 if timed_out else st, text="rolled back on the others")
我们还用同样的方式广播 /pause、/resume 和 /v1/unload_lora_adapter。/health 只有在所有副本都健康时才返回 200;/server_info 和 /v1/models 则只需取一份应答即可。在 TRL 看来,这个代理就是一台 data_parallel_size=1 的服务器,因此它会选择只同步 adapter。
起初我们担心 Python asyncio 代理会成为瓶颈,实际上并没有(至少在这个规模下没有)。同时在途的最多只有 128 个非流式 JSON 请求,路由也只是算几个哈希,单线程轻松搞定。如果需要更精致的路由器来支撑更大的流量,那大概就得用更快的语言来写了(🦀,说的就是你)。
完整运行结果
下面的数据来自 trainer 在 trackio 上记录的 logged metrics。这次运行使用 Qwen/Qwen2.5-Math-1.5B,在 all-linear 上做 LoRA r=1,每步生成 128 个 completion、每个 prompt 做 8 次 rollout。总共跑 500 步,每 50 步保存一次 checkpoint。trainer 使用一个 h200x2 Job,两个 vLLM 副本各使用一个 h200 Job。三个 Job 全部运行的成本约为每小时 20 美元。
权重同步
| 每次同步(按 trainer 时钟,共 126 次同步) | 之前 | 现在(p50) |
|---|---|---|
| 整个同步流程 | 30.8 s | 8.5 s(最小 6.6,最大 9.2) |
| 其中:暂停两个副本 | 0.3 s | 0.3 s |
| adapter all-gather 并保存到 bucket | 0.6 s | 1.1 s |
| 两个副本均接受该 adapter | 约 29 秒 | 约 7 秒 |
全部 252 次 adapter 加载均成功 🎉:126 次同步涉及 2 个副本。其中 6 次在第二次尝试时成功,246 次在第三次尝试时成功。
路由机制
在 64,728 次 rollout 结束后,proxy 的计数器显示如下:
routed [31928, 32800] affinity 54712 spilled 820 unmatched 9196
每个 prompt 对应 8 次 rollout,意味着八条请求中至少有一条是冷请求。因此,理论最低值为 12.5%。路由器实测得到 14.2% 的未匹配请求、84.5% 的亲和性命中率和 1.3% 的溢出率。若不深入研究基于真实测量负载的副本级推理指标,性能提升空间已十分有限。
时间都去哪了
第一套配置存在明显瓶颈:训练器而非生成过程。在 500 个步骤中,数据如下:
| 每个 optimizer step 的 p50 耗时 | |
|---|---|
| step | 22.9 秒 |
| forward + backward | 21.9 秒 |
| 等待 rollout | 0.02 秒 |
| rollout 队列占用率 | 476 / 512 |
| trainer MFU | 3.9% |
rollout 队列始终满载,worker 主要因背压而阻塞。在此配置下,第二个副本几乎无用武之地。后文将说明如何通过多次运行,将瓶颈在训练与生成之间转移,最终使整体运行速度提升 3.9 倍。
奖励信号
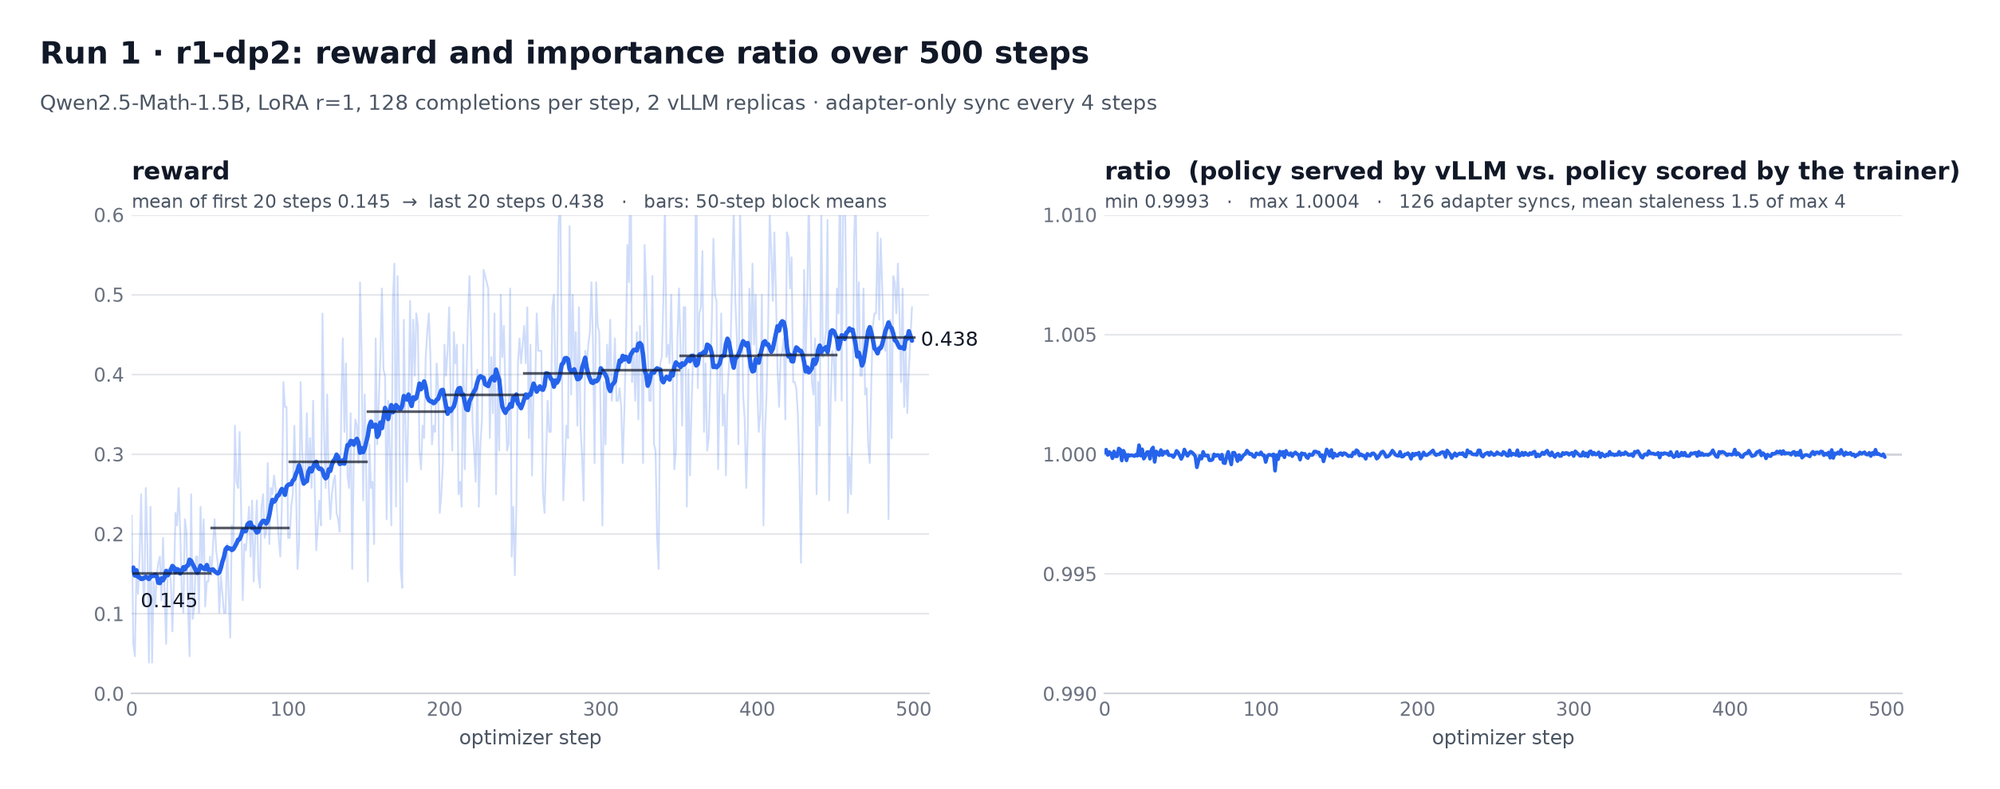
图 1:trackio 运行记录 r1-dp2。面板展示 reward 及其 20 步滑动均值和 50 步分块均值,以及 ratio(横轴范围 0.99 至 1.01)。奖励值在 500 步内从 0.15 上升至 0.44;ratio 全程保持在 0.9993 至 1.0004 之间。
500 步训练耗时 3 小时 27 分。平均奖励从最初 20 步的 0.145 上升到最后 20 步的 0.438。对此次测试更关键的是,ratio 在每一步都稳定保持在 1.000!vLLM 提供的策略与训练器用于评估 rollout 的策略始终一致。这一点在所有 126 次同步中都成立。平均陈旧度(staleness)为 1.5 个策略版本,最大不超过 4。完整曲线见 trackio 仪表盘。
我们已经拿到了 LoRA AsyncGRPO 有效的确凿证据!接下来,通过分析最近的详细 AsyncGRPO 指标,看看如何改进训练流程。
追踪瓶颈的乒乓效应
异步 RL 本质上是训练与生成之间的流水线。如果一方加快而另一方跟不上,效果为零。幸运的是,我们在 AsyncGRPOTrainer 中加入了足够的计时和指标,可以直接观察这一现象。
所有有用指标都记录在 日志指标 部分。perf/rollout_wait_s 显示训练器等待样本的时长;rollout/backpressure_s 显示生成端等待 rollout 队列空位的时长。这两者互为反面,不应同时处于高位。结合队列大小,它们能告诉我们瓶颈在哪一侧。
我们跑了五组实验,每组都针对上一组仪表盘中暴露出的问题进行调整。除特别说明外,模型、配方和三路 Job 架构保持不变。以下是各组的 trackio 运行名称。
读懂仪表盘
我们持续监控以下四组指标:
perf/step_s和perf/fwd_bwd_s:单个优化器步的耗时,以及其中前向+反向传播占用的比例。如果步耗时几乎等于前向+反向耗时,说明训练器明显受算力限制。perf/rollout_wait_s:训练器在启动新步骤前等待样本的时长。接近零说明生成速度领先于训练,样本即时可用。sample/rollout_queue_size对比queue_maxsize:这是连接两端的缓冲区。队列已满意味着生成端被节流;队列空闲意味着训练器“饿”了。rollout/backpressure_s和rollout/score_block_s:rollout worker 因为缓冲区满了而被阻塞的时长。这个 worker 是一个两阶段流水线:生成阶段把完成的组交给打分阶段,打分阶段再把打完分的样本推进 rollout 缓冲区。缓冲区满了,打分就无法入队而阻塞,这就是rollout/backpressure_s。打分一旦停下,就不再消费自己的输入队列,生成阶段也就交不出下一组,这就是rollout/score_block_s。两者是同一个阻塞,先在打分阶段出现,再回传到生成阶段。
诊断很简单:队列满、rollout 等待为零、背压高,说明 trainer 太慢;队列空、rollout 等待上升、没有背压,说明生成太慢。对比 perf/mfu_wall_clock 和 perf/mfu_fwd_bwd 还能看出 trainer GPU 有多少时间在干等而不是训练。
Run 1,r1-dp2:跟不上的 trainer
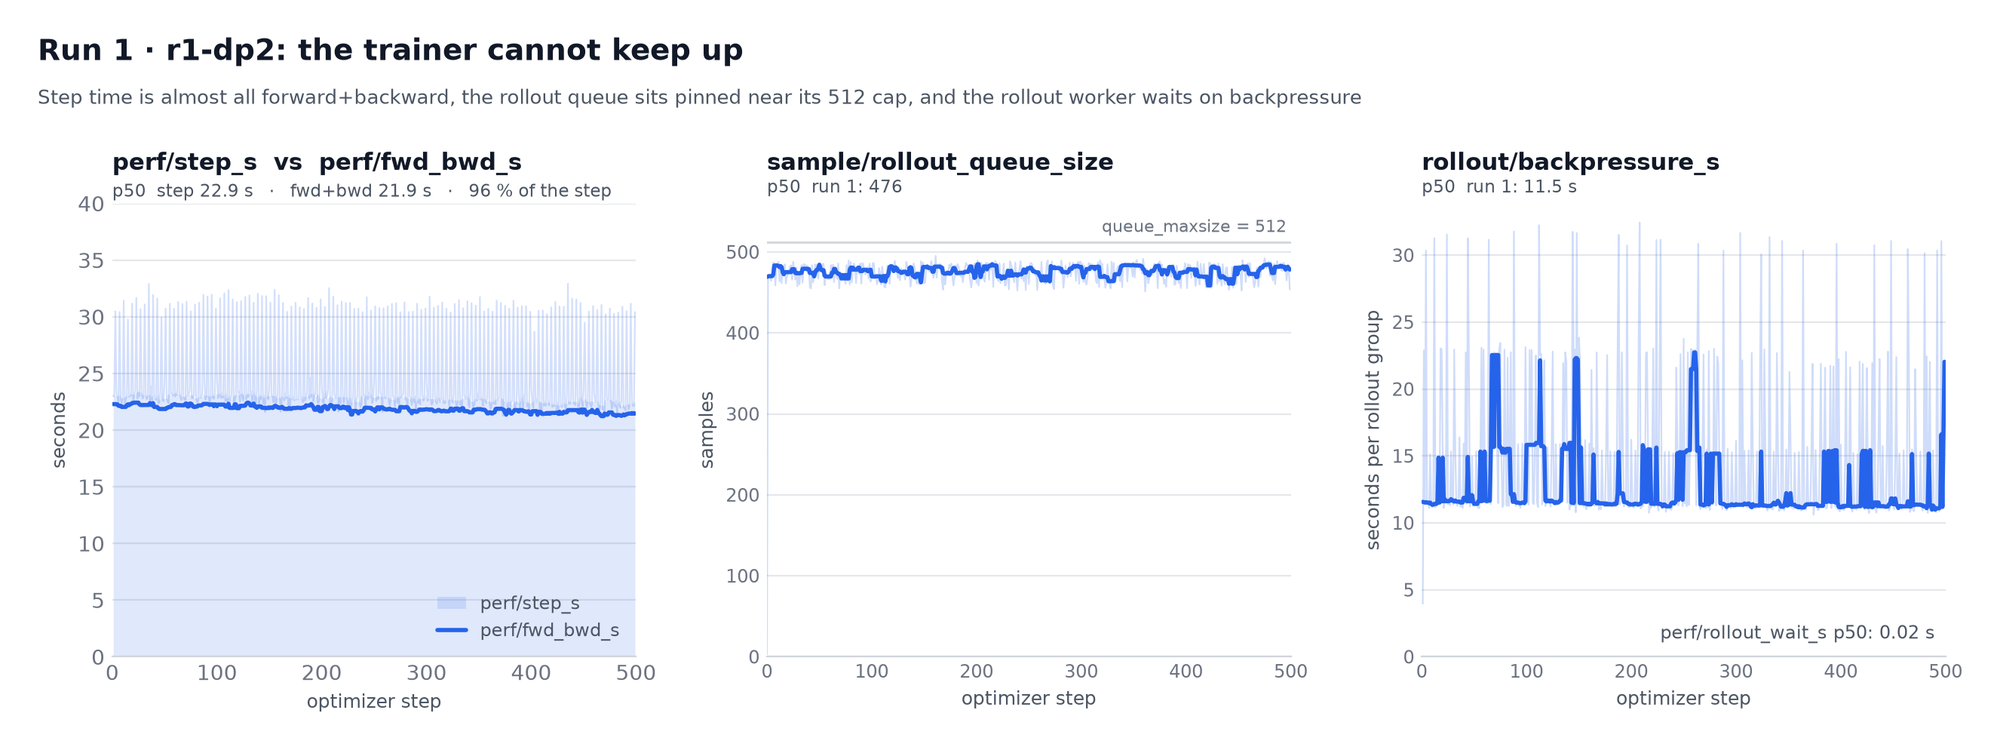
图 2. trackio run r1-dp2。面板:perf/step_s、perf/fwd_bwd_s、sample/rollout_queue_size、rollout/backpressure_s。step 时间与前向+反向几乎完全重叠;队列长期钉在 512 中的 476 附近,每个 rollout 组的背压从没低于 11 秒:瓶颈在 trainer。
perf/step_s 是 22.9 秒,perf/fwd_bwd_s 是 21.9 秒,前向和反向占了 96% 的 step 时间。队列一直是满的,trainer 等 rollout 只花 0.02 秒,而 rollout worker 每个组要被背压阻塞 15 秒。两个 vLLM 副本的生成速度远快于 trainer 的消费速度。报告的 4.6k tokens/s 并不是它们的真实上限,只是产出的结果没地方放而已。
批量指标揭示了 3.9 % 极低 MFU 的成因。batch/microbatches_per_step 为 64,batch/samples_per_row 为 1.0。每个 rank 在每一步中处理约 1.2k 个 token 的序列,重复 64 次。这源于参考配方中 per_device_train_batch_size=1 的设置。对于 H200 上的 1.5B 模型而言,这种配置完全受限于延迟。
运行 2,r1-dp2-tb16k:填充微批次
修复方法并非调整 batch size。我们保持每个优化器步处理 128 个 completion,仅改变它们在 GPU 上的布局方式:不再每个微批次仅包含一条序列,而是将多条序列密集打包到每一行中。Trainer 通过token 预算批次支持这一功能。当 token_budget > 0 时,系统会将多个样本打包到每个 rank 的每一行中,实现无 padding 处理。一个优化器步处理 gradient_accumulation_steps 行数据。我们将 token_budget 设为 16384,gradient_accumulation_steps 设为 6。
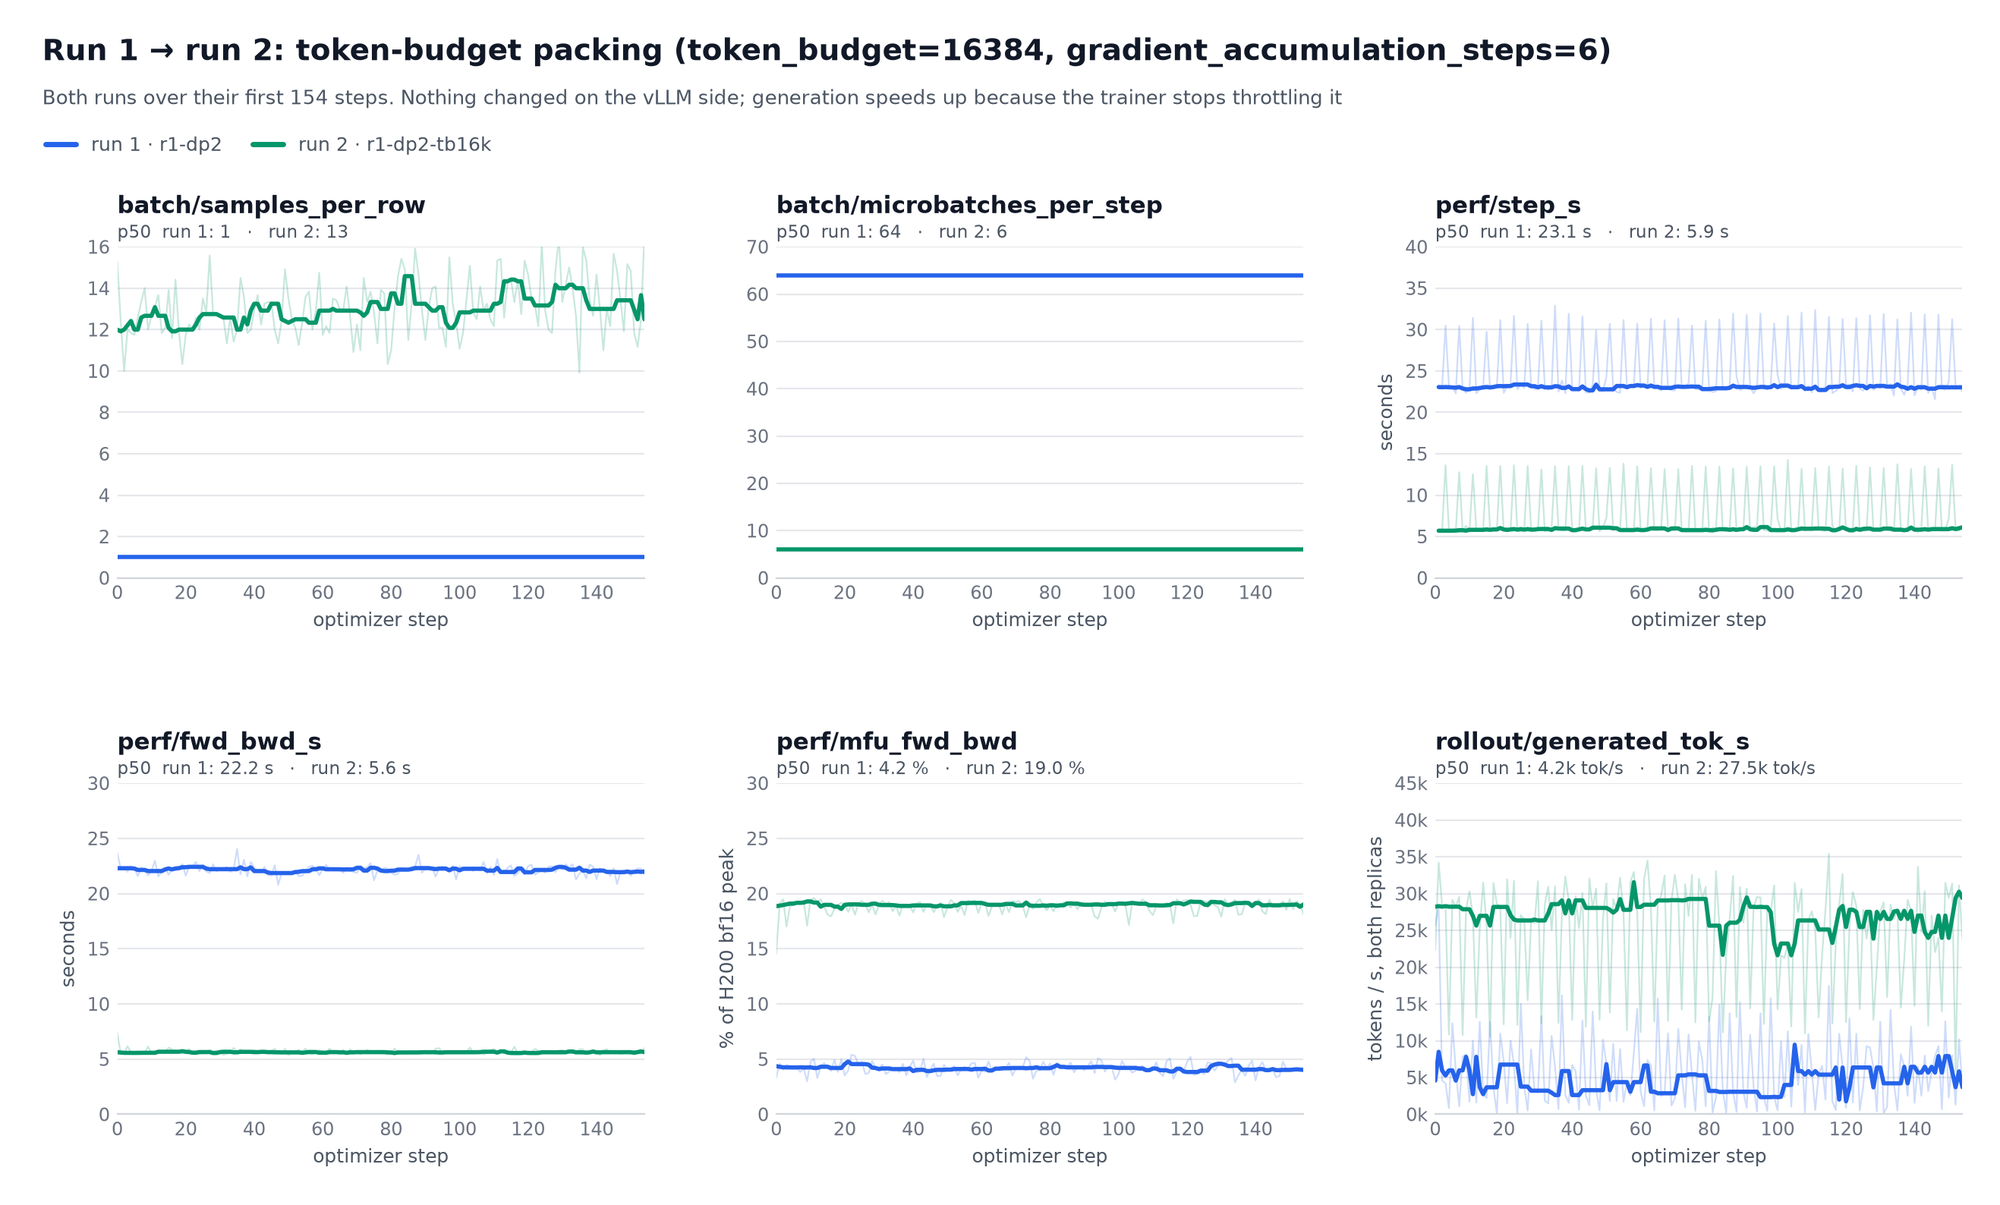
图 3. 在 trackio 中,将 r1-dp2 与 r1-dp2-tb16k 的前 154 步运行结果叠加显示。面板展示指标包括:batch/samples_per_row、batch/microbatches_per_step、perf/step_s、perf/fwd_bwd_s、perf/mfu_fwd_bwd、rollout/generated_tok_s。打包后每行样本数从 1 提升至 13,微批次数量从 64 降至 6,单步耗时从 23 秒缩短至 5.9 秒,生成吞吐量从 4.2k 提升至 27.5k tok/s,而 vLLM 侧未做任何改动。
batch/samples_per_row 从 1.0 提升至约 12.7,微批次数量从 64 降至 6。行填充率高达 95 %!前向和反向传播时间从 21.9 秒降至 5.6 秒,MFU 则从 3.9 % 跃升至 19 %。由于打包效率优于基于平均长度预估的预测值,我们现在每个步训练约 150 个样本。
生成吞吐量也从 4.6k 跃升至 25k tokens/s,尽管我们并未修改 vLLM 侧的任何配置。队列不再持续处于满载状态,副本终于能够正常运行。这正是我们不倾向于孤立优化流水线各阶段的原因。我们需要评估整个系统,因为缓慢的阶段会掩盖上游各环节的真实性能表现。
第 3 轮:r1-dp2-tb16k-nockpt:停止前向重算
perf/fwd_s 为 1.34 s,而 perf/fwd_bwd_s 为 5.6 s。常规反向传播耗时大约是前向传播的两倍,但在基础权重冻结的情况下,两者应更接近 1:1。3.2 倍的反比值得关注。
原因在于 AsyncGRPOConfig 默认设置为 gradient_checkpointing=True。这意味着每个 microbatch 在反向传播阶段都会重新计算前向。这也解释了为何 16k token 的行在 141 GB 的 H200 上仅占用 25 GB 显存——这是该训练器的显存优化策略,但在当前场景下并非必需:模型足够小,保留激活值用于反向传播也完全能放进显存。
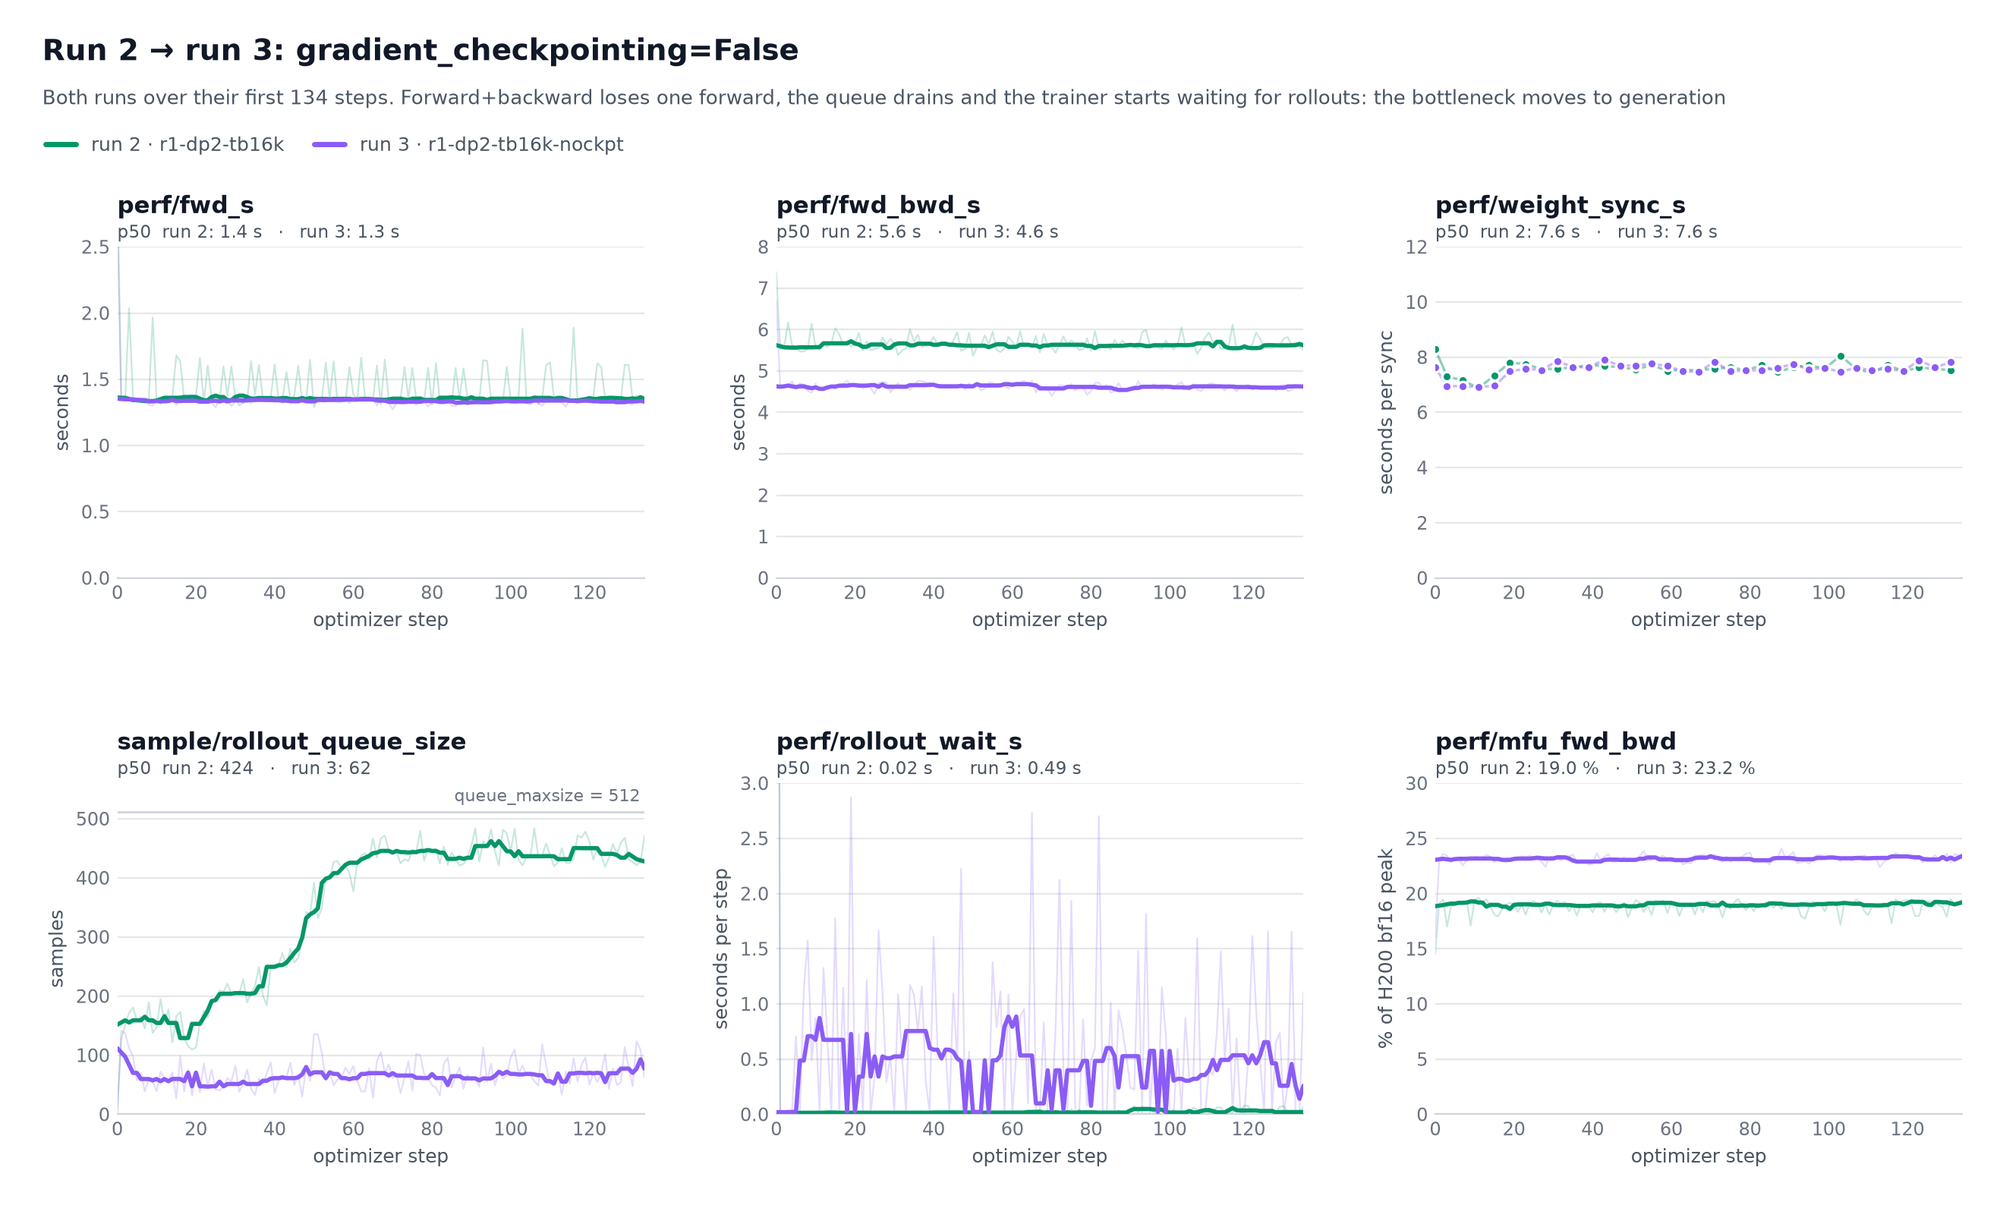
图 4. trackio 展示 r1-dp2-tb16k 和 r1-dp2-tb16k-nockpt 前 134 个步骤的叠加对比。子图分别显示:perf/fwd_s、perf/fwd_bwd_s、perf/weight_sync_s、sample/rollout_queue_size、perf/rollout_wait_s、perf/mfu_fwd_bwd。前向+反向耗时减少了一次前向的计算量;队列长度从约 420 降至约 60;rollout 等待时间从 0.02 s 上升至 0.5 s:瓶颈转移到了生成环节。
设置 gradient_checkpointing=False 后,前向与反向传播耗时降至 4.6 s,几乎正好减少了一次前向的计算时间,MFU 达到 23%。此时队列长度降至 71,rollout 等待时间从 0.04 s 上升至 0.6 s。训练器消耗样本的速度已超过两个副本的生成速度。我们成功将瓶颈转移到了生成端。
这又暴露出另外两项开销。每四步一次的权重同步耗时 7.6 s,现在占据了 25% 的挂钟时间。而在之前每步耗时 23 s 时,这一比例仅为 8%。此外,反向传播仍比前向慢 2.5 倍。在基础权重冻结的前提下,每个步骤中存在约 2 s 的耗时并非来自常规模型计算。
第 4 轮:r1-dp3-tb16k-nockpt:三个副本,及一项意外
由于生成速度成为短板,我们增加了第三个副本。同时将代理层的 adapter 重试间隔从 2 s 缩短至 0.5 s,并禁用 fsdp_reshard_after_forward,以排查 FSDP2 的重新聚合(re-gather)是否导致了反向传播中额外的 2 s 延迟。
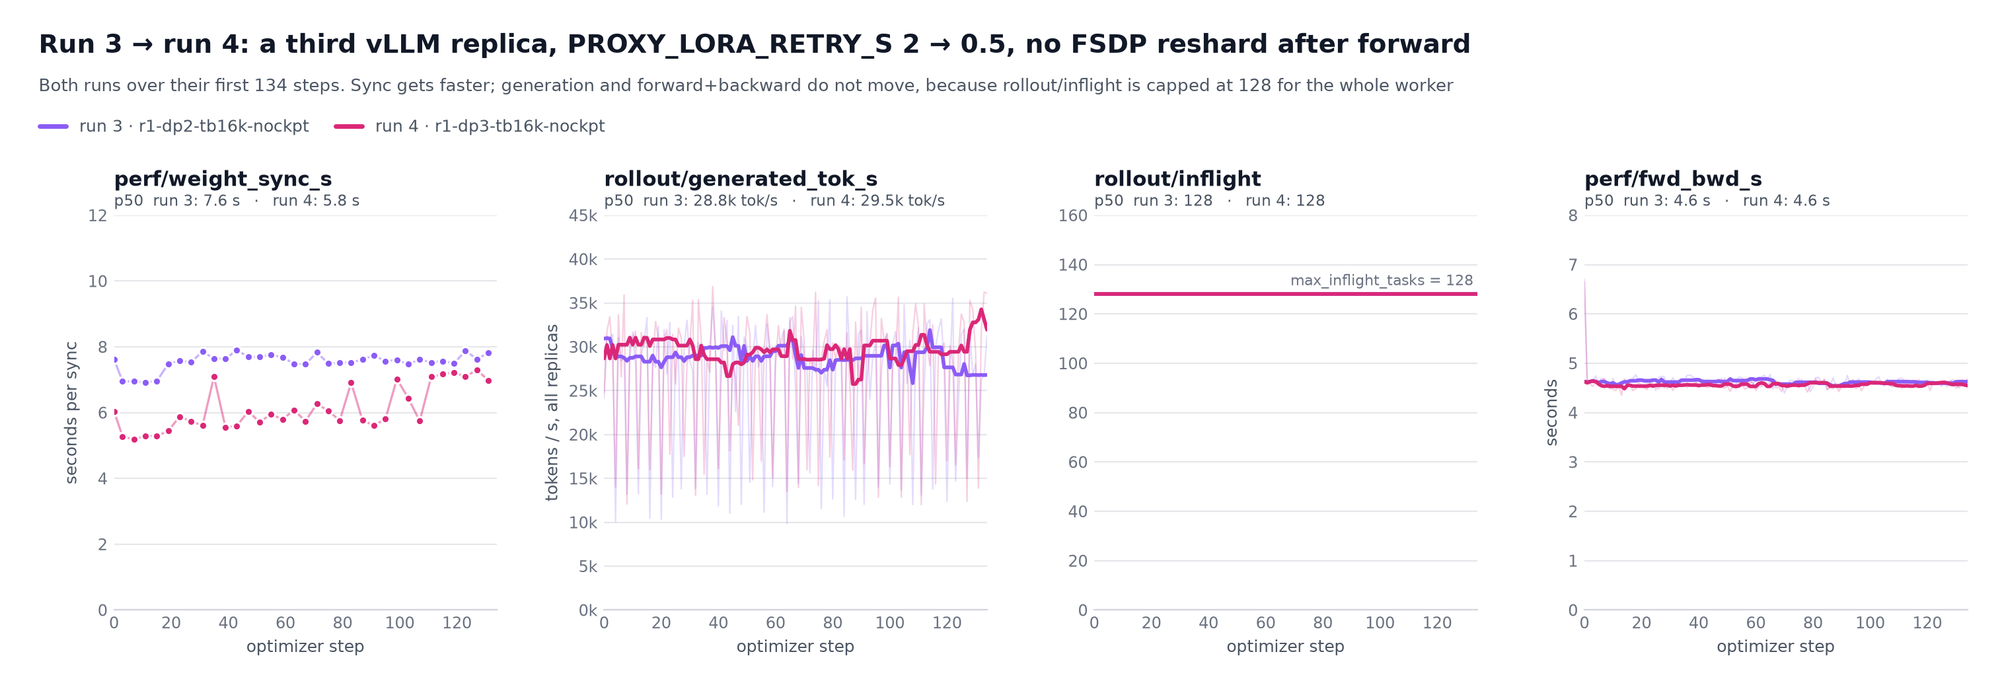
图 5. trackio 将 r1-dp2-tb16k-nockpt 和 r1-dp3-tb16k-nockpt 的前 134 步叠加对比。面板包括:perf/weight_sync_s、rollout/generated_tok_s、rollout/inflight、perf/fwd_bwd_s。同步耗时从 7.6 秒降到 5.8 秒;生成和前向+反向耗时不变;两次运行的 rollout/inflight 都是 128,这正是第三个副本撞上的上限。
权重同步从 7.6 秒降到 5.8 秒,说明缩短重试间隔确实有效。前向和反向仍保持 4.6 秒,排除了重新分片的影响。生成速度只从 25k 涨到 26k tokens/s。第三个副本基本没干活。
原因就藏在 rollout/inflight 里:每次运行都是 128。代理显示这些请求在三个副本上的分布是 44 + 43 + 41。max_inflight_tasks 限制的是整个 rollout worker 的并发数,而不是按副本分配。1.5B 模型在 H200 上处理 43 个和 130 个并发序列,每个 token 的成本几乎一样。把 128 个请求分到三块 GPU 上,吞吐量和分到两块几乎没区别。
所以瓶颈不在 vLLM,而在我们自己设置的一个客户端常量。当初设得这么保守,是因为不知道几百个长 HTTPS 请求经由公开的 Jobs 代理会表现如何。到这时,已经 130,000 次 rollout 完成请求通过了代理,没有出现一次传输错误。
Run 5,r1-dp3-inflight384:放开在途请求的上限
只改两个参数:max_inflight_tasks=384、queue_maxsize=768,其余不动。
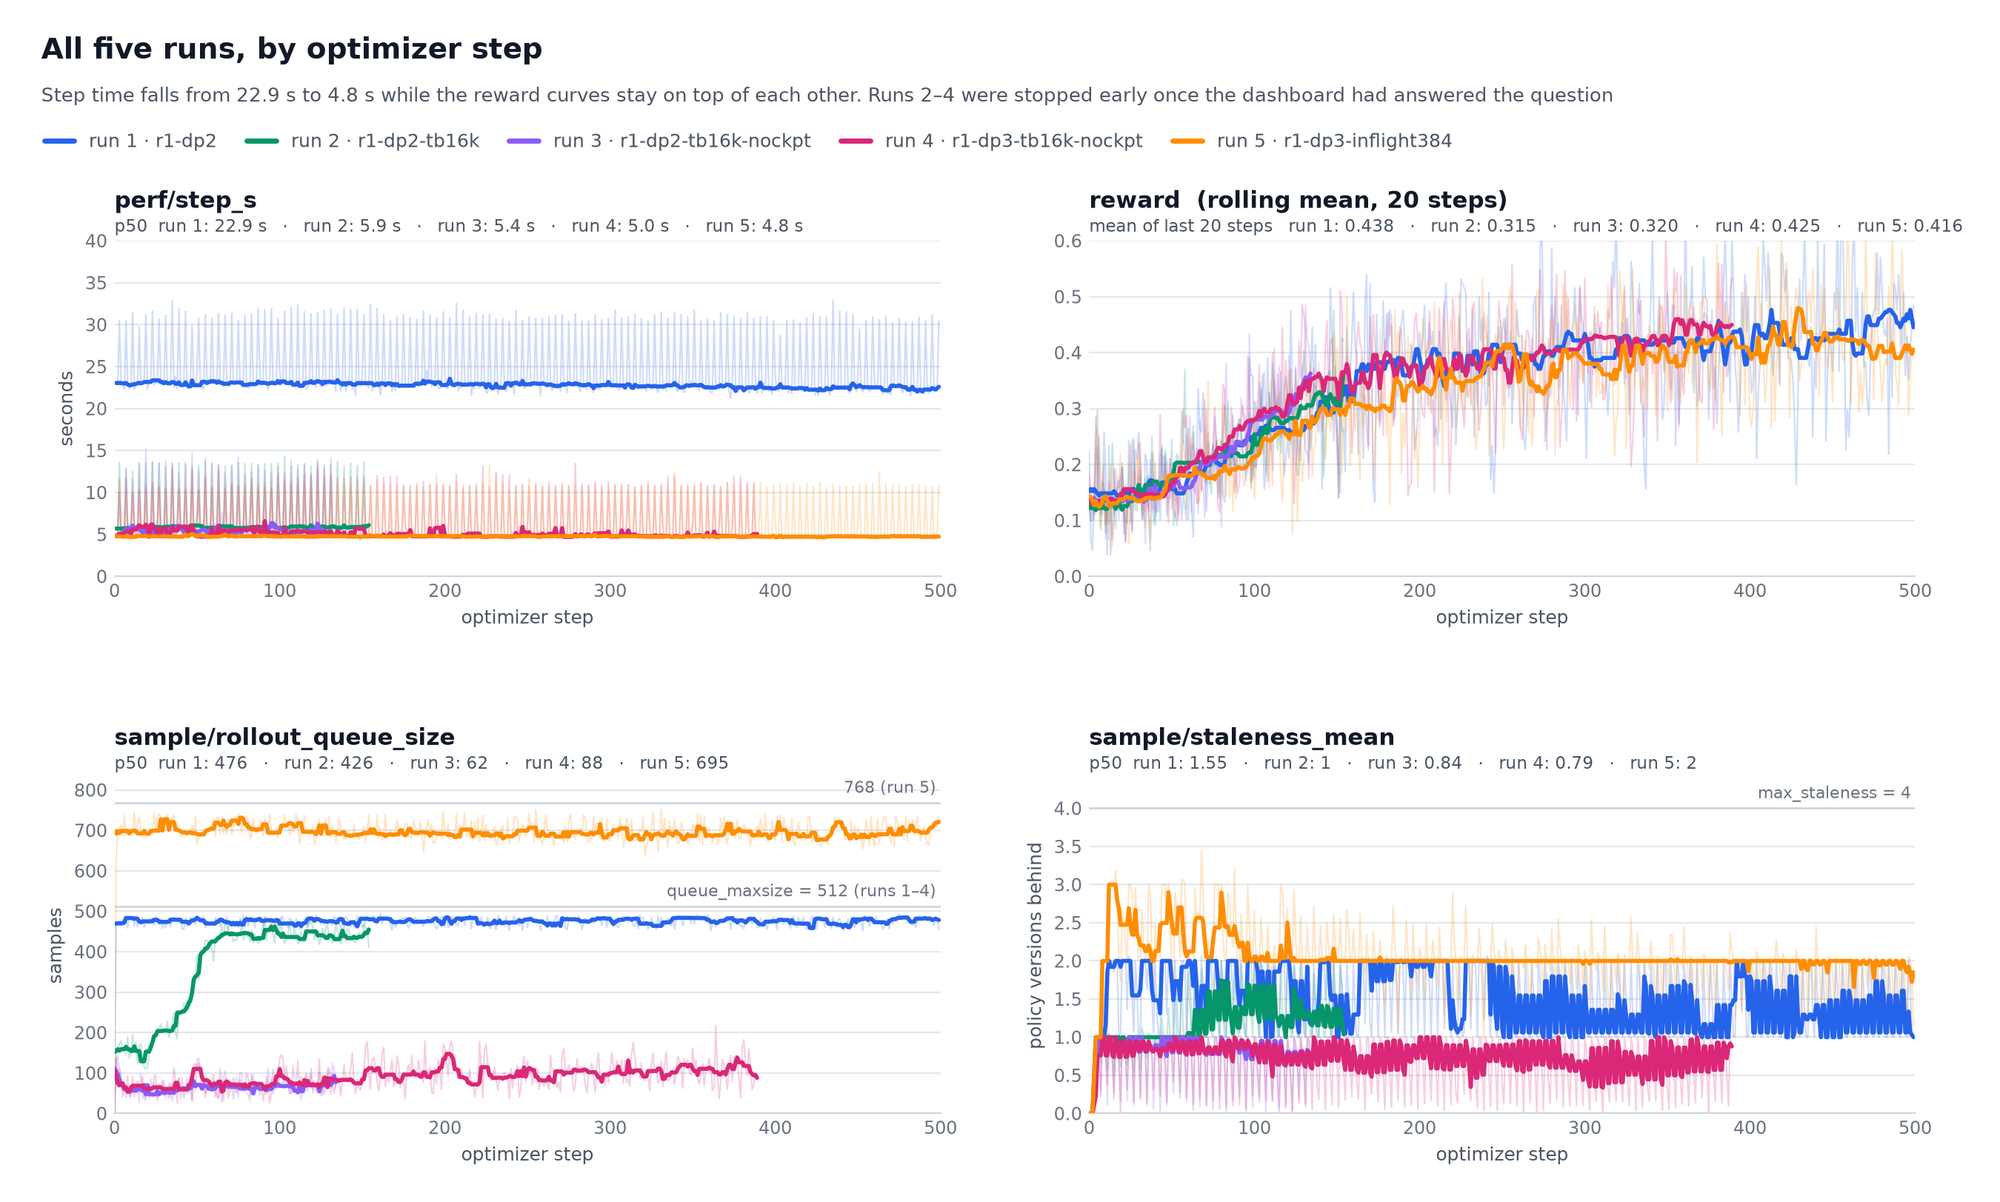
图 6. 五次 trackio 运行(r1-dp2、r1-dp2-tb16k、r1-dp2-tb16k-nockpt、r1-dp3-tb16k-nockpt、r1-dp3-inflight384)的叠加图,横轴为训练步数。各面板分别为:perf/step_s、reward、sample/rollout_queue_size、sample/staleness_mean。随着系列推进,单步耗时从 22.9 秒降至 4.8 秒,而奖励曲线几乎重合;最后一次运行的队列重新填满至 768 容量中的约 690,陈旧度稳定在 2。第 2 至 4 次运行在仪表盘给出答案后提前停止。
当有 384 个请求在处理时,每个副本分配 128 个。队列迅速填满至 768 容量中的约 690 并保持该水平。背压恢复至 5 秒,rollout 等待时间降至 0.03 秒。训练再次成为瓶颈!前向和反向传播耗时 4.6 秒,权重同步增加 1.5 秒的摊销开销,中位数单步耗时为 4.8 秒。
由于样本在更大的队列中等待时间更长,平均陈旧度从 1.5 升至 2.0 个版本。这仍低于 max_staleness=4,且 ratio 保持在非常接近 1.000 的水平。
成绩看板
| 500 步 | 第 1 次运行 r1-dp2 |
第 5 次运行 r1-dp3-inflight384 |
|---|---|---|
| 实际耗时 | 3 小时 27 分 | 53 分 |
perf/step_s,p50 |
22.9 秒 | 4.8 秒 |
perf/fwd_bwd_s,p50 |
21.9 秒 | 4.6 秒 |
perf/mfu_fwd_bwd |
3.9 % | 23.5 % |
batch/samples_per_step |
128 | 168 |
| 训练样本数 | 64,000 | 84,078 |
perf/weight_sync_s,p50 |
8.5 秒 | 6.2 秒 |
sample/staleness_mean |
1.5 | 2.0 |
| 奖励(前 20 步 → 后 20 步) | 0.145 → 0.438 | 0.145 → 0.416 |
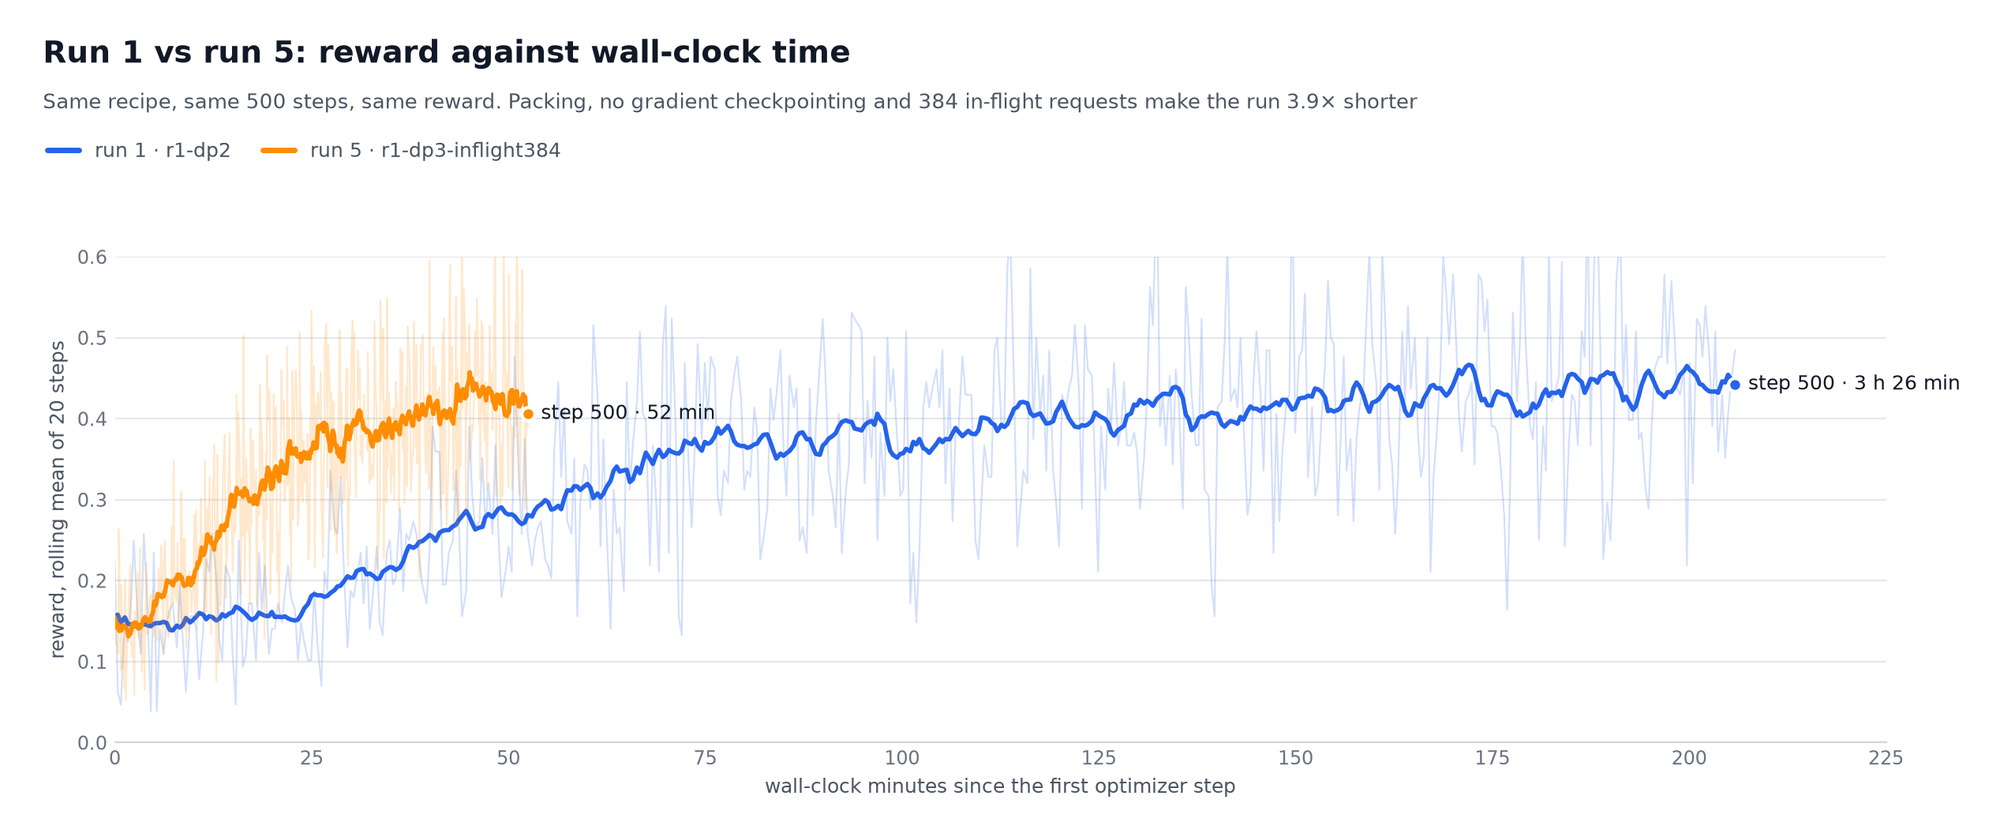
图 7. trackio 展示了 r1-dp2 和 r1-dp3-inflight384 的运行结果,横轴为自首个 optimizer step 起经过的墙钟时间,纵轴为 reward。两者采用相同配方、均为 500 步、最终 reward 也一致;但第 5 次运行仅耗时 52 分钟,而前一次需 3 小时 26 分钟。
最后一次运行速度提升了 3.9 倍,且多训练了 31% 的样本,但 reward 曲线基本保持一致。实现这一提升的关键在于:启用 packing、关闭 checkpointing 以及提高 in-flight 上限。在每种情况下,仪表盘都在最初 10 分钟内就清楚地呈现了这些差异。
试试看
git clone https://github.com/AmineDiro/hfjobs-lora-buckets && cd hfjobs-lora-buckets
hf auth login
MAX_STEPS=20 RUN_TAG=smoke ./run_all.sh --wait        # 约 15 分钟,三个 Jobs,完成后自动取消 server
MAX_STEPS=500 ./run_all.sh --wait                     # 运行 1:基准批处理形状,约 3.5 小时
TOKEN_BUDGET=16384 GRAD_ACCUM=6 GRADIENT_CHECKPOINTING=0 PROXY_LORA_RETRY_S=0.5 \
  MAX_INFLIGHT=384 QUEUE_MAXSIZE=768 MAX_STEPS=500 ./run_all.sh --wait   # 运行 5:相同配方,约 55 分钟
参考链接
- John Schulman 等人,LoRA Without Regret,Thinking Machines Lab,2025 年 9 月。论证了为何 rank-1 LoRA 在策略梯度 RL 中能与全量微调效果相当。
- TRL,
AsyncGRPOTrainer及其记录的 metrics。 - TRL PR #7017:为
AsyncGRPOTrainer增加 PEFT/LoRA 支持,配合基于 adapter-only 的 vLLM 同步,已发布于 TRL v1.14。 - Hugging Face Jobs 和 Storage Buckets;
hf-mount。 hf-mount-repro:用两个脚本复现 30 秒 negative-cache 卡顿。- 本文章所有运行的 trackio 仪表盘。
- Penghui Qi、Zichen Liu、Xiangxin Zhou、Tianyu Pang、Chao Du、Wee Sun Lee、Min Lin,Defeating the Training-Inference Mismatch via FP16,arXiv:2510.26788,2025。Sanity 数据集来源
sail/Sanity-Test-R1D-1.5B,LoRA 训练方案来源sail-sg/Precision-RL中的oat/scripts/lora/bf16_grpo_tis_lora.sh。
@article{qi2025precisionrl,
  title={Defeating the Training-Inference Mismatch via FP16},
  author={Qi, Penghui and Liu, Zichen and Zhou, Xiangxin and Pang, Tianyu and Du, Chao and Lee, Wee Sun and Lin, Min},
  journal={arXiv preprint arXiv:2510.26788},
  year={2025}
}