
一只AI蝴蝶的翅膀-AI大模型驱动半导体产业链的基本原理
AI大模型如何从一行代码,牵动整个半导体产业链?
你有没有想过一个问题:当你在对话框里敲下一句"帮我写一首诗",然后AI流畅地吐出几行文字——这中间到底发生了什么?
表面上看这是个软件问题。但如果把这条链路一直追到底,你会发现一件挺魔幻的事:从大模型的参数、GPU的算力、浮点数的编码方式、晶体管的制造工艺、光刻机的极紫外光源,一直到地球深处那些不起眼的稀土矿物——全都被一根看不见的线串在了一起。
在开始之前,先看一张全景图。下面这篇文章的整条主线就是沿着这张图从上往下走:
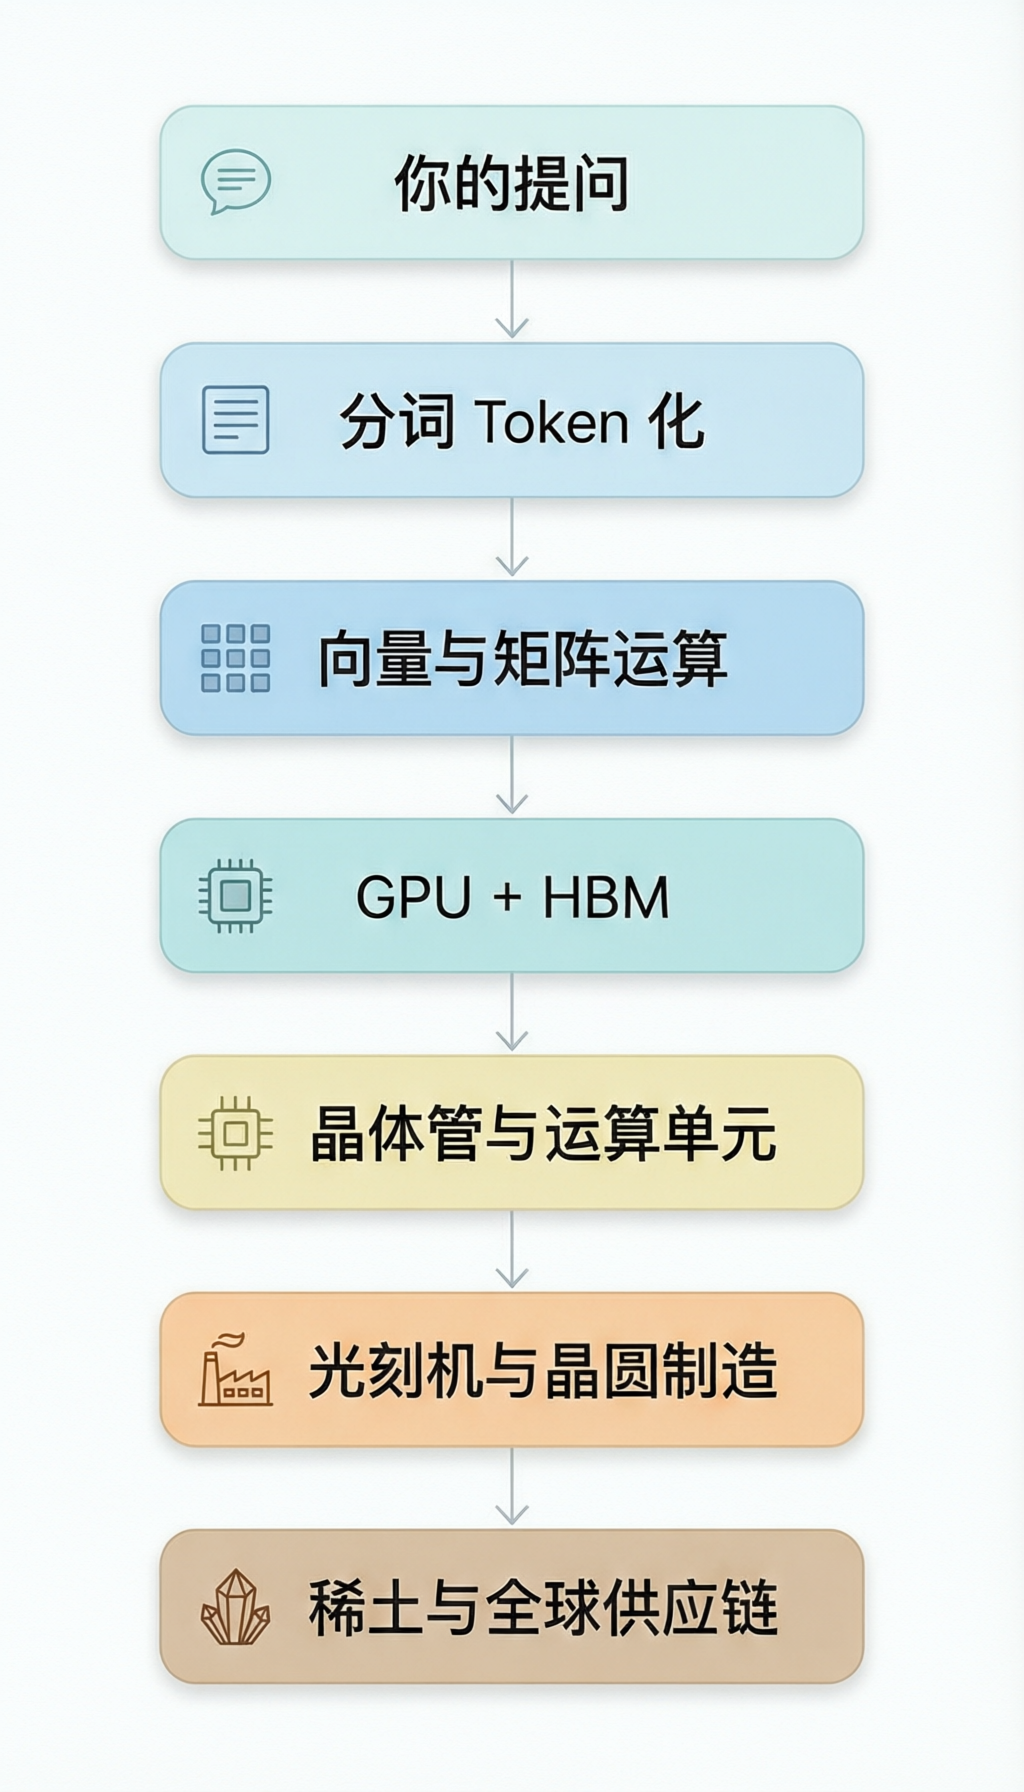
大模型到底在"算"什么?
大模型做的事情说起来很简单:给定一段前文,预测下一个词。就这么一件事。
但"预测"这个动作的代价,可能比你想象的大得多。
一个70亿参数的模型,内部有70亿个"权重值"——你可以理解成70亿个可以微调的旋钮。每个旋钮的值是一个小数,比如0.00342或-0.8761。这些数字是模型在训练阶段从海量数据里一点一点"学"出来的。
当你输入"今天天气"四个字,模型会经历这样一条链路:
第一步,分词。文字被切成token(词片段),比如"今天"是一个token,"天气"是另一个token。
第二步,向量化。每个token被映射成一个高维向量——你可以想象成一长串小数。比如一个简化的4维向量:
"今天" → [ 0.12, -0.87,  0.34,  0.56 ]
"天气" → [ 0.65,  0.21, -0.43,  0.78 ]
真实模型里这个向量有4096维甚至更多——每个维度都是一个浮点数,编码了这个词在不同语义维度上的信息。语义相近的词,向量之间的距离就近。"国王"和"女王"挨得近,"国王"和"苹果"离得远。
第三步,矩阵运算——这是真正的大头。向量进入模型后,要和权重矩阵做乘法。什么是矩阵乘法?来看一个极简的例子:
输入向量 (1×3)          权重矩阵 (3×3)              输出向量 (1×3)
                    ┌ 0.1  0.5  0.3 ┐

[ 0.2, 0.8, 0.1 ] × │ 0.4  0.2  0.7 │  =  [ 0.38, 0.28, 0.69 ]

                    └ 0.6  0.9  0.4 ┘
输出向量的第一个值 = 0.2×0.1 + 0.8×0.4 + 0.1×0.6 = 0.38。就这么一个数,就是3次乘法和2次加法。
真实模型里呢?一层Transformer的权重矩阵是4096×4096。一个4096维的向量和这个矩阵相乘,就是4096×4096 = 约1677万次乘加运算。而模型有几十层Transformer叠在一起,再算上注意力机制(每个token还要和其他所有token做交互),一次推理轻松达到数亿次运算。
这些运算的结果,经过一层层处理后,最终变成了一个概率分布——词汇表里每个token出现在"下一个位置"的概率。概率最高的那个token被选中,还原成文字,拼到原文后面。然后整个流程再来一遍,生成下下一个词。如此循环,就是你看到的AI"逐字生成"的效果。
📦 扩展阅读:那些小数是怎么存进计算机的?
模型里的每个参数、每个向量值,在计算机中都是以浮点数(Floating Point)形式存储的。浮点数就是计算机表示小数的标准方式,类似科学计数法,由符号位、指数位和尾数位三部分组成。
不同精度占用的存储空间不同:FP32用32个bit,精度最高但最费空间;FP16用16个bit,省一半但数值范围窄;BF16同样16位但把更多位分给指数,范围大、精度略低,是目前训练的主流选择。推理时越来越多地用FP8甚至INT8(8位整数)——反正参数不再更新,精度低点也能接受,关键是省显存、跑得快。
就这么一个精度选择的决策,直接决定了一款模型能不能跑得起来、成本多高。
📦 扩展阅读:概率分布是怎么变成文字的?
模型算完之后,会给词汇表里的每一个词打一个"分数"——分数越高,表示模型觉得这个词出现在下一个位置的可能性越大。你可以想象成一场投票:词汇表里有几万个候选词,每个词都有自己的得票数。
得票最多的那个词,当然最可能被选中。但如果每次都选第一名,输出的文字就会很死板、千篇一律。所以实际操作中会加入一点随机性——大致相当于"得票高的更容易被抽中,但不是绝对当选"。随机性的大小可以调:调小了,模型更严谨、更确定;调大了,输出更有创意、更有变化。你平时用AI时看到的"温度"(Temperature)设置,本质上就是在调这个随机性的大小。
到这里你应该已经感受到一个事实:一次看似简单的AI对话,背后是数亿次浮点运算。
那么问题来了——什么样的硬件,能扛住这种计算量?
什么样的硬件能扛住这种计算?
你可能会说:CPU不也能算数吗?凭什么非得用GPU?
这里的关键在于,大模型的运算有一个非常鲜明的特点——大量数据、相同操作、高度并行。前面那个矩阵乘法的例子还记得吗?输出向量的每个值都是独立计算的,彼此之间互不依赖。1677万次乘加运算,完全可以同时开工。
CPU和GPU的设计哲学截然不同。CPU像一个全能选手——每个核心都很"聪明",擅长处理复杂的逻辑判断、分支预测、异常处理。一块顶级CPU大约有几十个核心,操作系统、数据库、网络通信它都能应付。但面对大模型这种"简单但量大"的重复运算,几十个人怎么干得过几万人?
GPU走的是人海路线。一块NVIDIA H100上有超过16000个计算核心,单个核心不复杂,但上万个同时干活,吞吐能力惊人。H100的FP16算力接近1000 TFLOPS——每秒近千万亿次浮点运算。(烧掉的电费嘛,够买好几套房的。夸张了,但也差不多。)
📦 扩展阅读:CPU和GPU,到底差在哪?
用一张表来对比就很直观:
CPU(如AMD EPYC) GPU(如NVIDIA H100) 核心数量 几十到上百个 超过16000个 单核能力 极强(复杂逻辑、分支预测) 较弱(简单运算) 擅长任务 操作系统、数据库、网络 矩阵乘法、图形渲染 浮点算力 ~几十 TFLOPS ~1000 TFLOPS (FP16) 内存带宽 ~几十到一百多 GB/s ~3.35 TB/s (HBM3) 说白了,CPU是几个专家,GPU是一支万人施工队。大模型的活,需要的是施工队。
但光有算力还不够。这里有个很多人忽略的问题:内存带宽。
大模型推理时,每生成一个token都要把整个权重矩阵从显存搬到计算单元。一个70亿参数模型(FP16精度)约14GB——每吐一个字就要读14GB数据。如果内存带宽跟不上,GPU再快也只能干瞪眼等着。这就是业内说的"内存墙"。
所以HBM(High Bandwidth Memory,高带宽内存)成了刚需中的刚需。H100配备的HBM3显存带宽约3.35 TB/s,是普通DDR5内存的几十倍。高端AI芯片都在拼命堆HBM,原因很简单:算力再强,喂不饱数据也白搭。
这就是为什么2025年全球半导体市场规模预估达到7722亿美元(同比增长22.5%),其中AI芯片市场增速更是超过60%。整个产业的增长,很大程度上就是被大模型对GPU和HBM的饥渴需求推着走的。
好,到这里我们知道大模型需要GPU来做海量浮点运算。但一个新的问题浮出水面:GPU到底是怎么用物理器件完成这些运算的?那些小数、那些矩阵乘法,在硅片上是怎么实现的?
浮点运算在物理世界里是怎么发生的?
追到这一层,就从软件进入硬件了。
一切的起点是晶体管——一个极其微小的电子开关。给栅极加电压,电流通过,代表"1";断开,代表"0"。就这么简单。一块H100芯片上大约有800亿个这样的开关。(800亿个开关挤在一块芯片上,想想就觉得不可思议。)
把几个晶体管组合起来就是逻辑门——与门、或门、异或门。逻辑门再搭建成加法器和乘法器,芯片就有了算术能力。一个32位浮点乘法器,内部是成千上万个逻辑门按特定拓扑排列,电信号从输入端流入,经过层层门电路,输出端就得到乘积。整个过程在纳秒级完成,完全不需要软件参与——电路本身就是算法的物理实现。
回过头看那个矩阵乘法的例子——输出向量的第一个值0.38是怎么算出来的?在GPU内部,大致发生了这样的事:
0.2 和 0.1 送入浮点乘法器 → 得到 0.02

0.8 和 0.4 送入浮点乘法器 → 得到 0.32

0.1 和 0.6 送入浮点乘法器 → 得到 0.06

三个结果送入浮点加法器 → 0.02 + 0.32 + 0.06 = 0.40
每一步都是晶体管的开合。一个FP32数用32个存储单元保存,每个单元由几个晶体管构成。换成FP16只要16个单元——同样的芯片面积能塞更多参数,运算也更快。这就是为什么低精度格式在物理层面更省资源:本质上是少用了一半的开关。
而GPU之所以强,是因为它把绝大多数晶体管都用在了计算上。一块H100有132个SM(流处理器),每个SM里有大量浮点运算单元(FPU)。一条"做矩阵乘法"的指令被解码一次,同时发给上万个FPU并行执行。这就是SIMD架构——一个指挥官发令,上万士兵同时动手,各干各的那一份数据。
📦 扩展阅读:同样是存数据,GPU、HBM、硬盘用的完全不是一套路子
| 存储类型 | 用什么存 | 晶体管用量 | 断电丢数据? | 速度 | 典型容量 |
|---|---|---|---|---|---|
| GPU缓存(SRAM) | 6个晶体管存1bit | 非常多 | 是 | 最快 | 几十MB |
| HBM/内存(DRAM) | 1个晶体管+1个电容 | 较少 | 是(电容会漏电) | 很快 | 几十GB |
| SSD固态硬盘(Flash) | 浮栅晶体管,能"关住"电子 | 适中 | 不丢 | 快 | 几百GB~几TB |
| 机械硬盘(HDD) | 磁性材料,靠磁头翻转磁极 | 不用晶体管 | 不丢 | 最慢 | 几TB~几十TB |
这一点值得停下来想一想:你以为AI在"思考",其实它只是在几十亿个微小开关的开合之间,完成了一次又一次的乘法和加法。智能,是从这些开关的组合模式中"涌现"出来的。
那么问题来了:这些微小的开关,是怎么被造到芯片上去的?
几十亿个晶体管,怎么造到一块芯片上?
答案可能出乎你的意料——不是一个个造出来再组装的,而是像印刷报纸一样,一层一层"印"在硅晶圆上的。
原料是硅。硅从哪来?沙子。把沙子中的二氧化硅提纯到99.9999999%(行话叫"9N硅",九个9的纯度),拉成单晶硅棒,切成薄片,抛光到纳米级平整度,就是一块晶圆。
最关键的一步叫光刻——在晶圆表面涂一层光刻胶,然后用光刻机把电路图案投影上去。ASML的EUV光刻机用13.5纳米波长的极紫外光,穿过掩模版,经过精密透镜聚焦到晶圆上。显影后,电路图案就留在了晶圆表面。之后还有刻蚀(用等离子体精确刻掉多余材料)、掺杂(注入磷或硼改变硅的导电性)、沉积金属导线……这些步骤重复几十次,在晶圆表面构建出数十层三维结构的集成电路。
📦 扩展阅读:EUV光刻机到底有多离谱?
ASML的EUV光刻机,说实话是人类有史以来造出的最精密的机器之一。每台售价超过2亿美元,重约180吨,包含10万多个零件,全球独此一家能生产。
它的光源是怎么产生的?用高功率激光击打每秒滴落5万次的锡滴,产生高温等离子体,释放出13.5纳米的极紫外光。这个光还不能通过普通透镜传输(会被吸收),只能用多层反射镜在真空中引导和聚焦。整个系统的振动控制要达到原子级别。
2026年第二季度ASML单季营收93亿欧元,同比增长超过21%,订单已经排到2027年以后。这些数字本身就说明了一切:半导体制造的门槛,高到令人窒息。
到这里,整条链路已经从大模型的数学运算,一路追到了硅片上纳米级的晶体管结构。但故事还没完。还有一个问题,藏在这条链路的最深处——
光刻机也好,晶圆制造也好,有一种材料虽然用量极少,但一旦断了供,整条产线就得停。那就是稀土。
稀土在这条链里,扮演什么角色?
很多人以为芯片是用稀土做的。其实不是。晶体管的主要材料是硅,稀土在芯片成品里的含量极少。
但没有稀土,芯片根本造不出来。
晶圆每道工序之间都需要化学机械抛光(CMP),把表面磨到原子级平整。抛光液的核心磨料是二氧化铈(Ce)——铈是稀土元素。芯片缩小到45纳米以下后,传统二氧化硅栅极太薄会漏电,需要引入镧(La)等稀土元素调节界面特性。光刻机、刻蚀机里的精密电机和传感器大量使用钕铁硼永磁体——钕也是稀土。
稀土对芯片的意义不是"芯片里有很多稀土",而是"没有稀土就造不出芯片"。它们渗透在制造工艺的每个环节,是工业维生素一样的存在——用量不大,缺一种都不行。
而全球稀土冶炼分离产能,中国占了大约85%以上。即使其他国家有稀土矿,也往往需要送到中国来加工提纯。2025年中国进一步升级了稀土出口管制,全球芯片供应链为此高度紧张。这层关系在新闻里不太起眼,但它可能是芯片地缘政治中最关键的一环。
更重要的是,稀土的作用远不止半导体。新能源汽车的永磁电机、风力发电、军工装备、消费电子……几乎所有你能想到的高端制造业都绕不开它。AI大模型带动的不只是芯片需求,而是从算力到材料、从软件到矿物的整条工业链。
写在最后
从对话框里的一行字,到70亿个浮点数参数的矩阵运算,到上万个GPU核心的并行计算,到硅片上纳米级的晶体管,到ASML那台180吨重的光刻机,再到地底下那些不起眼的稀土矿。
这中间的每一环都紧密相连。
一只蝴蝶扇动翅膀,可以引发一场风暴。AI这只蝴蝶的翅膀,扇动的是整个半导体产业链——从最顶层的算法,一直到最底层的元素周期表。
下次看到"AI芯片卡脖子"或"稀土出口管制"的新闻,你可能会多一层直觉:这些事情不是孤立的,它们本来就是同一件事。