
10 秒视频,8.6 秒生成完:AI第一次跑赢播放器
先看一组数字。
一段 10.125 秒的视频,从提交请求到完整 MP4 文件落盘,用时 8.678 秒。5 秒的片子,4.396 秒交付;15 秒的片子,14.059 秒交付。
也就是说,视频还没播完,新的已经生成好了。
这不是首帧时间,也不是那种「先出个模糊预览」的流式交付,而是完整响应的就绪时间:画面、帧率、H.264 视频、32 kHz 立体声 AAC,全部齐活。
行业里衡量这件事有个专门的指标,叫 RTF,响应时间除以媒体时长。RTF 小于等于 1,才算实时。上面这三档,全部达标。
一、跑赢播放,为什么是个临界点过去两年,AI 视频的尴尬一直是:质量勉强追上了,速度远远没跟上。
生成一段十秒镜头,等几十秒到几分钟是常态。于是整个工作流天然是异步的:提交、等待、看结果、不满意再重来。创作者真正的瓶颈不是想象力,是等待。
而 RTF 一旦小于 1,形态就变了。等待消失之后,生成可以被嵌进实时流程:边播边生成、连续对话式修改、按需即时出片。
当生成快过播放,瓶颈就从机器转移到了人的判断力。二、难的不是模型,是整个系统这次实测来自 vLLM-Omni 团队,对象是 MiniMax H3:一个能同时吃文本、图像、视频、音频,并联合生成画面与同步声音的模型。
一个请求要穿过的环节长得吓人:先是 Qwen3-VL 编码器(BF16 下常驻约 51.5 GB 权重),然后是联合音视频的 DiT 去噪,接着是互相独立的视频 VAE 与音频 VAE,再跨设备与进程边界传输,最后封装成 MP4。
这带来一个容易被忽略的事实:只优化 DiT,其余环节的时延依旧留在那里。
所以真正有效的做法是全链路一起改:注意力与通信层减少结构性填充,算子层把归一化、旋转位置编码、激活函数逐个融合,解码层让视频 VAE 分块铺到八张卡上;输出侧先把 FP32 帧转成紧凑格式,一次传输负载直接少 75%;连封装都改成并行。
结果是完整响应时延比对照实现降低 30.8%,相当于 1.445 倍加速。而这一切是无损的:不靠量化、不靠稀疏注意力、不靠缓存复用、不靠减少去噪步数。
三、把 49 次,换成 4 次去噪周边的开销压完了,最大的那块还在原地:DiT 前向 49 次,合计 51.8 秒。
真正把速度推进实时区间的,是 FastVideo 基于 H3 蒸馏出的四步学生模型 FastH3:把 49 次前向换成 4 次,DiT 耗时从 51.8 秒降到 5.532 秒。
有个技术细节很能说明工程功底:FastH3 不是那种可以按请求随时切换的普通 LoRA 配件。除了低秩因子,它的产物还携带满秩的改动与替换权重,所以正确的做法是在权重分片之前先完成融合,而不是运行时挂载。
△ 49 次前向压到 4 次,这是速度反转的关键一步
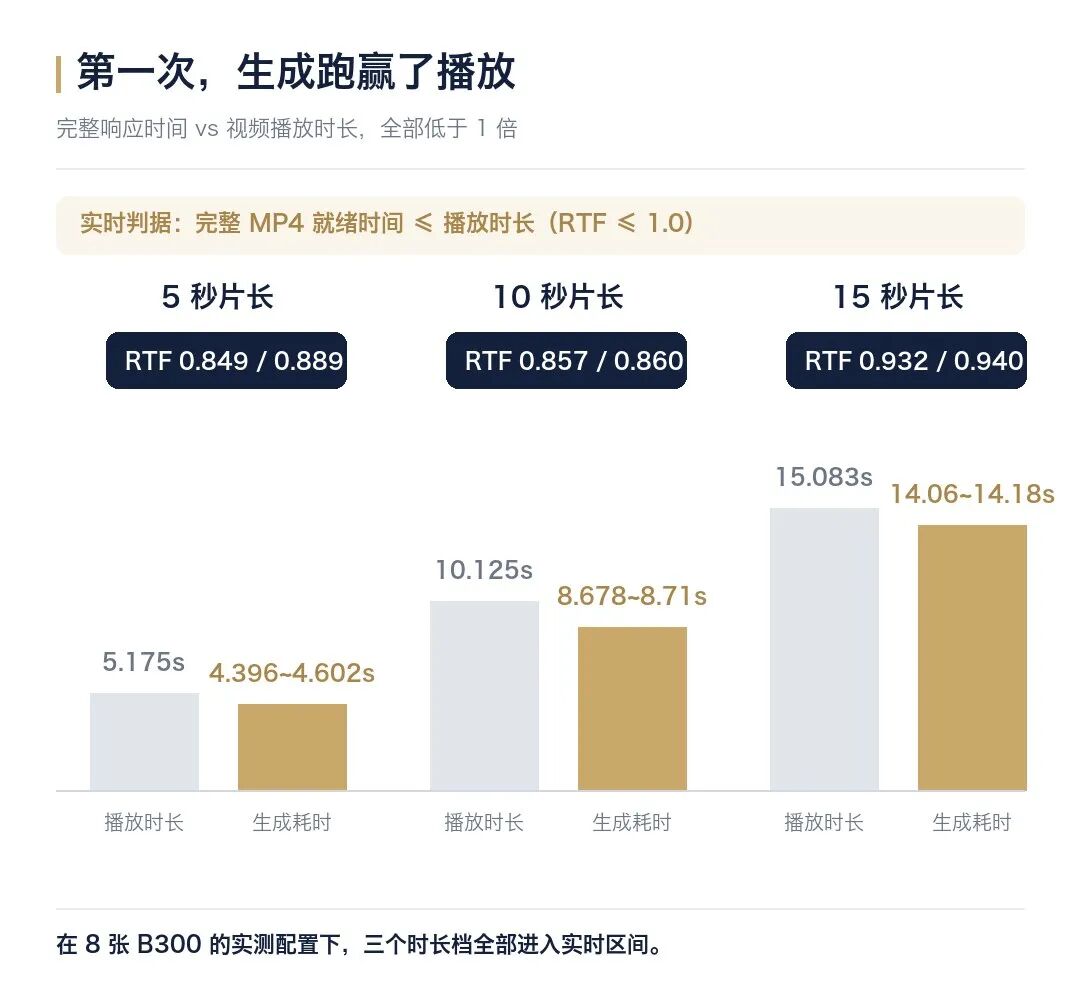
△ 三个时长档的生成耗时与播放时长对比,全部跑进实时区间
更值得记下的是下一步。砍掉最大的一块之后,剩下的每一段都会重新变成主角:这段 10 秒请求里,VAE 解码、设备传输与 MP4 封装合计又占掉约 3 秒。官方的下一步是把它们重叠起来,而不是逐个优化,乐观估计还能再省 0.87 到 1.75 秒。
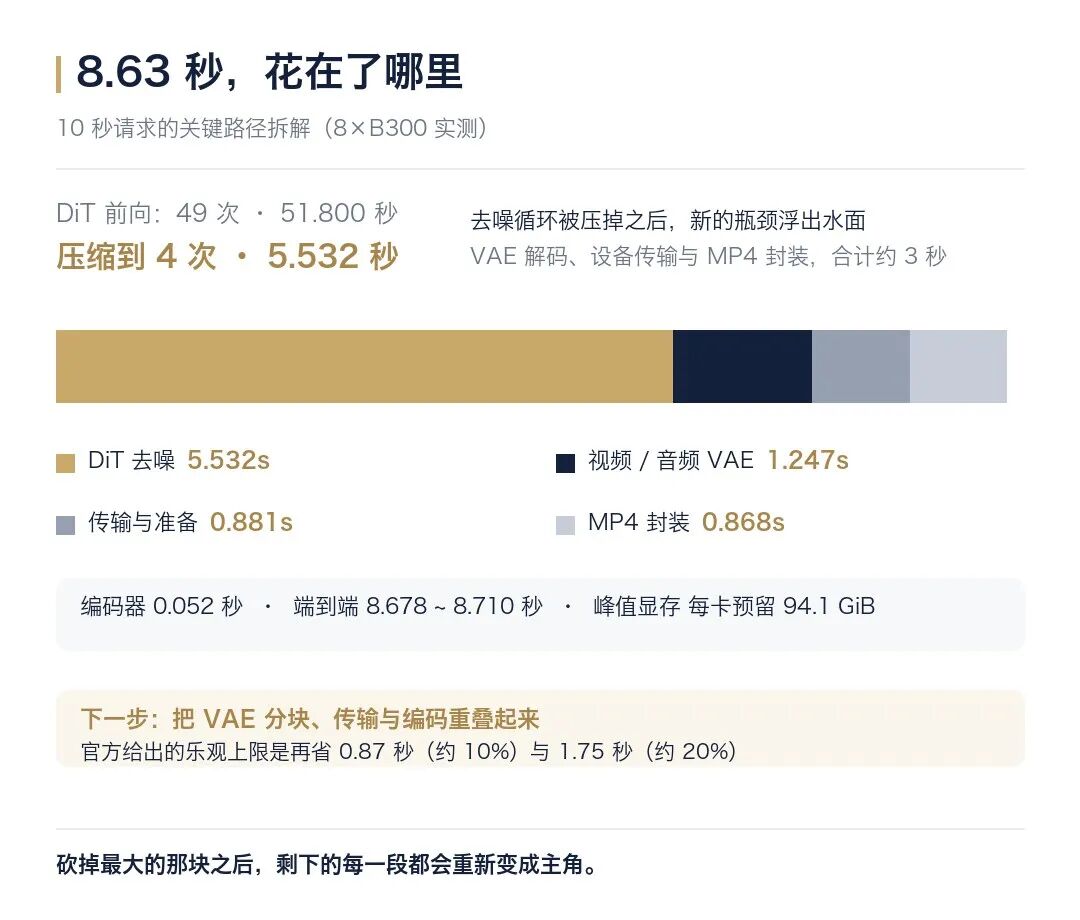
△ 8.63 秒花在了哪里:瓶颈会随着优化不断转移
四、三条捷径,三种代价除了把步子减少,还有几条更激进的捷径,而这份报告最难得的地方,是把每条捷径的代价一并写清楚了。
分布式逐层卸载:把大部分 DiT 层放进主机内存按需流式加载,显存占用降低 37.5%,代价是时延增加 5.1%。
在线 FP8 量化:加载时把符合条件的权重转成 FP8,峰值显存降低 38.9%,时延还顺带降了 5.3%。
SAGE 稀疏注意力:把注意力里的两条路径都量化到 FP8,时延降低 17.5%,但图像相对稠密基线出现 0.37 的 LPIPS 偏移,这是拿质量换速度。
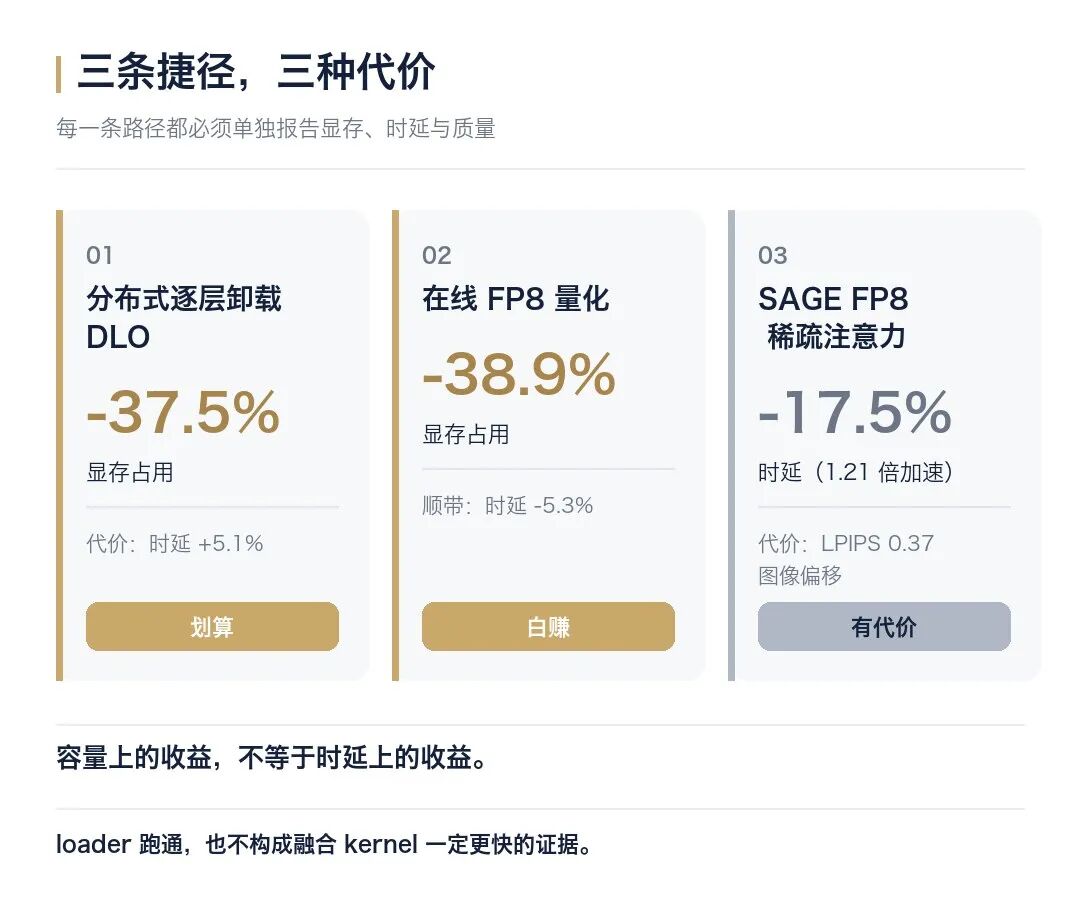
△ 容量上的收益,不等于时延上的收益
这张图的潜台词比数字更重要:省显存不等于省时间,跑通不等于更快。一个团队愿意把「这条路径有利、那条路径有损」分开讲,本身就是专业度的证明。
五、当生成快过播放,真正变的是什么聊到这,该把话题从机房拉回到人身上。三件事会跟着变。
第一,成本结构重写。单个镜头的等待从分钟级压到秒级,意味着试错次数会成倍上涨。内容行业的分水岭不再是「能不能做出来」,而是「敢不敢改二十遍」。
第二,创作被推成交互。工作流从「写脚本、渲染、看片」变成「边聊边改」。会用对话式工作流的人,和只会提交任务的人,产出效率会越拉越大。
第三,别把边界忘了。这组成绩的前提是 8 张 B300、专用的文生音视频任务、固定的产物版本;报告本身也明确写着,基础版与四步版本之间的质量等价性评估尚未完成。把工程结论当成通稿去讲,是这轮 AI 浪潮里最容易犯的错。
机器不再拖慢你的时候,你打算用它来做什么?三件事,现在就可以动手:
一、换指标。判断一个视频生成能力,别只看样片好不好看,去看它的完整响应时间和 RTF。样片决定能不能用,速度决定怎么用。
二、换工作流。把「提交、等待、重来」改成「对话式连续迭代」。省下来的时间不要用来提前收工,用来多改几轮,这是速度红利真正的兑现方式。
三、重算你的成本与定价。蒸馏加系统优化的组合拳,会把单位内容的生成成本持续压下去。按今天的成本报出去的价,明年可能就站不住了。
视频行业第一次,机器跑得比播放器还快。
接下来需要加速的,是我们自己的判断力。