
本地部署AI大模型记录[05]:给Hermes Agent装上"斜杠命令",从QQ发命令唤醒远程GPU服务器、拉起27B大模型,零token的远程运维
一、由头
我的前由文章记一个训了N轮的1.7B小模型,结果没派上用场的过程
讲述过欲训练小模型帮我在hermes agent主机操控服务器失败的历程,现在我已经折腾出新的远程操控GPU服务器的方法,在此记录一下心得。
首先老流程是这样的:
web方式登录阿里云主机 →从阿里云主机ssh 登录家里的hermes主机 → 从hermes主机唤醒gpu服务器→ 从从hermes主机ssh登录gpu服务器→ 启动llama server……
一套下来五六条命令,光操作登录都要做好几遍,而且不时还要看网速的脸色,经常这么操作就忒烦了 。
给hermes配置fallback小模型的想法失败后,我忽然想起hermes的cli界面有很多斜杠快捷命令:
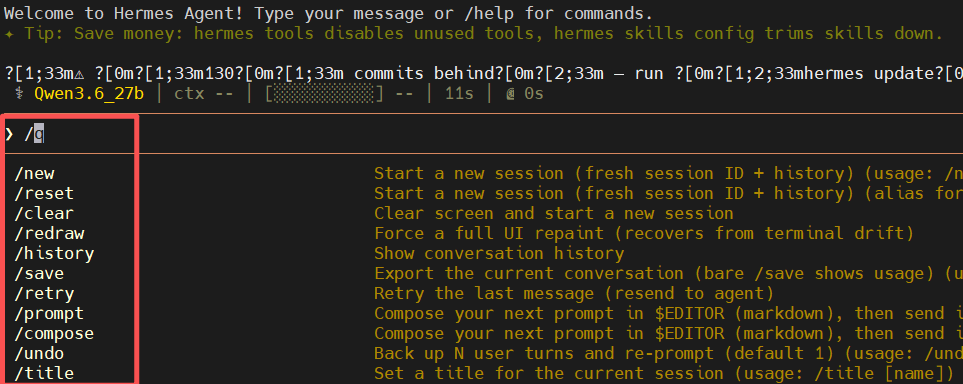
只要在cli命令行打个“/”,就可以拉出很多hermes自带的命令,完全可以不用大模型。直觉告诉我,应该可以定制扩展命令来远程操作我家庭网内的服务器。
二、背景:我到底在远程操作个啥
先给刚来的朋友交代下环境(本号老读者可以跳过这节):
| 项 | 值 |
|---|---|
| 主机 | 家里自组GPU大模型主机 |
| 显卡 | RTX 3090 24G+ A3000 Laptop 12G(跑 ComfyUI或其它) |
| 大模型 | llama-server,跑 Qwen3.8_27B-Q4量化版 |
| 穿透 | frp 0.67.0,68 上跑 frpc,家里笔记本上也跑一个 frpc |
| 日常 | GPU服务器关机省电,要用远程唤醒 |
以前每次"把机器整好",都是这么个流程:
1. 发现主机离线2. 手动发 WoL 魔术包(还得记得 MAC 地址 )
3. 干等 1~2 分钟,反复 ping
4. ssh 上去
5. cd 到启动脚本目录
6. nohup ./start_xxx.sh > log 2>&1 &
7. 等端口起来,27B 模型加载又要 2~3 分钟
8. 查看日志验证启动情况
三、Hermes方案:斜杠命令插件,绕过大模型
◆ 核心思路
Hermes 的插件可以注册斜杠命令(slash command)。这种命令由 gateway 直接分发执行,完全不经过大模型——零 token、零延迟、零幻觉。
QQ 机器人里发 /wakeonlan,gateway 收到后直接跑 Python 函数,发魔术包、ping 检测、返回结果。整个过程大模型连看都没看一眼。
◆ Hermes 的插件目录长这样
~/.hermes/plugins/
├── wakeonlan/        # 唤醒
│   ├── plugin.yaml
│   └── __init__.py
├── frpc/             # 拉穿透(68 + 本机两条命令)
│   ├── plugin.yaml
│   └── __init__.py
├── qwen/             # 起大模型
│   ├── plugin.yaml
│   └── __init__.py
└── ops68/            # 关机(两段式防误触)
    ├── plugin.yaml
    └── __init__.py
每个插件就两个文件。plugin.yaml 是清单:
name:wakeonlan
version:0.1.0
description:"hermes wakeup — send Wake-on-LAN magic packets to wake remote hosts."
author:wangxd
kind:standalone
platforms:
-linux
-macos
__init__.py 里实现 register(ctx),把命令注册进去。以唤醒为例,核心就这么点东西:
defregister(ctx) -> None:
    ctx.register_command(
        name="wakeonlan",
        handler=_slash_wakeonlan,
        description="WoL 唤醒 192.168.0.68 并 ping 检测联通,不走大模型",
        args_hint="[无需参数]",
    )
handler 就是个 async 函数:先 ping 一下,在线就回"无需唤醒";离线就发魔术包(优先用系统的 wakeonlan 命令,没有就用纯 Python 拼 1024 字节广播包),然后每 3 秒 ping 一次,最多等 120 秒,通了就回话。
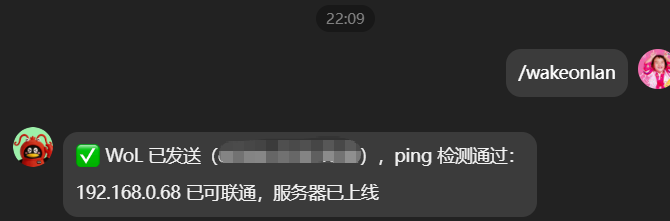
QQ 里发 /wakeonlan 后收到的"✅ 服务器可联通"回复
以上介绍的唤醒插件,全程我0代码,由hermes+qwen3.8 27b本地模型完成开发,配置,省心吧?
然后GPU服务器能远程唤醒,那接下来通过ssh就可以操控服务器上的软件了,很是方便。于是,我又让hermes按我之前的手工操作命令,把剩下的几个操作也做成插件命令的形式,如下:
◆ 四个命令,各管一摊
| 命令 | 干什么 | 防呆设计 |
|---|---|---|
/wakeonlan | WoL 唤醒 68,ping 检测联通 | 已在线则直接报告,不重复发包 |
/startqwen | 启动 27B 大模型(离线先自动唤醒) | 检测到端口在监听/模型加载中,不重复启动 |
/frpcstart68 | 在 68 上拉 frpc(离线先自动唤醒) | 已在运行则报 PID 收工 |
/frpcstartlocal | 在本机拉 frpc | 用 systemd 托管(后面细说) |
/shutdown68 | 关机 | 两段式:第一次只警告,发 /shutdown68 yes 才真关 |
关机命令那个hermes给我设计了两段式防止误关机:先发 /shutdown68 它只回一句"确认关机请发送 /shutdown68 yes,30 秒内不发送则什么都不做"。多个提醒,损失为零。
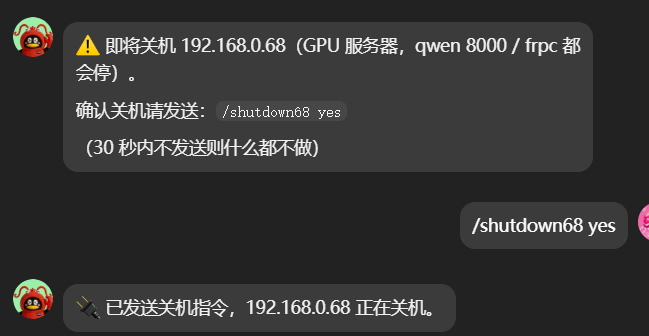
[/shutdown68 的警告回复 + /shutdown68 yes 的执行回复]
四、详细过程就不表了,hermes会自编码自检测自纠错
◆ hermes自翻车示例1:ssh 引号嵌套,脚本被静默丢弃(最隐蔽的一次)
/startqwen 启动大模型,命令长这样:
ssh adminwxd@192.168.0.68 'cd /home/adminwxd/llama.cpp/build/bin && ( setsid sh -c 'CUDA_VISIBLE_DEVICES=0 ./start_qwen38_27b_sgpu.sh' </dev/null >/tmp/qwen_start.log 2>&1 & )'
第一次跑:ssh 正常返回,日志文件生成了,但是空的。端口 8000 永不监听,llama-server 进程压根不存在。
后来才想明白:ssh 整条远程命令是用单引号包起来的,里面又套了一层单引号 sh -c 'VAR=0 ./script'——第一个内层单引号就把外层引号提前闭合了。远程实际执行的是:
sh -c VAR=0
纯赋值语句,静默成功,exit 0。脚本?被丢弃了。
现象就是那三样:无进程、空日志、端口永不监听。没有任何报错,因为每一步的退出码都是 0。
修复方法简单到我想笑——环境赋值根本不需要引号:
( setsid env CUDA_VISIBLE_DEVICES=0 ./start_qwen38_27b_sgpu.sh </dev/null >/tmp/qwen_start.log 2>&1 & )
env VAR=0 ./script,一个引号都不用,问题消失。
ssh 远程命令里整条单引号包裹时,内层绝不能再出现单引号。这种 bug 最毒的地方在于它不报错。
◆ hermes自调试自修正过程示例:frpc 起来了,gateway 一重启,没了
本机那个 frpc 一开始是用 ssh 式的方法直接后台拉起的,setsid 也用了,看着挺稳。
结果验证 gateway 更新重启,frpc 死了。
翻 gateway 源码找到了凶手:gateway/status.py 里有个 reap_gateway_children(),gateway 重启时会清掉自己进程树下的所有孤儿后代。setsid 只能脱离会话,脱离不了进程树——从 gateway 的 terminal 里拉起来的进程,全在它的树里,一锅端。
修复:本机 frpc 改用 systemd 托管:
systemd-run --user --unit=frpc-local2 \
  --working-directory=/home/wangxd/frp_0.67.0_linux_amd64 \
  /home/wangxd/frp_0.67.0_linux_amd64/frpc -c frpc.toml
systemd 拉起的进程不在 gateway 树里,重启免疫;崩了 systemd 还会自动拉起。日志看 journalctl --user -u frpc-local2。
顺带还有一个小坑:检测本机 frpc 在不在,不能用 pgrep -f 全路径——frpc 是用相对路径 ./frpc 启动的,命令行里压根没有全路径,-f 全路径匹配不到真进程,反而匹配到跑 pgrep 的 shell 自己。正确姿势:pgrep -x frpc 拿 PID,再读 /proc/<pid>/cwd 校验工作目录。
◆ 还有个差点翻车的:远程后台进程 ssh 挂住
68 上起 frpc 时,nohup 不够,单个 setsid 也不够——frpc 会继承 ssh 通道的文件描述符,ssh 挂住不返回,插件的 handler 直接卡死。
最后是用双重子 shell 解决的:
( setsid ./frpc -c frpc.toml </dev/null >/tmp/frpc.log 2>&1 & )
外面再套一层 ( ... & ),进程立刻被 reparent 给 init,什么都不持有 ssh 通道。这个写法四个插件里统一用。
五、结果:QQ 里一句话,全流程零 token
现在整个"把 68 整好"的流程,长这样:
我:/wakeonlan
Agent:✅ WoL 已发送(d8:bb:c1:58:19:f8),ping 检测通过:
       192.168.0.68 已可联通,服务器已上线

我:/startqwen
Agent:✅ qwen 已在 68 上启动,端口 8000 已监听
       启动日志: /tmp/qwen_start.log
       (27B 加载约 2.5 分钟,命令轮询等待,不用我盯着)

我:/frpcstart68
Agent:✅ frpc 已在 68 上启动
       日志: /tmp/frpc.log
◆ 数据说话
| 项 | 手动流程 | 斜杠命令 |
|---|---|---|
| 命令条数 | 6~8 条 | 1 条 |
| 耗时(不含模型加载) | ~10 分钟(含等、查、翻路径) | 自动,全程免盯 |
| 经过大模型? | 是(如果让 Agent 代劳) | 否,零 token |
| 出错面 | MAC 打错/引号/日志/重定向…… | 收在插件代码里,翻一次车修一次 |
| 防误触 | 无 | 关机两段式、重复启动自动跳过 |
关键不是"省了十分钟",是出错面从"人"转移到了"代码"。人敲命令会打错字、会忘参数、会在疲惫的时候复制错路径;Python 函数不会。翻车一次,把教训写进代码,下次就不会再翻。
而且这些命令 CLI、TUI、QQ 三个入口通用。晚上躺床上刷 QQ 把机器整好,这是以前不敢想的。
六、心得
俩句话:
- 确定性操作别走大模型。开关机、起服务、拉穿透这种流程固定的事,斜杠命令零 token 零延迟,大模型留给真正需要"动脑子"的活。
- 插件三件套缺一不可:目录里要有
plugin.yaml清单、__init__.py里要有register(ctx)、名字要加进config.yaml的plugins.enabled白名单——少一样都被静默跳过,不报错。