
Iris-mini 与 Iris-pro:同级最强开源权重搜索智能体
AllSpark 团队发布了 Iris-mini 和 Iris-pro 两款开源搜索智能体,并公开了完整的训练方案。论文称,这些训练数据不仅提升了搜索能力,还改善了模型在从未专门训练过的任务上的表现,包括通用工具使用和办公工作。
基于语言模型构建的搜索智能体能够自主进行网络检索。它们需要理解问题、决定搜索什么、解读结果,并判断已收集的证据是否足以给出答案。至于这些模型到底能自主完成多少工作,目前仍有争议。在既有基准测试中,这类领先的 AI 系统大多只是用网络来印证它们在训练中已经掌握的知识。
中国实验室 AllSpark 在一篇新论文中介绍了两个不同规模的搜索智能体:Iris-mini 拥有 350 亿参数,Iris-pro 拥有 3970 亿参数。两者均基于 Qwen 系列模型(Qwen3.6-35B-A3B 和 Qwen3.5-397B-A17B)构建,支持 256,000 token 的上下文窗口。据团队介绍,它们在各自参数量级的开源权重搜索智能体中取得了最强成绩。
从网页链接结构逆向生成训练问题
训练流程从网页的链接结构出发反向构建任务。系统以一个种子页面及其出站链接为起点,构建出一张由术语和关系组成的图,再基于这张图生成多步骤问题——回答这些问题需要串联多个相互关联的步骤。
除最终答案外,图中每个术语都会被改写成近义表达,从而杜绝通过简单文本搜索就能找到线索的可能。智能体必须真正推理,而不是简单查资料。只有那些参考模型在无工具时无法解决、但在获得正确来源后能够解决的问题,才会进入数据集。这保证了任务既有足够难度,又能清晰验证。
两阶段过滤淘汰低质量训练数据
更强的教师模型会生成由推理过程、搜索查询及其结果构成的解题路径。这些路径需经过两轮筛选。第一轮检查完整路径的准确性、是否存在重复循环以及搜索深度;根据论文描述,第二轮由裁判模型逐步审查,其评估标准并非人为设定,而是直接从数据中推导得出。
随后,模型通过对实时网络搜索进行强化学习来提升性能。裁判模型和结果摘要运行在训练集群内部,由团队自有的大型 Qwen 模型驱动,确保训练过程不依赖外部服务。监督微调和强化学习交替进行,这一过程被作者称为“SFT-RL 爬升”。每一轮中已解决的最困难任务及最高效的解题路径,都会反馈至下一轮训练循环。
上下文管理可能比模型差异更重要
团队认为,在常见基准测试中,运行时的上下文管理带来的影响,往往大于系统间报告的性能差距。在长时间的研究会话中,上下文可能在智能体解决所有子问题之前就已填满。诸如丢弃对话历史等技巧虽然能人为延长研究过程,却很少能反映模型的真实质量。
为隔离这一效应,团队在所有基准测试中分别测试了启用和禁用上下文管理两种情况,同时保持工具、上下文限制和裁判模型不变。仅报告启用管理时的结果,无法清晰区分哪些性能来自模型本身,哪些来自周围的基础设施。此外,Iris 的得分来自单一智能体,没有辅助智能体,最后也没有额外的验证步骤。
四项基准测试的结果
测试涵盖了 BrowseComp,用于测试从间接线索中发现罕见事实的能力;其中文对应版本 BrowseComp-ZH;DeepSearchQA,用于评估检索证据的完整性;以及Humanity's Last Exam,该测试提出专家级别的学术问题。
开启上下文管理后,根据论文数据,Iris-mini 在四项测试中的得分分别为 82.2、84.8、86.9 和 52.3;Iris-pro 则达到 88.6、85.1、92.9 和 56.4。在小型模型组中,Iris-mini 在四项基准测试里的三项占据领先,尤其在 BrowseComp 上以 3.4 分的优势超越次优模型 XYZ-Aquila-mini,仅在 DeepSearchQA 上稍逊一筹。作者指出,在大型模型组中,Iris-pro 始终保持领先或持平,部分场景下的表现甚至逼近那些需要更高算力支持的系统。
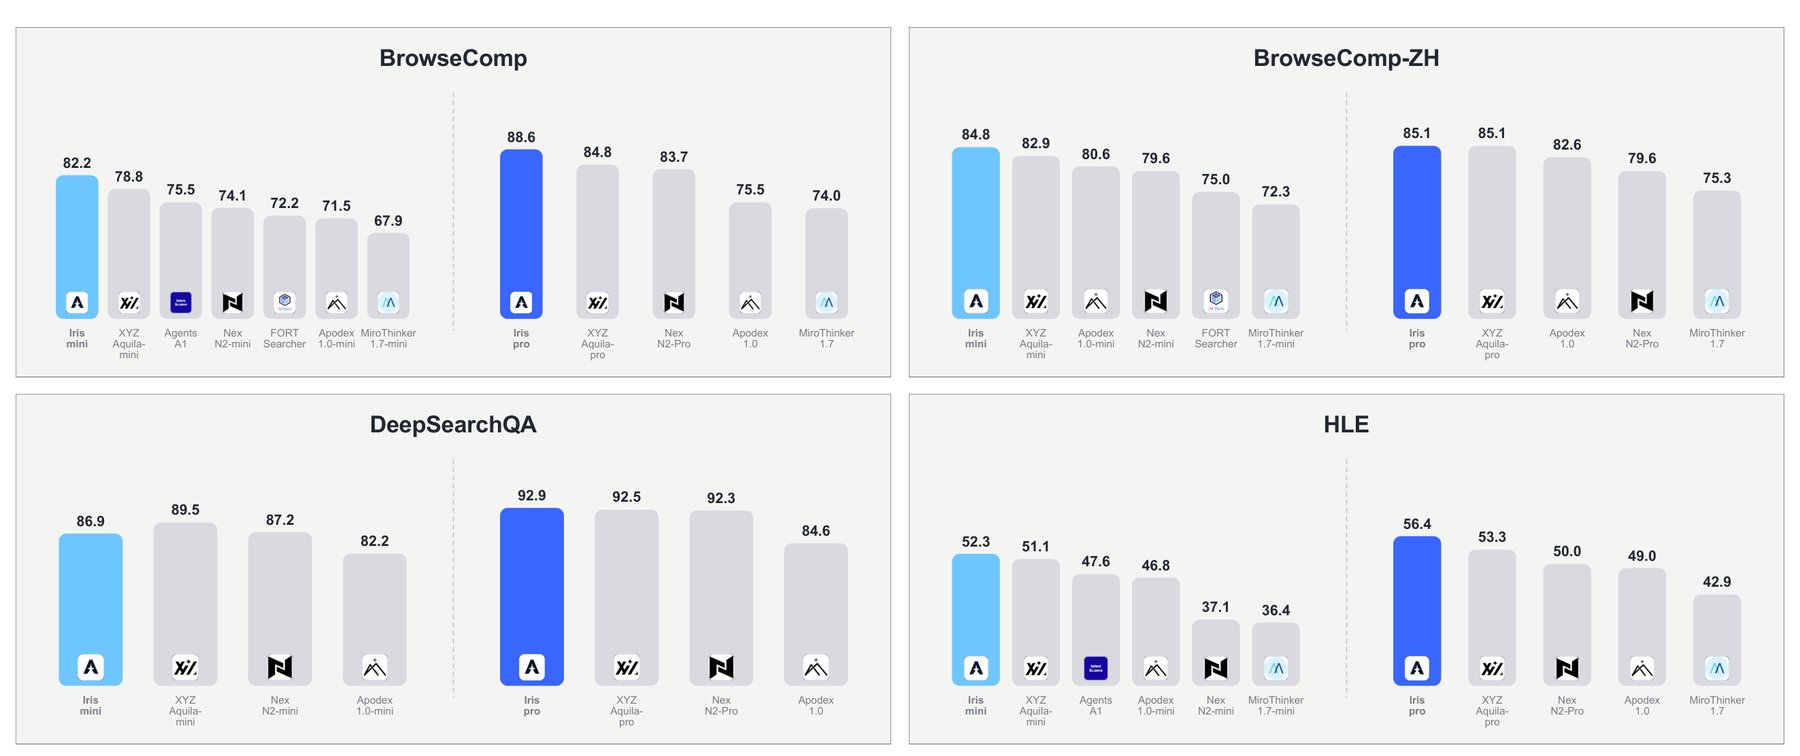
上下文管理对较小模型的影响更为显著,可将 BrowseComp 得分最高提升 21.2 分。论文解释称,原因并非 Token 预算变小,而是消耗速度更快。Iris-mini 完成相同任务需要更多步骤,因此更容易触及上下文长度限制。
在 Humanity's Last Exam 测试中,提升幅度相对较小,因为该基准更依赖领域知识和学术推理,网络搜索主要起辅助作用。最佳成绩通常来自结合“历史丢弃”策略与“二次尝试”机制:若首次尝试失败,系统会将其浓缩为简短笔记,记录已核实和排除的内容,并将该笔记附加到下一轮任务中。
当标准答案出错时
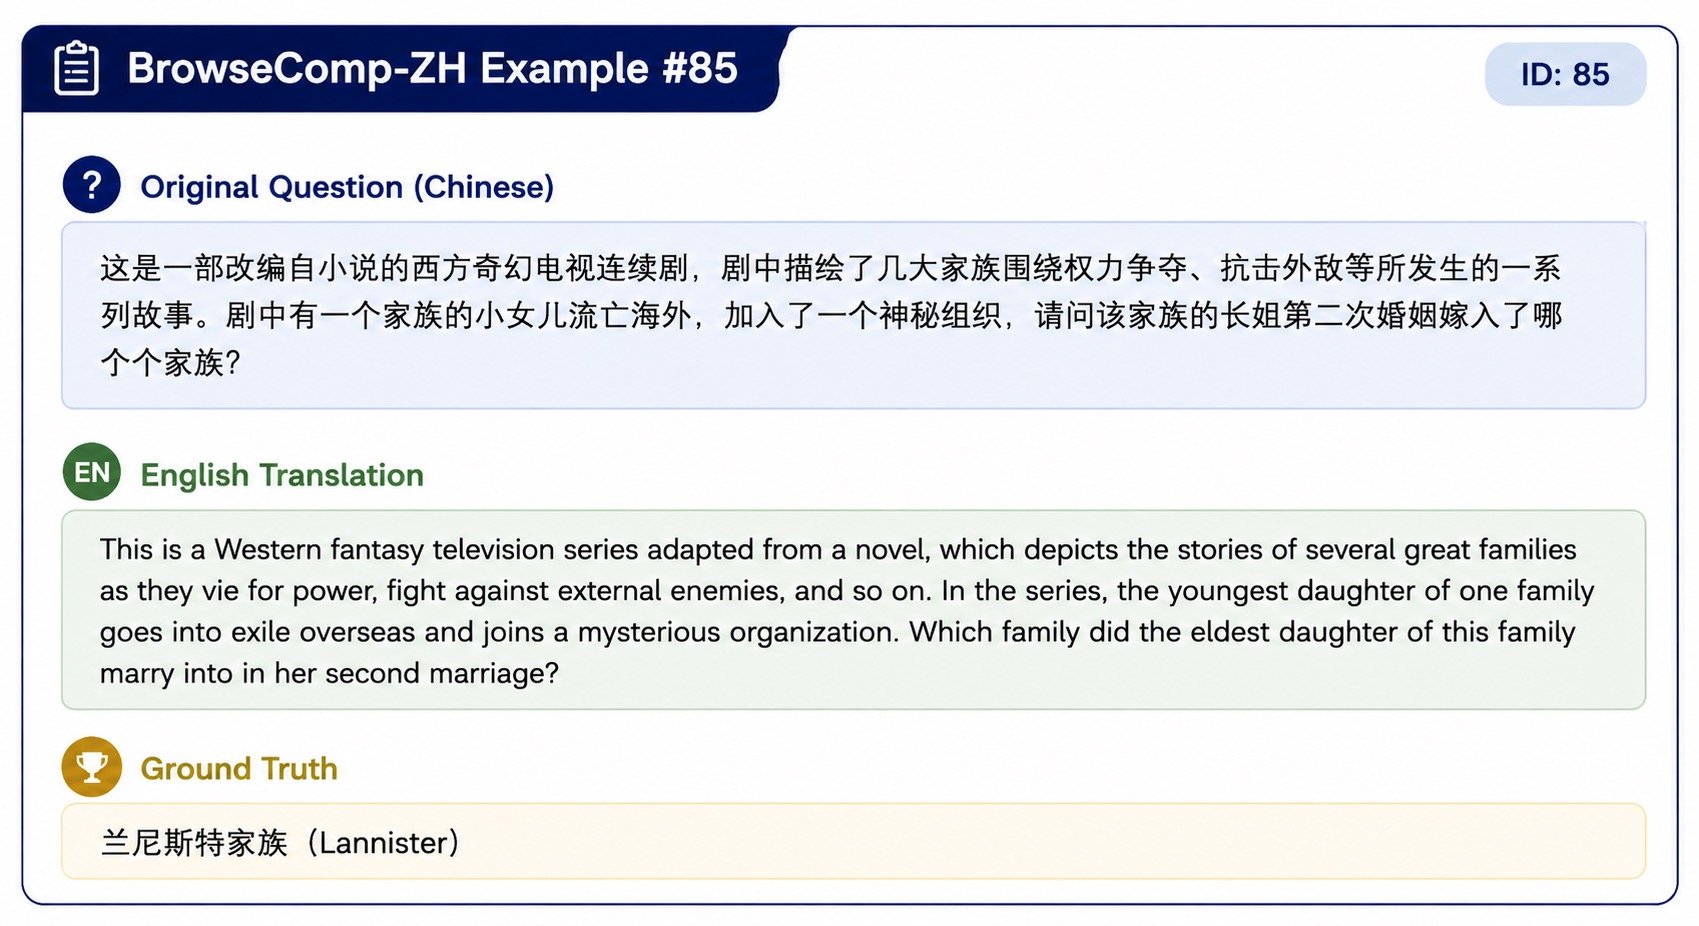
论文附录中,团队描述了一个案例:尽管代理的回答有源材料支持,却因与标准答案不符而被判为错误。BrowseComp-ZH 中的一道题目指向剧集《权力的游戏》。代理回答是“博顿”,而标准答案却是“兰尼斯特”。剧中角色珊莎·史塔克的第二次婚姻对象确实是兰姆松·博顿,代理的回答实际上是正确的。团队表示,这类标准答案与源材料之间的矛盾,正驱使他们致力于构建更优质的基准测试。
除了搜索之外,作者还发现了一个意想不到的副作用:无论是生成的训练数据还是专门训练的模型,都在一些从未训练过的任务上带来了性能提升,比如通用工具使用和办公任务。团队认为,搜索可能更像一种基础能力而非狭窄的专项技能——只要智能体需要在信息不完整的情况下工作,学到的行为就能派上用场。
Iris-mini 和 Iris-pro 的模型权重已在 Hugging Face 集合中发布,代码则在 GitHub 上。目前发布的内容包括 Iris Harness,其中包含智能体循环、工具、上下文管理策略,以及全部四个 benchmark 及其评估流程。该 harness 可对接任何 OpenAI 兼容的接口。数据构建和训练流水线会在之后陆续开源。