
【深入理解AIAgent】第01篇:别再把固定流程都叫智能体!——Agent核心公式与 ReAct 循环
【深入理解 AI Agent】第01篇:别再把固定流程都叫智能体!—— Agent 核心公式与 ReAct 循环
这是我们精读《深入理解 AI Agent》的第01篇。这次,我们想先搞清楚一个最基础、也最容易混淆的问题:接了大模型的工作流,到底算不算 Agent?
🔍 一、拖几个节点、接一个大模型,就算做出了 Agent?
在可视化平台上拖几个节点,接入一个大模型,再画上几条IF-ELSE分支,一个“AI Agent”似乎就完成了。演示时,它能提取工单、查询数据库、生成退款回复;流程图整整齐齐,每个节点都闪着“智能”的光。
但我们不妨放进一个明确的假设场景:用户突然说,“退货物流卡在杭州了,能不能先帮我催一下?如果今天能到,我就不退款了。”原来那条“识别问题→查订单→生成退款邮件”的固定路线,马上遇到了流程图里没有的新路口。
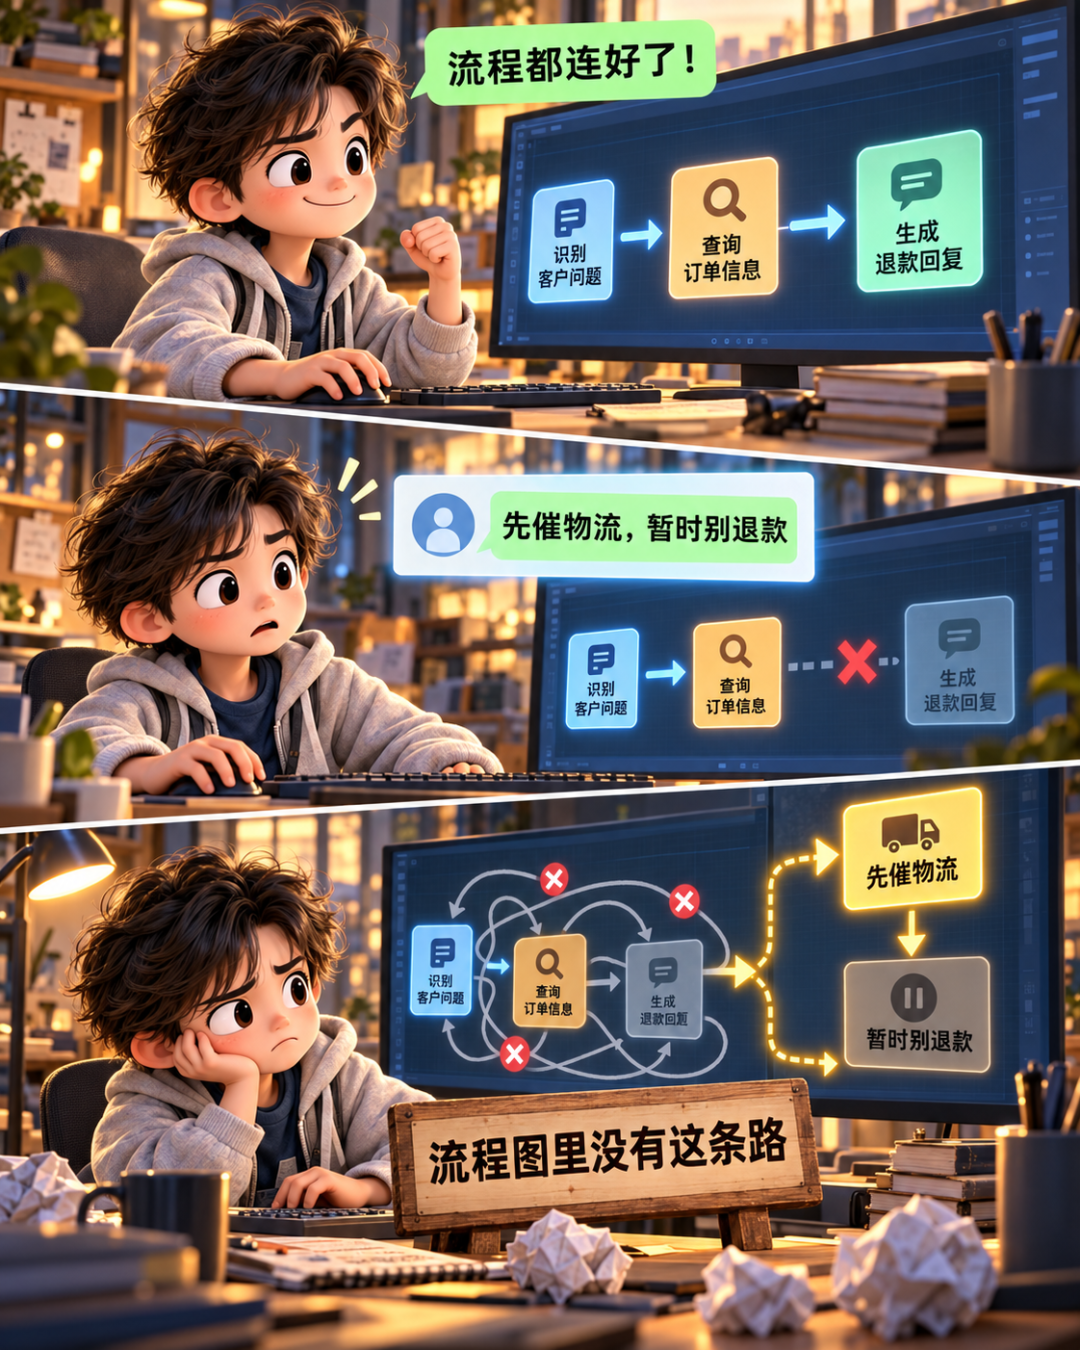
如果系统只能继续提取退款原因,或者走进预设的异常分支,它依然是一条大模型驱动的工作流。如果系统能够根据新情况先查物流、判断是否需要追问,再决定继续退款还是切换目标,它才表现出了自主 Agent 最关键的能力。
工作流像自动化流水线:每个工位做什么、下一站去哪儿,都在开机前确定。自主 Agent 更像被派到现场解决问题的特工:目标明确,但会根据现场反馈改变路线。两者都可能使用 LLM,真正的分水岭不是“有没有模型”,而是谁掌握下一步的决定权。
判断一个系统是不是自主 Agent,不能数它用了几个模型,而要看执行路径能否根据环境反馈动态变化。
🧠 二、先别急着背定义:把 Agent 想成一个刚入职的同事
原书给出了一个非常适合入门的公式:
Agent = LLM + 上下文 + 工具
我们可以先把它翻译成大白话:大脑 + 眼睛和工作台 + 手脚。
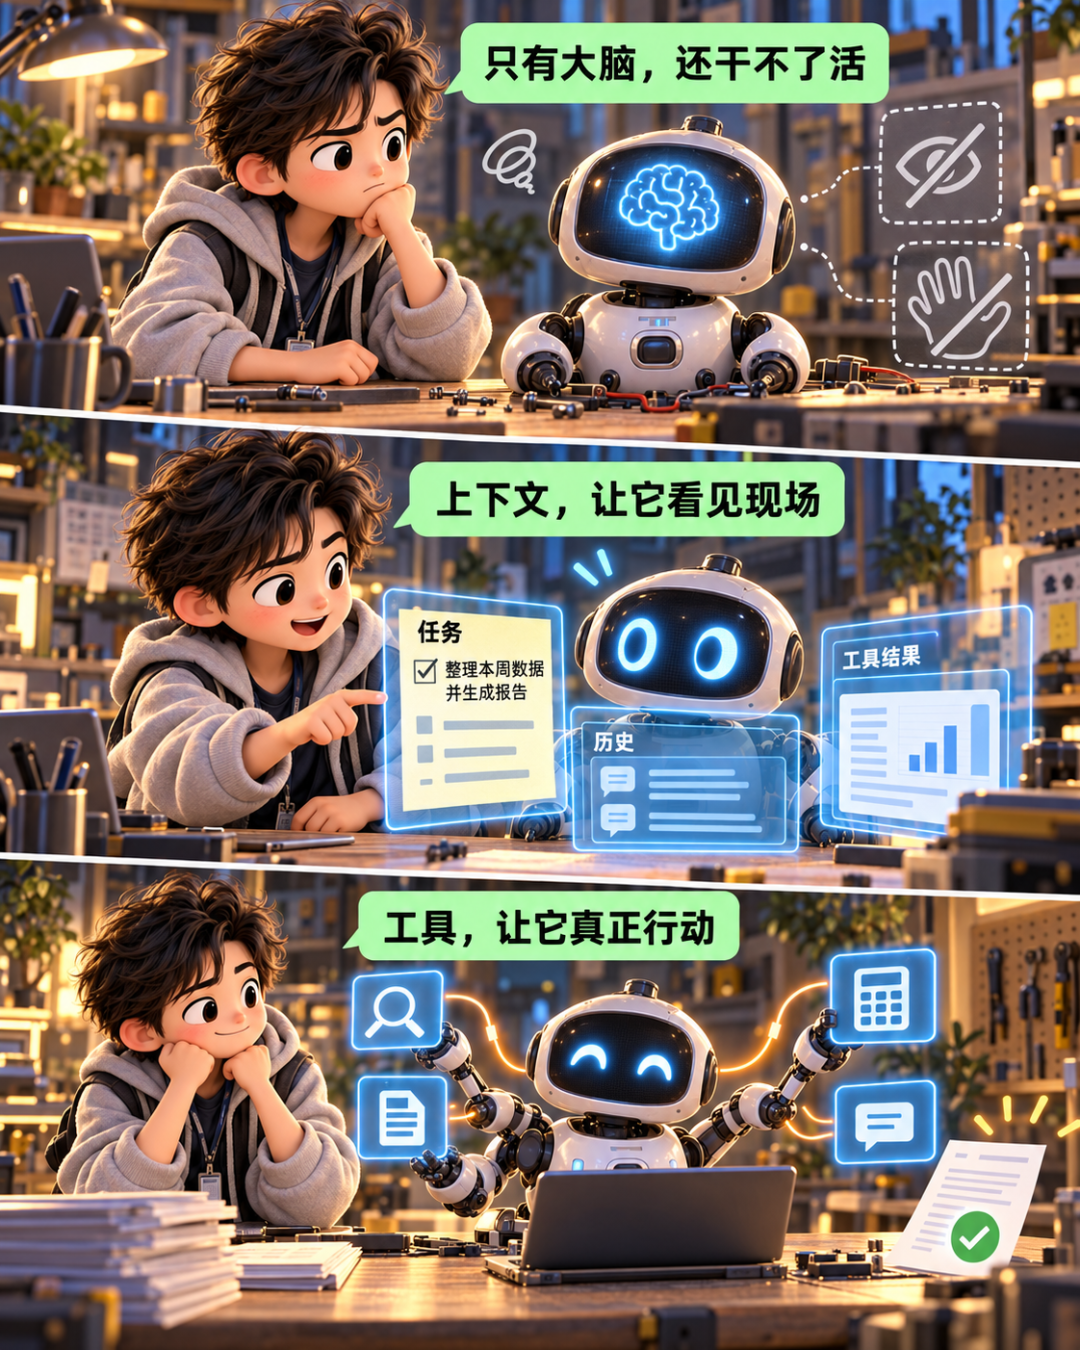
LLM 像大脑,负责理解目标、比较方案和选择下一步。它决定“现在应该做什么”,但只能输出文字或结构化指令。就像一个人脑子里已经想明白要查订单,如果没有任何操作接口,最后仍只能站在原地给建议。
上下文既像眼睛,也像摆在面前的工作台。用户说了什么、系统规定了什么、有哪些工具、上一步返回了什么、任务进行到哪里,都必须以某种形式进入上下文。没有进入上下文的信息,对模型来说不是“忘记了”,而是从来没有看见。
工具则是手脚。搜索、读文件、查数据库属于感知工具,让 Agent 看到外部信息;写文件、执行代码、发送消息属于行动工具,让 Agent 改变外部世界。模型输出一个 get_weather 调用,本身并没有查到天气,真正访问服务的是模型外部的程序。
这个比喻能帮助我们入门,但也有边界。上下文不只是人的眼睛,它还包含历史消息、记忆、工具说明和任务状态;工具也不只是执行动作,读取网页同样要通过工具完成。工程上更准确的说法是:上下文承载 Agent 当前可见的信息,工具定义 Agent 能够使用的观察和行动接口。
这里还要补上一个经常被忽略的角色:环境。文件、网页、数据库、用户和其他 Agent 都属于环境。Agent 执行动作后,环境状态发生变化,再把新的观察返回。环境不是 Agent 身体的一部分,而是它要持续打交道的外部世界。
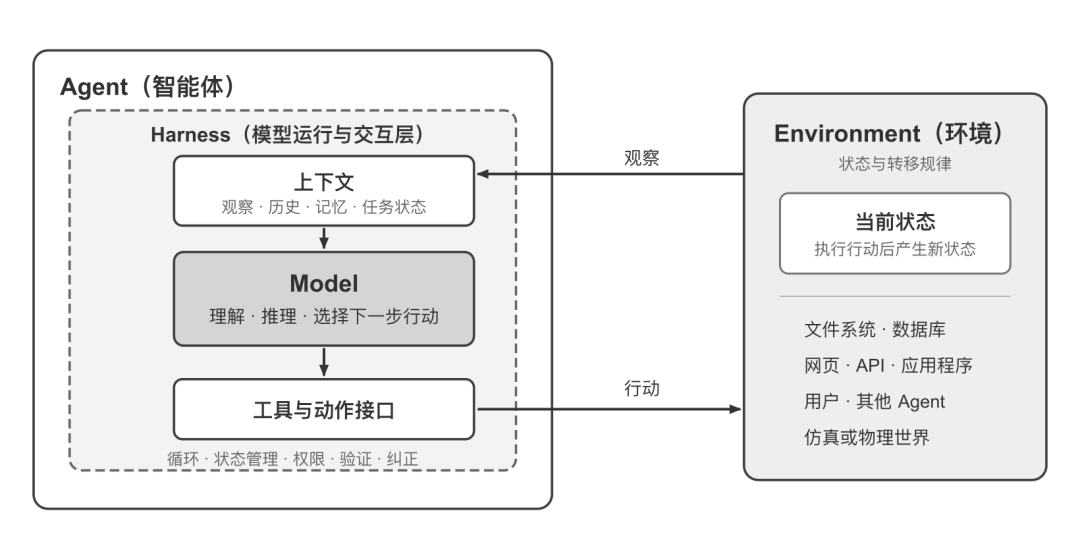
图中重点看左右两条箭头:环境把“观察”交给 Agent,Agent 通过工具发出“行动”。中间的 Model 只负责决策,真正维持上下文、执行工具和管理循环的是外围 Harness。
现在再看工作流与自主 Agent 就容易多了。工作流像自动化组装线:每个工位该拧哪颗螺丝,下一道工序送去哪儿,路径提前确定。自主 Agent 则像派到现场的特工:拿到目标和工具后,会根据新线索改变行动,但也可能绕路、误判甚至停不下来。
因此两者不是“落后”和“先进”的关系。付款、删除数据、生产发布等高风险步骤,更适合交给确定性工作流;搜索资料、排查故障等路径难以预知的任务,才值得把更多决定权交给 Agent。现实系统往往是混合结构,而不是二选一。
工作流解决的是“怎样稳定走完已知路线”,自主 Agent 解决的是“路线无法提前知道时,怎样边走边决定”。
⚙️ 三、Agent 真正运转起来,靠的是一条闭环
自主 Agent 的核心不是先写一份巨长计划,而是不断重复一个小循环:看一眼、想一想、动一下、再看一眼。这就是 ReAct,也就是 Reasoning 与 Acting 的组合。
这个循环留下的消息历史叫作轨迹。我们可以把它想成 Agent 执行任务时拍下的一卷“工作录像”:用户提出了什么、模型为什么行动、调用了哪个工具、环境返回了什么,都一格一格保留下来。下一轮决策不是凭空开始,而是站在上一轮的战果或废墟上继续。
第一步,Harness 把用户任务、系统约束、工具定义和已有历史整理成消息,交给模型。模型根据当前看到的信息做判断:已经可以回答,还是需要调用工具?如果需要工具,它会返回工具名称和参数,而不是亲自执行。
第二步,Harness 解析模型给出的调用请求,检查参数,然后找到对应工具。工具可能访问网页、计算汇率,也可能执行一段代码。执行完成后,Harness 把结果包装成一条新的 tool 消息,追加回上下文。
第三步,模型再次读取这份已经更新的上下文。它看到真实结果后,可能继续调用另一个工具,也可能发现之前的方向不对,调整计划。如果信息已经足够,它才输出最终答案。
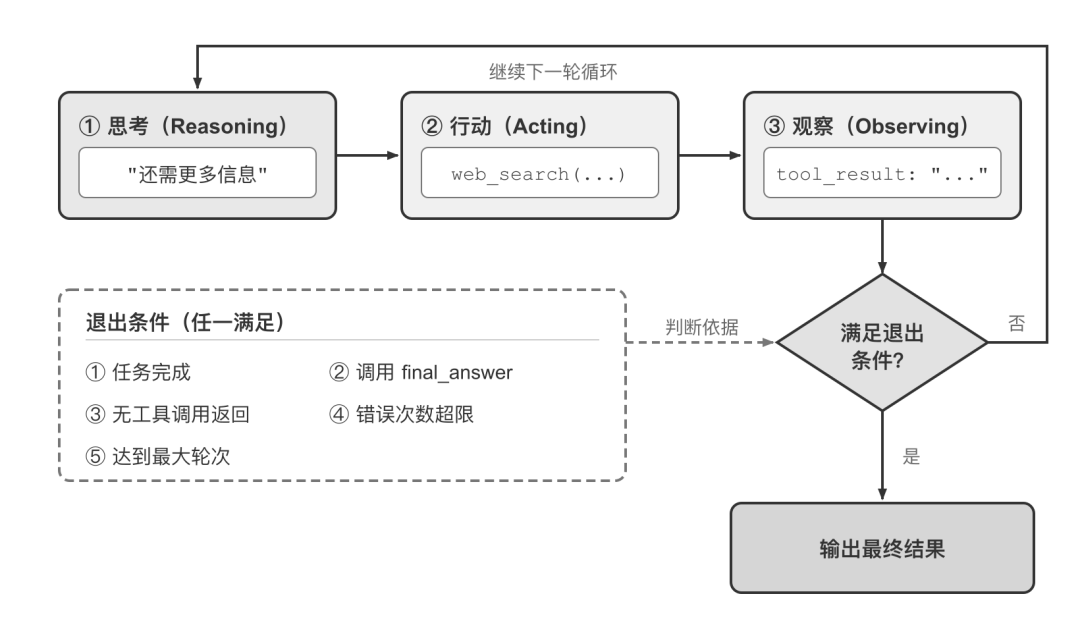
这张图最值得看的是“观察”之后的岔路:满足退出条件就输出结果,否则带着新观察进入下一轮。没有反馈箭头,只能算一次性生成;没有退出条件,循环就可能失控。
沿着项目里的 ContextAwareAgent.execute_task(),我们能看到这条闭环的真实骨架。下面不是凭空编写的教程代码,而是从该方法中删去日志、供应商兼容和异常细节后保留的最小结构:
while iteration < max_iterations:       # 给循环设置安全上限
    response = client.chat.completions.create(
        messages=messages,
        tools=tool_descriptions,
    )
    message = response.choices[0].message

    if not message.tool_calls:           # 模型决定给出最终文本
        final_answer = message.content
        break

    messages.append(message)             # 记录模型的工具请求
    for call in message.tool_calls:
        result = execute_tool(call)       # Harness真正执行工具
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(result),
        })                                # 把观察送回下一轮
这段代码揭示了一个很重要的事实:模型提出行动,Harness 执行行动;模型选择方向,循环程序控制边界。 如果模型返回普通文本且没有工具调用,循环结束;如果持续调用工具,则最多运行到 max_iterations,避免无限消耗。
工作流的控制权则主要在预定义代码中。比如“身份核验完成后才能支付”,可以被硬编码成不可跨越的顺序;自主 Agent 可以决定先查什么、再问谁,却不应该拥有绕开付款审批的自由。最实用的设计通常是:外围用工作流守住业务边界,边界内部让 Agent 动态探索。
ReAct 的技术本质不是“让模型多想几步”,而是让决策、行动和环境反馈形成可以反复校正的控制闭环。
💡 四、我们的实践心得与深水区避坑指南
本篇验证范围:L2(原理精读 + 源码追踪 + 仓库证据复核)。我们精读了原书第一章,追踪了
chapter1/context/agent.py的核心循环,并复核了实验1-1的真实模型运行记录;这些是项目已有证据,不是我们的独立复现。
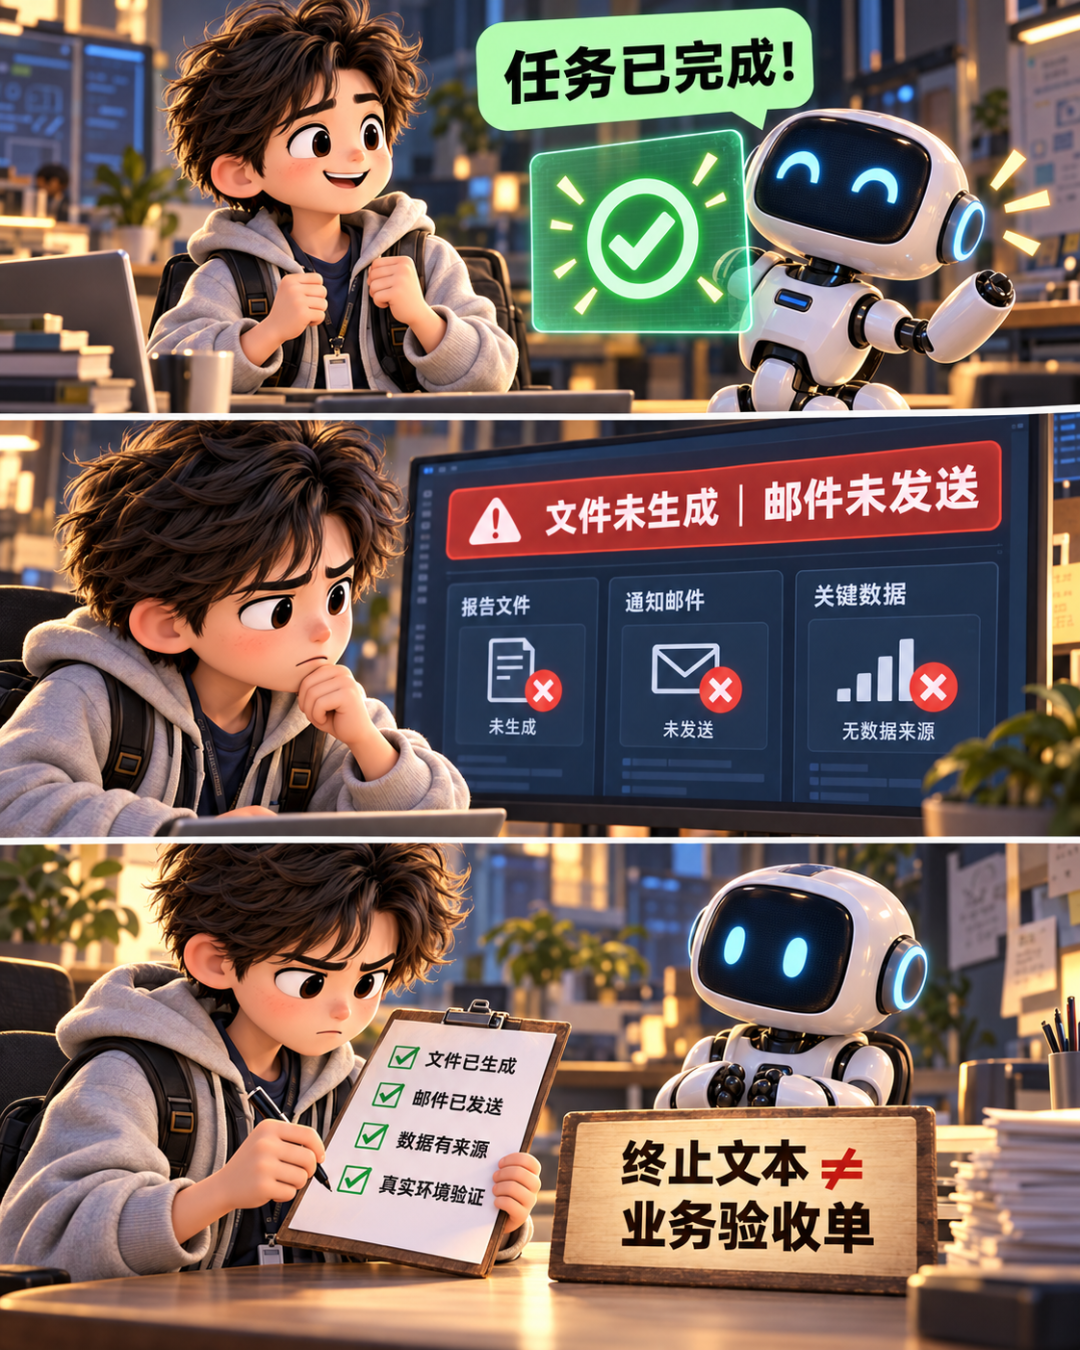
⚠️ 陷阱一:“模型给出了漂亮答案” ≠ “任务真实完成了”
模型返回函数名和JSON参数,只代表它提出了工具调用请求;真正执行工具、记录结果和处理异常的是外部程序。即使模型给出流畅的最终回答,也不代表文件已经生成、邮件已经发送或数字已经算对。
仓库实验1-1中,完整上下文组在3轮内得到正确结果;仓库当前保存的一次无工具组运行虽然很快结束,却给出了缺少工具观察支撑的数字。其他模型也可能拒答,不能概括成“模型通常都会编造”,但至少说明:终止文本不是业务验收单。
避坑心法:把“模型已经停下”与“任务已经成功”分开记录。关键数字回溯工具结果,外部动作读取真实状态,不能只检查模型有没有说“完成”。
⚠️ 陷阱二:工具报错后,ReAct 可能陷入“死循环鬼打墙”
工具失败不可怕,可怕的是模型看见错误后仍重复同一动作。如果只返回“请求失败”,模型不知道该改格式、补参数还是更换工具,很容易持续消耗轮次和 Token。
实验1-1展示了相近的鬼打墙:历史被移除或工具结果被隐藏时,模型在当前5轮上限内都没有形成终止答案。表现依赖模型和任务,但机制很清楚——下一轮看不到有用的新观察,循环就失去了纠错依据。
实操技巧:错误信息要明确预期格式并给出合法示例;循环设置最大轮次,检测相同工具和参数的重复调用,连续失败后换策略或转人工。
⚠️ 陷阱三:Agent 会过早宣布胜利(Early Completion)
项目源码专门区分 completed 与 task_success:前者表示模型给出终止文本,后者才依据任务规则判断结果是否正确。这两个字段的差别,正是 Agent 常见的可靠性漏洞。
调研 Agent 只搜索一家就开始“综合对比”,编程 Agent 改完文件却没跑测试,退款 Agent 生成邮件却没确认发送——它们都能自然结束循环,却没有真正完成目标。
设计模式升华:关键任务不能完全由执行者裁定是否完工。原书后续多次使用提议者—审核者模式:一个 Agent 执行,另一个角色根据目标和证据独立验收;简单任务也至少需要确定性验证器和完成清单。
所以设计系统时先问三遍:路径真的无法提前确定吗?动态决策收益是否大于额外成本?哪些边界必须交给确定性代码?
我们把选择方法压缩成一张表:
| 任务特征 | 优先选择 |
|---|---|
| 步骤固定、规则严格、风险高 | 工作流 |
| 路径未知、需要搜索和试错 | 自主 Agent |
| 外围规则固定、内部处理灵活 | 工作流 + Agent 混合 |
| 一次模型调用已经能解决 | 不要为了“Agent”而上Agent |
真正成熟的系统不是把所有决定都交给模型,而是把该固定的边界固定住,把必须随机应变的空间留给 Agent。
📌 五、总结与课后思考
最后,我们用一句话凝练这次精读后的核心判断:
工作流负责把已知的事做稳,ReAct 负责在未知中找路;真正可靠的 Agent,知道什么时候该用哪一种。
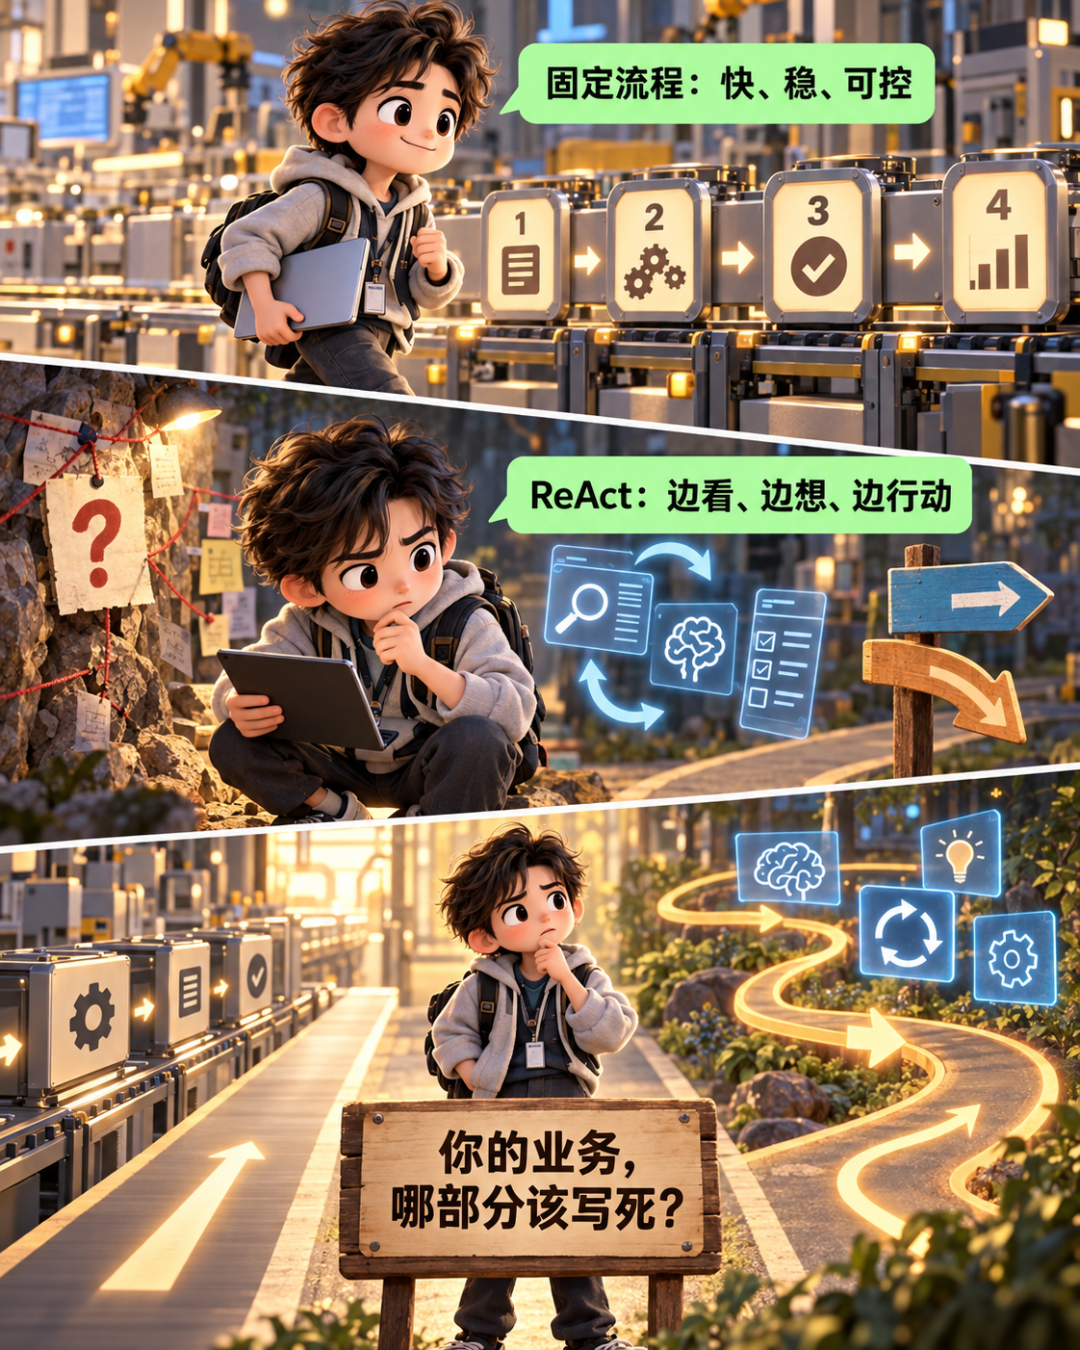
在你的真实业务或日常开发中: 有哪些场景其实用确定性的 Workflow就能搞定得又快又稳?又有哪一类边界模糊、多步博弈的场景,是非 ReAct 智能体不可的?欢迎留言聊聊你的观察与困惑!
下一篇,我们会继续追问:Agent 已经有了大脑、眼睛和手脚,为什么一个很聪明的模型仍然会把任务做砸?答案藏在模型外面的 Harness 里。
📌 专栏导航与版权说明
本文属于《深入理解 AI Agent 实战解读》系列。本系列记录我们精读和实践《深入理解 AI Agent:设计原理与工程实践》的过程。我们尽量用自己的语言解释原理,并明确区分源码阅读、证据复核与独立复现。
- 原书与实验仓库:https://github.com/bojieli/ai-agent-book[1]
- 在线阅读:https://bojieli.github.io/ai-agent-book/[2]
- 开源许可:Apache License 2.0
感谢李博杰老师及项目贡献者开放书稿、配图和配套实验。本文不是原项目的官方解读;涉及实验数量和项目状态时,以发布前核实的当前仓库为准。
我们会继续从评论中的真实场景里寻找问题。下一篇,一起拆开模型外面的 Harness。
参考链接
- https://github.com/bojieli/ai-agent-book: https://github.com/bojieli/ai-agent-book
- https://bojieli.github.io/ai-agent-book/: https://bojieli.github.io/ai-agent-book/