
从晶圆出片到首个 Token:利用 Nemotron 与 Palantir Foundry 将供应链专业知识代码化
NVIDIA 拥有全球规模最大、最复杂的供应链之一,其绩效从晶圆出片一直追踪到首个 Token 生成。这一过程分为两个阶段:Time-to-rack(上架时间)涵盖从硅片离开晶圆厂,到组装完成的系统抵达数据中心机房;Time-to-token(Token 生成时间)则包含此后的一切环节:供电、冷却、网络,以及让基础设施在第一天就能投入生产的软件栈。
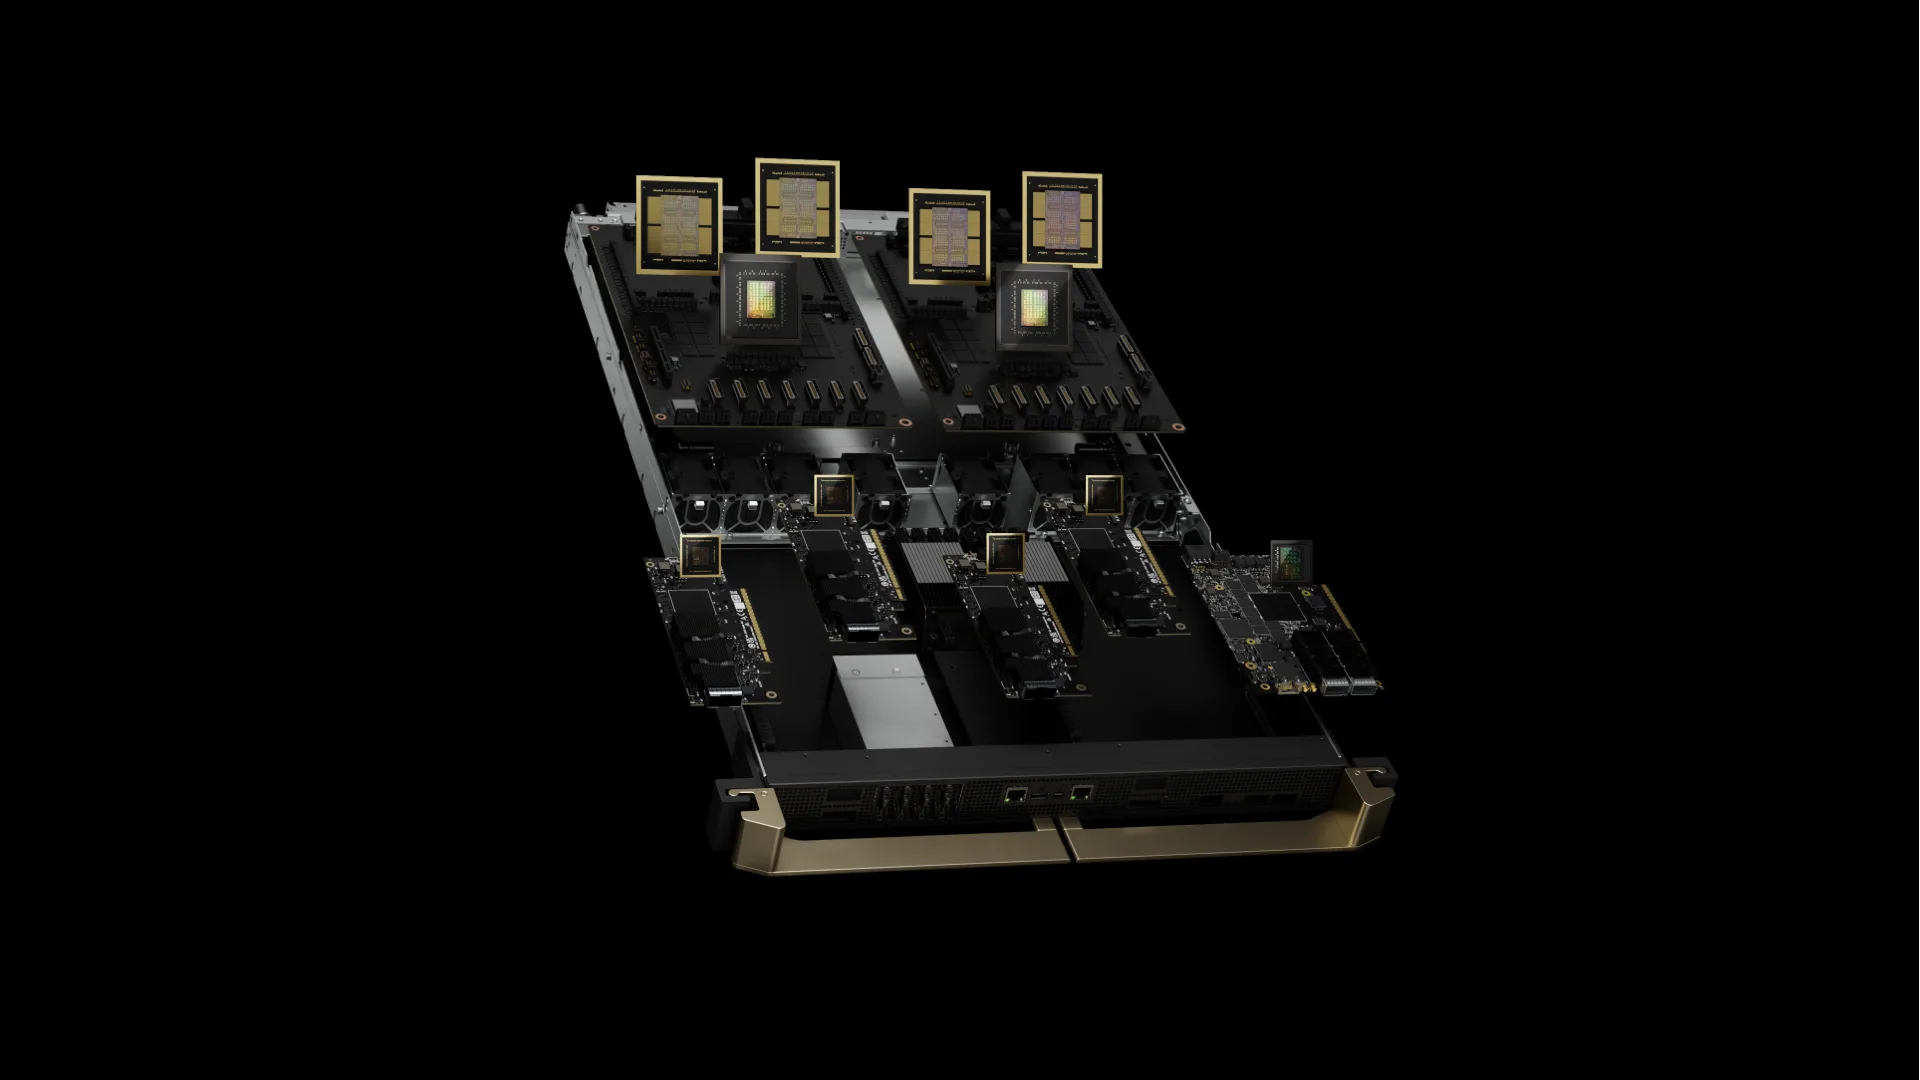
NVIDIA Grace Blackwell NVL72 平台使用了数百万个零部件,供应商遍布全球,最终系统由数十家 OEM 和 ODM 负责组装。仅一个计算托盘——单台机架中的 18 个之一——就需要 2 颗 NVIDIA Grace CPU、4 颗 NVIDIA Blackwell GPU 和 32 组 HBM3e 内存堆栈。我们为 Vera Rubin 打造的供应链规模是 Grace Blackwell 的两倍。CPU、GPU 和内存都是关键组件,且其库存状况每周都在变化,因此本周卡住生产的零部件,下周可能就供应充足。每个组件都有其独立的物料清单、供应商和交期。将这些因素乘以期机架内的每个子装配体,结果看起来就不像供应链,而更像一道令人望而生畏的组合数学题。
在来自三个来源池的所有组件到齐之前,合同制造商无法开始组装:NVIDIA 直供件、NVIDIA 寄售库存件,以及供应商直供件。理想情况下,所有组件同时到达,但现实往往是早到的部件不得不等待迟到的部分。NVIDIA 从制造站点收到物料的那一刻起就开始计时,直到物料作为子装配体或成品离开站点,这一指标被称为 Time of Ownership(TOO,所有权周期时间)。
面对高度动态的库存状况,NVIDIA 必须决定向每个制造站点分配什么物料以及分配多少。这就是关键物料分配问题,每周都需要人工重新调整。分配计划覆盖当前季度和下一个季度,最近几周的需求已经锁定,因此每周的新数据主要影响的是更远期安排。
本文主要关注 Time-to-rack,压缩它需要做到四件事:
- 实时可视化,随时定位关键运营瓶颈
- 冗余备份,避免单点故障导致生产停摆
- 高可靠性,确保上游生产承诺得以兑现
- 将人类专家经验代码化,让复杂分配决策背后的判断沉淀为可持续积累的知识资产
前三项要求提供了必要的运营基础,而人类专家经验的代码化才是带来最大变革的关键。
在 Palantir Foundry 中构建供应链指挥中心
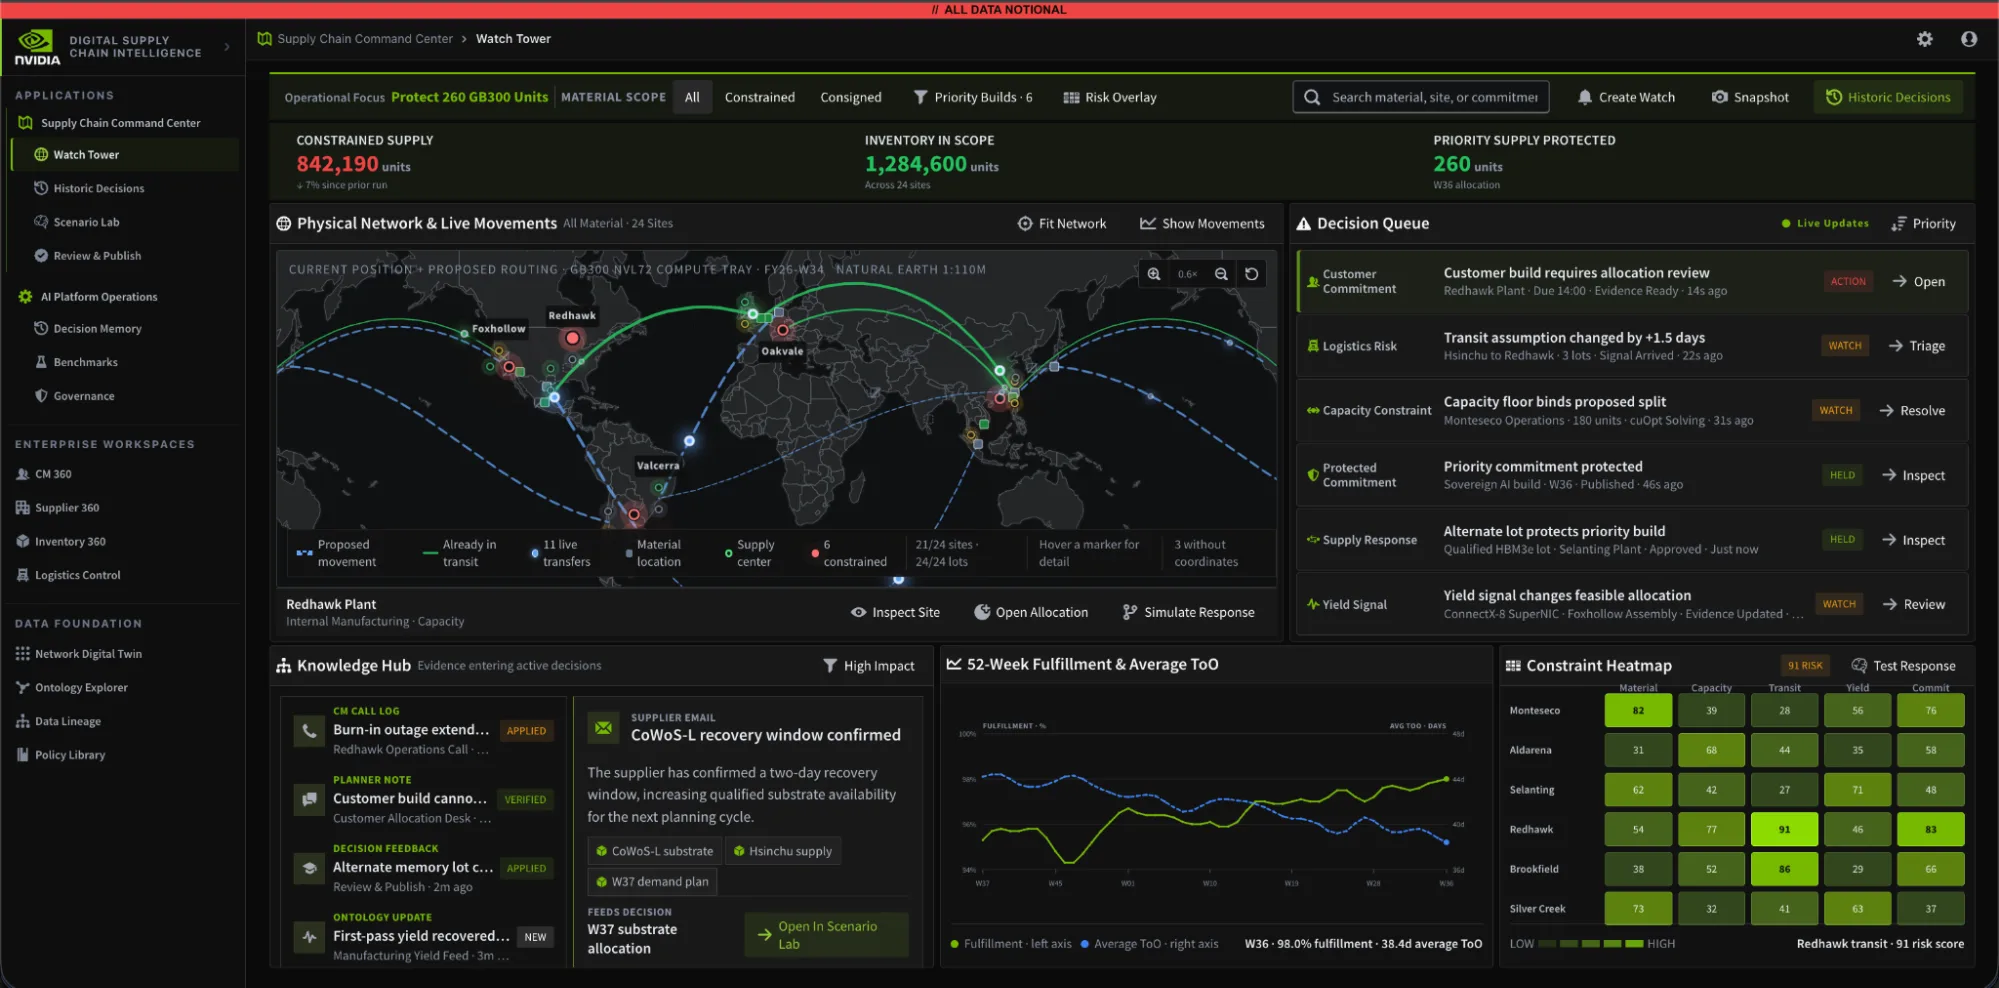
NVIDIA 供应链运营团队与 Palantir 合作,为物料分配决策的每一项输入建立了统一视图。NVIDIA 团队称之为数字供应链智能(Digital Supply Chain Intelligence)指挥中心,它能呈现各种风险、阻塞点及其他信号——这些信号影响着决策,但过去往往分散在互不联通的数据源中,难以被发现。
在底层,Palantir Foundry 提供了运营上下文。其 Ontology 将物料、制造基地、产能承诺、产能、分配、生产产出以及非结构化的定性信号统一到同一个受治理的数据层。它由对象和关联而非行与表构成,完整刻画了运营的真实状态。
有了这种表征,分配规划人员就能模拟和分析各种不同的场景,大幅拓宽可探索的决策空间,也为 AI 飞轮奠定基础——让新知识不断积累,性能随时间持续提升。
利用 NVIDIA cuOpt 解决量化问题
跨多个制造厂分配物料,本质上是一个量化问题。建模始于决策变量:在接下来的一段时间内,每种受限物料应分配给哪些工厂、各分配多少?围绕这些变量的是一系列边界条件。这包括所有能够生产特定 Blackwell 子总成的制造商,以及物料到位后每个站点能吸纳的吞吐量。还包括每个必需部件的依赖关系图,沿链条逆向映射,让求解器明白:阻碍计算托盘生产的,是其最稀缺的输入,而非平均水平。这一关键约束并非固定不变,而是在以下因素间动态波动:
- GPU、CPU 和内存的供需随周变化
- 三条供应路线的进货时间窗口
- 已对客户做出的承诺,这决定了任何单一站点短缺的实际成本
- 成千上万个变量和约束最终收敛为单一的周度分配方案。
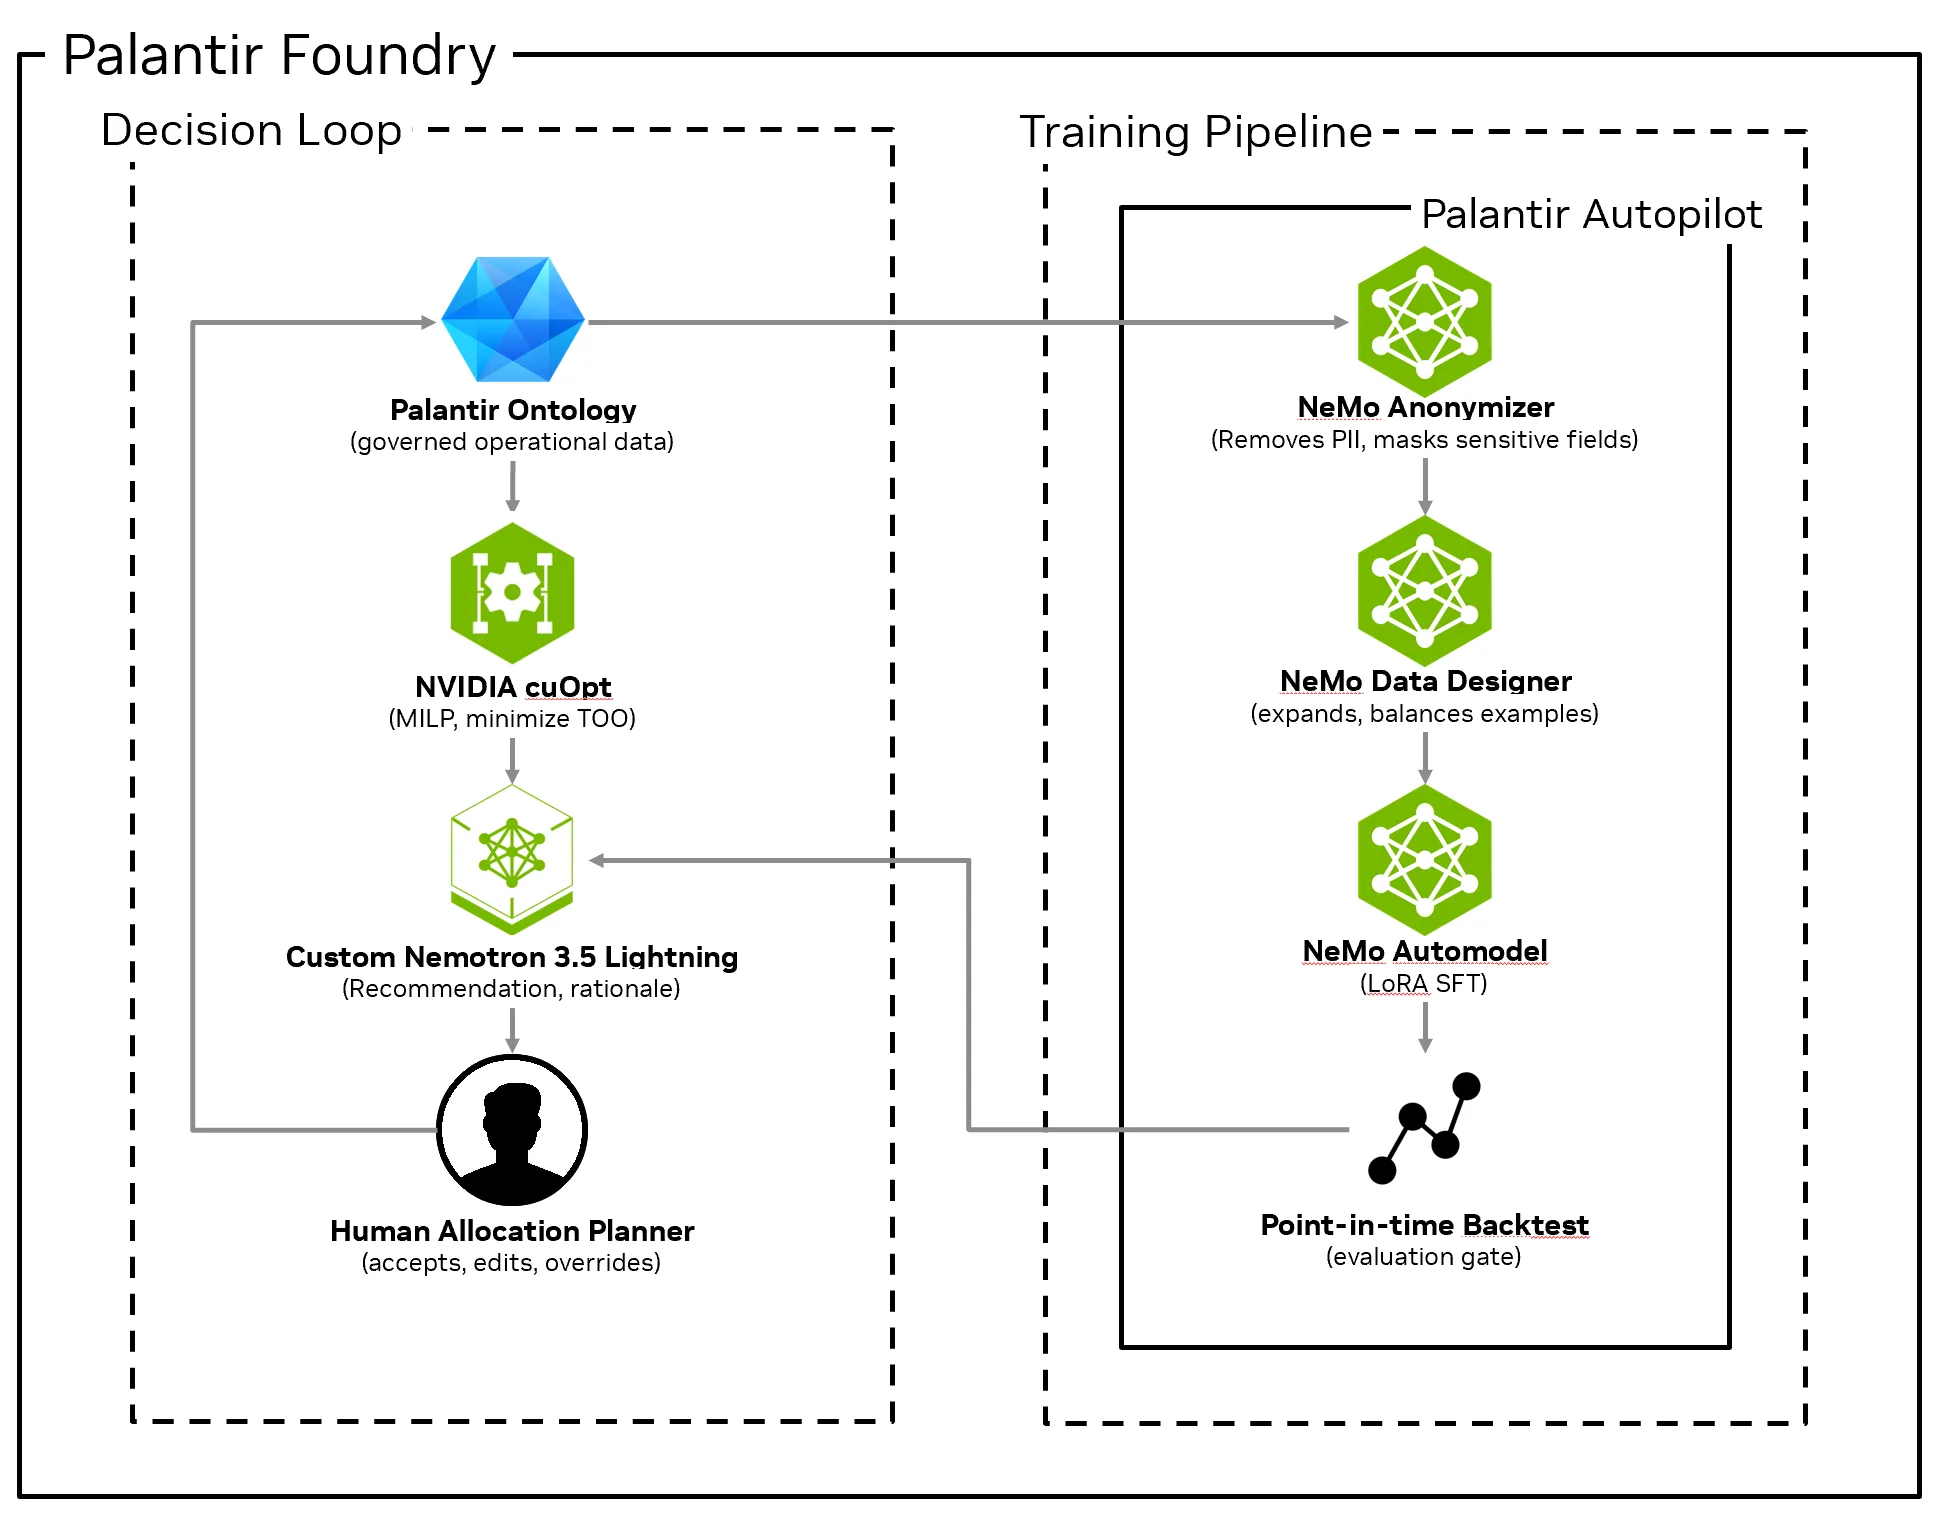
NVIDIA cuOpt 是一个面向 GPU 加速决策优化的开源库,负责解决这一问题。它从本体(Ontology)读取输入,并将结果写回作为分配决策。分配被建模为一个混合整数线性规划问题,目标是最小化持有时间(TOO)。cuOpt 返回的不仅仅是分配方案,它还报告哪些约束是紧约束(binding),让规划者看清:是台湾的产能而非内存供应,压制了本周的产量。
由于求解速度极快,规划者还能探索答案周围的解空间。如果本期内存减少 10% 会发生什么?如果一个新的制造厂投产呢?规划者不再只是向求解器索取一个答案,而是开始询问其背后的权衡取舍。
数学的边界
量化的最优解并非全貌。NVIDIA 和 Palantir 用实际发生的事件回溯历史分配决策,结果发现 cuOpt 未能捕捉到关键的人为因素。 规划者掌握着求解器看不到的信息:那一周与伙伴往来邮件、关键区域的极端天气预警、正在发生的地缘政治事件、上一次供应商复盘会议的记录,以及多年积累的经验。这些信息塑造了对下个周期如何分配物资的直觉,正是这种直觉让人类专家超越了纯数学计算。 基于此,NVIDIA 和 Palantir 围绕这些人类专家构建了工作流程。它捕捉分配决策、决策背后的逻辑、预期结果和实际结果。一旦机构知识被转化为明确且可审查的决策逻辑,并存储在 Ontology 中,它就为训练 LLM 学习专家判断奠定了基础。将决策智能编码化
接着,我们对一个开放权重 LLM 进行后训练,使其应用同样的推理逻辑并给出建议。在评估 NVIDIA Nemotron 的开源模型后,我们选择了 Nemotron 3.5 Lightning,因为它专为代理工作流的执行层设计。作为模型系统的一部分,它负责执行特定任务,而系统中包含更大规模的模型用于编排和通用任务。 其混合专家架构适合高效推理。该模型体量轻盈,总参数 300 亿,每次前向传播激活约 30 亿参数,但足以学习专注的策略。这种轻量级特性使后训练循环具有可行性:相较于更大的模型,小模型学习更快,训练和部署所需的算力也大幅减少。Nemotron 是开放的,可以在你自己的算力边界内进行后训练。任何组织都能在自己的运营数据上跑通同样的飞轮,而无需将数据暴露给外部。模型学习的信号正是规划人员实际使用的那些:给制造工厂分配了多少受限物料、厂商承诺生产多少、最终实际生产多少,以及决策时可以获得的定性运营证据。
目标是沉淀出一套分配策略,能够评估生产风险、给出建议的分配区间、指出建议背后的关键因素,并向供应链团队解释其推理过程。
每条记录同时也是评估工具。我们只基于当天可知的信息重放每个决策,隐藏实际结果,然后把模型的建议与规划人员的判断以及实际发生的情况做对比。这项评估要回答的核心问题是:如果这个模型上个月就在运行,它能否做出正确的分配决策?
从 Ontology 数据到专用模型
训练流程从 Palantir Ontology 中的运营历史数据开始:
- 匿名化:NeMo Anonymizer 在训练前去除个人身份信息,并对敏感字段做混淆处理。
- 合成数据生成:NeMo Data Designer 对样本进行扩充和均衡,让模型不只看到常规的周度情况,还能接触到分配上调、产能受限和供应中断等场景。
- 监督微调:NeMo AutoModel 在基础权重保持冻结的前提下训练一小组 LoRA adapter 参数,从而缩短训练时间、降低内存需求并减小 checkpoint 体积。
- 评估:时点回测(point-in-time backtest)将相同的历史决策分别输入基础模型和微调后的模型,从而量化后训练带来的提升。
Palantir Autopilot 端到端管理整个生命周期:从 Ontology 数据启动每个任务、监控部署的自定义 Nemotron 模型,并保持从数据、模型版本到建议输出的完整血缘关系。
部署后,模型会读取当前的运营上下文,并返回包含建议理由及关联风险的建议。规划人员会审查这些建议,并做出最终决定。
闭环
每一次接受、编辑、覆盖和生产结果都会写回 Ontology,不断积累,直到拥有足够多的代表性数据,以证明再次进行受治理的训练运行是合理的。
未来,这种反馈将用于强化学习。被接受和被覆盖的建议将形成偏好对,奖励涵盖分配的准确性、策略合规性和证据基础。模型不会在生产环境中自我重新训练。
这种结果在两个方面产生了复利效应:规划人员花费更少的时间重构常规决策,从而覆盖更多的站点和产品;分配专业知识也变成了机构知识,缩短了入职时间,并在整个组织中传播关键经验。
后训练带来的成果
NVIDIA 供应链运营团队与 Palantir 合作,指定模型接收什么内容、可以推荐什么,以及如何对这些推荐进行评分。该工作流既成为了应用程序,也成为了分配决策智能的基准测试。
我们在相同的任务和相同的评估数据上比较了三种模型:
- 基础版 Nemotron 3.5 Lightning (BF16)
- Nemotron 3 Ultra (NVFP4)
- 我们后训练的 Nemotron 3.5 Lightning (BF16)
在开发基准测试中,经过后训练的 Lightning 模型达到了86.7% 的分配决策准确率。Ultra 模型为 55.5%,基础版 Lightning 仅为 17.5%。这意味着后训练模型比 Ultra 高出 31.2 个百分点,比自身基础模型高出 69.2 个百分点。

在两项均衡评估决策类型而非样本数量的指标上,它也占据领先。平衡准确率取各分类召回率的平均值,因此稀有事件与常见事件权重相同:
Lightning 的平衡准确率为 58.6%,而 Ultra 为 42.0%。Macro-F1 取各分类 F1 值的平均值,并纳入精确率,防止模型通过过度预测稀有类别来虚增召回率:Lightning 为 57.5%,Ultra 为 39.5%。这两项指标至关重要,因为在供应受限的情况下,规划者削减分配的频率远高于增加,若仅看整体准确率,会高估盲目预测多数类模型的性能。
这一结论具体且重要:
在有限的分配任务中,专用的 30B 模型可以超越规模大出一个数量级以上的通用模型。
这并不意味着小模型在综合能力上更强。其优势集中体现在其后训练所覆盖的领域。尽管经过微调,未来的生产风险预测依然困难。专业化提升了决策任务的表现,但未能解决所有相关的预测问题。
LoRA 运行在 2 块 NVIDIA B200 GPU 上几分钟内即完成,资源消耗极低,便于随着反馈积累反复迭代。这是主权 AI 的实际体现:专有供应链数据、模型权重和推理过程均保留在单一受管环境中。该 AI 栈可部署在本地或云端,使组织能在数据、系统和运营需求所要求的地方运行 AI。
会学习的供应链
本文讨论的供应链工作流并非半导体行业独有。任何由经验丰富的人员根据零散信息分配关键产能的业务,都可以运行同样的飞轮,并将其适配到新的领域。
这需要三个关键要素:
- 一个受管控的运营层
- 同时记录决策依据和结果的决策捕获机制
- 一个可以在自己的安全算力边界内进行后训练的开放模型
运营数据训练模型,模型改进决策,决策又成为下一轮受管控训练的新运营数据。NVIDIA 和 Palantir 正是以这种方式缩短从晶圆出货到首个 token 的产出时间,也正因如此,全球最可靠的 AI 基础设施供应链的学习速度才能超过其增长速度。
立即上手,为你的 agentic 工作流定制高效的开放权重模型。
订阅 NVIDIA 新闻,并在 LinkedIn、X、YouTube 以及 Discord 的 Nemotron 频道上关注 NVIDIA AI,及时了解 NVIDIA Nemotron 的最新动态。
在 Hugging Face 上获取开放的 Nemotron 模型,并在 build.nvidia.com 上查看 NIM 微服务和开发者示例合集。